

TL;DR : les tarifs de GPT-6.2 sont de 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie pour Astra, et de 2 $ et 10 $ pour Sol. Les lectures en cache coûtent 0,40 $ et 0,10 $. Une tâche d'agent illustrative de 20 tours coûte environ 3,23 $ sur Astra et 0,81 $ sur Sol avec le cache de prompt actif, et quatre fois plus sans.
OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. Astra est le modèle frontière pour les travaux les plus complexes. Sol est le modèle du quotidien, et sa page de modèle indique qu'il est conçu pour « alimenter des agents à grande échelle ».
Un prix par million de tokens en dit peu sur ce qu'une équipe d'agents va dépenser. Les agents renvoient leur contexte à chaque tour : la facture dépend donc du cache, de la longueur du contexte et du nombre d'agents exécutés simultanément. Ce guide convertit la grille tarifaire de GPT-6.2 en montants par tâche et par mois, puis présente les limites qui permettent de les maîtriser. Si vous faites déjà tourner des agents de code côte à côte, Sharkly vous permet de fixer ces limites par Agent.
Tarifs de GPT-6.2 pour Astra et Sol
Voici la grille tarifaire standard de l'API, relevée le 20 novembre 2026 sur la page du modèle Astra et la page du modèle Sol. Tous les prix sont par million de tokens.
| Prix pour 1M de tokens | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Entrée | 8,00 $ | 2,00 $ |
| Entrée en cache (lectures) | 0,40 $ | 0,10 $ |
| Écritures en cache (rétention 30 minutes) | 10,00 $ | 2,50 $ |
| Écritures en cache (rétention 12 heures) | 20,00 $ | 5,00 $ |
| Sortie | 40,00 $ | 10,00 $ |
| Fenêtre de contexte | 1 050 000 | 1 050 000 |
Sol coûte exactement le quart d'Astra sur chaque ligne. Les deux modèles partagent la même fenêtre de contexte et les mêmes limites de débit : seul le prix les distingue sur une facture.
Les règles tarifaires qui modifient le total
Cinq règles présentes sur les pages des modèles pèsent davantage sur la facture d'un agent que le tarif de base :
- Surcharge pour long contexte. Une requête dépassant 272K tokens en entrée paie le double pour l'entrée et le cache, et 1,5 fois pour la sortie, sur l'ensemble de la requête.
- Les écritures en cache sont facturées en supplément. Écrire un préfixe dans le cache coûte 1,25 fois le prix normal de l'entrée pour 30 minutes, ou 2,5 fois pour 12 heures.
- Les lectures en cache sont bon marché. Sur GPT-6.2, une lecture en cache coûte 0,05 fois le prix normal de l'entrée, selon le guide de mise en cache des prompts d'OpenAI.
- Le Batch coûte 50 % des tarifs standard.
- La vitesse coûte plus cher. Le mode Fast coûte 2 fois le tarif standard. Ultrafast coûte 3 fois jusqu'au 28 février 2027, puis 6 fois à partir du 1er mars 2027.
GPT-6.2 ne prend pas en charge Flex processing. Son remplaçant est une fenêtre d'achèvement en arrière-plan à tarif réduit, présentée plus bas.
Combien coûte une tâche d'agent sur GPT-6.2
Prenons une tâche de code illustrative : 20 tours, 60 000 tokens en entrée par tour et 2 000 tokens en sortie par tour. Soit 1,2 million de tokens en entrée et 40 000 en sortie pour toute la tâche. Vos chiffres seront différents : remplacez-les par les vôtres.
| Scénario | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Aucun hit de cache | 11,20 $ | 2,80 $ |
| 90 % de hits de cache | 3,23 $ | 0,81 $ |
| 90 % de hits de cache, fenêtre d'arrière-plan de 8 heures | 1,94 $ | 0,49 $ |
Les lignes avec cache supposent que 90 % de l'entrée est lue depuis le cache et que les 10 % restants sont facturés comme une écriture en cache de 30 minutes. C'est le scénario pessimiste : une exécution réelle avec cache devrait donc rester à ces niveaux ou en dessous.
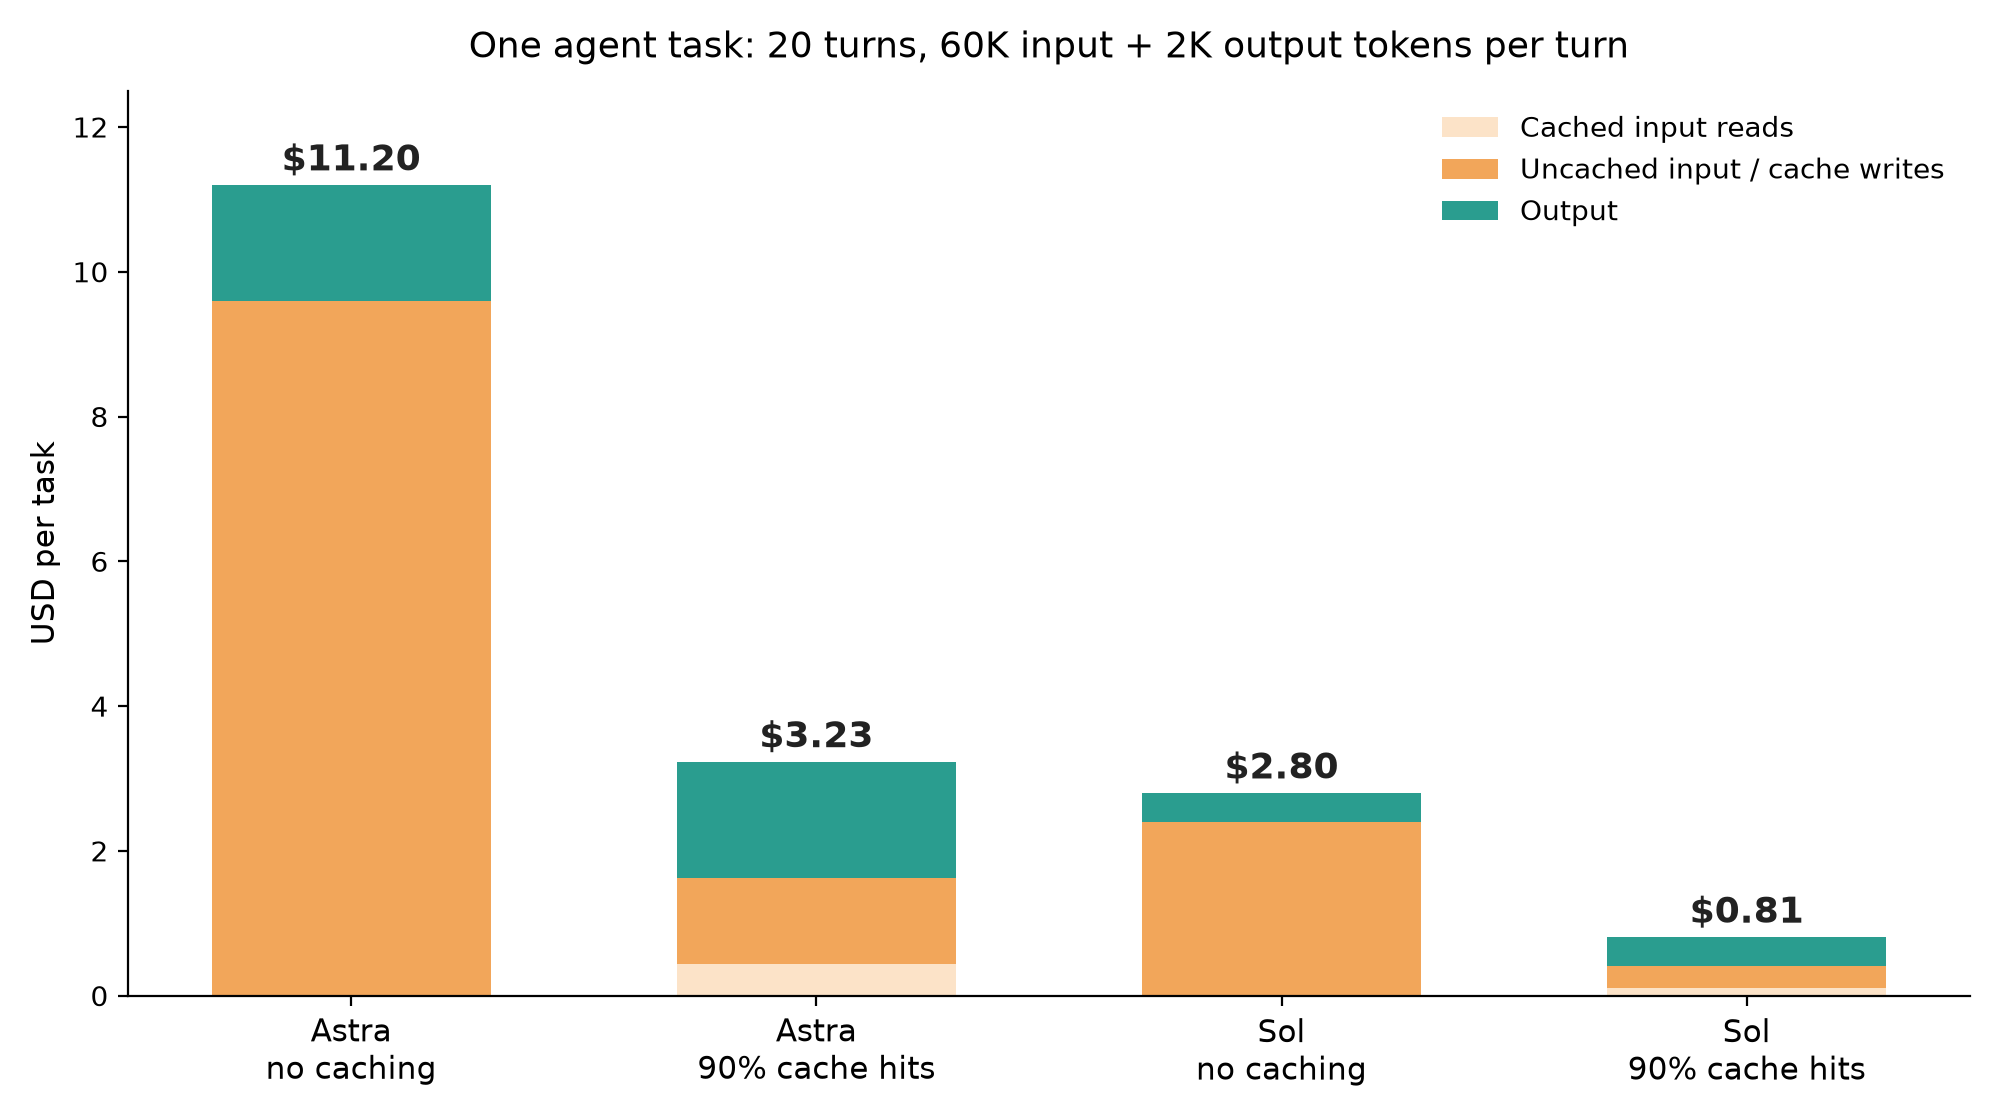
Deux chiffres ressortent. Le cache réduit le coût de la tâche d'environ 71 % sur les deux modèles. Et une tâche Astra avec cache ne coûte qu'un peu plus cher qu'une tâche Sol sans cache. Le modèle bon marché avec un cache défaillant coûte presque aussi cher que le modèle cher avec un cache qui fonctionne.
Là où la surcharge pour long contexte fait mal
Les agents de code qui lisent la moitié d'un dépôt peuvent dépasser 272K tokens en entrée par tour. Comparez deux tours Sol, avec 2 000 tokens en sortie et sans cache :
- 270 000 tokens en entrée : 0,54 $ en entrée plus 0,02 $ en sortie, soit 0,56 $ au total.
- 300 000 tokens en entrée : 1,20 $ en entrée plus 0,03 $ en sortie, soit 1,23 $ au total.
Un contexte 11 % plus grand coûte plus du double. Si votre harnais d'agent compresse le contexte, maintenez-le sous 272K. La même logique sous-tend notre article sur pourquoi les modèles bon marché peuvent coûter plus cher : le prix par modification acceptée compte plus que le prix par token.
Coût mensuel de GPT-6.2 pour une équipe d'agents
Appliquons maintenant une échelle aux chiffres avec cache. Supposons cinq agents achevant chacun 8 tâches par jour pendant 22 jours ouvrés. Cela fait 880 tâches par mois.
| Configuration de l'équipe | Tâches par mois | Coût mensuel des modèles |
|---|---|---|
| Les cinq agents sur Astra | 880 | 2 842 $ |
| Un agent Astra comme leader, quatre agents Sol | 176 + 704 | 1 139 $ |
| Les cinq agents sur Sol | 880 | 713 $ |
La configuration mixte coûte 60 % de moins que tout-Astra. Elle réserve le modèle frontière à la planification et aux revues difficiles, et envoie le travail de routine à Sol. Nous détaillons le rôle de leader dans GPT-6 Astra comme leader de votre équipe, et le même raisonnement anime même budget, plus d'agents avec GPT-6 Sol.
Le prix n'est qu'une limite. Les tokens par minute bloquent une équipe d'agents avant l'argent sur les niveaux d'utilisation les plus bas, ce que le guide des limites de débit de GPT-6.2 examine niveau par niveau.
Forfaits Codex ou clés API
Si vos agents utilisent Codex via un forfait ChatGPT, vous ne payez pas au token : vous consommez un quota. La page tarifaire de Codex estime 6 à 50 messages locaux par fenêtre de cinq heures pour GPT-6.2 Astra sur Plus et Standard Business, et 17 à 180 pour Sol. Les longues sessions épuisent le quota plus vite : les calculs en tokens ci-dessus prédisent donc toujours quelles tâches tomberont à court en premier.
Notre guide GPT-6.2 Codex couvre la configuration des deux modèles.
Comment réduire le coût de GPT-6.2 pour une équipe d'agents
L'ordre ci-dessous place d'abord les actions les plus rentables :
- Faites fonctionner le cache. Placez les instructions stables dans un message
developerau début de l'entrée et ne réécrivez jamais les tours précédents. Un préfixe modifié est un échec de cache. - Sol par défaut. Ne passez une tâche à Astra que si elle dépasse le cadre d'un service ou si Sol échoue deux fois sur le même type de tâche.
- Restez sous 272K tokens en entrée par requête.
- Bascullez le travail de masse vers les fenêtres d'arrière-plan lorsque vous appelez l'API depuis votre propre harnais.
- Utilisez Batch pour les évaluations et les tâches hors ligne, jamais pour un agent interactif.
- Laissez Fast et Ultrafast désactivés sauf si quelqu'un attend le résultat.
Les fenêtres d'arrière-plan à tarif réduit remplacent Flex
Le guide du mode arrière-plan d'OpenAI liste deux fenêtres d'achèvement à tarif réduit pour l'API Responses, en bêta publique sur GPT-6.2 : 2h à 30 % sous le tarif standard et 8h à 40 % sous. Elles partagent la limite de débit de Batch, et non votre limite de tokens en temps réel.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
Interrogez l'ID de réponse plus tard, ou utilisez un webhook. Cela convient à la génération de tests, aux mises à jour de dépendances et aux passes de documentation dont personne n'a besoin avant le lendemain matin.
Contrôler les dépenses GPT-6.2 par Agent dans Sharkly
Sharkly ne revend pas de tokens. Chaque exécution est facturée sur le forfait Codex ou la clé API déjà rattachée au Runtime : votre facture OpenAI reste donc l'unique source de vérité. Ce que Sharkly vous apporte, c'est le contrôle du volume de travail qui atteint cette facture.
Chaque Agent dispose d'une ligne Modèle par défaut listant les modèles que son Runtime signale. Réglez vos Agents de routine sur Sol et votre Agent leader sur Astra. Quand une tâche exige plus, la documentation Sharkly décrit une dérogation par tâche : survolez l'Agent dans le sélecteur de destinataires et choisissez un modèle pour cette seule exécution.
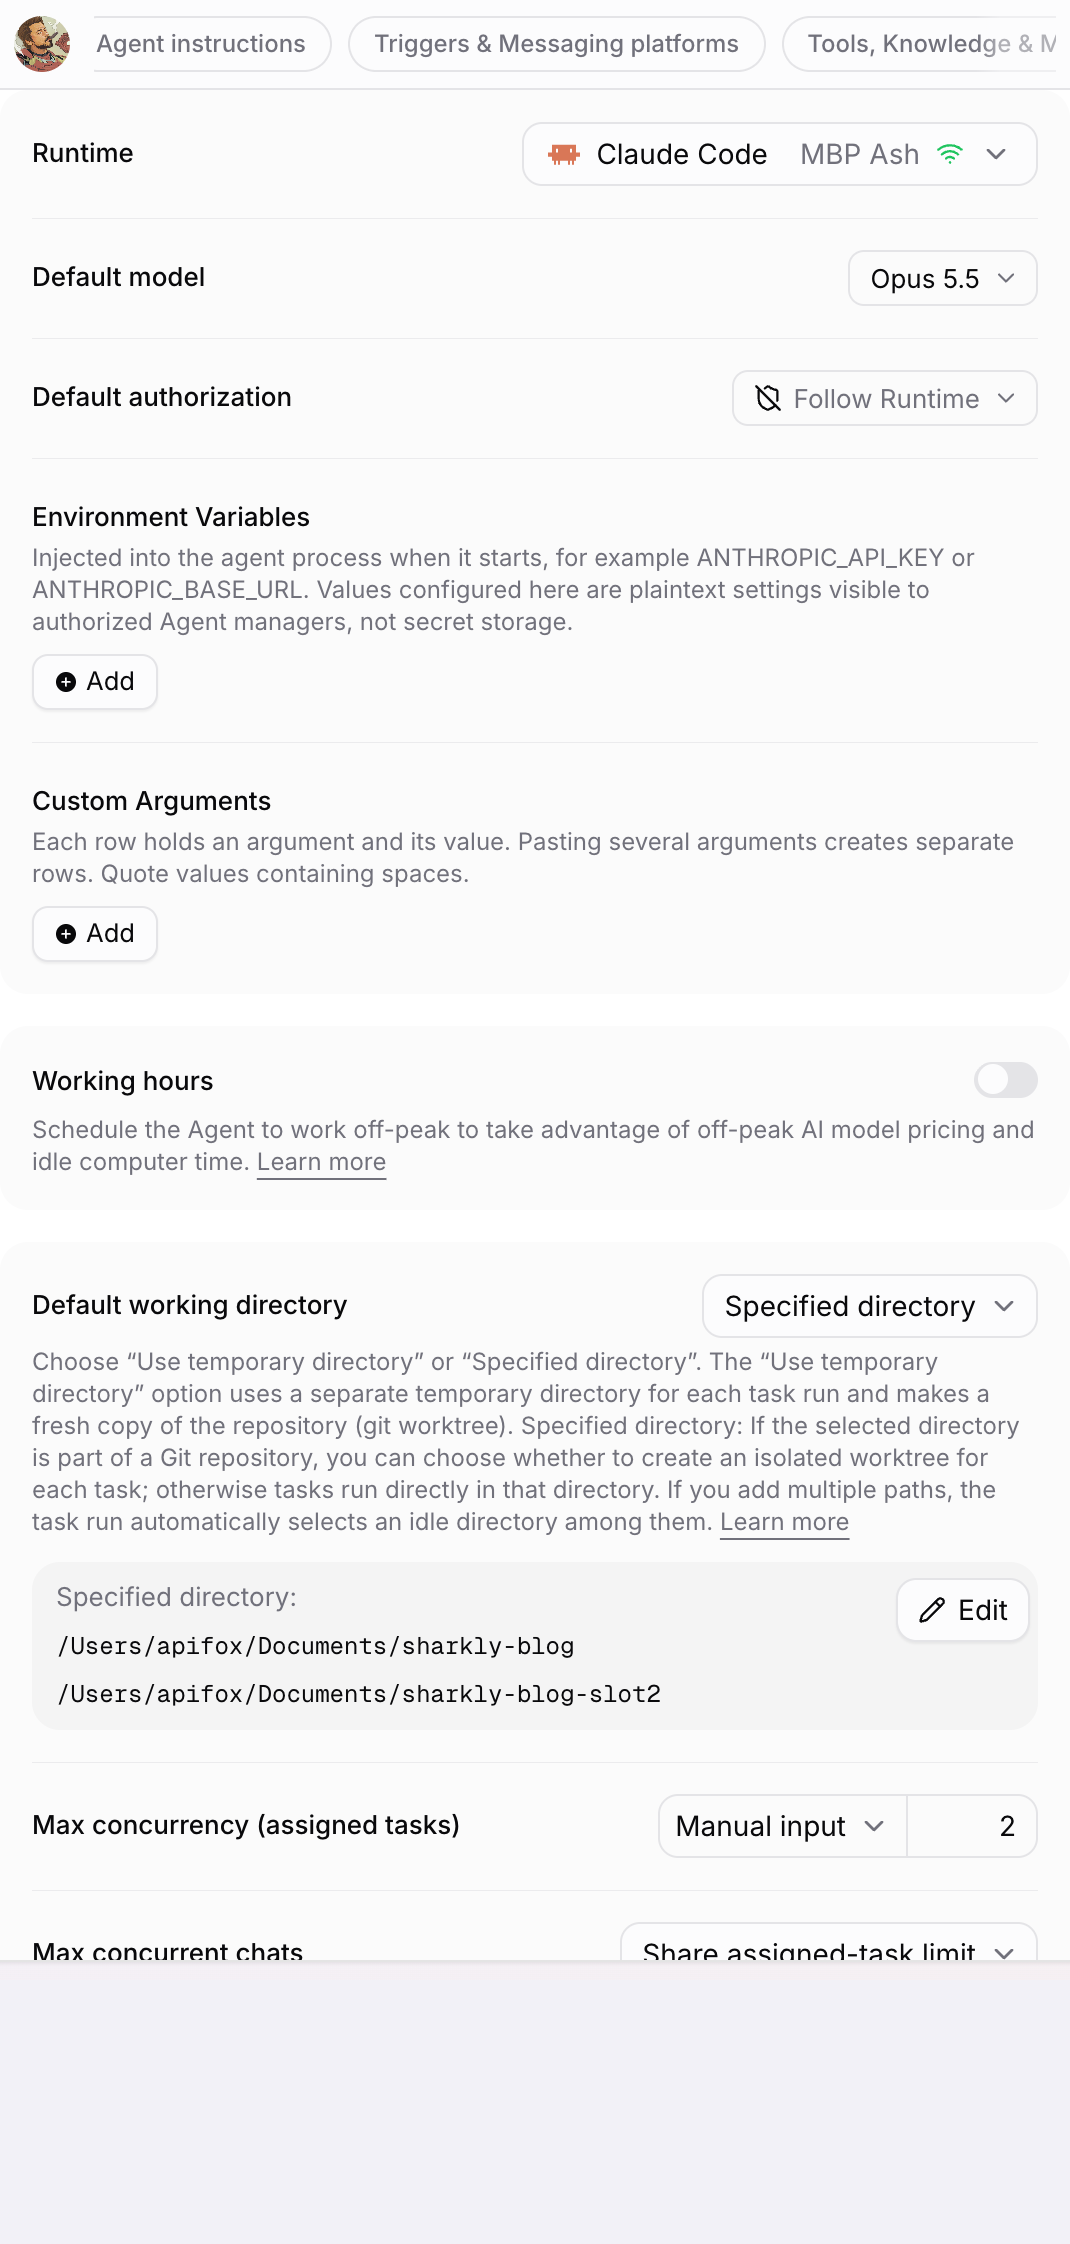
Le même panneau contient les variables d'environnement, injectées dans le processus de l'agent au démarrage. Donnez à chaque groupe d'Agents une clé API issue de son propre projet OpenAI : votre page d'utilisation OpenAI répartira ainsi les dépenses par groupe. Les heures de travail planifient un Agent sur des créneaux creux, si bien que les tâches de masse tournent la nuit et laissent la capacité de jour aux personnes qui attendent.
Les dépenses ont aussi besoin d'un plafond. La concurrence maximale limite le nombre de tâches qu'un Agent exécute à la fois, la durée maximale d'exécution arrête une exécution qui boucle, et le délai d'attente de la file écarte le travail qui a trop attendu.
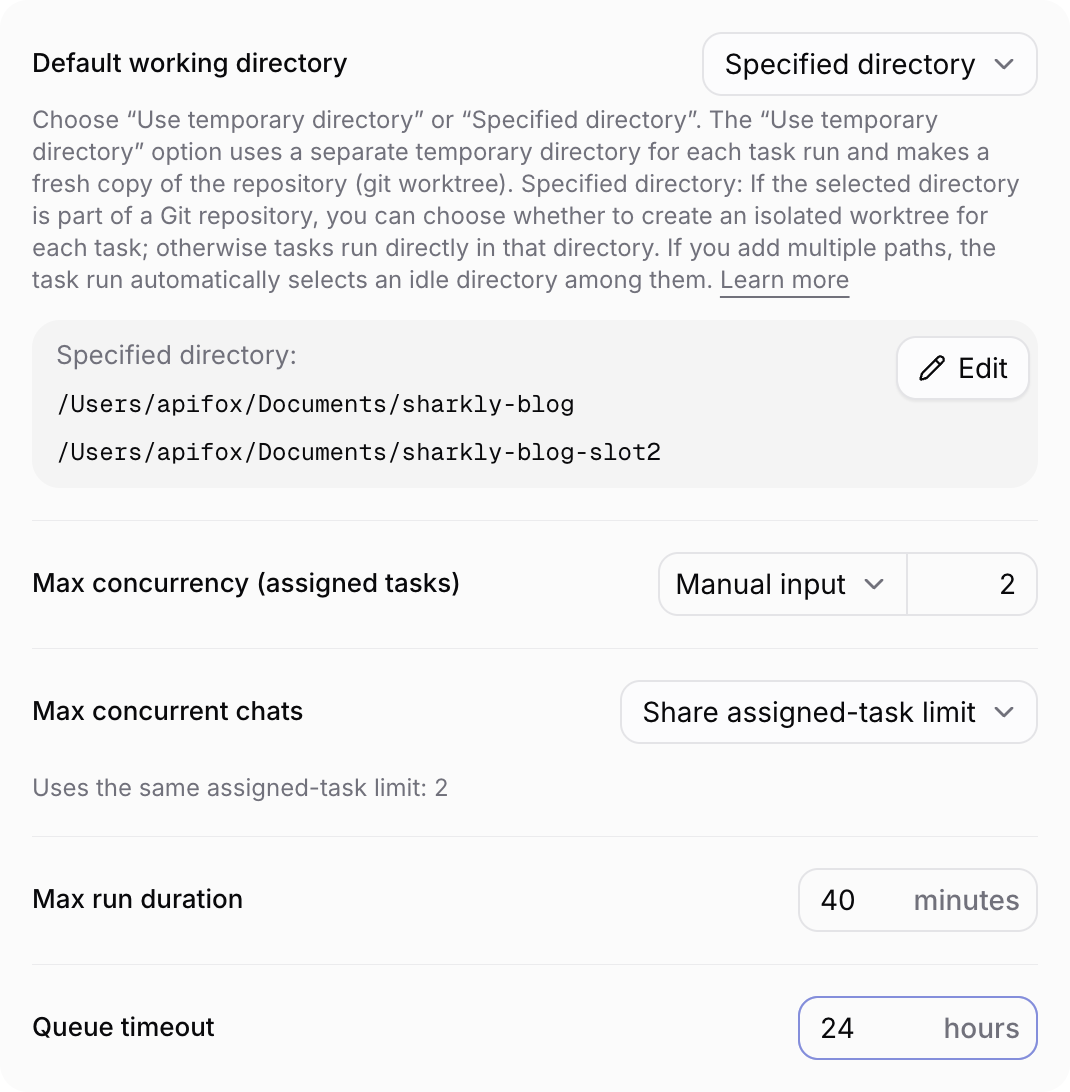
Un plafond d'exécution de 40 minutes sur un Agent Sol borne le pire des cas. La liste des exécutions de chaque Agent affiche les tokens consommés par chaque exécution, ce qui permet de repérer le type de tâche qui en brûle trois fois plus que les autres. Cette tâche a besoin d'une description plus précise ou d'un modèle moins cher.
Conclusion
La tarification de GPT-6.2 semble simple : Astra coûte quatre fois Sol sur chaque ligne. La facture des agents, elle, ne l'est pas. Le cache fait varier une tâche d'environ 71 %, le seuil de 272K peut doubler un tour, et la concurrence multiplie le tout. Mesurez une tâche réelle, montez votre taux de hits de cache, mettez le travail de routine sur Sol et plafonnez ce qui tourne en parallèle.
Essayez d'abord sur un seul Agent. Connectez un Computer, créez un Agent Codex sur GPT-6.2 Sol, réglez la concurrence maximale sur 2 et la durée maximale d'exécution sur 40 minutes, et assignez-lui une tâche de routine. Puis lisez les tokens de l'exécution. Pour en savoir plus sur le pilotage d'une équipe en parallèle, consultez comment faire tourner 10 agents de code IA à la fois.
FAQ
Combien coûte GPT-6.2 ?
GPT-6.2 Astra coûte 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie. GPT-6.2 Sol coûte 2 $ et 10 $. Les lectures en cache coûtent 0,40 $ sur Astra et 0,10 $ sur Sol.
GPT-6.2 Sol est-il moins cher qu'Astra ?
Oui. Sol coûte le quart d'Astra sur l'entrée, la sortie, les lectures en cache et les écritures en cache. Les deux partagent une fenêtre de contexte de 1 050 000 tokens et les mêmes limites de débit.
Quel est le tarif long contexte de GPT-6.2 ?
Les requêtes dépassant 272K tokens en entrée paient le double pour l'entrée et le cache, et 1,5 fois pour la sortie, sur l'ensemble de la requête, et non seulement sur les tokens au-dessus du seuil.
GPT-6.2 prend-il en charge Flex processing ?
Non. OpenAI oriente les travaux de longue durée vers des fenêtres d'achèvement en arrière-plan à tarif réduit : 2h à 30 % de remise et 8h à 40 % de remise, en bêta publique.
Combien coûte le Batch de GPT-6.2 ?
Le Batch coûte 50 % des tarifs standard sur les deux modèles. Il convient aux évaluations et aux tâches hors ligne, pas aux agents interactifs.
Sharkly facture-t-il les tokens GPT-6.2 ?
Non. Sharkly fait tourner les agents de code que vous utilisez déjà, et la consommation des modèles est facturée sur votre propre forfait Codex ou votre clé API. Sharkly contrôle le modèle utilisé par chaque Agent et le nombre de tâches exécutées simultanément.


