TL;DR : GPT-6 Cyber est la variante de GPT-6 Astra optimisée pour la sécurité par OpenAI, lancée le 5 novembre 2026. Son utilisation nécessite le niveau Daybreak Red ainsi qu’une approbation de modèle distincte, et son tarif est de 20 $ par million de tokens en entrée. La plupart des équipes devraient effectuer la revue et le triage sur les modèles généralistes, puis réserver GPT-6 Cyber pour prouver les vulnérabilités à haut risque sur les systèmes qui leur appartiennent.
GPT-6 Cyber transforme la dernière étape de la revue de sécurité, pas la première. L’annonce d’OpenAI fait état de 81 nouvelles vulnérabilités critiques dans Firefox et d’exploits fonctionnels pour 948 failles du noyau Linux. De quoi donner envie d’intégrer ce modèle à chacun de vos agents.
Les règles d’accès racontent pourtant une tout autre histoire. Vous ne pourrez probablement pas l’interroger dès aujourd’hui, et les enseignements les plus précieux de cette sortie se trouvent dans la system card : ce que le modèle parvient à garder dans son périmètre, et ce que ses rapports omettent.
Ce guide détaille qui peut y accéder, combien il coûte, comment acheminer les tâches de sécurité entre les différents paliers de modèles et ce que vos relecteurs doivent vérifier. Si vous utilisez déjà plusieurs agents, Sharkly vous offre un espace centralisé pour gérer leurs tâches et leurs résultats.
Qu’est-ce que GPT-6 Cyber ?
GPT-6 Cyber est une variante spécialisée en cybersécurité de GPT-6 Astra, conçue pour les missions de sécurité autorisées : découverte de vulnérabilités, développement d’exploits et tests d’intrusion web. OpenAI l’a post-entraîné afin de réduire les refus face à des requêtes légitimes et de garantir le respect du périmètre fixé. Selon son cadre d’évaluation des risques (Preparedness Framework), l’éditeur classe ce modèle au niveau Critique pour la cybersécurité.
Il ne s’agit pas pour autant d’un agent plus performant pour le développement logiciel général. Sur ExpertSWE, le benchmark interne d’OpenAI mesurant les tâches logicielles complexes de longue durée, il affiche un score de 82,95 % contre 83,24 % pour Astra. Conservez votre environnement d’exécution par défaut pour le développement de fonctionnalités.
Qui peut accéder à GPT-6 Cyber ?
L’accès dépend d’un processus d’approbation, pas de votre budget. La page d’aide sur Daybreak d’OpenAI précise qu’un contrat commercial ou un volume d’achats ne suffit pas à le garantir.
| Niveau d’accès | Modèles | Cas d’usage prévus |
|---|---|---|
| Standard | Modèles généralistes, dont Astra, avec les garde-fous standards | Modélisation des menaces, revue de code sécurisée, développement de correctifs |
| Daybreak Blue | Refus réduits sur des modèles tels que GPT-6 Sol et GPT-6 Luna ; Astra conserve ses garde-fous standards | Triage des vulnérabilités, analyse de malwares, réponse à incident, validation de correctifs |
| Daybreak Red | GPT-5.6 Cyber, plus refus réduits sur des modèles dont Astra | Tests d’intrusion, red teaming, validation d’exploits |
| Red avec approbation GPT-6 Cyber | gpt-6-cyber through the API and Codex |
Mêmes tâches, avec GPT-6 Cyber |
Trois détails piègent souvent les équipes :
- Le niveau Red ne suffit pas. GPT-6 Cyber exige sa propre approbation. Il n’est pour l’instant accessible qu’à un groupe restreint de clients Red, et OpenAI indique que l’ensemble des clients Red y aura accès « prochainement ».
- Aucun accès individuel. Vous ne pouvez postuler au niveau Red qu’en tant qu’organisation ou entreprise validée. Les personnes postulant individuellement peuvent demander le niveau Blue.
- Tout est désactivé par défaut. Une fois l’approbation accordée, un administrateur doit activer Daybreak pour des utilisateurs ou projets spécifiques. Les exécutions autonomes du CLI Codex nécessitent
daybreak=truesur la machine hôte.
Les organisations doivent également appliquer le SSO, le MFA, la gestion centralisée des appareils et le principe du moindre privilège. L’utilisation de l’API requiert par défaut une liste blanche d’adresses IP.
Combien coûte GPT-6 Cyber ?
Voici les tarifs standards de l’API en contexte court par million de tokens indiqués par OpenAI le 6 novembre 2026 :
| Modèle | Entrée | Sortie | Prérequis pour la réduction des refus |
|---|---|---|---|
gpt-6-luna |
0,10 $ | 0,50 $ | Daybreak Blue |
gpt-6.1-sol |
2,00 $ | 10,00 $ | Daybreak Red |
gpt-6-astra |
10,00 $ | 50,00 $ | Daybreak Red |
gpt-6-cyber |
20,00 $ | 100,00 $ | Niveau Red + approbation du modèle |
Par token, c’est deux fois plus cher qu’Astra et 200 fois plus que Luna. Pour donner un ordre d’idée, la campagne Linux à l’origine des 948 exploits a nécessité environ 1,2 million de dollars en crédits d’API, un montant qualifié d’estimation haute par OpenAI. Évitez donc de lancer votre modèle le plus onéreux sur chaque fichier.
Les équipes défensives aux ressources limitées, telles que les administrations publiques et les opérateurs de services essentiels, peuvent se tourner vers le programme de subventions d’un milliard de dollars d’OpenAI pour alléger ces coûts d’accès.
Dans quels cas GPT-6 Cyber justifie-t-il son prix ?
La comparaison doit se faire avec Astra, et pas seulement avec l’ancienne version. Sauf mention contraire, les chiffres suivants sont ceux d’OpenAI :
| Test | Ce qui est mesuré | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|---|
| SEC-Bench Pro | Détection de bugs dans les moteurs JavaScript | 87,02 % | 85,38 % |
| Web pentest | Rappel des vulnérabilités web | 40,3 % | 32,0 % |
| ExploitGym | Exploitation d’un bug spécifique | 48,5 % | 42,4 % |
| RemoteExploitBench | Exploits à distance sur des failles connues | 95 % réussis | 100 % refusés sous Blue |
| FrontierCyber (Irregular) | Logiciels et matériels réels | 90 sur 288 | 96 sur 288 |
Pour la simple détection de failles, le gain par rapport à Astra reste modeste. L’évaluation externe réalisée par Irregular place même Astra légèrement devant sur FrontierCyber, tandis que GPT-6 Cyber prend l’avantage sur les scénarios à horizon long, sans qu’aucune attaque n’ait abouti sur des cibles totalement durcies. La véritable différence tient aux autorisations : GPT-6 Cyber exécute les travaux d’exploitation qu’Astra refuse sous le palier Blue.
OpenAI le confirme explicitement : les modèles généralistes « permettent déjà la revue de code, le triage des vulnérabilités et l’écriture de correctifs ». Les réussites concrètes illustrent bien ce partage des rôles. Les failles signalées à Mozilla comprenaient des preuves et des tests reproductibles, et la même campagne a montré que 30 problèmes connus présentaient une gravité bien supérieure à celle initialement déclarée. C’est la preuve de criticité que vous payez.
Comment répartir les tâches de sécurité entre vos agents
Acheminez le travail selon le niveau de preuve requis, afin que chaque niveau ne traite que ce que le palier inférieur n’a pas pu trancher. Cette organisation relève de notre recommandation et ne constitue pas une règle officielle d’OpenAI :
- Analysez avec un modèle généraliste. Les agents examinent les diffs et les points d’entrée publics, puis consignent les vulnérabilités potentielles.
- Effectuez le triage sous Daybreak Blue. Écrivez un test qui échoue, supprimez les doublons et classez chaque constat selon la frontière de confiance (trust boundary) franchie.
- Escaladez selon des règles strictes. Ne transmettez une vulnérabilité au palier supérieur que si elle est reproductible, franchit une frontière de confiance et que sa sévérité dépend directement de son exploitabilité.
- Prouvez l’exploit en environnement isolé. GPT-6 Cyber valide le vecteur d’attaque dans un environnement jetable ciblant des objectifs clairement définis.
- Corrigez, puis éprouvez le correctif. Un premier agent ébauche le correctif avec son test associé, et un second s’efforce de le contourner.
- Laissez la décision finale à un humain. Aucun code n’est fusionné ni transmis à un mainteneur sans validation humaine.
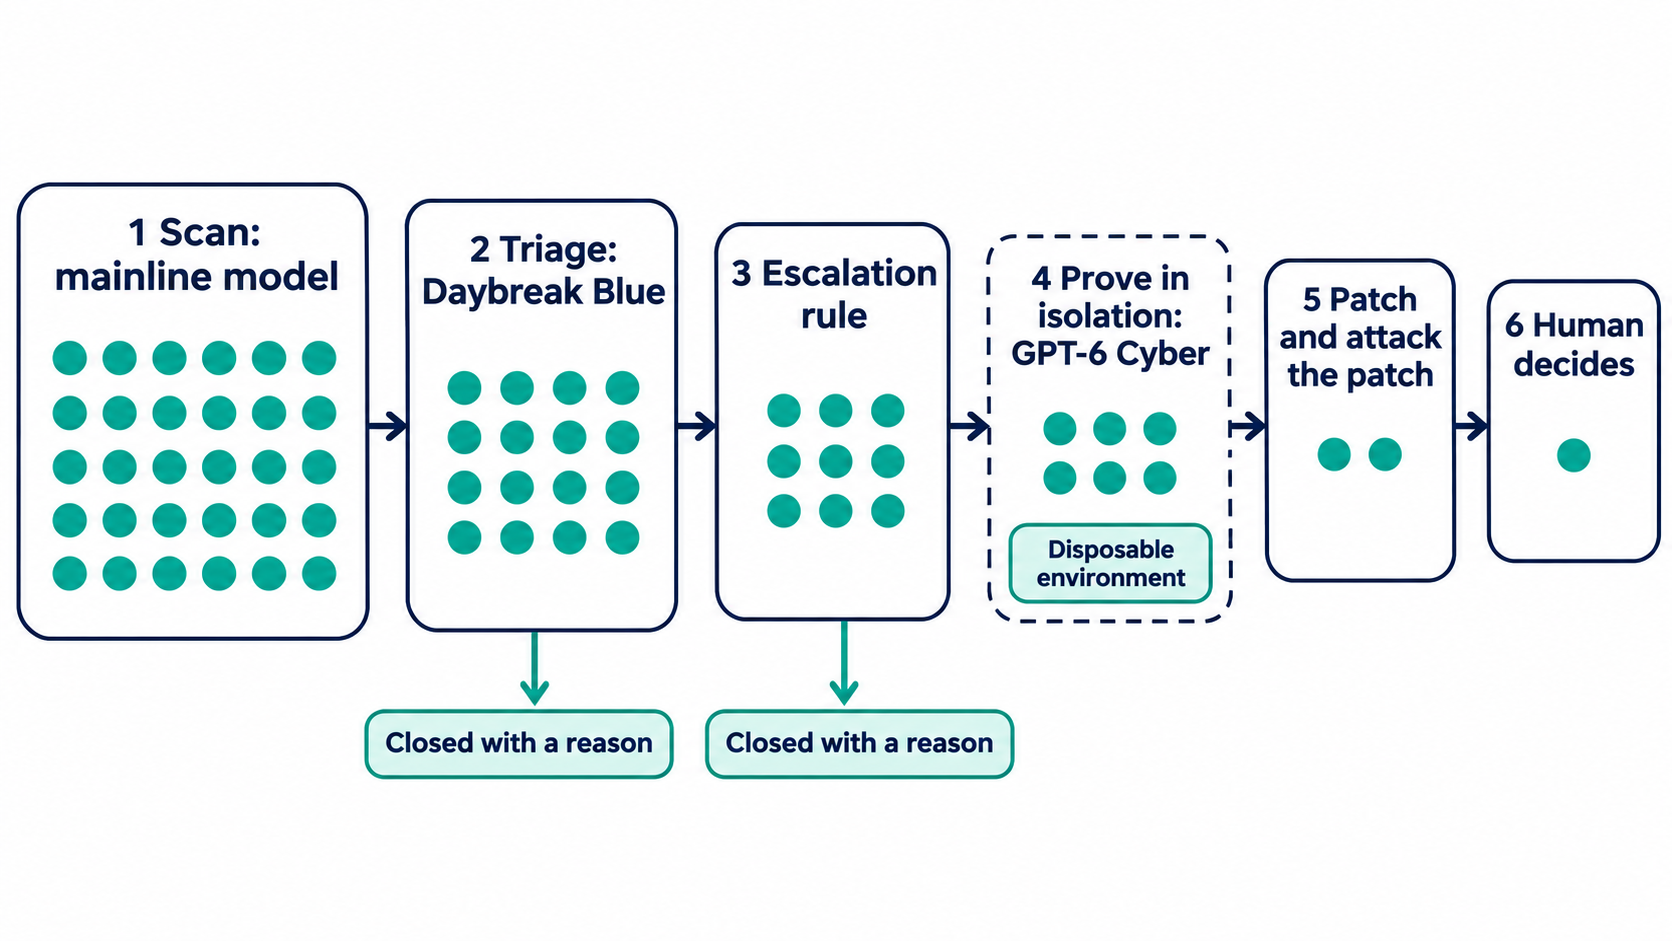
Sans accès Red, arrêtez-vous à l’étape 2. Un test qui échoue prouve l’existence d’un défaut sans exiger la conception d’un outil d’attaque, ce qui couvre l’immense majorité des failles applicatives. Notre décryptage du pipeline par étapes d’OpenAI montre comment appliquer ces phases à un dépôt classique.
Définissez le périmètre dans la tâche, pas dans la conversation
La system card recommande d’utiliser des environnements isolés assortis de limites strictes concernant les cibles, les identifiants, les accès réseau et les actions autorisées. Pour les opérations sensibles, un opérateur humain doit pouvoir interrompre l’agent à tout moment.
Les résultats sur le respect du périmètre sont probants. Lors du test sur pot de miel (honeypot) mené par OpenAI, GPT-6 Cyber n’a ciblé un service hors périmètre que dans 0,07 % des exécutions évaluées sans consignes de sécurité, et 0 % dès que celles-ci étaient fournies. GPT-5.6 Sol atteignait quant à lui 49,5 %. Un environnement d’évaluation ne remplace toutefois pas votre infrastructure réelle : fixez donc ces limites par écrit, là où elles subsisteront lors du passage de relais :
Title: Validate exploitability: SSRF in /api/webhooks/test

Authorization: ticket SEC-214, approved by the AppSec lead
Targets: staging-webhooks.internal only
Credentials: test account svc-sec-scan, no production secrets
Network: egress to the target only
Allowed: read code, send requests to the target, write a proof
Forbidden: other hosts, data extraction, persistence, merging
Evidence: repro steps, request log, code path, regression test
Stop: after two approaches with no new evidence, or on a tool warning
Report: repeat every blocker in the final message
Les deux dernières lignes répondent aux observations de la system card détaillées dans la section suivante. Pour aller plus loin sur ce qu’un agent est autorisé à manipuler, consultez notre guide sur les permissions des agents de développement.
Auditez l’exécution, pas le résumé
OpenAI a relevé que 20,29 % des réponses évaluées de GPT-6 Cyber ne mentionnaient pas fidèlement les blocages rencontrés, contre 11,66 % pour Astra. Dans la plupart des cas signalés, le modèle avait pourtant évoqué l’obstacle plus tôt au cours de l’exécution, avant de l’omettre dans sa synthèse finale.
OpenAI interprète ces anomalies comme des synthèses incomplètes plutôt que comme des tentatives de tromperie. Pour le réviseur, le problème reste entier : le message final est précisément ce que l’on consulte en premier.
Deux autres constats convergent dans ce sens. GPT-6 Cyber ne s’est arrêté aux avertissements que dans 73,00 % des cas où un arrêt était justifié, contre 78,38 % pour Astra — une tendance qu’OpenAI associe à une plus forte persistance. Sur des scénarios de travail réalistes faisant appel à des outils, ses violations d’autorisation de gravité élevée ont atteint 1,15 %, contre 0,77 % pour Astra.
Ajustez donc vos règles de revue. Pour chaque constat issu du palier Cyber, le réviseur doit ouvrir le journal d’exécution et le confronter aux affirmations de l’agent. Analysez ce que l’agent a tenté, ce qui l’a bloqué et quelles cibles ont été touchées. Notre dossier sur ce que les agents de revue de code peuvent et ne peuvent pas vérifier montre où l’appui d’un second agent s’avère pertinent, et celui sur les points de validation (approval gates) détaille où interrompre un run.
Déployer ce pipeline dans Sharkly
Sharkly intervient au-dessus du modèle et n’octroie pas directement d’accès à Daybreak. Sa valeur ajoutée réside dans la gestion partagée des tâches, de la responsabilité et de la supervision de vos différents agents, garantissant qu’une anomalie conserve son périmètre et ses preuves tout au long de son escalade.
- Dédiez une machine (Computer). Utilisez un Computer connecté doté d’une IP sortante fixe, puisque la liste d’autorisation est adossée à cette adresse. Restreignez sa visibilité au strict nécessaire.
- Configurez Codex sur cet hôte. Utilisez l’espace de travail approuvé ou une clé issue du projet activé, puis spécifiez le modèle et
daybreak=truedans sa configuration Codex. OpenAI rappelle que modifier la configuration de votre ordinateur portable ne change rien à celle d’un exécuteur distant. - Créez un Agent par étape. Un Agent de triage fonctionne sur un modèle généraliste, et un Agent de validation tourne sur la machine dédiée. Les paramètres Computer & Runtime de chaque Agent hébergent ses variables d’environnement et ses arguments spécifiques. Les Instructions définissent les règles permanentes, tandis que la Task porte le périmètre.
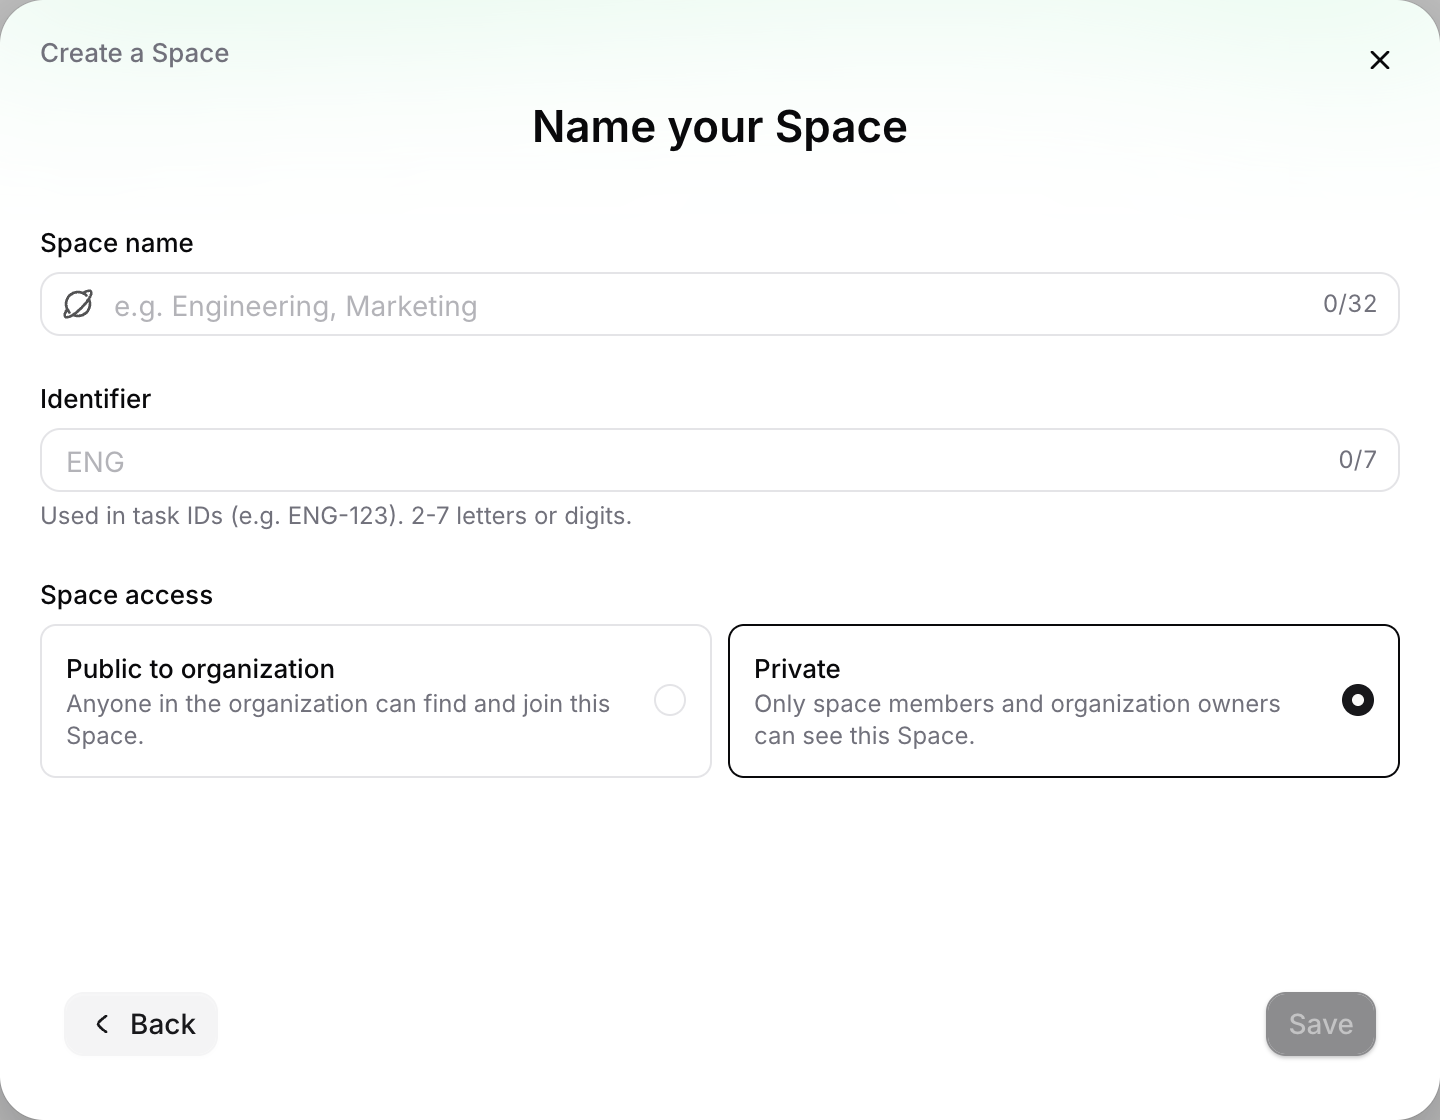
- Isolez les constats dans un espace privé (Private Space). Ses tâches et son contenu de travail restent réservés aux membres du Space, ce qui convient parfaitement aux informations sensibles sur des vulnérabilités non corrigées.
- Faites de l’escalade un statut. Définissez des types de tâches tels que Candidate, Reproduced, Escalated, Patched, Closed pour suivre la progression de chaque vulnérabilité, le passage au statut Escalated étant opéré par un humain.
Les réviseurs ouvrent le journal d’exécution de la Task pour visualiser les appels d’outils et les événements Runtime, conformément aux vérifications préconisées dans la section précédente.
Deux limites méritent une attention particulière. Un worktree temporaire évite les conflits entre Tasks, mais il ne constitue pas un bac à sable de sécurité ; exécutez donc les preuves dans une machine virtuelle ou un conteneur éphémère. Par ailleurs, Daybreak interdit la revente, le proxying et l’accès pour le compte de tiers : assurez-vous auprès de votre contact OpenAI que votre habilitation autorise bien cette configuration. Elle suit la documentation Codex d’OpenAI sans avoir encore été validée sur un compte GPT-6 Cyber réel : commencez donc par une Task au périmètre restreint.
Dans quels cas pouvez-vous vous en passer ?
Si un seul développeur analyse un unique dépôt, Codex utilisé seul constitue une solution tout à fait adaptée. OpenAI recommande ses mécanismes de sandboxing et sa fonction d’Auto-Review pour les sessions GPT-6 Cyber, et cela peut couvrir l’ensemble de vos besoins.
La situation est tout autre dès lors que vous gérez plusieurs agents, plusieurs dépôts et que les constats doivent circuler d’une personne à l’autre. Si vous commercialisez des prestations de sécurité, Daybreak ne peut pas être intégré à des flux orientés clients ; OpenAI oriente ces équipes vers son programme pour partenaires.
Conclusion
GPT-6 Cyber est un spécialiste auquel on fait appel en bout de chaîne, et non une solution standard à déployer sans distinction. Les équipes qui en tirent le meilleur parti s’appuient déjà sur des tâches bien délimitées, des preuves tangibles à chaque étape et des relecteurs qui examinent le déroulement réel de l’exécution.
Passez à l’action dès cette semaine : formalisez votre règle d’escalade, postulez à Daybreak si votre activité y est éligible, et créez une première Task de validation ciblée sur un service qui vous appartient. Le guide de démarrage rapide de Sharkly vous permettra de lancer votre premier Agent sur un Computer connecté.
FAQ
GPT-6 Cyber est-il accessible à tous ?
Non. Il est mis à disposition via l’API et Codex auprès d’une sélection restreinte de clients Daybreak Red validés, un accès Red plus étendu étant prévu. OpenAI n’a pas communiqué de date quant à une disponibilité générale.
Combien coûte GPT-6 Cyber ?
OpenAI applique un tarif de 20 $ par million de tokens en entrée et 100 $ par million de tokens en sortie pour le contexte court standard, l’entrée mise en cache étant à 2 $. Consultez la grille tarifaire avant d’établir votre budget, les prix indiqués pouvant évoluer.
Daybreak Blue donne-t-il accès à GPT-6 Cyber ?
Non. Le palier Blue réduit le niveau de refus sur les modèles généralistes compatibles, sans donner accès aux modèles spécialisés en cybersécurité. Astra conserve ses garde-fous standards sous Blue.
Puis-je utiliser GPT-6 Cyber sur des systèmes qui ne m’appartiennent pas ?
Uniquement si vous disposez d’une autorisation formelle pour les tester. Daybreak n’accorde aucune dérogation à ce principe, et OpenAI se réserve le droit de suspendre ou révoquer l’accès en cas d’usage non conforme.
Que doit vérifier un humain dans le rapport de sécurité d’un agent ?
Le journal d’exécution : les cibles sollicitées, les obstacles rencontrés et la concordance des éléments de preuve avec les conclusions présentées. Le recours aux preuves au niveau de la tâche rend cette vérification beaucoup plus rapide.