
Anthropic menyebut Claude Opus 5.5 40% lebih murah untuk dijalankan dibanding Opus 5. Seseorang di tim Anda pasti sudah melakukan hitungan yang kelihatannya jelas: dengan anggaran yang sama, jumlah run agent menjadi sekitar 1,7 kali lipat, jadi pekerjaan yang selesai juga sekitar 1,7 kali lebih banyak. Hitungan itu benar secara aritmetika tapi salah secara operasional, dan minggu ketika hitungan itu mulai dijadikan dasar adalah minggu ketika papan tugas Anda penuh dengan run yang sudah selesai tapi belum dibaca siapa pun.
Kendala untuk menjalankan lebih banyak agent secara paralel tidak pernah terletak pada tagihan model. Kendalanya adalah kapasitas satu orang untuk membaca diff, memahami apa yang diputuskan agent, dan menerimanya. Pemotongan harga tidak mengubah angka itu sedikit pun. Yang naik adalah seberapa cepat pekerjaan tiba di titik itu.
TL;DR
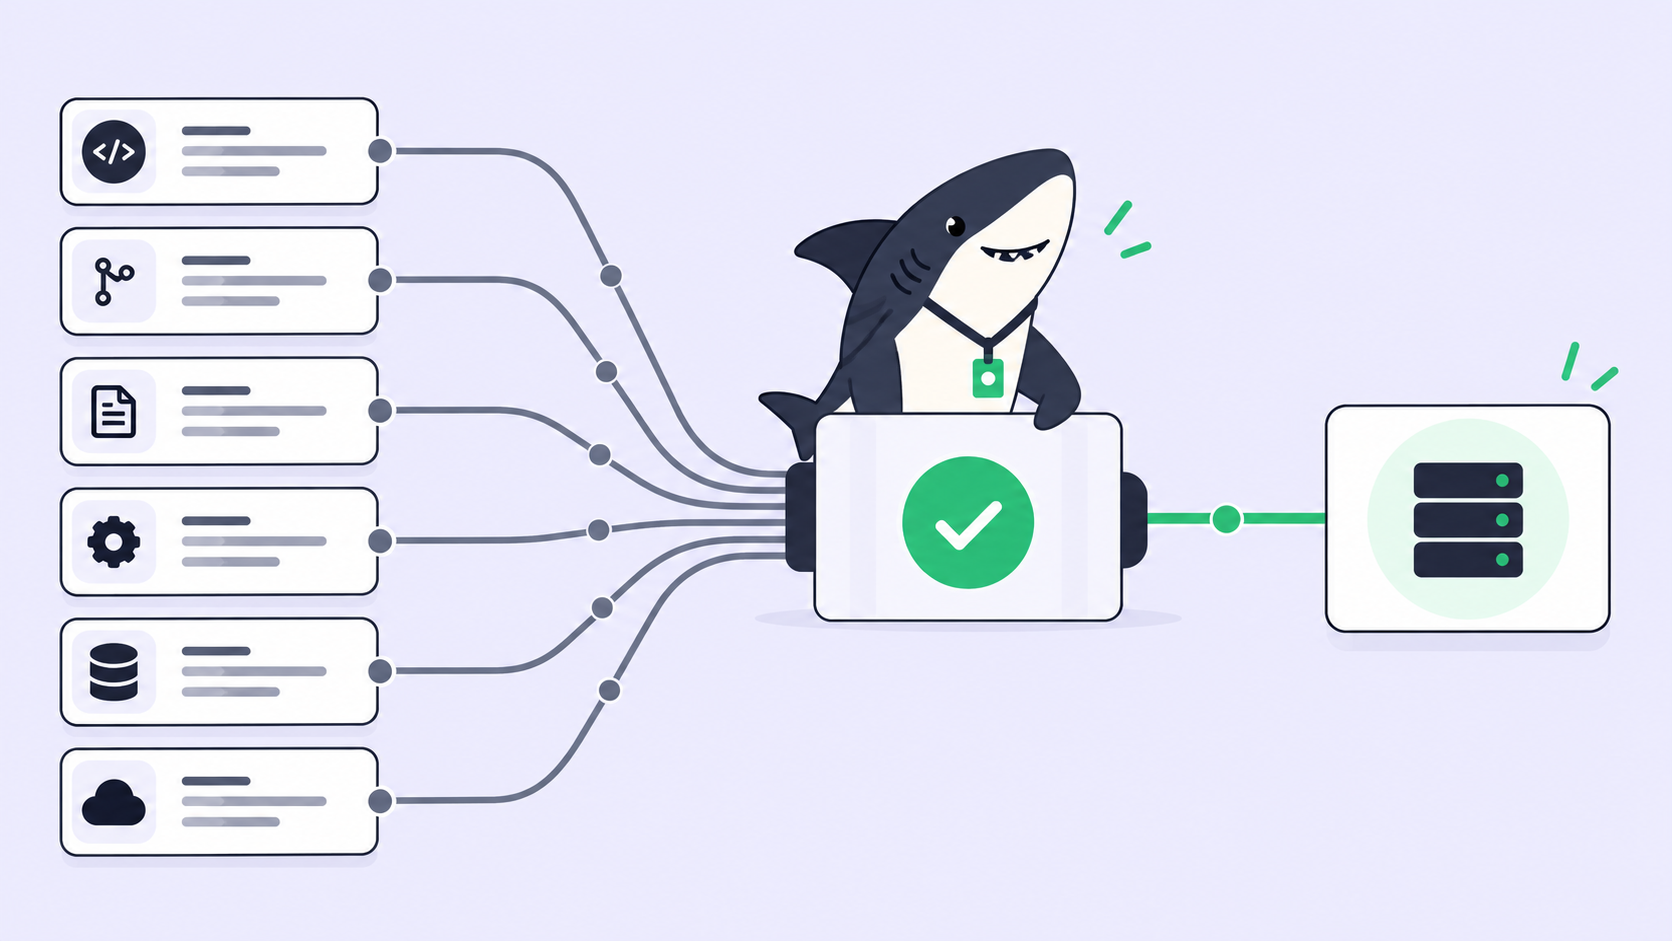
Batas review adalah jumlah run agent yang sudah selesai dan benar-benar bisa dibaca, dinilai, serta diterima sebuah tim dalam sehari, dan batas itu ditentukan oleh manusia, bukan oleh token. Model yang lebih murah menaikkan laju kedatangan pekerjaan di batas tersebut tanpa mengubah batasnya sendiri, jadi efek pertama yang terlihat dari pemotongan harga adalah antrean yang lebih panjang, bukan rilis yang lebih cepat. Agent melakukan riset, eksekusi, pengujian, dan pelaporan. Manusia yang menentukan arah, memberi wewenang, dan menerima hasilnya. Respons yang berguna adalah membatasi konkurensi berdasarkan jumlah reviewer, bukan berdasarkan anggaran, sekaligus memisahkan pekerjaan agent yang konvergen menjadi satu hasil yang bisa direview dari pekerjaan agent yang menyebar ke banyak hasil. Sharkly menjaga konteks, progres, blocker, hasil, dan review manusia tetap terlihat pada Task dari permintaan sampai rilis, dan itulah yang membuat antrean bisa dihitung sejak awal.
Apa yang sebenarnya jadi lebih murah
Dua lab merilis produk pada 2026-09-22. Berikut bagian yang menyentuh tagihan Anda.
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| ID API | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Input per 1 juta token | $5 | $4 | $2 | $0,10 |
| Output per 1 juta token | $25 | $20 | $10 | $0,50 |
| Input cache | n/a | $0,20 baca, $5 tulis | diskon 90% untuk baca | diskon 90% untuk baca |
Anthropic menyatakan Opus 5.5 40% lebih murah untuk dijalankan dibanding Opus 5 dan menghasilkan output sekitar 30% lebih cepat. Tarif resmi di atas adalah 20% lebih rendah dari harga token Opus 5, yang merupakan hitungan kami sendiri dari dua angka yang dipublikasikan dan merupakan klaim terpisah dari angka 40% tersebut. OpenAI menyatakan Sol dan Luna masing-masing 50% lebih murah dibanding harga promosi GPT-5.6, dan “promosi” adalah kata OpenAI sendiri, jadi angka utama itu diukur terhadap tarif diskon, bukan tarif resmi.
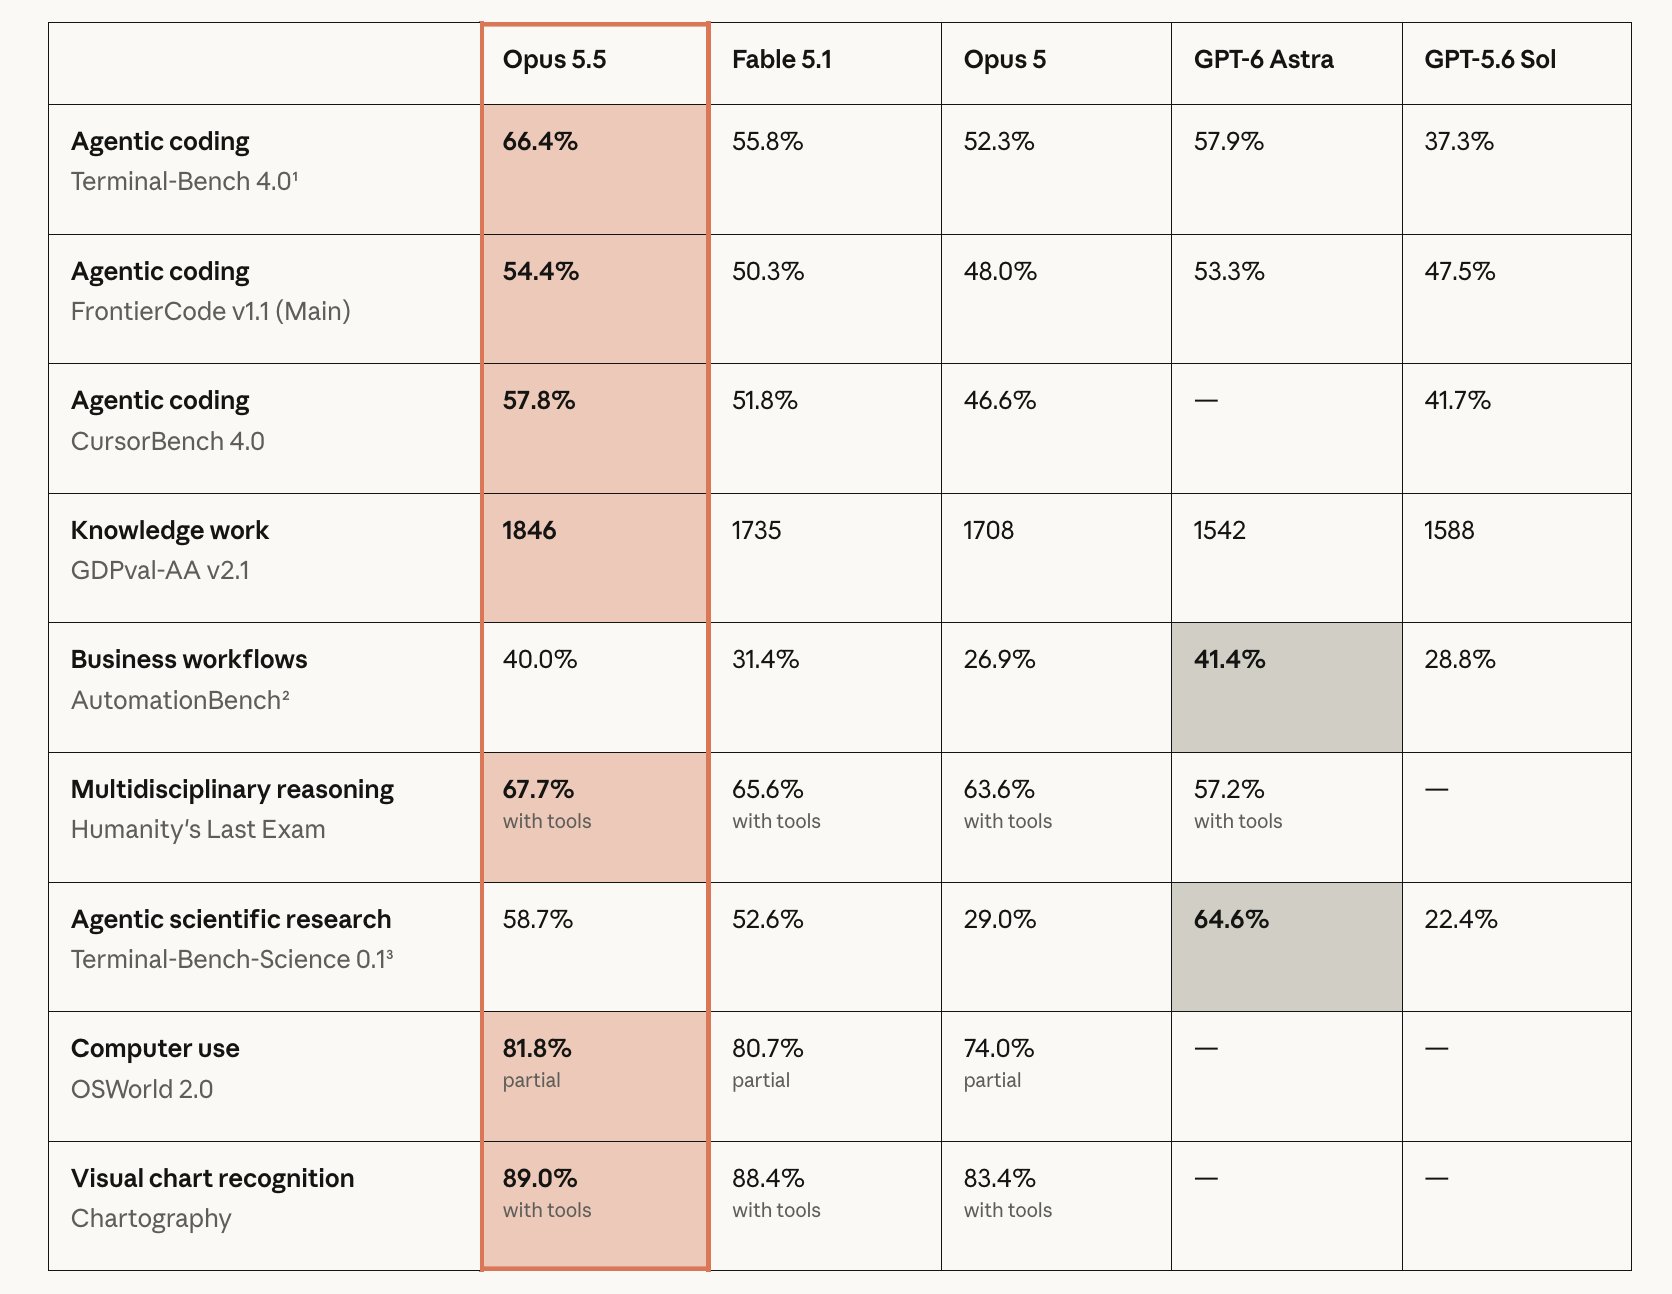
Biaya per tugas yang selesai bergerak lebih jauh daripada biaya per token. Pada AutomationBench 1.0.6, OpenAI melaporkan GPT-6 Sol pada extra high reasoning mencetak skor 33,2% dengan biaya $0,27 per tugas, dibandingkan Claude Opus 5 pada max reasoning yang mencetak 26,9% dengan biaya 11,1 kali lipat Sol. Pada DeepSWE 1.1, OpenAI menempatkan GPT-6 Luna pada max reasoning di angka 66,6% dan 93% lebih murah per tugas dibanding Opus 5.
Jadi harga sebuah percobaan turun sangat banyak, di dua vendor, dalam satu hari. Tidak ada hal lain dalam minggu Anda yang berubah.
Hitungan yang semua orang lakukan minggu ini
Tahan pengeluaran tetap, lalu bagi. Dengan biaya 40% lebih murah, angka bulanan yang sama membeli sekitar 1,67 kali lebih banyak run Opus 5.5 dibanding run Opus 5. Alihkan separuh pekerjaan rutin ke Luna dan pengalinya tidak lagi menarik, karena dengan $0,10 dan $0,50 per juta token, baris model bukan lagi hal yang Anda anggarkan.
Sekarang lakukan hitungan kedua, yang menentukan apakah semua itu benar-benar dirilis. Ambil jumlah run selesai yang bisa dibaca dengan benar oleh salah satu engineer Anda dalam sehari. Bukan sekadar dibaca cepat, bukan disetujui hanya karena ada centang hijau: baca diff-nya, pahami apa yang dipilih agent untuk dilakukan, dan terima tanggung jawab atasnya. Berapa pun angkanya, angka itu sama pada 2026-09-21 dan akan sama juga kuartal depan. Aritmetika kapasitas review sudah berakhir buruk bahkan sebelum ada pemotongan harga, dan pemotongan harga hanya mengubah sisi inputnya.
Pemotongan harga bukanlah penambahan kapasitas. Itu hanya perubahan pada seberapa murah menghasilkan sesuatu yang tetap membutuhkan manusia.
Petunjuknya: biaya bukan yang menghentikan Anda
Kalau biaya model adalah kendala yang mengikat, tim-tim pasti sudah menjalankan konfigurasi termurah yang berhasil. Nyatanya tidak. Data OpenAI sendiri menyebut peneliti median di organisasinya menjalankan inferensi lebih dari $600 sehari dengan harga API, dan persentil ke-90 menjalankan $7.000 sehari. Tabel benchmark yang dipublikasikan menunjukkan tim-tim sengaja memakai konfigurasi yang 11,1 kali lebih mahal per tugas untuk mendapatkan skor yang lebih rendah, karena hasil yang Anda percayai lebih berharga daripada hasil yang harus Anda periksa dua kali.
Itulah bentuk kendala yang sebenarnya. Orang bersedia membayar berkali-kali lipat untuk output yang butuh lebih sedikit pengawasan manusia per unitnya. Sumber daya langka yang dibeli adalah perhatian, bukan komputasi, dan itu sudah dibeli dengan premi yang mahal sejak awal.
Artinya, pemotongan harga berdampak asimetris. Sisi penghasil menjadi lebih murah, sementara sisi penerima tetap persis seperti sebelumnya.
Fan-out yang konvergen, dan fan-out yang berakhir di papan tugas
Inilah pembedaan yang membuat model murah benar-benar berguna alih-alih diam-diam mahal, dan inilah yang paling sering dilewatkan tim.
Sebagian paralelisme bersifat konvergen. Tiga agent mencoba migrasi yang sama di worktree yang terisolasi, sebuah test suite dan satu Agent pemimpin memilih yang lolos, dan satu hasil sampai ke manusia. Biayanya jadi tiga kali lipat, tapi beban review tidak berubah. Di sinilah pemotongan harga benar-benar membeli throughput nyata, dan di sinilah ekonomi baru layak membuat Anda mengubah setup.
Sebagian paralelisme bersifat divergen. Sepuluh agent mengambil sepuluh Task yang tidak berhubungan dan menghasilkan sepuluh diff, sepuluh ringkasan perubahan, dan sepuluh keputusan penerimaan. Biayanya tetap sepuluh run. Beban review-nya sepuluh kali lipat dari satu unit perhatian seseorang.
| Fan-out konvergen | Fan-out divergen | |
|---|---|---|
| Contoh | 3 percobaan untuk satu migrasi, yang terbaik menang | 10 Task, 10 Assignee, 10 diff |
| Apa yang dibeli model murah | Lebih banyak percobaan, peluang lebih besar ada yang bagus | Lebih banyak pekerjaan selesai yang menunggu |
| Item review yang dihasilkan | 1 | 10 |
| Aman diskalakan hanya berdasarkan harga | Ya | Tidak |
Gunakan model murah untuk melebarkan fan-out konvergen sejauh kesabaran Anda terhadap percobaan ulang. Jangan gunakan model murah untuk melebarkan fan-out divergen melebihi kapasitas reviewer Anda, tidak peduli seberapa terjangkau run-nya sekarang. Itulah pasangan keputusan yang jujur, dan bagian keduanya adalah yang memakan biaya kalau diabaikan.
Apa yang perlu diubah, bukan anggarannya
Batasi konkurensi berdasarkan reviewer, bukan berdasarkan pengeluaran. Tulis aturannya di tempat yang bisa dilihat Crew: Task terbuka yang menunggu penerimaan manusia tidak boleh melebihi jumlah reviewer yang bertugas dikalikan berapa banyak review yang bisa diselesaikan salah satunya dalam satu shift. Dua angka itu milik Anda, bukan milik kami. Ketika batasnya tercapai, agent berhenti mengambil Task baru meskipun anggarannya memungkinkan. Aturan routing tertulis lebih baik daripada sekadar preferensi di sini, karena preferensi diam-diam kalah oleh harga yang lebih murah.
Jadikan “menunggu manusia” sebagai status yang terlihat. Run yang sudah selesai dan run yang berhenti untuk menanyakan sesuatu terlihat sama dari luar, dan keduanya tidak terlihat kalau satu-satunya catatan hanyalah terminal. Eksekusi, blocker, hasil, dan diskusi lanjutan seharusnya kembali ke timeline Task, sehingga antrean menjadi sesuatu yang bisa dihitung, bukan sekadar perasaan yang muncul hari Jumat.
Hitung biaya review-nya, bukan tokennya. Pelacakan biaya lintas agent yang melaporkan dolar per run menjawab pertanyaan yang sudah tidak lagi mengikat. Angka yang layak ditampilkan di dashboard adalah menit manusia per perubahan yang diterima. Kalau angka itu naik setelah Anda beralih ke model yang lebih murah, berarti model yang lebih murah itu justru lebih mahal.
Belanjakan sebagian penghematan untuk bukti. Run yang melampirkan typecheck, hasil tes, ringkasan perubahan, dan batasan yang diketahui membutuhkan lebih banyak token tapi lebih sedikit perhatian. Dengan $0,20 per juta pembacaan input cache di Opus 5.5 dan diskon 90% untuk pembacaan cache di GPT-6, proses verifikasi tambahan nyaris gratis dan mengembalikan sumber daya yang sebenarnya langka.
Apa artinya untuk minggu ini
Dua lab memotong harga sebuah percobaan di hari yang sama, dan salah satunya melakukan benchmark terhadap model yang sudah digantikan beberapa jam kemudian. Tidak ada dari keduanya yang merilis sesuatu yang bisa membaca diff untuk Anda. Kepemilikan manusia atas pekerjaan adalah bagian yang tidak menjadi 40% lebih murah, dan itulah bagian yang menentukan apa yang sampai ke produksi.
Kalau Anda sudah menjalankan beberapa coding agent, langkah berguna minggu ini bukan menaikkan angka konkurensi. Melainkan mencari tahu berapa batas review Anda yang sebenarnya, lalu menetapkan konkurensi agar sesuai dengannya. Sharkly memberi Anda satu tempat untuk melihat run, blocker, hasil, dan antrean pekerjaan yang menunggu diterima oleh manusia.


