
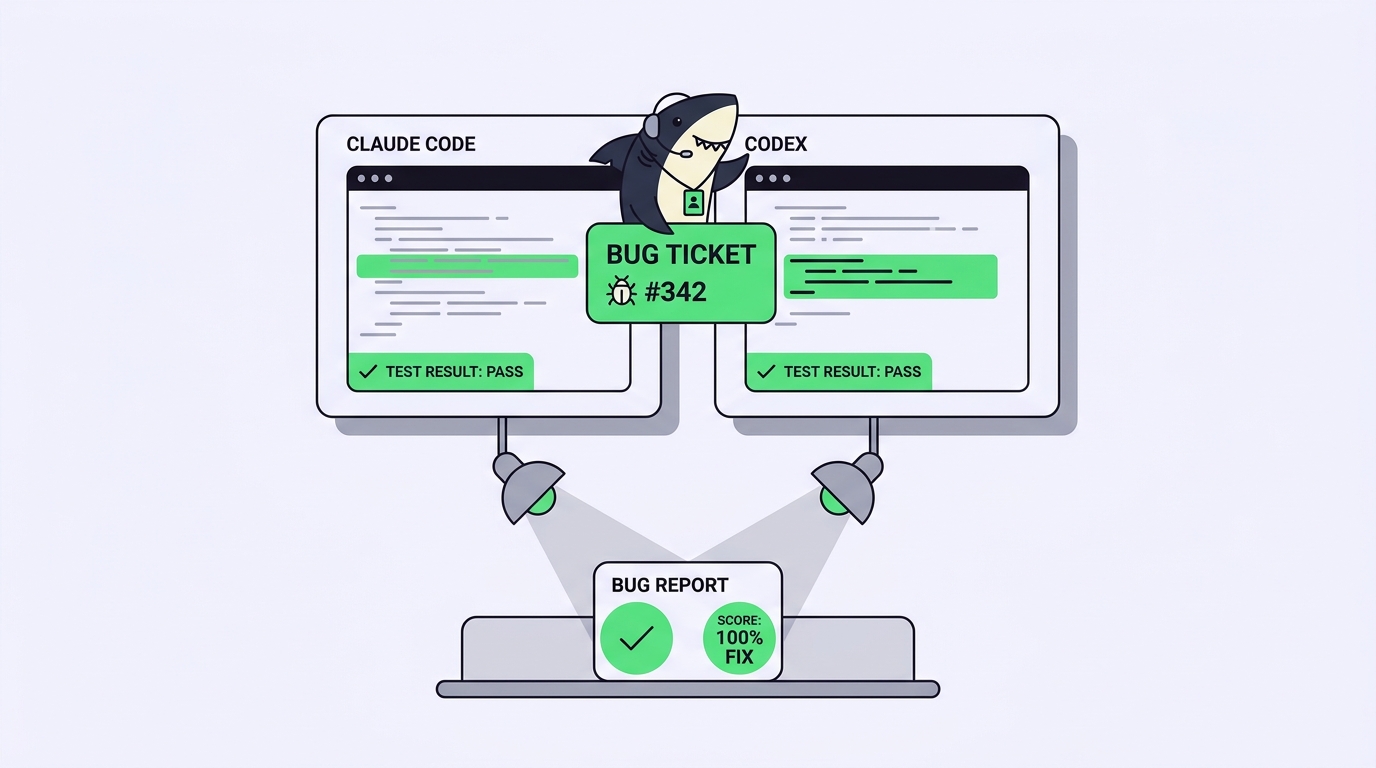
Ada bug nyata yang sedang terbuka, dan dua agen yang bisa memperbaikinya: Claude Code dan Codex. Tab browser penuh dengan pendapat soal mana yang lebih pintar, tapi tak satu pun memberi tahu Anda agen mana yang harus diarahkan ke bug ini, di repositori ini, hari ini. Angka benchmark publik juga tidak. Papan peringkat mengukur sekumpulan masalah open-source yang sudah tetap dengan harness yang sudah disetel. Bug Anda adalah masalah privat: konvensi Anda, flaky test Anda, modul yang hanya dipahami satu orang.
Cara jujur untuk menjawab “Claude Code atau Codex” adalah menjalankan keduanya pada bug yang sama, dalam kondisi yang sama, lalu membaca apa yang masing-masing serahkan. Kedengarannya sederhana, tapi cepat berubah jadi kekacauan: dua agen mengedit file yang sama, dua terminal, dua set output pengujian, dan tidak ada cara rapi untuk membandingkannya berdampingan. Perbandingan yang Anda inginkan adalah soal agennya. Pekerjaan yang ada di depan Anda adalah mencegah keduanya bertabrakan.
Tabrakan itulah yang dihilangkan oleh Sharkly. Sharkly adalah platform perintah dan manajemen Agent serba-satu: Anda menetapkan Task yang sama ke dua Agent berbeda, masing-masing berjalan di Computer yang terhubung dalam worktree terisolasi miliknya sendiri, dan setiap eksekusi mengembalikan diff, hasil pengujian, serta review-nya ke satu tempat. Sharkly bukan pengganti Claude Code atau Codex, dan bukan harness benchmark. Sharkly adalah lapisan yang membuat adu langsung yang adil bisa dilakukan tanpa membuka terminal kedua. Panduan ini membahas metodenya, rubrik penilaian untuk satu bug, dan di mana masing-masing agen cenderung menang.
Jawaban singkat
Untuk membandingkan Claude Code dan Codex secara jujur, berikan keduanya bug yang identik, commit awal yang sama, dan acceptance test yang sama, dengan masing-masing berjalan pada konfigurasi terbaiknya. Lalu nilai apa yang kembali: apakah perbaikannya lulus, apakah diff-nya tetap dalam lingkup, dan berapa lama Anda perlu me-review perubahan itu. Agen yang menang di satu bug baru menang di satu bug. Jalankan metode ini pada beberapa bug sebelum Anda memercayai kesimpulannya.
Mengapa “mana yang lebih baik” adalah pertanyaan yang salah
Claude Code dan Codex sama-sama agen coding yang mengutamakan terminal. Keduanya membaca repositori Anda, mengedit file, menjalankan perintah, dan melaporkan hasilnya. Keduanya berbeda dalam cara Anda mengonfigurasinya dan cara mereka berperilaku saat tertekan, tapi tidak ada yang unggul secara universal untuk pekerjaan yang mengisi sprint normal.
Satu peringkat global justru menyembunyikan bagian yang Anda pedulikan. “Mana yang lebih baik” merangkum semuanya menjadi satu angka yang tidak bertahan begitu bersentuhan dengan basis kode Anda. “Mana yang lebih baik untuk jenis bug ini, di repo saya, saat review” bisa dijawab, dan hanya versi itulah yang layak diperjuangkan. Jika Anda masih menentukan model apa yang harus dijalankan tiap agen, mencocokkan model dengan peran agen adalah pertanyaan pertama yang lebih baik daripada papan peringkat mana pun.
Jalankan keduanya pada bug yang sama: metode yang bisa Anda percaya
Perbandingan yang adil menjaga semua hal tetap konstan kecuali agennya. Empat aturan membuatnya demikian.
- Pilih satu bug nyata, bukan prompt mainan. Ambil satu defect terbatas dari backlog Anda yang punya acceptance test yang bisa dijalankan dan diff yang bisa Anda baca dalam beberapa menit. Tuliskan sebagaimana Anda akan menuliskannya di tracker: task seperti
SH-312: fix the timezone drift in the invoice export. “Build a todo app” tidak memberi tahu apa pun tentang kode Anda. - Beri keduanya input yang identik. Deskripsi task yang sama, commit awal yang sama, kriteria penerimaan yang sama. Jika Claude Code mendapat prompt yang lebih kaya daripada Codex, Anda sedang mengukur prompt Anda, bukan agennya.
- Jalankan masing-masing pada performa terbaiknya. Beri Claude Code
CLAUDE.md-nya, beri CodexAGENTS.mddan konfigurasinya, dan beri masing-masing izin serta model yang direkomendasikan dokumentasinya sendiri. Membandingkan agen yang sudah disiapkan dengan baik melawan agen yang masih polos hanya mengukur mana yang Anda repotkan untuk dikonfigurasi. - Isolasi kedua eksekusi. Setiap agen butuh salinan kerjanya sendiri. Dua agen di satu checkout akan saling menimpa, dan Anda akan menghabiskan sore hari untuk mengurai merge alih-alih membaca dua percobaan yang bersih. Inilah gunanya worktree terisolasi.
Jalankan kedua percobaan itu, lalu buang branch yang kalah. Anda menyimpan perbaikan yang Anda percayai beserta bukti alasannya.
Rubrik penilaian untuk satu perbaikan bug
“Apakah lulus” hanyalah satu bit informasi. Perbaikan yang sesungguhnya ditentukan oleh lebih dari itu, dan menuliskan rubriknya sebelum Anda melihat hasilnya membuat perbandingan tetap jujur.
| Yang dinilai | Pertanyaan yang dijawabnya | Mengapa penting |
|---|---|---|
| Kebenaran | Apakah acceptance test lulus, dan apakah tidak ada hal lain yang rusak? | Batas minimum. Agen yang mencetak “done” belum meluluskan apa pun. |
| Disiplin lingkup | Apakah diff-nya hanya menyentuh hal yang dibutuhkan bug itu? | Perbaikan yang menulis ulang empat file tak berhubungan lebih mahal untuk di-review daripada manfaat yang diberikannya. |
| Kualitas tes | Apakah agen menambah atau memperbarui tes yang akan menangkap regresi itu? | Perbaikan tanpa tes adalah perbaikan yang akan Anda ulangi lagi. |
| Waktu review | Berapa lama sampai Anda memercayai perubahan itu? | Sering kali menjadi hambatan sesungguhnya, dan mudah diabaikan sampai akhirnya menguras waktu Anda seharian. |
| Kejujuran | Apakah agen menandai batas dan asumsinya sendiri? | Eksekusi yang bisa Anda percayai adalah yang memberi tahu apa yang tidak diverifikasinya. |
Nilai kedua percobaan pada lima kriteria yang sama, untuk bug yang sama, dan pemenangnya tak lagi soal selera. Waktu review layak diberi bobot lebih: dua agen bisa sama-sama selesai dalam dua puluh menit tapi tetap butuh satu jam masing-masing untuk diperiksa. Satu jam itu sering menjadi batas nyata seberapa banyak pekerjaan agen yang bisa diserap sebuah tim.
Di mana masing-masing cenderung menang
Tidak ada angka yang dikarang di sini, hanya hal-hal yang perlu diperhatikan. Claude Code mengandalkan memori proyek CLAUDE.md-nya dan cenderung tetap mengikuti konvensi repositori pada perubahan lintas file, yang terlihat pada refactor yang mencakup beberapa modul. Codex nyaman dalam setup sandbox yang digerakkan konfigurasi dan sering menyusun kode baru beserta tesnya dengan rapi, yang terlihat pada perbaikan yang cakupannya terbatas. Keduanya makin sering menyimpang seiring bertumbuhnya repo, dan keduanya akan dengan percaya diri menyerahkan perubahan yang tidak lulus. Uji dengan bug Anda sendiri sebelum menganggap semua ini sebagai kesimpulan final.
Inilah bagian jujur yang dilewatkan sebagian besar perbandingan. Jika Anda hanya memakai satu agen dan bekerja di satu terminal, Anda tidak perlu platform untuk menjalankan ini. Sesi Claude Code yang tertata baik di satu worktree, atau satu eksekusi Codex, sudah cukup, dan Anda bisa memeriksa diff-nya sendiri. Persamaannya berubah begitu Anda membandingkan dua agen, pada lebih dari satu bug, dan Anda ingin hasilnya dalam bentuk yang bisa dibaca orang lain.
Menjalankan adu langsung di Sharkly
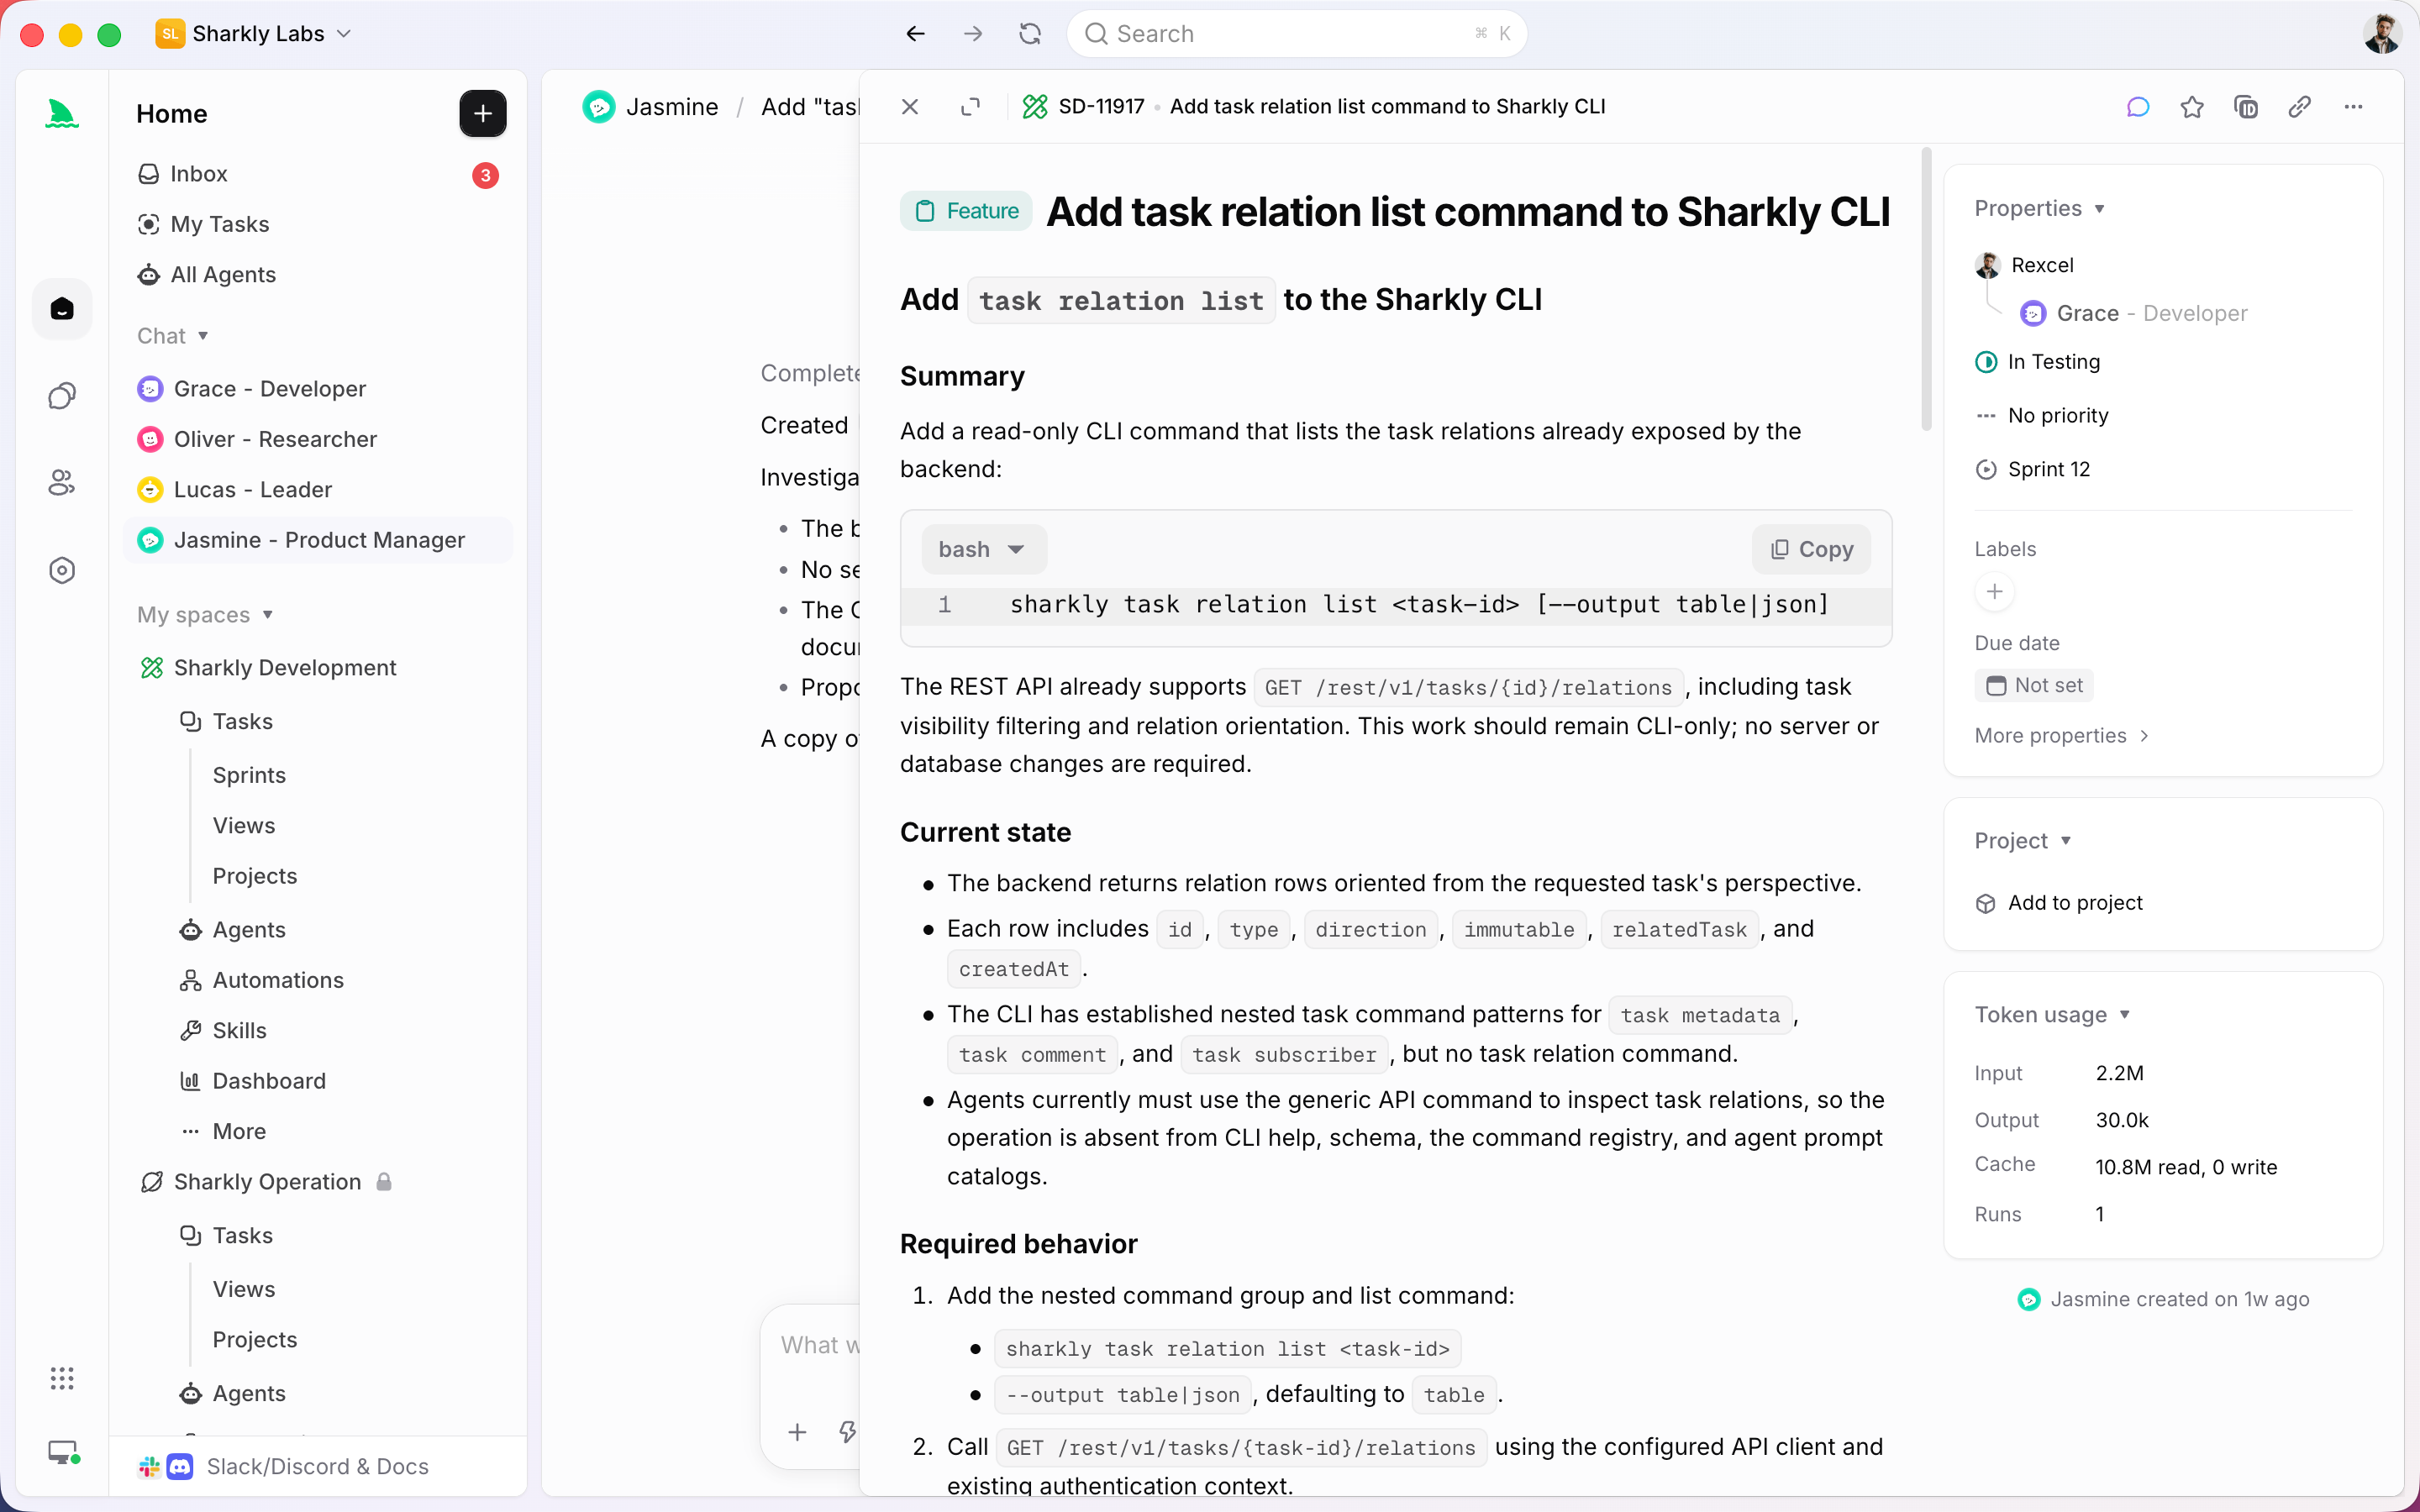
Di sinilah Sharkly membuktikan nilainya. Anda membuat satu Task untuk bug itu, lalu menugaskannya ke Agent Claude Code dan Agent Codex sekaligus. Setiap Agent berjalan di Computer yang terhubung dalam worktree-nya sendiri, sehingga kedua percobaan tidak pernah menyentuh file yang sama. Eksekusi, penghambat, hasil, dan ringkasan perubahan kembali ke timeline Task, dan Anda bisa membaca dua diff serta dua hasil pengujian secara berdampingan dalam satu tampilan, tanpa perlu mengingat terminal mana memuat yang mana.
Pembagian kerjanya tetap jelas. Agen meneliti, mengeksekusi, menguji, dan melaporkan. Manusia menetapkan arah dan menerima hasilnya. Otomatisasi berhenti di titik yang membutuhkan penilaian Anda, dan Sharkly menjaga konteks, kemajuan, penghambat, hasil, serta review manusia tetap terlihat dari permintaan hingga rilis. Anda tidak menyerahkan keputusan ke sebuah alat; Anda mendapatkan kedua percobaan yang sudah tertata rapi sehingga hanya butuh hitungan menit. Ketika Anda ingin mempertahankan kedua agen untuk pekerjaan sehari-hari alih-alih sekadar uji coba sekali pakai, menjalankan Claude Code dan Codex bersamaan di satu basis kode adalah alur kerja yang sama, hanya dibuat rutin.
Mana yang sebaiknya dipilih, menurut ukuran tim
Pilihan yang tepat bergantung pada siapa yang memilih dan seberapa lama hasil perbandingan itu harus bertahan.
| Ukuran tim | Yang paling diberi bobot | Yang sebaiknya dipilih |
|---|---|---|
| Developer solo | Waktu review dan eksekusi di mesin sendiri | Agen mana pun yang paling cepat Anda review; Andalah satu-satunya pembaca |
| Tim kecil | Eksekusi paralel dan visibilitas bersama | Keduanya, ditugaskan melalui satu Task agar semua orang melihat bukti yang sama |
| Tim platform | Integrasi dan netralitas penyedia | Pertahankan keduanya; alur kerja harus tetap jalan apa pun agen yang memimpin kuartal berikutnya |
Baris terakhir itulah alasan sesungguhnya untuk menjalankan perbandingan, bukan memilih favorit lalu membelanya. Agen terbaik kuartal ini belum tentu yang terbaik kuartal depan, dan membangun ulang proses setiap kali pemimpinnya berganti adalah beban tersendiri. Membandingkan pada bug Anda sendiri, dalam alur kerja yang bisa menjalankan agen apa pun, membuat Anda bebas berpindah saat jawabannya berubah.
Jika Anda ingin terus memakai beberapa agen coding alih-alih terikat pada satu ekosistem, itulah masalah yang dirancang untuk dipecahkan Sharkly. Unduh Sharkly, hubungkan satu Computer, dan tugaskan bug nyata yang sama ke kedua agen. Putusan yang Anda dapatkan kembali adalah tentang basis kode Anda, satu-satunya yang bisa memprediksi minggu Anda.
FAQ
Mana yang lebih baik dalam memperbaiki bug, Claude Code atau Codex? Tidak ada yang menang secara umum. Pada bug yang sama, dengan konfigurasi terbaik masing-masing, biasanya salah satu sedikit lebih unggul, dan siapa yang unggul bisa berbalik tergantung jenis bug dan ukuran repo. Jalankan keduanya pada defect nyata dari backlog Anda lalu nilai kebenaran, lingkup, tes, dan waktu review.
Bisakah saya menjalankan Claude Code dan Codex pada bug yang sama secara bersamaan? Bisa, asalkan masing-masing punya salinan kerjanya sendiri. Dua agen di satu checkout akan saling menimpa. Beri masing-masing worktree terisolasi, atau tugaskan Task-nya ke keduanya di Sharkly dan biarkan setiap Agent berjalan di Computer-nya masing-masing.
Apakah skor benchmark memberi tahu saya agen mana yang harus dipakai? Skor itu memberi tahu agen mana yang layak diuji, bukan bagaimana perilaku agen di repositori Anda. Dataset publik tidak akan pernah memuat library internal Anda, konfigurasi lint Anda, atau modul yang belum Anda uji. Anggap papan peringkat sebagai filter, lalu jalankan perbandingan yang benar-benar bermakna pada kode Anda sendiri.
Apakah Sharkly menggantikan Claude Code atau Codex? Tidak. Sharkly adalah lapisan penugasan, konteks, dan review di sekitar agen coding yang sudah tim Anda jalankan. Agen melakukan eksekusi; Sharkly mengelola Task, menjaga eksekusi tetap terlihat, dan menyerahkan penerimaan hasil kepada manusia.
Berapa banyak bug yang harus saya bandingkan sebelum memutuskan? Satu bug hanya memberi tahu tentang satu bug. Jalankan metode ini pada beberapa jenis defect sebelum Anda memercayai sebuah pola, dan jaga rubriknya tetap identik setiap kali agar hasilnya bisa ditumpuk dan dibandingkan.


