
TL;DR: Sebuah tim di MIT CSAIL membuat sebuah frontier model membaca dan mengedit bobot Qwen3.5-0.8B di dalam sandbox Python, dengan anggaran forward pass yang ketat dan log lengkap untuk setiap langkah. Para penulis melaporkan MATH-500 naik dari 7,9% menjadi 48,1%. Anda bisa membiarkan coding agent mengedit bobot model dengan cara yang sama: lima tugas di sebuah board, anggaran yang dituliskan di setiap tugas, agen kedua untuk eval, dan satu orang yang menyetujui file hasil edit.
Pada 2 November 2026, Rikiya Takehi, Jayden Teoh, Alex Zhang, dan Omar Khattab menerbitkan Sparks of Weight-Space Programming. Model dalam penelitian mereka, GPT-6 Astra, membuka tensor bobot, menulis kode numpy dan PyTorch untuk mengolahnya, menyusun hipotesis, dan mengubah 131.072 angka dalam model berparameter 0,8B.
Baca pengaturannya dan semuanya terasa familiar: sandbox, anggaran tool, log untuk setiap prompt dan sel yang dieksekusi. Itu adalah coding agent dengan harness, dan harness itulah bagian yang bisa tim Anda tiru hari ini.
Apa yang dilakukan tim MIT, dalam angka
Weight-space programming berarti sebuah LLM membaca parameter jaringan sebagai data dan mengeditnya secara langsung, tanpa gradient descent dan tanpa proses training. Tulisan MIT tersebut melaporkan hal ini pada model-model kecil, di bawah batas tool yang ketat, dengan setiap langkah tercatat dalam log.
Hasil utamanya adalah pengeditan Qwen3.5-0.8B:
| Metrik (angka dari penulis) | Model dasar | Model hasil edit |
|---|---|---|
| MATH-500 | 7,9% | 48,1% |
| GSM8K | 13,8% | 67,1% |
| IFEval | 21,0% | 62,3% |
| Run yang mencapai batas 32.768 token | 93,0% | 33,1% |
Astra melacak kebiasaan model yang terus mengulang hingga kehabisan token ke satu arah yang ditulis oleh MLP di layer 15 dan 19, lalu menguranginya dari 64 kolom output di masing-masing layer: 131.072 bobot, atau 0,016% dari model. Checkpoint yang dipublikasikan berlisensi Apache-2.0, dan kartunya menyatakan hanya dua tensor yang berbeda dari model dasarnya: matriks down_proj.weight di kedua layer tersebut.
Mengapa harness menentukan hasilnya
Ada dua temuan dalam tulisan tersebut yang lebih penting bagi sebuah tim daripada hasil utamanya.
Anggaran mengubah hasil. Setiap forward pass rata-rata memproses batch berisi 64 sekuens. Dengan 10 pass, MATH-500 mencapai 12,3%. Dengan 25 pass, mencapai 14,1%. Dengan 50 pass, mencapai 48,1%. Model sama, tugas sama, tetapi batas berapa kali agen boleh menguji sebuah ide berbeda.
Tool-nya mengubah hasil. Hanya dengan diberi bobot dua varian Gemma 3 270M, Astra tidak bisa menentukan mana yang bersikap menjilat dalam empat percobaan. Ketika diberi tool yang mengembalikan attention weight atas sampai 16 teks yang ia tulis sendiri, ia berhasil menunjuk model yang menjilat itu di ketiga pasangan.
Jadi ada dua tuas: seberapa banyak yang boleh dibelanjakan agen dan apa yang boleh dilihatnya. Keduanya harus dituliskan sebelum run dimulai.
Keterbatasannya juga sama jelas. Astra tidak dapat meningkatkan Gemma 3 270M pada MATH-500: dari dasar 6,8%, hasil edit terbaiknya hanya mencapai 7,7%. Para penulis menafsirkan ini sebagai pengeditan yang menghilangkan hambatan, bukan menambahkan kemampuan yang belum dimiliki model. Mereka menyebut temuan-temuan ini masih awal, dan beberapa di antaranya hanya berasal dari satu kali run. Rancang eksperimen Anda sendiri sebagai pengujian, bukan sebagai perbaikan.
Cara membiarkan coding agent mengedit bobot model dengan aman
Eksperimen weight-space yang aman memiliki lima sifat:
- Bobot asli bersifat read-only bagi setiap agen.
- Anggaran forward pass adalah angka yang tertulis di tugas dan ditegakkan oleh sandbox.
- Set eval yang dilihat editor terpisah dari set regresi yang dijalankan reviewer.
- Log setiap run tetap terlampir pada tahap yang bersangkutan.
- Ada orang yang menyetujui file hasil edit sebelum apa pun memuatnya di luar sandbox.
Sharkly tidak menghitung forward pass atau memeriksa tensor. Skrip sandbox Anda yang melakukannya, dan runtime Anda (Claude Code, Codex, atau agen lain yang sudah Anda jalankan) yang melakukan pembacaan dan pengeditan. Sharkly menampung pekerjaannya: siapa yang bertanggung jawab atas tiap tahap, berapa yang boleh dibelanjakan, apa yang dihasilkan, dan siapa yang menyetujuinya. Repositori log milik tim MIT sendiri menyimpan folder harness/ berisi konfigurasi Codex dan skrip sandbox, yang berguna sebagai referensi untuk sisi sandbox.
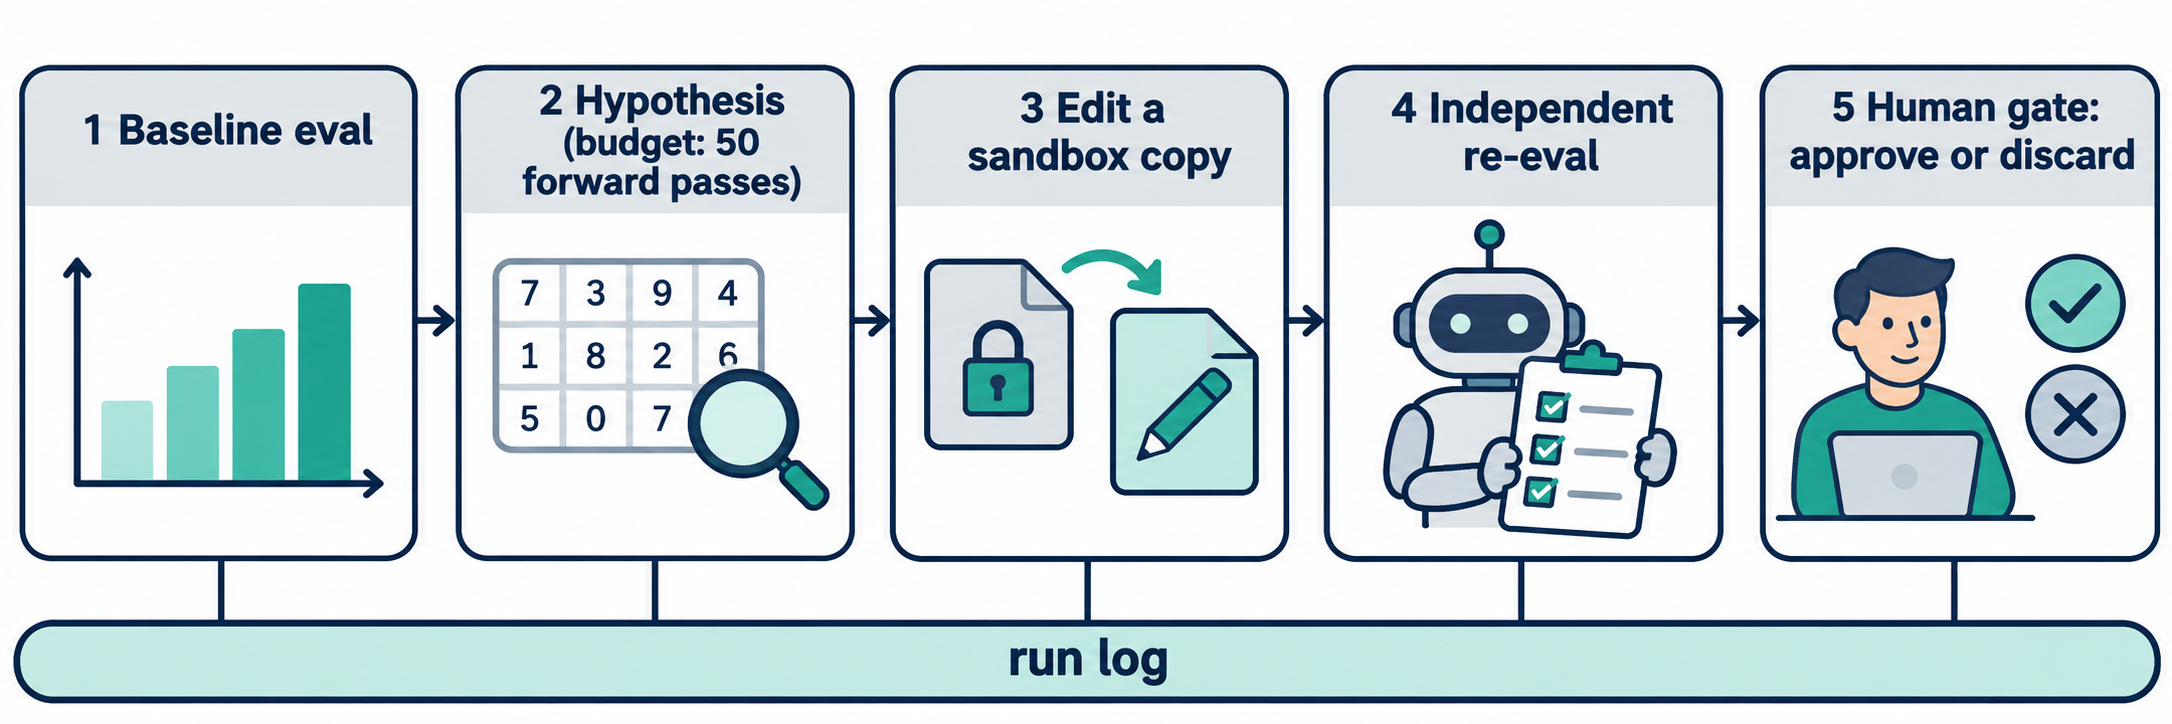
Tahap 1: Eval baseline pada model yang belum disentuh
Tugas pertama menjalankan eval Anda pada checkpoint asli dan mencatat skor serta bagian mana yang gagal. Untuk Qwen3.5-0.8B, 93,0% run mencapai batas token. Tugas hipotesis membutuhkan deskripsi kegagalan itu.
Tahap 2: Baca bobot dan tulis hipotesis
Inilah tugas yang memuat anggaran. Cantumkan angkanya di isi tugas, dalam bentuk yang tidak mungkin salah dibaca oleh agen:
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
Anggaran di dalam tugas hanyalah janji; anggaran di wrapper sandbox adalah jaminannya. Tulis keduanya, dan buat wrapper mencetak jumlah pass yang digunakan agar angkanya masuk ke log run.
Tahap 3: Lakukan pengeditan pada salinan di sandbox
Agen editor mengubah salinan checkpoint dan melaporkan diff-nya. Ia tidak pernah mendapat akses tulis ke file asli. Di Sharkly, setiap run tugas mendapat direktori terisolasi sendiri, dan pekerjaan repositori dapat menggunakan worktree terpisah untuk setiap run, sehingga tahap 3 tidak bisa menyentuh apa yang diukur pada tahap 1.
Tahap 4: Eval ulang independen oleh agen reviewer
Tetapkan tahap ini ke agen yang berbeda dari agen yang melakukan pengeditan. Agen ini menjalankan ulang eval tahap 1 dan menambahkan set regresi yang belum pernah dilihat editor. Jika Anda menjalankan sebuah Crew, leader dapat menyerahkan hasil edit ke satu anggota dan eval ulang ke anggota lain. Pola ini sama dengan mixed-model Crew dengan reviewer terpisah: agen yang menulis perubahan bukanlah agen yang menilainya.
Editor mengoptimalkan berdasarkan apa yang bisa dilihatnya, jadi peningkatan yang hanya muncul pada soal-soal itu tidak membuktikan banyak hal.
Tahap 5: Gerbang manusia pada diff
Tugas terakhir sampai ke seseorang dengan tiga lampiran: daftar tensor yang berubah, tabel sebelum dan sesudah, serta hasil regresi dari reviewer. Tidak ada yang memuat checkpoint hasil edit di luar sandbox sampai tugas ini berpindah status.
Skrip singkat ini menghasilkan lampiran pertama. Skrip ini membandingkan dua checkpoint safetensors dan mendaftar setiap tensor yang berubah:
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
Pada checkpoint yang dipublikasikan, kartu model menyatakan Anda seharusnya melihat tepat dua tensor down_proj.weight. Jika hasil edit Anda sendiri menyentuh tensor yang tidak pernah disebut dalam hipotesis, itulah alasan untuk membuangnya.
Menjalankan board di Sharkly
Berikut board untuk satu eksperimen. Setiap baris adalah tugas dengan assignee, status, dan riwayat run-nya sendiri.
| Tugas | Assignee | Anggaran atau gerbang | Selesai jika |
|---|---|---|---|
| 1. Eval baseline | Agen eval | Hanya set eval | Skor dan catatan kegagalan diposting |
| 2. Hipotesis dari bobot | Agen editor | 50 forward pass | Hipotesis diposting, jumlah pass yang digunakan tercatat |
| 3. Pengeditan di sandbox | Agen editor | Hanya salinan, file asli read-only | Diff dan file hasil edit ada di sandbox |
| 4. Eval ulang dan regresi | Agen reviewer | Set regresi held-out | Tabel sebelum/sesudah diposting |
| 5. Setujui atau buang | Seorang manusia | Gerbang manusia | Keputusan tercatat pada tugas |
Hubungkan tiap tahap dengan relasi blocks agar board menampilkan rantainya. Relasi tugas di Sharkly jujur soal batas kemampuannya: sebuah relasi menunjukkan ketergantungan dan progres pada kartu, tetapi tidak memindahkan tugas atau memulai run dengan sendirinya. Biarkan setiap tahap tetap di Backlog sampai tahap sebelumnya selesai. Tugas yang ditugaskan ke agen tidak memulai run selama masih berada di Backlog, jadi memindahkannya keluar adalah pemicunya.
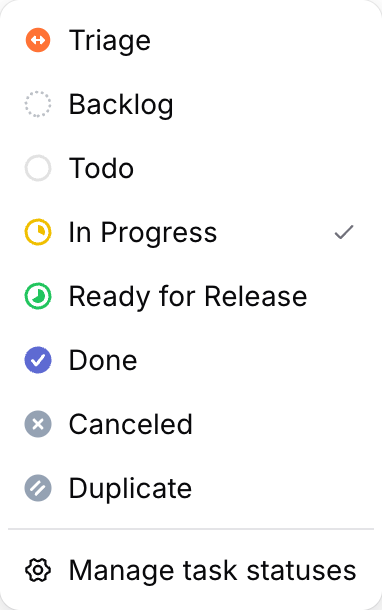
Ketika tahap 4 selesai, agen dapat membiarkan tugas menunggu review manusia, dan orang tersebut melihatnya di Inbox. Log eksekusi mencatat waktu mulai, waktu selesai, panggilan tool, dan pemicu setiap run: jejak audit Anda, tersimpan pada tahap yang bersangkutan. Untuk lebih lanjut soal di mana harus menghentikan agen, lihat gerbang persetujuan untuk coding agent.
Batasan praktis sebelum Anda mulai
- Mulai dari yang kecil. Studi ini menggunakan model 0,8B dan 270M dengan akses tensor di CPU. Pilih model yang bisa Anda evaluasi dalam hitungan menit.
- Jangan berharap ada peningkatan pada kemampuan yang tidak dimiliki. Hasil pada Gemma menunjukkan bahwa pengeditan dapat membuka hambatan pada model, bukan mengajarinya.
- Anggap satu kali run hanya sebagai anekdot. Ulangi eksperimen dengan agen yang baru sebelum Anda memercayai hasil edit tersebut.
Kesimpulan
Pelajaran yang bisa dipakai ulang dari tulisan MIT adalah harness-nya: anggaran yang tertulis, tool yang terbatas, log yang lengkap, dan hasil yang bisa diperiksa orang lain. Itulah kontrol yang memang sudah Anda inginkan di sekitar coding agent yang mengedit kode.
Untuk mencobanya, buat kelima tugas tersebut di sebuah Sharkly Space, tugaskan tahap 1 sampai 4 ke agen di Computer yang terhubung, dan simpan tahap 5 untuk diri Anda sendiri. Sharkly gratis untuk memulai di sharkly.ai.
FAQ
Bisakah coding agent mengedit bobot model?
Dalam studi MIT CSAIL, bisa. GPT-6 Astra membaca tensor Qwen3.5-0.8B di sandbox Python dan mengubah 131.072 bobot. Para penulis melaporkan MATH-500 naik dari 7,9% menjadi 48,1%. Penelitian ini masih awal, dilakukan pada model kecil, dan beberapa hasilnya hanya berasal dari satu kali run.
Apa itu weight-space programming?
Sebuah LLM membaca parameter jaringan sebagai data dan mengeditnya secara langsung, tanpa training. Ia menganalisis tensor dengan kode, menyusun hipotesis, mengubah bobot, lalu mengukur efeknya dengan jumlah forward pass yang terbatas.
Mengapa anggaran forward pass penting?
Dalam ablasi Qwen milik para penulis, 10 pass mencapai 12,3% pada MATH-500, 25 pass mencapai 14,1%, dan 50 pass mencapai 48,1%. Anggaran menentukan berapa banyak ide yang bisa diuji agen. Tuliskan di tugas dan tegakkan di sandbox.
Bisakah pengeditan bobot menambah kemampuan baru pada model?
Studi ini menunjukkan tidak. Hasil edit terbaik Astra menggerakkan Gemma 3 270M dari 6,8% ke 7,7% pada MATH-500. Para penulis menyimpulkan bahwa pengeditan menghilangkan hambatan pada Qwen, bukan menambahkan kemampuan.
Bagaimana cara mencegah bobot hasil edit sampai ke produksi?
Mount file asli sebagai read-only, edit salinannya, jalankan eval ulang secara independen, dan wajibkan seseorang menyetujui diff tensor sebelum apa pun memuat file tersebut di luar sandbox.


