
OpenAI merilis GPT-6 Luna pada 22 September dengan harga $0,10 per juta token input dan $0,50 per juta token output, dengan id API gpt-6-luna dan jendela konteks 1M. Dengan tarif seperti itu, pertanyaan yang menarik bukan lagi apakah model ini cukup baik secara umum. Pertanyaannya menjadi lajur mana di papan Anda yang bersedia Anda serahkan kepadanya, dan bagaimana lajur murah serta lajur mahal berjalan di Computer yang sama tanpa ada yang kehilangan jejak tentang lajur mana yang menghasilkan suatu hasil tertentu.
Ini masalah konfigurasi sebelum menjadi masalah model. Tim yang memasang Luna di mana-mana menghemat biaya, lalu menghabiskannya kembali di tahap tinjauan. Tim yang tidak pernah memasangnya terus membayar tarif premium hanya agar sebuah Agent mengganti nama file pengujian. Panduan ini mengambil jalur paling ringkas yang berguna: pasang gpt-6-luna di satu Computer, biarkan ia berada di lajurnya sendiri, tugaskan satu Task nyata, dan baca hasilnya di tempat yang bisa dilihat tim.
Ringkasan Singkat
Pasang gpt-6-luna sebagai model default sebuah Runtime di Computer yang terhubung, pastikan Runtime tersebut berstatus Available di Sharkly, beri ia Agent sendiri alih-alih memakai ulang Agent mahal, naikkan timeout per-Task sebelum mempercayai eksekusi panjang, dan gunakan Luna hanya untuk pekerjaan yang hasilnya bisa diperiksa seseorang dalam waktu kurang dari satu menit. Sharkly tidak akan menampilkan nama model. Yang ditampilkannya adalah eksekusi, log, pertanyaan, dan hasil pada Task tersebut. Agent melakukan riset, eksekusi, pengujian, dan pelaporan. Manusia yang menetapkan arah, memberikan wewenang, dan menerima hasilnya.
Di mana pengaturan model berada
Sharkly tidak memilih model. Dokumentasi Agents menyatakannya dengan gamblang: “Agent mengikuti model default Runtime. Ia tidak menjanjikan atau menampilkan nama model tertentu. Ubah model di konfigurasi tool Runtime atau Computer, bukan di Agent.”
Jadi tidak ada dropdown model di Agent, dan tidak ada pula kontrol kedalaman berpikir. Empat peran, masing-masing satu tugas. Agent menentukan bagaimana pekerjaan harus ditangani. Computer menyediakan host dan sumber daya lokal. Runtime menjalankan sesi agent yang sebenarnya. Task tetap menjadi catatan bersama bagi tim. Panduan lengkap untuk konfigurasi itu ada di panduan GPT-6 Sol kami; artikel ini membahas bagian yang khusus tentang menempatkan model murah di papan.
Langkah 1: pasang gpt-6-luna di Computer
Di Computer yang akan menjalankannya, perbarui tool agent Anda dan masuk dengan akun atau API key yang memiliki akses Luna. OpenAI menyediakan Luna di ChatGPT Work dan di Codex untuk paket Plus, Pro, Business, Enterprise, dan Edu, memberi pengguna Free dan Go akses Luna di aplikasi desktop, dan belum menambahkannya ke Chat. Jika codex -m gpt-6-luna bisa memulai sesi di terminal biasa pada host tersebut, Sharkly dapat menggunakannya.
Lalu tetapkan default-nya agar eksekusi di Runtime tersebut ikut memakainya:
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
Dua catatan untuk potongan kode itu. Nama key reasoning-effort berbeda antar versi Codex, jadi cocokkan dengan contoh konfigurasi untuk build yang terpasang di Computer tersebut. Dan high ada di situ dengan sengaja, bukan sebagai nilai default: semua hasil Luna yang dipublikasikan di bawah ini diukur pada effort high atau max, bukan pada setelan yang akan Anda pilih untuk membuat model murah semakin murah. [VERIFY]
Kembali di Sharkly, buka detail Computer dan jalankan rescan atau uji koneksi. Runtime seharusnya berstatus Available. Computer yang hanya menampilkan online berarti layanan lokalnya sedang mengirim heartbeat. Status kapabilitas Runtime-lah yang memberi tahu Anda bahwa sebuah eksekusi bisa dimulai.
Langkah 2: pisahkan lajur murah secara kasatmata
Sebuah Computer dapat mengekspos satu atau beberapa Runtime, masing-masing melaporkan status koneksinya sendiri, dan Runtime ACP kustom dapat ditambahkan dari detail Computer dengan nama serta perintah startup-nya sendiri. Itulah tuas yang layak dimanfaatkan di sini. Beri lajur Luna entri Runtime tersendiri dan Agent tersendiri, dinamai menurut lajurnya bukan menurut modelnya, dan papan akan memberi tahu Anda di lajur mana sebuah Task dijalankan tanpa perlu ada yang membaca log eksekusi.
Ini bukan sekadar kosmetik. Sharkly tidak dapat membaca secara andal model yang benar-benar dipakai sebuah Runtime, dan itulah alasan Agent mengikuti default Runtime serta tidak menampilkan nama model. Jika satu Agent diam-diam berganti model antara hari Selasa dan Kamis karena seseorang mengedit file konfigurasi, dua eksekusi yang tampak identik pada Task tersebut sebenarnya tidak sama. Satu lajur per tingkat biaya membuat hal itu terlihat di satu tempat yang sudah biasa dilihat tim. Lihat Computer di Sharkly untuk cara Runtime dideteksi dan diuji.
Satu pasang keputusan, karena dua lajur ada biaya pemeliharaannya. Pisahkan Runtime ketika lebih dari satu orang menugaskan pekerjaan di Computer tersebut dan perbedaan antara eksekusi $0,10 dan $10 berarti bagi seseorang. Jangan pisahkan jika hanya satu engineer yang menjalankan beberapa Task per minggu; satu Runtime dan penilaian per-Task lebih sedikit untuk diingat, dan isolasi worktree sudah mencegah eksekusi saling bertabrakan.
Langkah 3: sesuaikan skala eksekusi untuk model yang lambat memulai
Murah tidak sama dengan cepat, dan inilah setelan yang paling sering salah pertama kali. Artificial Analysis, pihak ketiga dan bukan salah satu vendor, mengukur 153,9 token output per detik untuk varian reasoning max GPT-6 Luna dengan waktu 124,23 detik ke token pertama. Itu lebih lama daripada waktu tunggu kebanyakan orang sebelum menganggap sebuah proses menggantung.
Jadi tetapkan timeout per-Task secara sengaja, dan pertahankan direktori kerja dalam mode Temporary agar setiap Task mendapat direktori terisolasi dan worktree yang baru. Dua eksekusi Luna pada repositori yang sama kemudian tidak dapat saling menimpa, dan eksekusi yang sedang berpikir tampak berbeda dari eksekusi yang sudah mati, karena Task membawa status sedangkan scrollback terminal tidak.
Di mana Runtime murah sebaiknya ditempatkan dalam sebuah Crew
Crew adalah kelompok People dan Agents yang dapat dipakai ulang dan dikoordinasikan oleh satu Agent pemimpin. Aturan penempatan yang muncul dari angka-angka OpenAI sendiri adalah Luna sebaiknya berada di antara para anggota, bukan di puncak.
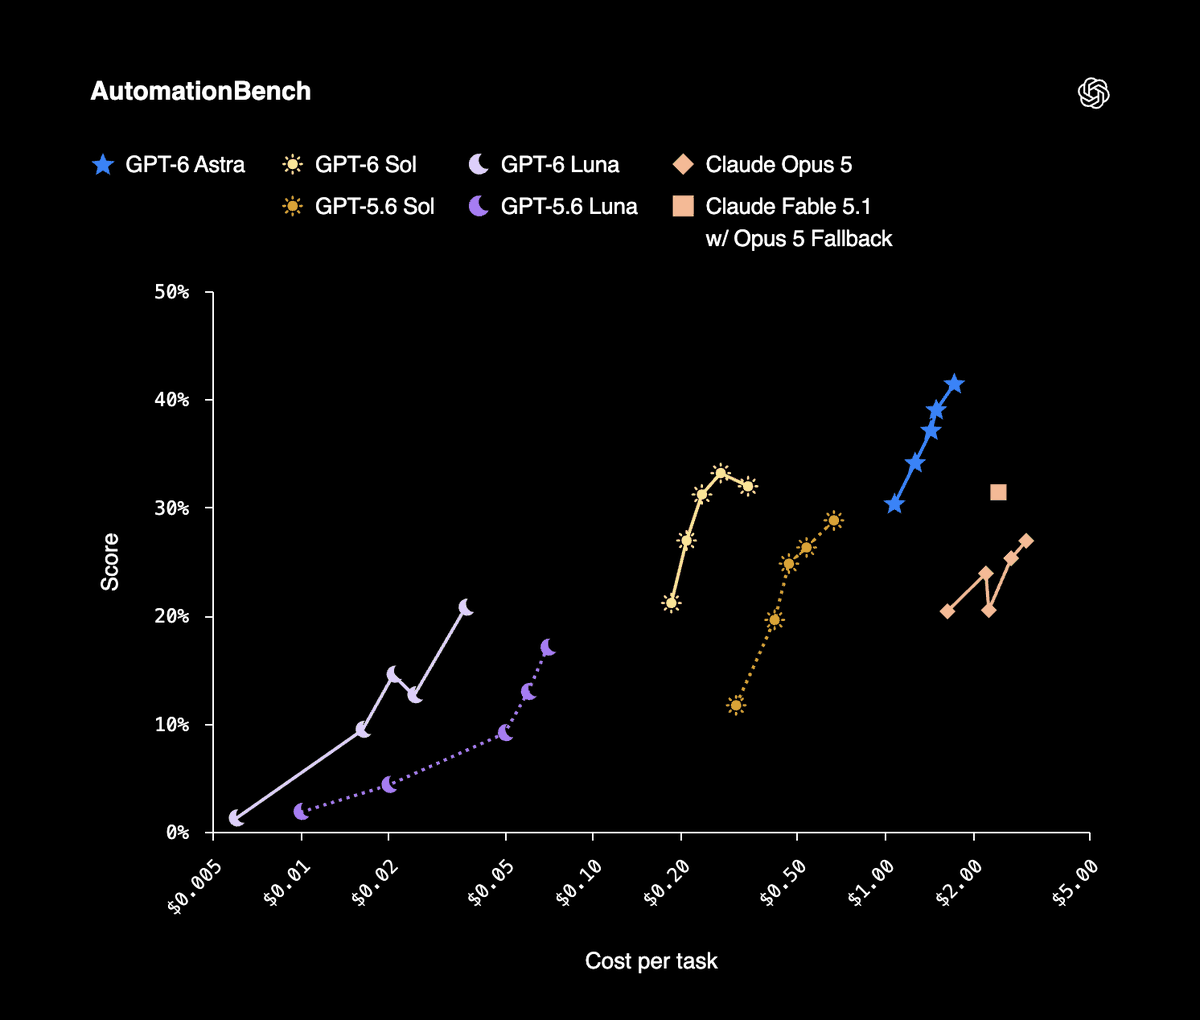
Kasus sebagai anggota sangat kuat. Pada DeepSWE 1.1, OpenAI melaporkan Luna pada effort max meraih skor 66,6%, sebanding dengan Claude Opus 5 dan Fable 5 pada effort medium, dengan biaya per task 93% lebih rendah daripada Opus 5 dan 96% lebih rendah daripada Fable 5. Pada OSWorld 2.0 offline, Luna pada max mengalahkan GPT-5.6 Sol pada medium dengan biaya sepersepuluhnya. Pada AutomationBench 1.0.6, Luna pada high meraih skor 5,4 poin persentase di atas pendahulunya dengan biaya per task 58% lebih rendah, dan pada faktualitas, Luna pada effort lebih tinggi menyamai GPT-5.6 Sol dengan biaya sekitar seperseratusnya. OpenAI juga menyebut Sol dan Luna 50% lebih murah daripada harga promosi GPT-5.6, dan kualifikasi itu berasal dari OpenAI sendiri: baseline-nya adalah tarif promosi, bukan tarif daftar.
Kasus sebagai pemimpin lemah, dan bukan karena benchmark apa pun. Seorang pemimpin menafsirkan tujuan, menentukan apa yang dilakukan para anggota, dan menyatukan hasil mereka kembali ke dalam satu Task. Kesalahan penafsiran di puncak bukan satu eksekusi buruk, melainkan semua eksekusi anggota diarahkan ke hal yang salah, dan penghematan token pemimpin hanyalah pembulatan galat dibandingkan itu. Panduan pemimpin Crew kami menyampaikan argumen yang sama di ujung lain daftar harga.
| Pekerjaan | Lajur | Alasan |
|---|---|---|
| Triage, pelabelan, perapian backlog | Luna | Volume tinggi, dan seseorang bisa memeriksa putusannya dalam hitungan detik |
| Scaffolding pengujian, catatan tinjauan awal | Luna pada effort high | Kemenangan yang dipublikasikan ada pada high atau max, bukan pada setelan lebih rendah |
| Perubahan pada kode yang dirilis | GPT-6 Sol pada $2 / $10 | AutomationBench 33,2% dengan biaya $0,27 per task |
| Menafsirkan tujuan yang ambigu untuk sebuah Crew | GPT-6 Sol, atau Astra pada $10 / $50 | Kesalahan pemimpin berlipat ganda ke setiap anggota |
Tuliskan itu sebagai aturan, bukan kebiasaan. Model mana untuk tugas coding mana membahas pertanyaan routing ini secara menyeluruh.
Satu catatan saat membaca margin OpenAI: pos peluncurannya membandingkan dengan Claude Opus 5, dan Anthropic mengganti Opus 5 dengan Opus 5.5 beberapa jam kemudian di hari yang sama. Perbandingan Luna di atas diukur terhadap generasi sebelumnya dari model yang disebutkan.
Apa yang tidak menjadi lebih murah dengan Runtime murah
Luna menurunkan harga untuk menghasilkan sebuah perubahan. Ia tidak berpengaruh pada harga untuk menerimanya. Sepuluh eksekusi murah menghasilkan sepuluh diff, sepuluh set output pengujian, dan sepuluh keputusan yang hanya bisa diambil manusia, dan angka pengeluaran OpenAI sendiri adalah peringatan, bukan jaminan: mereka melaporkan median peneliti di atas $600 sehari untuk coding agent, dengan persentil ke-90 mencapai $7.000. Biaya per task yang lebih murah adalah cara tagihan sebesar itu terbentuk.
Maka versi jujur dari tawaran ini. Runtime murah layak dipasang ketika pekerjaan yang diambilnya adalah pekerjaan yang bisa diverifikasi seseorang dengan cepat, dan ia menjadi penghematan palsu ketika justru memperbanyak antrean di depan reviewer Anda. Jaga agar konteks, kemajuan, hambatan, hasil, dan tinjauan manusia tetap terlihat dari permintaan hingga rilis, dan tentukan lajurnya pada saat penugasan, bukan saat tinjauan. Tinjauan manusia adalah hambatannya membahas sisi penjadwalan dari hal itu.
Jika Anda sudah menjalankan beberapa coding agent, hubungkan satu Computer, buat satu Agent di lajur murah, dan tugaskan sesuatu yang membosankan kepadanya.


