
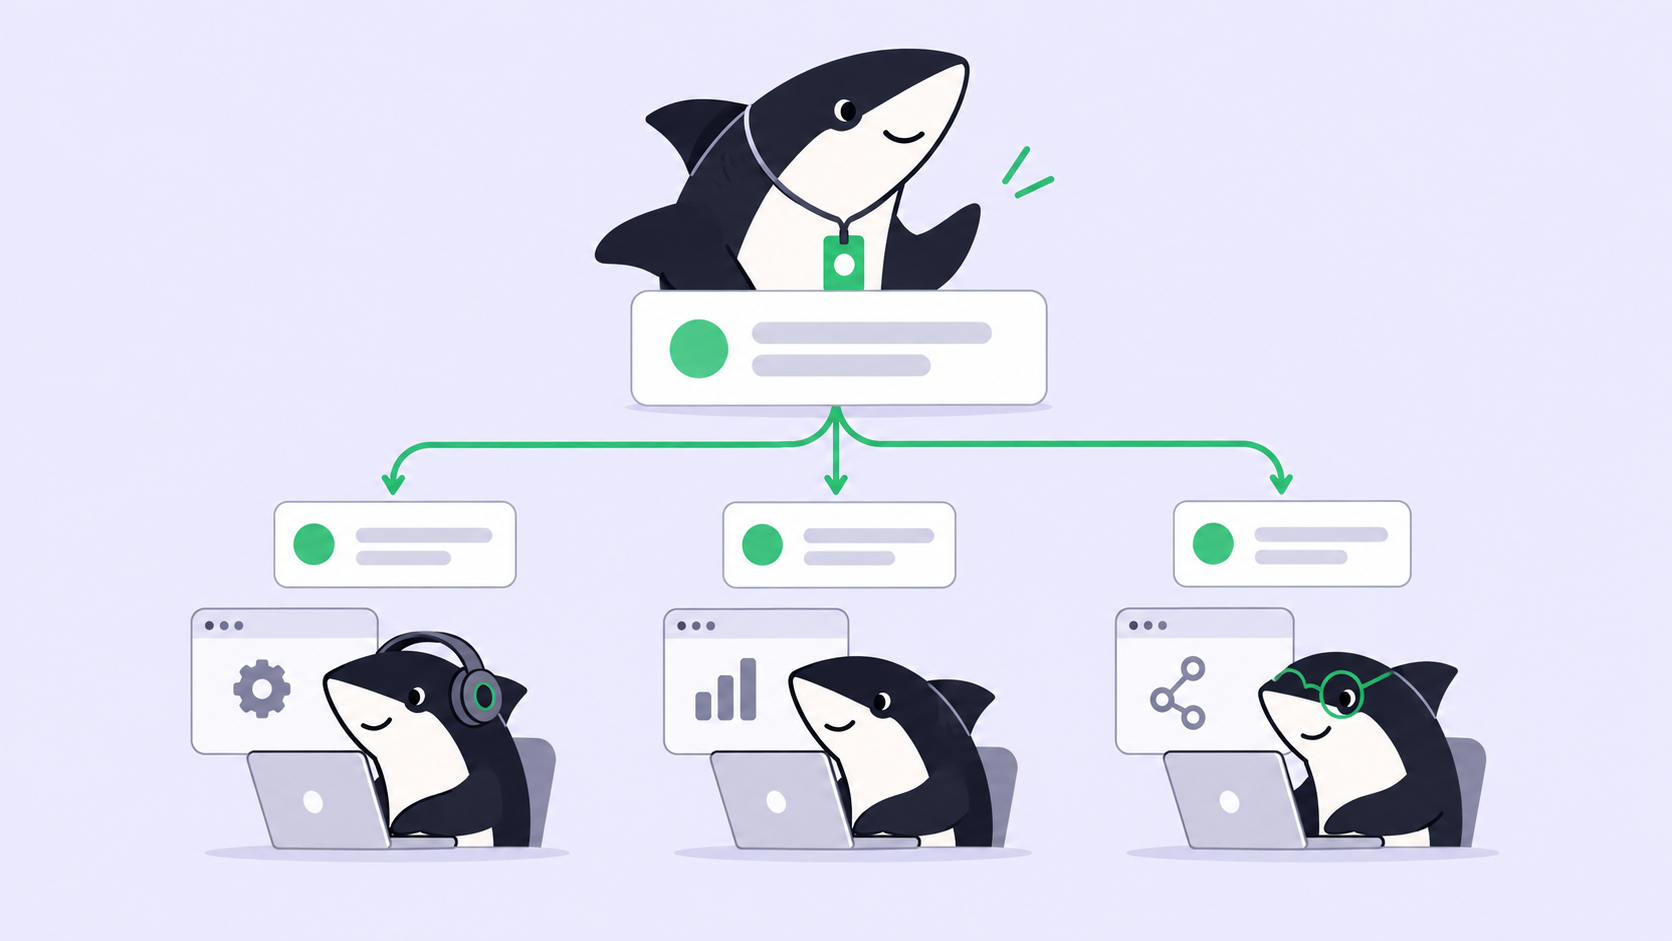
Seorang pemimpin Crew nyaris tidak menulis kode. Ia membaca Task, memutuskan siapa yang harus bertindak, menyebut anggota yang dibutuhkannya, menunggu, membaca apa yang kembali, lalu menggabungkannya atau mengirimnya kembali. Pada GPT-6 Astra dengan tarif $10 per juta token input dan $50 per juta token output, Agent yang paling sedikit menghasilkan kode justru membawa tarif tertinggi di Crew tersebut.
OpenAI merilis GPT-6 Sol pada 2026-09-22 dengan tarif $2 masuk dan $10 keluar, id API gpt-6-sol, seperlima tarif Astra di kedua sisi. Itu tidak membuat Sol menjadi model terpintar yang tersedia. Itu membuat kursi koordinasi cukup murah untuk diisi di setiap Crew yang Anda jalankan.
Kami sudah menyampaikan argumen Astra di GPT-6 Astra sebagai pemimpin Crew Anda: berikan kursi yang memutuskan kepada penilaian terbaik di tim, dan para anggotanya boleh biasa saja. Argumen itu tetap berlaku. Yang berubah adalah harga untuk menjalankannya. Yang tidak berubah adalah antrean pekerjaan selesai yang menunggu seseorang menerimanya.
TL;DR
Crew adalah kelompok People dan Agent yang dapat digunakan ulang, dikoordinasikan oleh satu Agent pemimpin, dan eksekusinya mengutamakan pemimpin: pemimpin membaca konteks Task dan instruksi Crew sebelum anggota mana pun mulai. Kursi itu berat di input dan berjalan lebih dari sekali per Task, jadi tagihannya mengikuti pembacaan, bukan penulisan. Sol dengan tarif $2 / $10 plus diskon 90% untuk pembacaan input yang di-cache membuatnya terjangkau untuk selalu menempatkan pemimpin di setiap Crew. Tetap pakai Astra atau Claude Opus 5.5 di kursi itu ketika kebutuhannya sendiri masih ambigu. Agent meneliti, mengeksekusi, menguji, dan melaporkan. People menetapkan arah, memberikan wewenang, dan menerima hasilnya.
Apa yang sebenarnya dihabiskan kursi pemimpin
Dokumentasi Sharkly menjelaskan eksekusi Crew sebagai urutan tetap. Jika Task berada dalam status yang dapat dieksekusi dan pemimpinnya siap, Agent pemimpin mulai lebih dulu. Ia membaca konteks Task dan instruksi Crew, lalu menangani pekerjaannya sendiri atau menyebut anggota Agent yang memenuhi syarat untuk kontribusi tertentu. Hasil mereka kembali ke Task, dan pemimpin menggabungkan apa yang kembali.
Bacalah itu sebagai bentuk penagihan. Setiap giliran pemimpin dimulai dengan membaca: deskripsi, komentar sejak terakhir kali, instruksi Crew, peran yang tersedia, dan apa pun yang sudah diposting anggota. Giliran itu berakhir dengan menulis keputusan singkat atau sebuah sebutan. Berat di input, ringan di output, berulang.
Dan kursi itu lebih sibuk daripada yang diperkirakan sebagian besar tim, karena pemimpin tidak berjalan sekali per Task. Pada Task yang ditugaskan ke Crew, komentar biasa dari anggota yang memenuhi syarat dapat memulai pemimpin Crew, dengan syarat ketersediaan yang sama seperti proses lain. Task dengan diskusi aktif di dalamnya adalah Task yang pemimpinnya sudah membaca utas itu berkali-kali.
| Kandidat untuk kursi pemimpin | ID API | Input / output per 1J | Input yang di-cache |
|---|---|---|---|
| GPT-6 Astra | tidak disebutkan | $10 / $50 | tidak disebutkan |
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | $0,20 baca, $5 tulis |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | diskon 90% untuk baca |
| GPT-6 Luna | gpt-6-luna |
$0,10 / $0,50 | diskon 90% untuk baca |
Itu adalah tarif API vendor, dan keberadaannya di sini lebih untuk perbandingan rasio ketimbang tagihannya. Penggunaan model tetap berjalan melalui langganan atau kunci API yang dikonfigurasi di alat coding Anda, jadi berapa yang dibayar tim Anda bergantung pada paket yang terhubung.
Biaya per task, bukan biaya per token
Pemimpin yang salah membaca kebutuhan akan menghabiskan satu hari proses anggota, jadi daftar tarif bukan tempat yang tepat untuk menyelesaikan ini. OpenAI mempublikasikan biaya per task bersama skornya, dan itu lebih mendekati pertanyaan sebenarnya.
| AutomationBench 1.0.6, seperti yang dipublikasikan OpenAI | Skor | Biaya per task |
|---|---|---|
| GPT-6 Sol, upaya ekstra-tinggi | 33,2% | $0,27 |
| GPT-6 Astra, upaya rendah | 30,3% | 3,9x Sol |
| Claude Opus 5, upaya maksimal | 26,9% | 11,1x Sol |
Pada Agents’ Last Exam V1, Sol dengan upaya maksimal mencetak 56,4%, di atas hasil terbaik Opus 5, dengan biaya per task 60% lebih rendah.
Tiga catatan jujur sebelum Anda mengeluarkan biaya apa pun berdasarkan tabel itu. Ini adalah hasil benchmark seluruh agent, bukan proses pemimpin; tidak ada yang mempublikasikan angka biaya koordinasi, dan tagihan riil pemimpin Anda bergantung pada seberapa banyak obrolan di Task Anda. Baris Astra berada pada upaya penalaran rendah, yang merupakan pilihan OpenAI sendiri sebagai titik pembanding, bukan Astra yang bekerja keras. Dan OpenAI menyatakan terus terang bahwa Astra "tetap menjadi model terbaik kami di semua lini", sementara Artificial Analysis, pihak ketiga, menempatkan indeks kecerdasan Sol di angka 48 berbanding 58 untuk Claude Opus 5.5. Sol bukan model terkuat yang bisa Anda tempatkan di kursi itu. Sol adalah model terkuat yang mampu Anda biarkan terus duduk di sana di setiap Crew.
Caching adalah diskon khusus untuk kursi pemimpin
GPT-6 menaikkan tingkat cache hit secara default dan memberi diskon 90% untuk pembacaan input yang di-cache. Dua perubahan lebih penting bagi pemimpin daripada bagi anggota: mengubah upaya penalaran atau kumpulan alat yang tersedia tidak lagi membatalkan cache, dan breakpoint eksplisit memungkinkan Anda memilih di mana awalan yang di-cache berakhir. OpenAI menyebut GitHub mengalami penurunan lebih dari 50% token prompt yang perlu diproses ulang di miliaran permintaan.
Pemimpin adalah pelaku terburuk dalam hal konteks yang dikirim ulang di sebuah Crew. Ia membaca instruksi Crew yang sama, konvensi repositori yang sama, dan utas Task yang terus bertambah di setiap giliran, dan awalan itu nyaris identik setiap kali. Itulah tepatnya bentuk yang cocok untuk awalan yang di-cache. Konfigurasinya berada di Runtime pada Computer, bukan pada Agent; cara menjalankan agent GPT-6 Sol di Sharkly membahas di mana menaruhnya.
Kapan Astra atau Opus 5.5 tetap memegang kursi
Gunakan Sol sebagai pemimpin ketika Crew menangani banyak Task terbatas setiap hari, perannya stabil, dan sebagian besar penilaian bisa dituliskan dalam instruksi Crew alih-alih diturunkan ulang setiap kali berjalan. Pertahankan model yang lebih mahal di kursi itu ketika kebutuhannya sendiri ambigu, ketika salah tafsir akan mengarahkan tiga anggota ke jalur yang salah, atau ketika Task-nya berupa satu pekerjaan panjang alih-alih banyak pekerjaan pendek.
Pemimpin yang lebih murah bukan alasan untuk menugaskan Crew pada pekerjaan yang bisa dilakukan satu Agent saja. Dokumentasinya tegas soal ini: untuk pekerjaan kecil dan terdefinisi baik, tugaskan Task langsung ke satu Agent. Gunakan Crew ketika pemimpin perlu menafsirkan tujuan, melibatkan anggota Agent lain, dan membawa hasil mereka kembali ke satu Task. Perbaikan satu file yang dialirkan melalui Crew akan membayar proses koordinasi yang sebenarnya tidak dibutuhkan, berapa pun tarifnya.
Mengganti model pemimpin juga tidak mengubah apa pun soal kepemilikan. Owner mengelola Crew; pemimpin mengoordinasikan eksekusi.
Menuliskan penilaian itulah yang membuat kursi yang lebih murah layak dipakai:
You lead this Crew. Read the Task and the comments added since your
last turn, then pick the smallest set of members that can finish it.
Mention @backend for API and job changes, @tests for coverage,
@docs for user-facing pages.
Ask a person only when two readings of the requirement would produce
different designs. Otherwise state your assumption and proceed.
Combine member results into one summary: what changed, what you ran,
what failed, what you did not cover. Leave acceptance to a person.
Satu catatan operasional sebelum Anda memercayai giliran pemimpin yang panjang. Artificial Analysis mengukur 102,15 detik sampai token pertama untuk varian penalaran maksimal GPT-6 Sol, angka pihak ketiga untuk konfigurasi upaya maksimal, bukan angka vendor. [VERIFY] Seluruh Crew menunggu giliran pertama pemimpin, jadi pemimpin yang sedang berpikir dan pemimpin yang menggantung terlihat sama sampai ada status yang menyatakan sebaliknya.
Tagihan yang tidak berubah
OpenAI melaporkan bahwa peneliti mediannya menghabiskan lebih dari $600 sehari untuk coding agent dan persentil ke-90 menghabiskan $7.000. Dengan tarif Sol, tim yang tadinya membatasi jumlah proses Crew kini mampu menjalankannya beberapa kali lebih banyak, dan setiap proses berakhir pada hasil yang harus dibaca seseorang.
Itulah kendala yang justru diperburuk, bukan diperbaiki, oleh penurunan harga. Koordinasi yang lebih murah membeli lebih banyak pekerjaan paralel, lebih banyak diff, dan lebih banyak keputusan per minggu, sementara kapasitas review diukur dalam jam manusia yang tidak berubah pada 2026-09-22. Agent meneliti, mengeksekusi, menguji, dan melaporkan. People menetapkan arah, memberikan wewenang, dan menerima hasilnya. Otomasi berhenti di titik yang membutuhkan penilaian tim.
Itulah sebabnya output pemimpin lebih penting daripada tarifnya. Proses pemimpin yang berakhir di scrollback tidak ada nilainya, baik di $0,27 maupun di $3. Proses pemimpin yang mengembalikan rencana, hasil anggota, pemeriksaan, kegagalan, dan pertanyaan terbuka ke satu Task itulah yang memungkinkan seseorang menerima pekerjaan dalam hitungan menit alih-alih merekonstruksinya. Jaga agar konteks, kemajuan, penghambat, hasil, dan review manusia tetap terlihat dari permintaan sampai rilis, dan kursi yang lebih murah berubah menjadi throughput alih-alih tumpukan pekerjaan.
Apa yang harus diubah minggu ini
- Pilih satu Crew dengan pemimpin yang mahal dan arahkan Runtime-nya ke
gpt-6-solpada Computer tersebut. - Pindahkan penilaian yang tadinya Anda bayar agar pemimpin mengimprovisasinya ke dalam instruksi Crew, secara tertulis.
- Jalankan satu Sprint dan bandingkan dua angka dengan yang sebelumnya: Task yang selesai, dan Task yang dikirim kembali setelah review. Jika yang dikirim kembali meningkat, kursi lama ternyata melakukan lebih banyak dari yang Anda kira.
Jika Anda sudah menjalankan beberapa agent, Sharkly memberi Anda satu tempat untuk mengelola task dan hasil mereka.


