
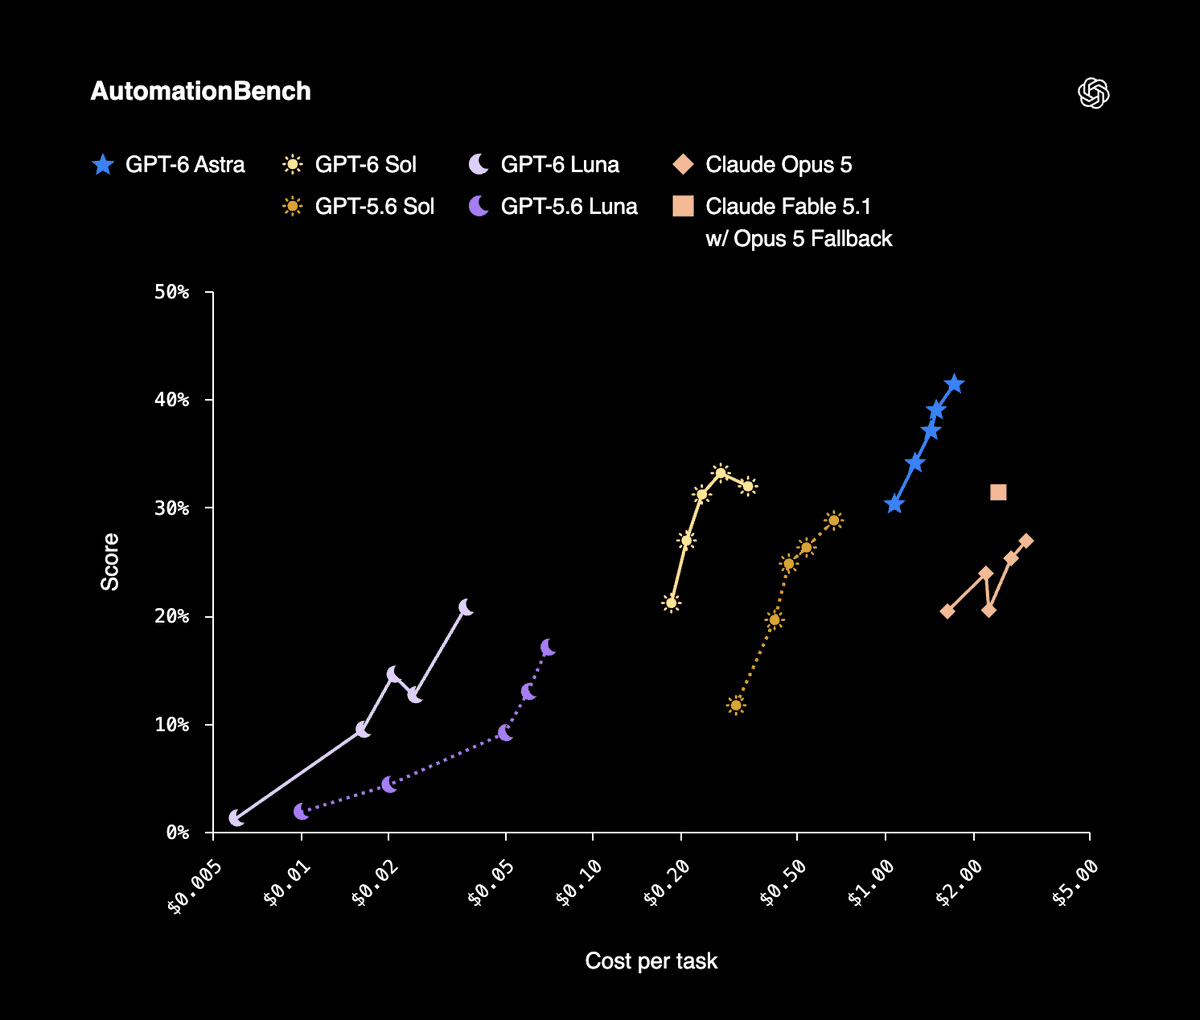
OpenAI merilis GPT-6 Sol pada 22 September dengan harga $2 per juta token input dan $10 per juta token output, dengan id API gpt-6-sol dan jendela konteks 872k. Angka yang seharusnya mengubah tampilan papan Anda bukanlah tarif token. Melainkan biaya per tugas yang tuntas: pada hasil AutomationBench 1.0.6 milik OpenAI, Sol dengan effort penalaran xhigh mencetak 33,2% dengan biaya $0,27 per tugas, sementara Claude Opus 5 pada effort maksimum mencetak 26,9% dengan biaya per tugas 11,1 kali lipat Sol.
Bacalah itu sebagai pernyataan anggaran, bukan papan peringkat. Jika tim Anda selama ini membatasi jumlah run agent karena satu run penuh terasa mahal, kendala itu baru saja bergeser. Kendala berikutnya adalah yang tidak bisa diselesaikan siapa pun dengan uang: tetap ada orang yang harus membaca diff dan menyetujui hasil kerjanya. Panduan ini menempuh jalur paling ringkas yang tetap berguna untuk penyiapan, lalu jujur soal bagian yang tidak diselesaikan oleh pemotongan harga. Pasang Sol di Codex pada satu Computer, buat satu Agent, tugaskan satu Task nyata.
TL;DR
Setel model = "gpt-6-sol" di Codex pada Computer yang sudah terhubung, pastikan Runtime Codex menampilkan Available di Sharkly, biarkan working directory Agent dalam mode Temporary, naikkan timeout per-Task sebelum Anda memercayai run panjang yang pertama, lalu tugaskan satu Task. Sharkly tidak akan menampilkan nama modelnya. Yang ditampilkan adalah run, log, pertanyaan, dan hasil pada Task tersebut. Agent meneliti, mengeksekusi, menguji, dan melaporkan. Manusia menentukan arah, memberikan otoritas, dan menerima hasilnya.
Di mana pengaturan model berada
Sharkly tidak memilih model. Dokumentasi Agents menyatakannya dengan gamblang: “Agent mengikuti model default Runtime. Nama model tertentu tidak dijanjikan atau ditampilkan. Ubah model di konfigurasi Runtime atau tool Computer, bukan di Agent.”
Tidak ada dropdown model di Agent, dan tidak ada juga kontrol kedalaman berpikir, jadi jangan mencari-cari. Empat peran, masing-masing satu pekerjaan. Agent menentukan bagaimana pekerjaan harus ditangani. Computer menyediakan host dan sumber daya lokal. Runtime menjalankan sesi agent yang sebenarnya, dan di sini Codex adalah Runtime-nya. Task tetap menjadi catatan bersama untuk tim.
Langkah 1: pasang GPT-6 Sol di Codex pada Computer
Di Computer yang akan menjalankannya, perbarui Codex dan masuk dengan akun atau API key yang punya akses Sol. OpenAI menyediakan Sol di ChatGPT Work dan di Codex untuk paket Plus, Pro, Business, Enterprise, dan Edu, dan Sol belum tersedia di Chat. Jika codex -m gpt-6-sol bisa memulai sesi di terminal biasa pada host tersebut, Sharkly dapat memakainya.
Lalu setel default-nya agar setiap run di Computer ini ikut memakainya:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
Ada dua catatan untuk potongan kode itu. Nama key reasoning-effort berbeda antar versi Codex, jadi cocokkan dengan contoh konfigurasi untuk build Codex di Computer tersebut. Dan tingkat effort adalah keputusan biaya, bukan tombol kualitas yang selalu dibiarkan di maksimum: hasil yang dipublikasikan OpenAI sendiri memakai tingkat effort berbeda untuk benchmark yang berbeda, dan angka $0,27 per tugas di atas adalah baris xhigh. [VERIFY]
Kembali di Sharkly, buka detail Computer dan jalankan rescan atau uji koneksi. Runtime Codex seharusnya menampilkan Available. Computer yang hanya menampilkan online berarti layanan lokalnya masih mengirim heartbeat. Status kapabilitas Runtime-lah yang memberi tahu Anda bahwa sebuah run bisa dimulai.
Langkah 2: siapkan cache sebelum Anda memperbesar Crew
Inilah perubahan GPT-6 yang paling penting begitu ada lebih dari satu Agent yang bekerja di repositori yang sama, dan justru inilah yang paling sering dilewatkan tim.
OpenAI melaporkan tingkat cache hit yang lebih tinggi secara default untuk GPT-6, diskon 90% untuk pembacaan input yang di-cache, dasbor prompt caching dan alat diagnostik, dan yang penting untuk pekerjaan agent, mengubah tingkat reasoning effort atau ketersediaan tool tidak lagi membatalkan cache. Breakpoint eksplisit memungkinkan Anda memilih di mana prefix yang di-cache berakhir. OpenAI menyebut GitHub melihat lebih dari 50% lebih sedikit token prompt yang perlu diproses ulang di miliaran permintaan.
Untuk sebuah crew, bentuk praktisnya begini. Setiap run Agent pada repositori yang sama mengirim ulang prefix besar yang hampir identik: tata letak repositori, aturan internal, perintah pengujian, konvensi. Prefix itulah yang justru menjadi tujuan cache, dan itulah sebabnya sekumpulan agent bisa jauh lebih murah per run dibandingkan agent pertama.
Sebuah pasangan keputusan, karena ini bukan pekerjaan yang gratis. Pin prefix yang stabil dan setel breakpoint eksplisit ketika beberapa Agent berjalan berulang kali pada satu codebase dan teks Skill serta instruksi Anda sudah final. Jangan repot-repot melakukannya jika Agent hanya berjalan beberapa kali seminggu atau instruksinya masih berubah setiap minggu, karena waktu yang Anda habiskan untuk merawat batas itu lebih banyak daripada penghematannya.
Langkah 3: bangun Agent dengan mempertimbangkan run yang lambat di awal
Buka Agents, pilih New Agent, pilih Computer dan Runtime Codex, lalu setel tiga hal.
Timeout per-Task. Setel ini dengan sengaja, karena run Sol dalam mode reasoning tinggi bisa terlihat mati sebelum terlihat sibuk. Artificial Analysis, pihak ketiga dan bukan salah satu vendor, mengukur 102,15 detik hingga token pertama untuk varian reasoning maksimum GPT-6 Sol. Itu lebih lama daripada waktu tunggu kebanyakan orang sebelum menganggap ada yang menggantung, dan justru itulah kegagalan yang bisa dicegah oleh status di papan bersama dan tidak bisa dicegah oleh terminal. Run yang sedang berpikir dan run yang sudah crash terlihat sama saja di scrollback. Lihat coding agent observability untuk mengetahui apa saja yang harus dibawa sebuah status agar layak dibaca.
Working directory. Mode Temporary. Setiap Task mendapat direktori terisolasi, dan run berbasis repositori menyiapkan worktree baru, sehingga dua run Sol pada repositori yang sama tidak bisa saling menimpa. Konkurensi default untuk direktori temporary adalah 50% dari batas Computer. Biarkan di angka itu sampai Computer tersebut sudah menangani beberapa run nyata; konkurensi yang lebih tinggi mengonsumsi CPU, memori, disk, dan kapasitas provider sekaligus.
Instruksi. Singkat dan stabil:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
Langkah 4: tugaskan satu Task, lalu putuskan apakah sebuah Crew layak dipertahankan
Pilih Task dengan kriteria penerimaan yang jelas. Pilih Agent sebagai Assignee dan pindahkan Task keluar dari Backlog ke status yang kategorinya siap dikerjakan; Task yang ditugaskan saat masih di Backlog akan menunggu. Run bergerak melalui queued, dispatched, dan running, dan tab Executions menayangkan log secara langsung. Jika Agent butuh keputusan, pertanyaannya kembali ke Task sebagai komentar, Task menampilkan waiting for human reply, dan itu masuk ke Inbox Anda.
Untuk perubahan yang cakupannya terbatas, satu Agent adalah pilihan yang tepat dan bagian yang bergerak tetap nol. Sebuah Crew adalah grup People dan Agent yang dapat dipakai ulang dan dikoordinasikan oleh satu Agent pemimpin, dan Crew layak dipakai ketika pemimpinnya harus menafsirkan sebuah tujuan dan menyatukan hasil beberapa anggotanya kembali ke dalam satu Task.
Sol mengubah hitungan itu, karena seorang pemimpin sebagian besar membaca, merencanakan, menugaskan, dan meninjau, dan itulah pekerjaan yang paling sulit dibenarkan di puncak daftar harga:
| Model Runtime | ID API | Input / output per 1 juta | Posisinya dalam Crew |
|---|---|---|---|
| GPT-6 Astra | tidak disebutkan | $10 / $50 | Pemimpin saat perencanaannya sendiri yang jadi bagian tersulit |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Pemimpin sekaligus anggota yang mengerjakan perubahan nyata |
| GPT-6 Luna | gpt-6-luna |
$0,10 / $0,50 | Anggota bervolume tinggi: triage, pelabelan, scaffolding |
Kami menulis penyiapan yang sama untuk Astra di menjalankan GPT-6 Astra sebagai pemimpin Crew. Argumennya masih berlaku; titik harga di bawahnya yang bergeser.
Apa yang tidak bisa dibeli dengan pemotongan harga
OpenAI menyebut Sol 50% lebih murah dibandingkan harga promosi GPT-5.6. Kualifikasi itu datang dari OpenAI sendiri dan itu penting, karena dasar pembandingnya adalah tarif promosi, bukan tarif daftar resmi. Dua catatan tambahan perlu berada di halaman yang sama. Benchmark peluncuran OpenAI membandingkan dengan Claude Opus 5, yang beberapa jam kemudian di hari yang sama digantikan Anthropic dengan Opus 5.5, jadi bacalah selisih itu sebagai hasil pengukuran terhadap generasi sebelumnya. Dan tingkat effort-lah yang menentukan: Sol mencapai 68,8% pada DeepSWE 1.1 dan 56,4% pada Agents’ Last Exam V1 di effort maksimum, bukan pada setelan yang akan Anda biarkan menyala untuk tugas rutin.
Lalu ada bagian yang sama sekali bukan soal model. OpenAI melaporkan bahwa peneliti median mereka sendiri menghabiskan lebih dari $600 sehari untuk coding agent, dengan persentil ke-90 di atas $7.000. Biaya per tugas yang lebih murah justru menjadi cara tagihan sebesar itu terbentuk, bukan cara menghindarinya. Setiap run tetap menghasilkan perubahan yang harus dibaca, dipertanyakan, dan disetujui oleh manusia, dan antrean itu tidak menjadi 11 kali lebih murah minggu ini. Rencanakan berdasarkan kapasitas review alih-alih pilihan model, tuliskan routing down sebagai sebuah aturan alih-alih sekadar preferensi, dan simpan penugasan, progres, blocker, hasil, serta review manusia di satu tempat dari permintaan hingga rilis.
Jika Anda sudah menjalankan beberapa coding agent, hubungkan satu Computer, buat satu Agent, dan beri ia tugas yang membosankan.


