
Anda sedang mencoba memutuskan coding agent mana yang layak dipercaya untuk pekerjaan nyata: Claude Code, Codex, Gemini CLI, OpenCode, atau dua di antaranya sekaligus. Jadi Anda membaca skor benchmark. Satu agent menyelesaikan 68% dari kumpulan tugas publik, yang lain 71%, dan Anda diharapkan memilih berdasarkan angka itu. Lalu agent tersebut masuk ke repositori Anda dan tersangkut di langkah build yang belum pernah dilihat dataset publik mana pun.
Benchmark mengukur sekumpulan masalah tetap yang sama untuk semua orang. Basis kode Anda adalah sekumpulan masalah privat: konvensi Anda, tata letak monorepo Anda, test flaky yang semua orang abaikan, skrip deploy yang hanya dipahami satu orang. Skor yang menentukan minggu Anda adalah skor yang Anda hasilkan pada kode tersebut, bukan skor yang diterbitkan laboratorium. Panduan ini membahas metode untuk membandingkan coding agent pada perangkat lunak yang benar-benar Anda rilis, dan cara menjalankan perbandingan itu tanpa membuka lima terminal untuk memisahkan para agent.
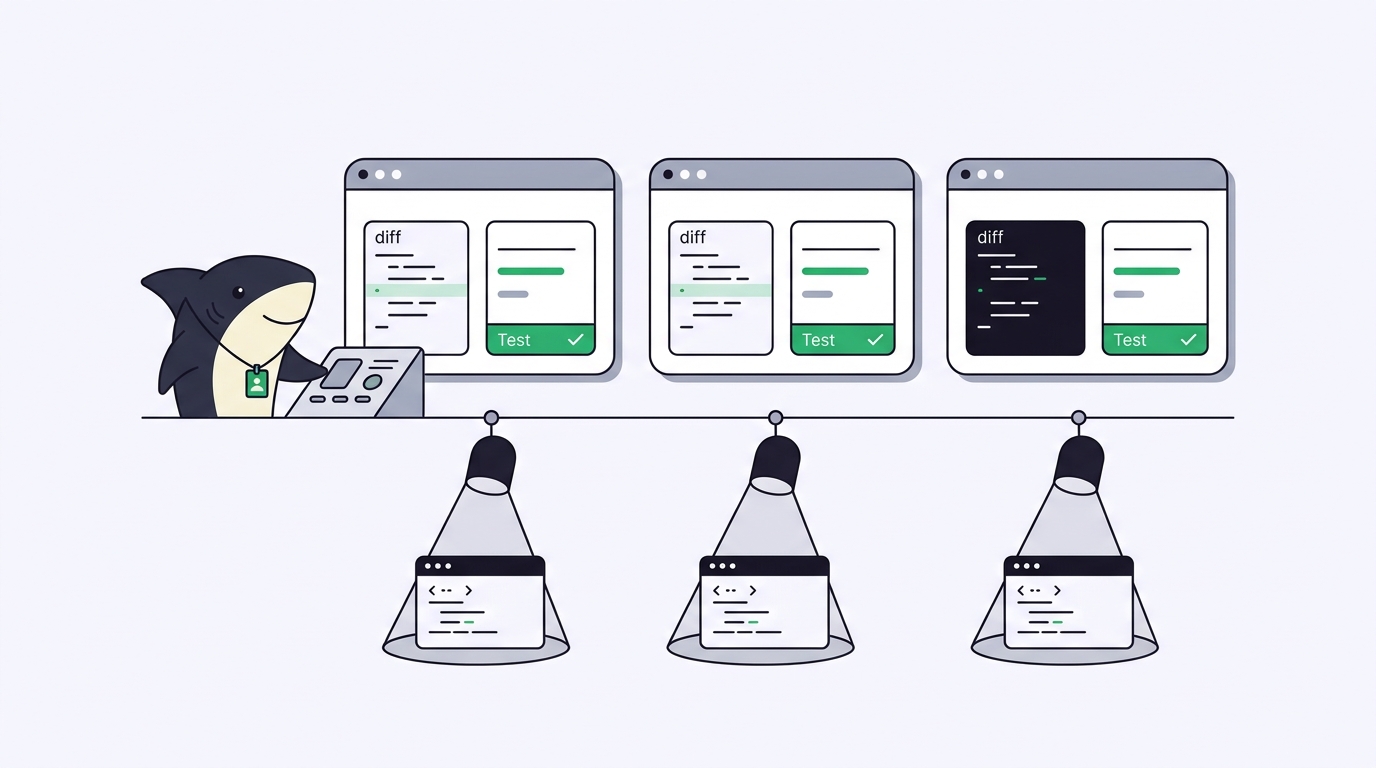
Sharkly adalah tempat metode itu bermuara. Sharkly adalah platform perintah dan manajemen Agent serba bisa: Anda menghubungkan Komputer Anda sendiri, menugaskan Task yang sama ke Agent yang berbeda, dan setiap eksekusi mengembalikan diff, keluaran test, dan review-nya ke satu tempat. Itulah yang membuat perbandingan yang adil menjadi mungkin. Variabel yang ingin Anda ukur adalah agent-nya, bukan juggling terminal yang biasanya Anda lakukan agar tiga eksekusi tidak saling bertabrakan.
Skor benchmark mengukur dataset, bukan repositori Anda
Benchmark coding agent adalah kumpulan test publik yang tetap, dinilai dengan cara yang sama untuk semua orang. Itulah justru yang membuatnya berguna bagi laboratorium yang membangun model, dan sekaligus yang membuatnya menjadi prediktor lemah bagi Anda.
Benchmark publik seperti SWE-bench mengambil tugasnya dari proyek open-source yang sudah dikenal luas, dengan harness yang sudah disetel dan pemeriksaan penerimaan yang dikurasi. Tidak ada satu pun dari itu yang menggambarkan hari Selasa Anda. Hal-hal yang menentukan performa agent pada kode Anda adalah hal-hal yang tidak akan pernah bisa dimuat dataset publik: pustaka internal Anda yang belum pernah dibaca model, konfigurasi lint Anda, file konteks 400 baris yang menjelaskan bagaimana layanan sebenarnya di-boot, satu modul yang tidak punya test.
Skor benchmark yang tinggi tidak memprediksi bagaimana agent berperilaku di repositori Anda. Skor itu memprediksi bagaimana agent berperilaku di repositori orang lain. Perlakukan papan peringkat sebagai filter kasar untuk menentukan agent mana yang layak diuji, lalu lakukan uji yang sesungguhnya. Jika Anda masih memilih model mana yang akan dipakai tiap agent, mencocokkan model dengan peran agent adalah pertanyaan awal yang lebih baik daripada skor mentah.
Pilih satu tugas nyata, bukan prompt mainan
Mulailah dari perbandingan paling sederhana yang berguna. Jangan benchmark agent pada "buat aplikasi todo." Pilih satu kebutuhan nyata dari backlog Anda: bug yang terbatas cakupannya, fitur kecil pada satu modul, migrasi yang memang akan Anda lakukan. Sesuatu yang punya test penerimaan yang bisa dijalankan dan diff yang bisa Anda baca dalam beberapa menit.
Lalu berikan input yang identik ke setiap agent: deskripsi tugas yang sama, commit awal yang sama, kriteria penerimaan yang sama. Tuliskan seperti yang akan Anda tulis di tracker Anda, tugas seperti SH-312: perbaiki pergeseran zona waktu pada ekspor invoice. Jika satu agent mendapat prompt yang lebih kaya daripada yang lain, Anda sedang mengukur prompt Anda, bukan agent-nya.
Gunakan perbaikan bug ketika Anda ingin melihat bagaimana agent membaca kode yang sudah ada dan tetap berada di dalam batas. Gunakan fitur kecil ketika Anda ingin melihat bagaimana ia menyusun kode baru dan apakah ia menulis test-nya sendiri. Jalankan keduanya seiring waktu; satu tugas hanya memberi tahu Anda tentang satu tugas.
Bandingkan setiap agent dalam kondisi terbaiknya, bukan terburuknya
Setiap agent punya pengaturan di mana ia bekerja paling kuat: model yang tepat, file konteks yang tepat, izin yang benar-benar dibutuhkannya. Berikan Claude Code file CLAUDE.md-nya, berikan Codex konfigurasinya, berikan setiap Runtime lingkungan yang direkomendasikan dokumentasinya. Membandingkan agent yang dikonfigurasi dengan baik melawan agent yang polos tidak memberi tahu apa pun selain mana yang Anda repotkan untuk disiapkan.
Menjalankan mereka dalam kondisi terbaik, berdampingan, adalah momen di mana pendekatan terminal mulai berantakan. Di Sharkly Anda menugaskan Task yang sama ke setiap Agent, dan setiap Agent berjalan di Komputer yang terhubung dalam worktree yang terisolasi, sehingga tiga agent yang mengedit repositori yang sama tidak akan pernah menyentuh file satu sama lain. Anda mendapatkan tiga percobaan bersih pada masalah yang sama alih-alih satu working tree bersama dan merge yang harus Anda urai sendiri secara manual. Jika Anda selama ini melakukannya secara manual, menjalankan beberapa agent sekaligus adalah bagian yang memang dirancang Sharkly untuk mengambil alih dari pundak Anda.
Jika Anda hanya menggunakan satu agent dan berkutat di terminal, satu sesi Claude Code yang disetel dengan baik di sebuah worktree sudah cukup, dan Anda mungkin tidak membutuhkan semua ini. Persamaannya berubah begitu Anda membandingkan dua agent atau lebih, di lebih dari satu tugas, dan Anda ingin hasilnya dalam bentuk yang benar-benar bisa Anda baca berdampingan.
Lima kriteria yang menentukan pada pekerjaan nyata
Benchmark menilai satu angka: apakah tugasnya lulus. Pekerjaan nyata ditentukan oleh lima hal yang tidak dicakup angka itu.
| Kriteria | Pertanyaan yang dijawabnya |
|---|---|
| Eksekusi paralel | Bisakah saya menjalankan para agent pada tugas yang sama secara bersamaan, dalam isolasi, tanpa konflik? |
| Visibilitas tim | Bisakah orang lain selain saya melihat apa yang dilakukan setiap agent, dan mengapa? |
| Alur review | Seberapa cepat saya bisa membaca diff, test, dan batasan yang diketahui lalu menerima atau menolaknya? |
| Eksekusi di mesin sendiri | Apakah agent berjalan di Komputer saya, terhadap lingkungan dan secret saya yang sebenarnya? |
| Integrasi | Apakah hasilnya masuk ke tracker, repo, dan alat review yang sudah kami gunakan? |
Empat kriteria pertama adalah area di mana sebagian besar agent tampak identik dalam benchmark tetapi berperilaku sama sekali berbeda pada kode Anda. Eksekusi di mesin sendiri khususnya tidak terlihat oleh test publik: agent yang berjalan terhadap toolchain Anda yang sebenarnya, database lokal Anda, hook CI Anda yang asli, sedang diuji pada hal yang Anda rilis, bukan pada sandbox yang menyerupainya.
Agent meneliti, mengeksekusi, menguji, dan melaporkan. Anda menetapkan arah, memberi otoritas, dan menerima hasilnya. Sebuah perbandingan hanya jujur jika Anda bisa melihat setiap bagian dari itu, untuk setiap agent, tanpa harus merekonstruksinya dari scrollback.
Nilai apa yang kembali, bukan apa yang diklaim agent
Agent yang mencetak "selesai" tidak sama dengan perubahan yang lulus. Nilai setiap eksekusi berdasarkan apa yang kembali, bukan berdasarkan apa yang diklaimnya. Untuk setiap percobaan, bukti yang berguna adalah daftar pendek yang sama: diff, hasil typecheck dan test, ringkasan perubahan, dan batasan yang diakui agent. Sharkly menjaga konteks, progres, hambatan, hasil, dan review manusia tetap terlihat dari permintaan hingga rilis, sehingga perbandingannya terbaca seperti tabel hasil alih-alih lima terminal yang harus Anda ingat-ingat.
Di sinilah juga bottleneck sesungguhnya muncul. Dua agent bisa sama-sama "menyelesaikan" sebuah tugas dalam dua puluh menit dan tetap menghabiskan satu jam masing-masing untuk Anda review. Me-review keluaran agent sering kali merupakan batas sesungguhnya atas berapa banyak pekerjaan paralel yang bisa diserap sebuah tim, dan hal ini harus berbobot besar dalam menentukan agent mana yang Anda pilih. Apa yang perlu diberi bobot bergantung pada siapa yang memilih:
| Memilih untuk | Bobot paling besar |
|---|---|
| Developer solo | Alur review dan eksekusi di mesin sendiri; Anda satu-satunya reviewer |
| Tim kecil | Eksekusi paralel dan visibilitas tim; beberapa orang perlu melihat eksekusi yang sama |
| Tim platform | Integrasi dan visibilitas; alur kerja harus tetap bertahan menghadapi agent terbaik berikutnya |
Baris terakhir itulah inti dari membandingkan sejak awal. Agent terbaik hari ini mungkin bukan agent terbaik kuartal depan, dan membangun ulang alur kerja Anda setiap kali pemimpinnya berganti adalah beban tersendiri. Sharkly bukan coding agent dan bukan harness benchmark; ia adalah lapisan yang memungkinkan Anda terus menguji agent terhadap kode Anda sendiri tanpa membangun ulang prosesnya setiap kali.
Jika Anda ingin terus menggunakan beberapa coding agent alih-alih berkomitmen pada satu ekosistem, itulah masalah yang dirancang Sharkly untuk diatasi. Unduh Sharkly, hubungkan satu Komputer, dan tugaskan tugas nyata yang sama ke dua agent. Perbandingan yang Anda dapatkan kembali adalah tentang basis kode Anda, dan hanya itulah yang memprediksi minggu Anda.


