
Empat coding agent selesai dalam jam yang sama dan membuka empat pull request. Satu menyentuh jalur retry penagihan, satu mengganti nama helper pengujian, satu menambahkan migrasi, satu memperbaiki typo di README. Hambatannya bukan kode atau pengujiannya. Hambatannya adalah pertanyaan yang dijawab seseorang sebelum membaca satu diff pun: mana yang harus saya lihat lebih dulu? Kami sudah berargumen bahwa tinjauan manusia adalah hambatannya begitu agent berjalan secara paralel. Postingan ini membahas bagian mekanis dari masalah tersebut, yaitu mengurutkan antrean, dan bagaimana model keputusan seperti Jev bisa mengangkatnya dari piring peninjau tanpa mengambil alih proses tinjauannya.
Apa itu Jev
Jev adalah System One Model dari TypeSafe AI: Anda mengirimkan sepotong state dan sekumpulan pertanyaan bertipe, lalu model ini mengembalikan jawaban untuk setiap pertanyaan dengan probabilitas terkalibrasi, tidak pernah berupa teks bebas. Supaya jelas soal namanya, ini adalah Jev si model TypeSafe, bukan YouTuber atau vaksin ensefalitis Jepang. Postingan peluncuran TypeSafe mendeskripsikannya sebagai “unstructured state in, typed probabilistic decisions out.” API-nya hanya satu endpoint, POST https://api.typesafe.ai/v1/systemone, kunci Bearer, model jev-latest, dengan tiga tipe pertanyaan: noul (probabilitas ya/tidak), choice (satu pilihan dari maksimal 255 opsi), dan score (posisi pada rubrik 2 sampai 10 level). Hanya teks, 64k token per permintaan dengan 32k untuk state, $0.042 per juta token input, output tidak dikenai biaya. Postingan saudara kami tentang Jev sebagai lapisan keputusan untuk coding agent membahas modelnya secara umum; di sini kami memakainya untuk satu pekerjaan saja.
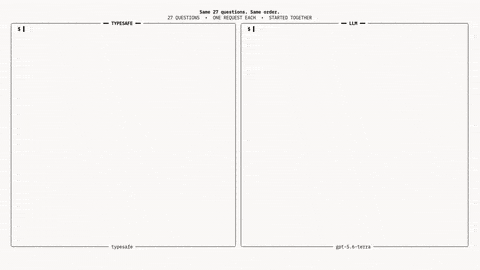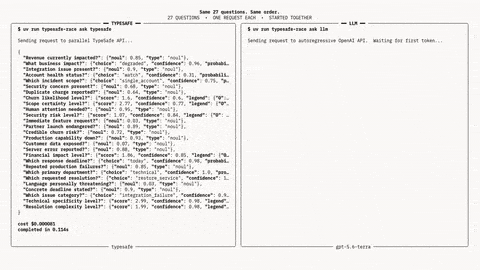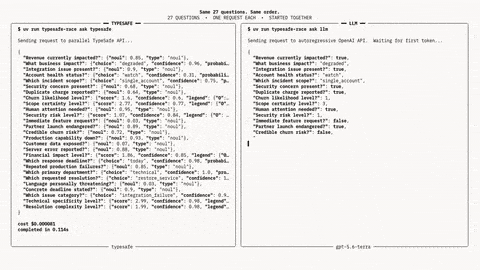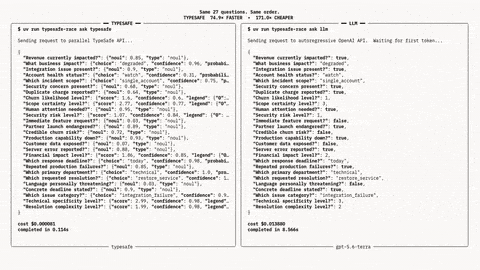
Tiga pertanyaan tinjauan
Setiap PR yang dibuka coding agent memunculkan tiga pertanyaan yang sama, dan masing-masing dipetakan ke satu primitif. State-nya sama untuk ketiganya: ringkasan diff, hasil pengujian, dan path yang disentuh. Bukan diff lengkapnya. Ringkasan menjaga panggilan tetap dalam anggaran dan membuat model tetap menjawab pertanyaan routing alih-alih meninjau ulang kodenya.
Apakah ini perlu dibaca manusia sebelum di-merge? Sebuah noul. Inilah filternya. Ini menentukan apakah sebuah PR masuk ke antrean manusia sama sekali atau menunggu di jalur prioritas rendah.
Peninjau atau antrean yang mana? Sebuah choice atas antrean yang benar-benar dijalankan tim Anda. Jawabannya membawa pilihan beserta distribusi lengkapnya, jadi pembagian 0.48 / 0.44 antara dua antrean memberi tahu Anda bahwa PR itu berada di batas kepemilikan, dan itu sendiri layak untuk diketahui.
Seberapa besar risiko yang dibawanya? Sebuah score pada rubrik berurutan. Hasilnya adalah posisi berbobot probabilitas, jadi sebuah perubahan bisa mendarat di 2.6 di antara “logic change covered by tests” dan “touches auth, billing, or data.” Angka itu adalah kunci pengurutan untuk antrean.
Satu permintaan menjawab ketiganya:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
Responsnya adalah tiga jawaban bertipe di bawah kunci yang sama. Untuk SH-418, perkirakan needs_human mendekati 0.9, queue memilih payments, dan risk mendekati puncak rubrik. Perbaikan retry penagihan dengan pengujian yang hijau tetap masuk ke depan antrean payments, karena pengujian hijau tidak menjawab “haruskah seseorang membaca ini.”
Ambang batas dan apa yang dilakukan setiap band
Probabilitas baru berguna setelah kode mengubahnya menjadi tindakan. Band di bawah ini hanyalah titik awal, bukan rekomendasi untuk repositori Anda; sesuaikan setelah seminggu menjalankannya.
needs_human |
Tindakan |
|---|---|
| 0.85 ke atas | Paling depan antrean manusia, diurutkan berdasarkan risk menurun |
| 0.15 hingga 0.85 | Antrean manusia, diurutkan berdasarkan risk, setelah band di atas |
| di bawah 0.15 | Jalur prioritas rendah; manusia tetap melakukan merge, sesuai jadwalnya sendiri |
Dua aturan menjaga ini tetap jujur. Pertama, risk di puncak rubrik selalu mendorong sebuah PR ke band terdepan, apa pun kata needs_human. Model yang hanya 0.12 yakin bahwa migrasi skema perlu ditinjau berarti ia hanya melihat ringkasan diff yang rapi, bukan lingkungan produksi. Kedua, choice yang dua opsi teratasnya berjarak dalam 0.1 satu sama lain dirutekan ke kedua antrean, bukan ke tidak ada antrean sama sekali. Ambiguitas soal kepemilikan adalah alasan bagi dua orang untuk melirik sebuah perubahan, bukan alasan untuk nol orang.
Perhatikan apa yang tetap ada pada manusia di setiap band: merge-nya. Band mengubah urutan dan kedalaman pembacaan. Band tidak pernah mengubah siapa yang memutuskan.
Gunakan Jev untuk antrean, bukan untuk putusannya
Gunakan Jev ketika pertanyaannya punya kumpulan jawaban yang tetap, state-nya merupakan ringkasan yang setia, dan Anda ingin membelanjakan perhatian manusia dalam urutan yang lebih baik: siapa yang membaca ini, seberapa cepat, di antrean mana. Pertanyaan-pertanyaan itu muncul di setiap PR dan dengan harga ini cukup murah untuk ditanyakan di setiap run.
Gunakan manusia, atau model bahasa yang bisa menunjukkan penalarannya, ketika pertanyaannya adalah apakah perubahan itu benar. Probabilitas bahwa sebuah perubahan perlu ditinjau bukanlah sebuah tinjauan. Jev tidak punya compiler, tidak punya test runner, dan tidak punya akses ke file yang dinilainya, hanya ringkasan yang Anda kirim. Nilai 0.96 pada “aman untuk di-merge” adalah alasan kuat untuk menaruh PR itu di puncak daftar seseorang, dan tidak pernah menjadi alasan untuk melewati orang tersebut. Gerbang persetujuan berada setelah model, dan model tidak punya cara untuk membukanya.
Apa yang dibangun komunitas
Dalam hitungan hari setelah peluncuran, seorang developer menerbitkan jev-review, yang oleh README-nya dideskripsikan sebagai “a small code-review workflow built with TypeSafe Jev.” Alat ini meninjau diff Git atau seluruh codebase, menyaring correctness, security, reliability, compatibility, dan test coverage, memilih region kode sebelum menilai dampaknya, menerapkan ambang batas dan kebijakan alur kerja di dalam kode, lalu menampilkan hasilnya di dasbor lokal. README-nya berhati-hati soal cakupan: proyek itu disebut “an experiment in composing fast typed judgments into a review workflow” dan dinyatakan “does not yet integrate compiler diagnostics, static analyzers, repository indexing, or generated explanations.”
Dua hal dalam desain itu layak ditiru: orkestrasi berada di dalam kode dan Jev hanya menjawab pertanyaan yang terbatas, serta pekerjaannya bertahap, pilih region dulu, baru nilai, bukan satu pertanyaan raksasa atas seluruh diff. Jev juga tersedia di Vercel AI Gateway sebagai typesafe-ai/jev melalui experimental_evaluate di AI SDK 7; dokumentasi Gateway mencatat bahwa ini hanya tersedia lewat AI SDK.
Kaitannya dengan Sharkly
Sharkly tidak memanggil Jev untuk Anda, dan Sharkly bukan model keputusan. Sharkly adalah lapisan task, Computer, konteks, dan tinjauan bersama di sekitar coding agent yang sudah dijalankan tim Anda. Yang dibutuhkan antrean berperingkat dari lapisan itu adalah tempat untuk berjalan dan tempat untuk mendarat.
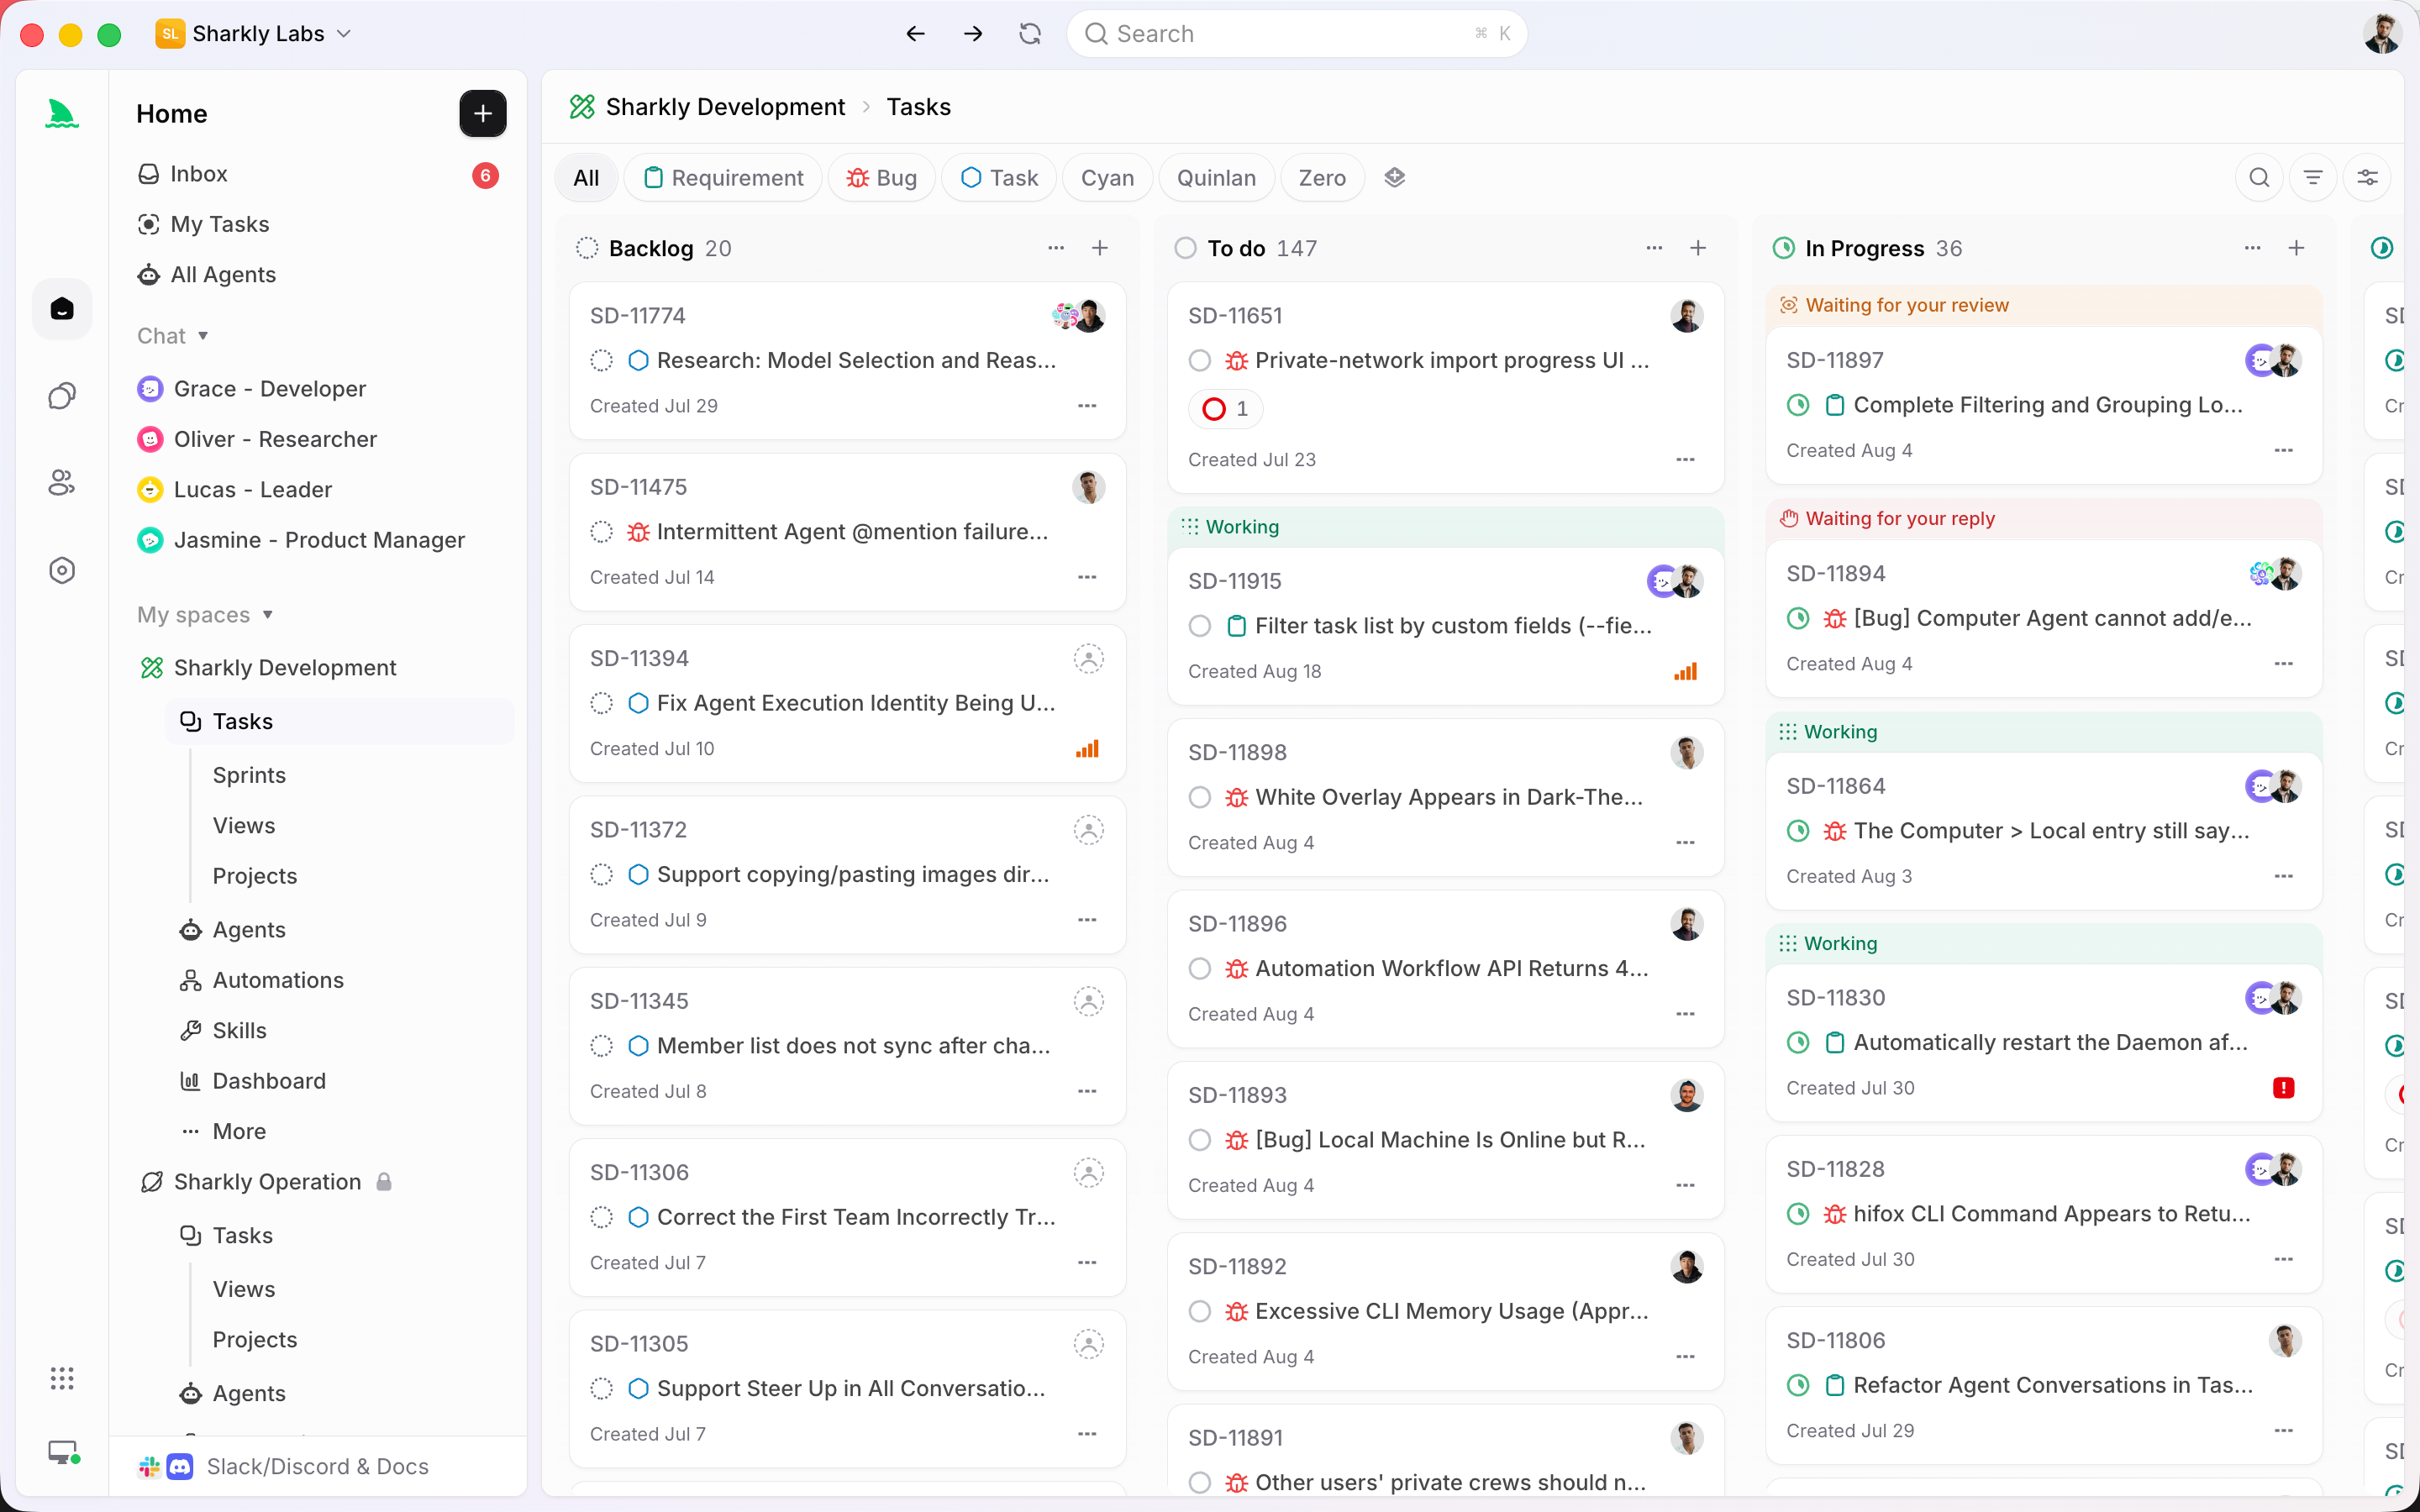
Tempat untuk berjalan adalah Automation: aturan milik Space yang menjalankan Agent dengan serangkaian instruksi pada sebuah trigger, dan salah satu trigger-nya adalah task yang berpindah ke status tertentu. Arahkan ke status yang dicapai Agent Anda saat PR terbuka, dan instruksinya menjadi: baca ringkasan diff, hasil pengujian, dan path yang disentuh pada Task tersebut; panggil Jev dengan tiga pertanyaan; tulis jawaban dan band-nya kembali sebagai komentar pada Task; set label untuk antreannya. Dokumentasinya menegaskan bahwa run yang selesai “is not a promise that every downstream business outcome was correct,” yang merupakan batas yang sama dengan yang digariskan band tinjauan.
Tempat untuk mendarat adalah Task itu sendiri. Band, antrean, dan skor risiko kembali ke Task tempat peninjau sudah biasa melihat, di samping ringkasan perubahan dan hasil verifikasi dari run tersebut. Seseorang membuka board yang diurutkan berdasarkan risk dan melihat mengapa setiap PR berada di posisinya. Agent membuka pull request, menjalankan pengujian, dan melaporkan. Manusia membaca sesuai urutan yang disarankan antrean, lalu menerima atau menolak. Urutannya berasal dari probabilitas; keputusannya tidak.
Jika Anda sudah menjalankan beberapa agent dan antrean tinjauanlah yang terasa menyakitkan, itulah alur kerja yang disiapkan oleh panduan memulai Sharkly: satu Computer, satu Agent, satu Task beserta bukti yang dibutuhkan sebuah peringkat.
FAQ
Bisakah Jev membaca seluruh diff, bukan hanya ringkasan?
Jev menerima hingga 32k token state, jadi diff kecil bisa masuk. Tetap kirimkan ringkasan: diff dari agent jauh melewati anggaran, dan ringkasan menjaga pertanyaannya tetap di level routing. Diff lengkapnya adalah yang dibaca manusia, dengan bukti tingkat task di sampingnya.
Bagaimana jika agent menulis sendiri ringkasan diff-nya?
Kalau begitu, ringkasannya bisa keliru dan menguntungkan agent, dan peringkatnya mewarisi kekeliruan itu. Utamakan ringkasan yang dihasilkan dari diff oleh langkah terpisah, dan selalu biarkan skor risk di level teratas menimpa needs_human yang rendah. Batasan tinjauan kode AI berlaku di sini: model bisa memberi peringkat pada apa yang ditampilkan, tetapi tidak bisa memverifikasi apa yang tidak ditampilkan.
Apakah band rendah berarti PR di-merge secara otomatis?
Tidak. Band rendah berarti seseorang melakukan merge nanti, sesuai jadwalnya sendiri, tanpa membacanya lebih dulu di antrean. Kepemilikan atas merge, dan atas pekerjaan yang dihasilkan agent, tetap ada pada orang yang disebut namanya di setiap band.
Apakah Jev gratis lewat Sharkly?
Sharkly tidak menjual ulang Jev atau model apa pun; Anda membawa kunci TypeSafe atau Gateway Anda sendiri, sama seperti run yang ditagihkan ke langganan yang terpasang pada Runtime Anda. Sharkly sendiri saat ini gratis untuk organisasi hingga 5 orang.


