
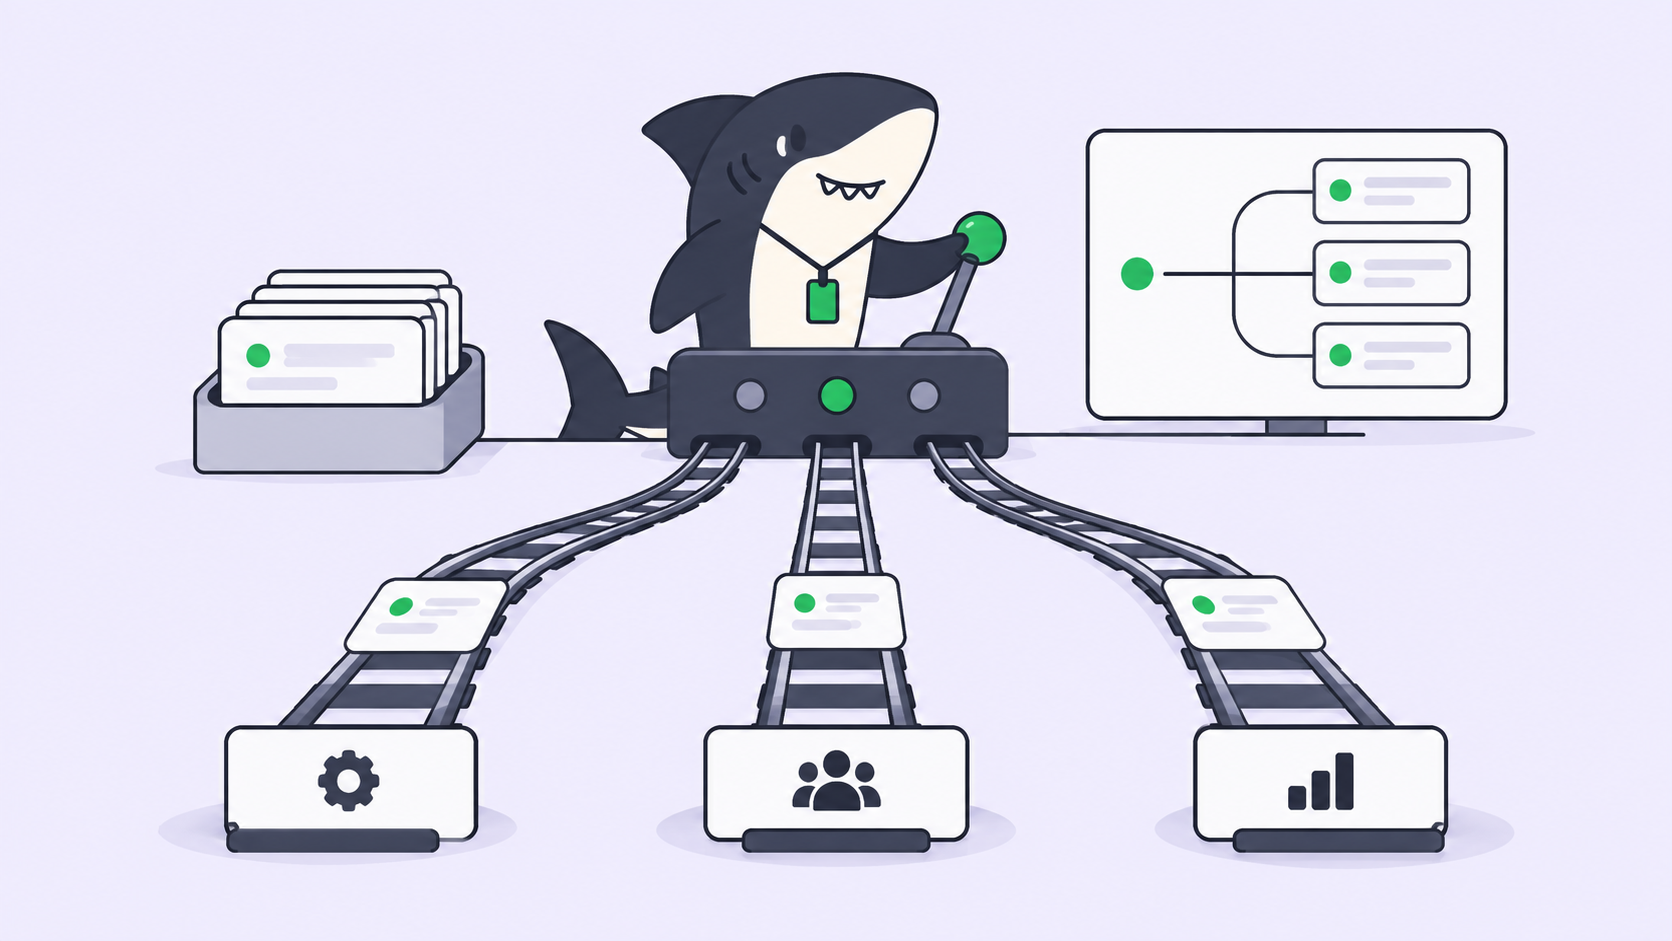
Tim Anda sebenarnya sudah merutekan pekerjaan antar model. Bedanya, semua itu hanya ada di kepala orang. Satu engineer menjalankan semuanya di tier mahal karena lebih jarang gagal. Yang lain beralih ke tier murah bulan lalu dan tidak memberi tahu siapa pun. Yang ketiga masih memakai apa pun yang jadi default tool saat instalasi. Hal ini masih bisa ditoleransi selama satu orang menjalankan satu agent. Tapi begitu lima Agent berjalan paralel, ini langsung jadi masalah: tidak ada yang bisa memastikan mana yang menghabiskan biaya empat puluh kali lipat dari yang seharusnya hanya untuk sebuah docstring, atau mana yang diam-diam gagal mengerjakan tugas yang memang di luar kemampuannya.
Pada 2026-09-22, selisih antar tier melebar cukup jauh hingga layak diperhitungkan. Anthropic merilis Claude Opus 5.5. OpenAI merilis GPT-6 Sol dan GPT-6 Luna. Selisih antara yang termurah dan termahal dari ketiganya mencapai empat puluh kali lipat pada token input, dan semuanya cukup mumpuni untuk diberi Task sungguhan.
Aturan routing adalah pernyataan tertulis, bukan sekadar preferensi
Aturan routing adalah pernyataan tertulis tentang kelas Task mana yang berjalan di Runtime mana, yang dilekatkan pada Agent yang mengeksekusi pekerjaan tersebut, bukan pada orang yang kebetulan memulai run-nya.
Itulah inti idenya, dan bagian terpentingnya adalah kata "tertulis". Preferensi hanya hidup di terminal satu orang dan hilang begitu ia cuti. Aturan hidup berdampingan dengan Agent, sehingga Assignee yang mengambil sebuah Task otomatis mewarisinya, reviewer bisa melihat tier mana yang menghasilkan diff yang sedang dibacanya, dan mengubah keputusan kuartal depan cukup dengan satu kali edit, bukan enam kali obrolan.
Aturan routing bukanlah peringkat model. Ia tidak mengklaim ada pemenang, dan memang tidak perlu. Ia hanya menyatakan ke mana setiap jenis pekerjaan diarahkan secara default, dan apa yang terjadi ketika default itu ternyata keliru.
Berapa biaya ketiga tier tersebut
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| ID API | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Input / output per 1 juta | $4 / $20 | $2 / $10 | $0,10 / $0,50 |
| Input cache | $0,20 baca, $5 tulis | diskon 90% untuk pembacaan | diskon 90% untuk pembacaan |
| Konteks | 1M | 872k | 1M |
Sebagai referensi: Claude Opus 5 seharga $5 / $25, dan GPT-6 Astra seharga $10 / $50. OpenAI menyebut Sol dan Luna 50% lebih murah dibanding harga promosi GPT-5.6. Kata "promosi" itu sendiri berasal dari OpenAI dan mengubah maknanya: dasar pembanding untuk klaim tersebut adalah tarif diskon, bukan tarif resmi. OpenAI juga menyatakan Astra "terus menjadi model terbaik kami di semua lini", sebuah pengingat berguna bahwa Sol adalah tier value di keluarganya sendiri, bukan flagship-nya.
Satu pengecekan praktis sebelum Anda menuliskan sebuah tier ke dalam aturan: OpenAI mencantumkan Sol dan Luna di ChatGPT Work dan di Codex untuk paket Plus, Pro, Business, Enterprise, dan Edu, dengan Free dan Go mendapat Luna di aplikasi desktop, dan menyatakan keduanya belum tersedia di Chat. Ketersediaan membentuk aturan routing sama besarnya dengan harga, karena tier yang tidak bisa diakses separuh Crew Anda bukanlah sebuah tier.
Route berdasarkan biaya per tugas yang selesai, bukan tarif token
Harga token hanyalah proksi dari angka yang sebenarnya Anda bayar. Model dengan tarif seperlima tapi butuh empat kali percobaan plus penyelamatan manual dari manusia bukanlah lebih murah. OpenAI mempublikasikan biaya per tugas berdampingan dengan skor untuk peluncuran ini, sesuatu yang jarang dilakukan secara terbuka dan merupakan bentuk bukti yang tepat untuk keputusan routing.
| Benchmark, seperti yang dipublikasikan OpenAI | Hasil | Biaya per tugas, relatif |
|---|---|---|
| AutomationBench 1.0.6, Sol pada extra-high | 33,2% | $0,27 per tugas |
| AutomationBench 1.0.6, GPT-6 Astra pada low | 30,3% | 3,9x Sol |
| AutomationBench 1.0.6, Claude Opus 5 pada max | 26,9% | 11,1x Sol |
| AutomationBench 1.0.6, Fable 5.1 dengan fallback Opus 5 pada max | 31,4% | lebih dari 8,9x Sol |
| Agents’ Last Exam V1, Sol pada max | 56,4%, di atas hasil terbaik Opus 5 | 60% lebih rendah dari Opus 5 |
| OSWorld 2.0 offline, Sol pada extra-high | 60,5% versus Opus 5 pada medium sebesar 60,3% | sekitar 80% lebih murah |
| DeepSWE 1.1, Luna pada max | 66,6% | 93% lebih murah dari Opus 5 |
| DeepSWE 1.1, Sol pada max | 68,8%, terpaut 1,1pp dari Fable 5 pada extra-high | sekitar 80% lebih murah |
Ada dua hal yang sekaligus benar dari tabel tersebut. Marginnya besar, tapi diukur terhadap Claude Opus 5, bukan Opus 5.5, yang belum ada saat tulisan OpenAI dibuat dan baru dirilis beberapa jam kemudian dengan biaya operasional 40% lebih murah dari Opus 5 menurut pengakuan Anthropic sendiri. Belum ada yang menjalankan ulang perbandingannya. Perlakukan baris-baris itu sebagai angka terakhir yang dipublikasikan, dan peringkat yang tersirat di dalamnya sebagai hipotesis untuk diuji di repositori Anda sendiri.
Yang tetap bertahan di balik catatan itu adalah polanya, dan pola itulah yang dibutuhkan sebuah aturan routing. Tier murah mampu bersaing pada pekerjaan yang terbatas dan berulang, dengan biaya hanya sebagian kecilnya. Klaim Anthropic sendiri untuk Opus 5.5 sama sekali bukan soal harga per tugas: biaya operasional 40% lebih murah dari Opus 5, output sekitar 30% lebih cepat, output maksimum 128k, dan mampu bertahan mengerjakan tugas selama 18 jam atau lebih. Itu menggambarkan model yang Anda arahkan untuk pekerjaan panjang dan berantakan, bukan untuk seratus tugas kecil.
Aturannya, ditulis lengkap
Inilah artefaknya. Sengaja dibuat membosankan, dan tempatnya adalah di mana tim bisa membacanya, bukan di file konfigurasi pribadi di satu laptop.
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
Tiga baris yang benar-benar berperan penting. Tier default disebutkan dengan jelas, sehingga Task yang tidak sempat dipikirkan tetap mendarat di tempat yang masuk akal. Eskalasi dibuat eksplisit, sehingga kegagalan murah tidak bisa bereskalasi menjadi kegagalan mahal tanpa ada yang menyadarinya. Pengecualian dicatat pada Task, dan itulah bedanya antara sebuah aturan dan sebuah saran.
Eskalasi adalah bagian yang sering dilewatkan tim
Penghematan pada tabel di atas nyata untuk setiap percobaan. Penghematan itu menguap jika percobaan murah rutin berubah menjadi retry mahal plus penyelamatan manual, karena Anda akhirnya membayar untuk kedua run sekaligus plus gangguannya. Inilah mode kegagalan dari rantai fallback otomatis: mereka menyembunyikan biaya tier murah di dalam tagihan tier mahal, dan tidak ada yang bisa melihat nilai tukarnya.
Karena itu, buatlah eskalasi bersifat manual dan terlihat. Run yang gagal kembali ke Task beserta log-nya, diff sejauh itu, dan pertanyaan yang membuatnya tersangkut. Seorang manusia yang memutuskan apakah akan mengarahkannya ulang ke tier lebih tinggi, memecahnya, atau memperjelasnya. Agent melakukan riset, eksekusi, pengujian, dan pelaporan. Manusia yang menentukan arah, memberi otoritas, dan menerima hasilnya. Jika jalur eskalasi Anda hanyalah loop retry, berarti Anda baru saja mengotomatiskan justru keputusan yang seharusnya diambil manusia.
Satu hal lagi yang perlu diperhatikan sebelum Anda mengarahkan pekerjaan yang sensitif terhadap latensi ke tier yang lebih murah. Artificial Analysis, pihak ketiga dan bukan salah satu vendor, mengukur varian penalaran "max" pada 115,2 token output per detik untuk Sol dengan 102,15 detik ke token pertama, dan 153,9 token per detik untuk Luna dengan 124,23 detik. Konfirmasikan angka-angka itu dengan daftar terkini sebelum Anda mengandalkannya. [VERIFY] Polanya yang penting: pada upaya penalaran maksimum, model murah bukanlah model yang cepat memulai, dan Agent yang sedang berpikir selama seratus detik terlihat persis seperti Agent yang menggantung. Ke tier mana pun Anda merutekan pekerjaan, bagaimana Runtime memberi sinyal kemajuan dan kegagalan yang menentukan apakah ada orang yang menyadari perbedaannya.
Kapan tidak perlu menulis aturan routing
Jika Anda menjalankan satu agent di satu repositori, tidak perlu melakukan semua ini. Pilih tier yang cocok dengan pekerjaan Anda dan lanjutkan. Routing membutuhkan dokumen untuk dirawat dan argumen untuk dibahas, dan baru memberi hasil ketika beberapa Agent berjalan bersamaan serta biaya atau pola kegagalannya berbeda.
Ambangnya kira-kira begini: tulis aturannya ketika dua orang atau lebih bisa memulai sebuah run, atau ketika satu anggaran menanggung beberapa Agent yang berjalan bersamaan. Di bawah ambang itu, aturan hanya jadi beban tambahan. Di atasnya, ketiadaan aturan itulah alasan tidak ada yang bisa menjelaskan tagihan bulan lalu.
Angka yang tidak berubah
Biaya per tugas yang selesai turun tajam di kedua kubu pada peluncuran ini. Sebagai gambaran skalanya, OpenAI melaporkan peneliti mediannya menghabiskan lebih dari $600 sehari untuk coding agent, dengan persentil ke-90 mencapai $7.000. Tim di bawah garis itu kini mendapat pekerjaan agent yang selesai beberapa kali lebih banyak dengan anggaran yang sama, dan ini layak dilacak per Runtime, bukan per invoice.
Tapi mereka tidak mendapat tambahan jam reviewer sama sekali. Routing adalah tuas biaya dan tuas keandalan, bukan tuas throughput, karena antrean pekerjaan yang menunggu diterima seseorang tidak berubah. Yang bisa dilakukan routing adalah membuat antrean itu terbaca: tier mana yang menghasilkan diff ini, berapa biayanya, berapa kali percobaannya, dan apakah Task yang gagal dua kali itu sedang tergeletak di Inbox seseorang atau tidak ada di mana pun. Simpan tujuan, run, biaya, penghambat, dan review pada Task sejak permintaan hingga rilis, maka aturan routing berubah menjadi pengaturan yang diedit tim, bukan kebiasaan yang dipegang diam-diam oleh enam orang.
Sharkly tidak menjalankan modelnya dan tidak memilihkannya untuk Anda. Sharkly adalah lapisan Task, Computer, konteks, dan review bersama di sekitar tool yang memang menjalankannya, dan di situlah aturan routing harus berada agar bisa bertahan lebih lama dari orang yang menulisnya. Jika Anda sudah menjalankan beberapa coding agent, model mana yang mendapat tugas mana dan agent mana yang mengerjakannya adalah keputusan yang sama, dilihat dari dua sisi. Hubungkan satu Computer, buat satu Agent per tier, dan beri yang murah sesuatu yang membosankan.


