
TL;DR: Tim agen AI OpenAI berhasil mengubah 5.034 target audit di kernel Linux menjadi 948 eksploit eskalasi hak istimewa lokal (LPE) unik dengan biaya sekitar $1,2 juta dalam bentuk kredit API, sebelum hasilnya ditinjau oleh peneliti manusia. Anda dapat menerapkan pola kerja serupa pada basis kode Anda sendiri: agen memetakan area yang dapat dijangkau, menganalisisnya, membuktikan setiap temuan secara terisolasi dan merancang draf perbaikan, lalu seseorang menyetujuinya.
Pada 4 November 2026, OpenAI menerbitkan “A thousand fewer paths to root”. Sorotan utamanya adalah 948 eksploit Linux. Namun, pelajaran penting bagi tim pengembang perangkat lunak ada di baliknya: hasil tersebut dicapai berkat agen-agen terspesialisasi yang bekerja secara bertahap, di mana tiap tahap menyerahkan bukti ke tahap berikutnya, dengan manusia di garis akhir.
Desain tersebut tidak bergantung pada keahlian khusus kernel, sehingga Anda dapat menerapkan struktur yang sama pada layanan Anda sendiri. Urgensinya sangat nyata: OpenAI menyatakan bahwa alur kerja (pipeline) mereka menghasilkan laba bersih (“net profitable”) jika dibandingkan dengan pembayaran program bug bounty publik. Para penyerang pun bisa melakukan kalkulasi yang sama, jadi mulailah dari sekarang.
Apa yang ditemukan tim agen AI OpenAI
OpenAI menjalankan pipeline ini pada pertengahan Oktober 2026 terhadap kernel Linux versi terbaru, menggunakan model keamanan siber (cyber model) yang akan segera dirilis. Target pengujian berupa VM terisolasi yang menjalankan OS desktop standar dengan seluruh proteksi bawaan tetap aktif.
| Tahap | Hasil | Biaya API |
|---|---|---|
| Scout | 5.034 target audit, sekitar 2,8 juta baris kode, kira-kira 7% dari keseluruhan kernel | $3,426 |
| Analyze | 2.308 kandidat temuan | $316,549 |
| Validate | 1.724 berhasil direproduksi (sekitar 74,7%) | $73,330 |
| Assess exploitability | 948 eksploit LPE unik, 291 PoC kebocoran informasi | $820,123 |
| Total | $1,213,430 |
Angka-angka ini adalah skala kernel milik OpenAI, bukan perkiraan biaya untuk repositori Anda. OpenAI menyebut biayanya “cenderung sebagai batas atas” karena pengujian ini bertujuan mengukur kapabilitas, bukan efisiensi.
Perhatikan tiga batasan penting berikut:
- Ini adalah celah eskalasi hak istimewa lokal (LPE). Penyerang harus memiliki akses awal lokal terlebih dahulu. Celah ini sendiri bukanlah eksploit jarak jauh (remote exploit).
- Banyak yang belum diperbaiki. Saat proses pemindaian dan analisis selama 10 hari selesai, 61 celah LPE telah ditambal di hulu (upstream), 43 memiliki patch di tahap staging, dan 299 sedang dalam pembahasan publik. OpenAI telah mengirimkan ratusan laporan dan patch untuk bug kritis serta mengirimkan sisanya secara bertahap bersama mitra Patch the Planet.
- Artikel OpenAI tidak menyebutkan adanya bug yang dieksploitasi secara aktif di luar sana (in the wild).
Panduan dari OpenAI tetap tegas. Pada sistem operasi yang belum menerima pembaruan patch terbaru, akun dengan hak istimewa rendah “harus dianggap secara fungsional setara dengan akses root bagi pelaku ancaman dengan sumber daya memadai.” Karena itu, segera terapkan patch, dan batasi dampak kerusakan (blast radius) menggunakan isolasi seperti Firecracker dan gVisor.
Lima tahap alur kerja keamanan agen AI
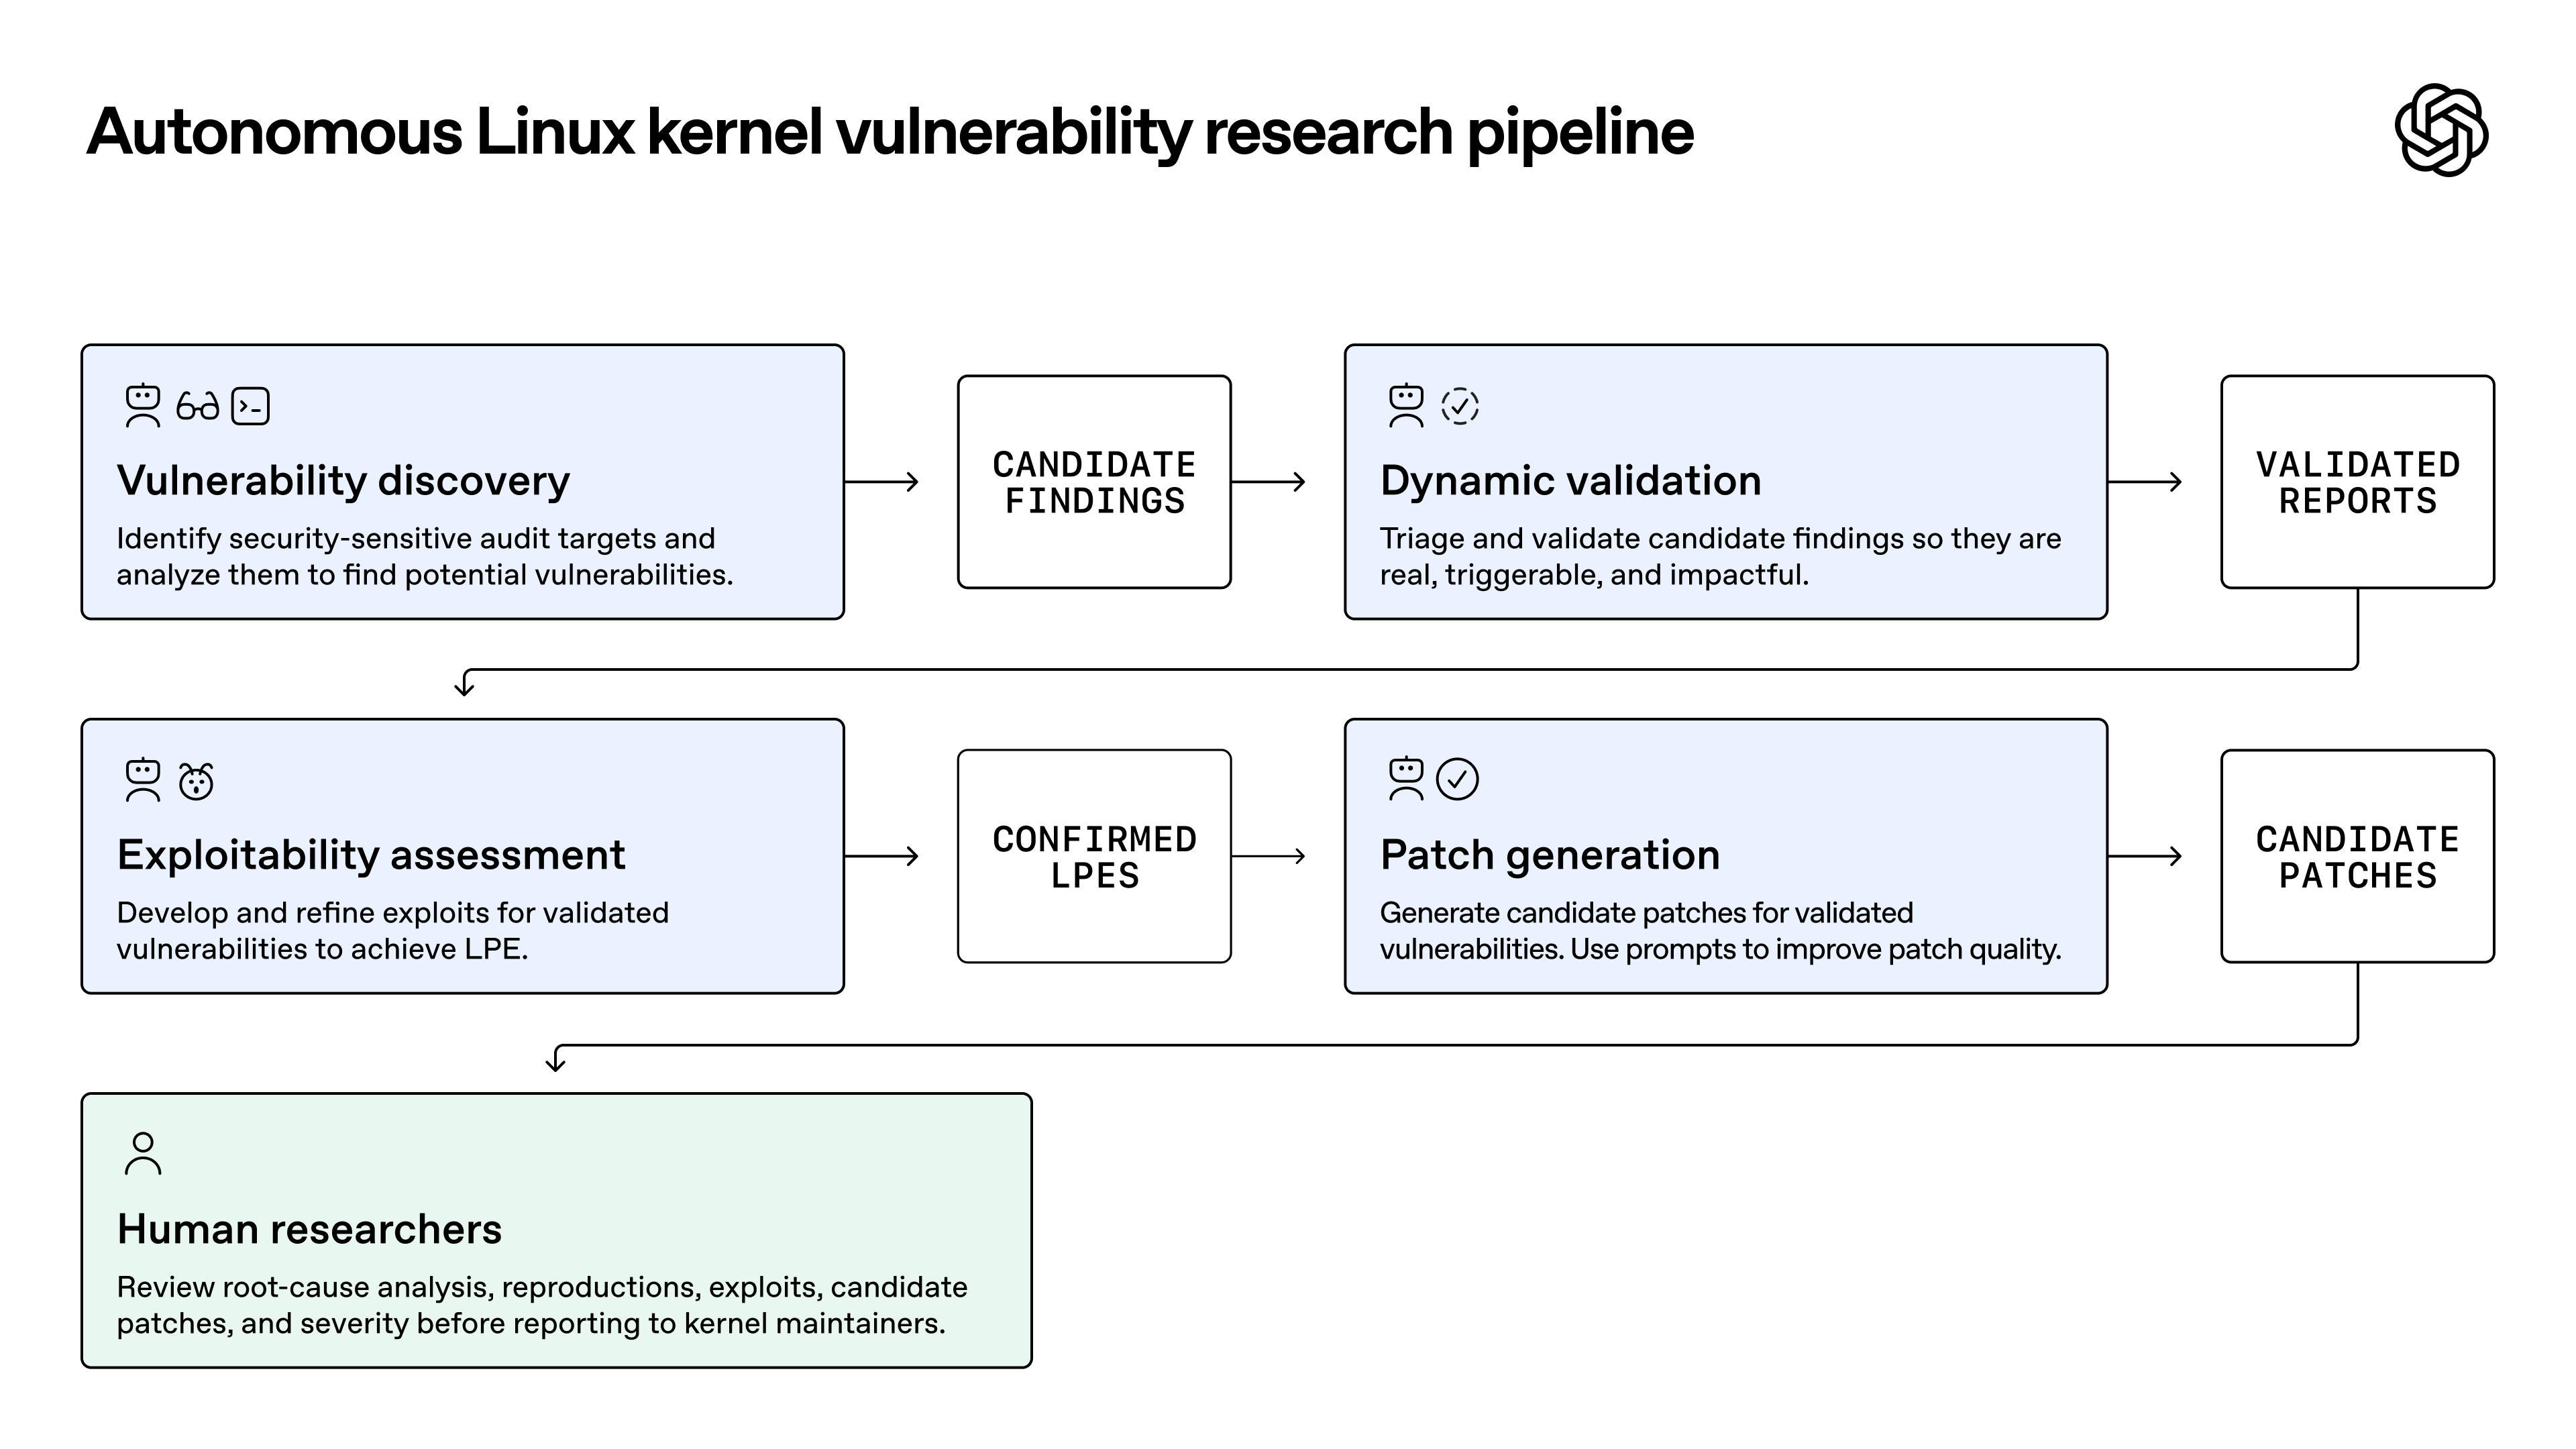
Alur kerja keamanan berbasis agen AI membagi proses peninjauan ke dalam beberapa tahap, di mana setiap tahap mempersempit cakupan kerja dan menghasilkan bukti untuk tahap berikutnya. Versi OpenAI memiliki lima tahap:
- Discovery. Agen Scout memilih target audit berdasarkan tingkat aksesibilitas dan relevansi keamanan. Agen Analyst membaca setiap target, membangun model ancaman, dan melaporkan kandidat temuan.
- Dynamic validation. Agen Triage menulis proof of concept (PoC) dan menjalankannya di VM terisolasi dengan KASAN, alat pendeteksi galat memori kernel, lalu menyempurnakannya hingga bug berhasil direproduksi atau semua opsi habis.
- Exploitability assessment. Agen penyaring menyaring temuan yang tidak memiliki jalur eksploitasi yang masuk akal. Agen ExploitDev menguji sisanya.
- Patch generation. Agen merancang draf patch untuk setiap bug yang tervalidasi, mengikuti konvensi kode di sekitarnya, serta memeriksa kemungkinan adanya varian lain.
- Human review. Peneliti keamanan meninjau eksploit, patch, dan tingkat keparahan (severity) sebelum diserahkan kepada pemelihara kode (maintainers).
Setiap serah-terima antartahap membawa bukti konkret, bukan sekadar opini, sehingga manusia di tahap akhir mengambil keputusan berdasarkan fakta.
Cara memetakan setiap tahap ke repositori Anda sendiri
Gunakan alur kerja ini hanya pada kode yang Anda miliki atau yang telah Anda beri wewenang untuk diuji. Untuk repositori Anda, hilangkan tahap pembuatan eksploit sepenuhnya. Tes yang gagal sudah cukup untuk membuktikan adanya cacat tanpa perlu menciptakan alat serangan.
| Tahap OpenAI | Versi Anda | Output |
|---|---|---|
| Scout | Buat daftar titik masuk (entry point) yang dapat dijangkau oleh pengguna anonim atau pengguna berhak istimewa rendah: rute, webhook, unggahan, parser, queue consumer | Daftar audit |
| Analyst | Satu target per eksekusi: baca kodenya, buat model ancaman singkat, laporkan potensi celah | Kandidat temuan |
| Validate | Tulis tes gagal minimal (minimal failing test) di lingkungan sekali pakai | Tes beserta log |
| Assess | Nilai dampak berdasarkan batas kepercayaan (trust boundary) yang dilanggar | Tingkat keparahan beserta alasannya |
| Patch | Rancang draf perbaikan sebagai pull request dengan menyertakan tesnya | Pull request |
| Human | Tinjau, lalu merge atau tolak | Perbaikan di-merge atau temuan ditutup |
Penentuan ruang lingkup (scoping) memberikan hasil yang sepadan dengan biayanya. Tahap scout OpenAI menghabiskan $3.426 dan berhasil memangkas cakupan audit menjadi sekitar 7% dari kernel. Mulailah dengan satu layanan beserta titik masuk publiknya. Deskripsi tugas (task) untuk satu temuan bisa sesederhana ini:
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
Verifikasi jalurnya, bukan hanya hasilnya
Pada eksekusi awal, tahap eksploitasi OpenAI melaporkan 200 keberhasilan. Namun, tinjauan manusia menemukan bahwa 20 di antaranya berhasil meraih akses root melalui 0-day yang berbeda dari target yang ditugaskan. Pipeline menandai keberhasilan berdasarkan hasil akhirnya, padahal hasil tersebut tercapai karena alasan yang keliru.
OpenAI kemudian memperketat batasan tugas dan menambahkan pemeriksaan independen untuk memastikan setiap eksploit benar-benar memanfaatkan kerentanan yang ditugaskan. Pelajaran pentingnya: verifikasi jalur menuju hasil, bukan hanya hasilnya saja.
Skenario yang mungkin Anda temui pun serupa: sebuah agen mengklaim tesnya membuktikan adanya celah autentikasi, tetapi ternyata tes tersebut gagal karena fixture yang hilang. Tambahkan agen pemeriksa independen yang tidak menulis tes tersebut, lalu ajukan satu pertanyaan: apakah kegagalan ini benar-benar berasal dari jalur kode yang dilaporkan?
Validasi sejak dini, karena positif palsu memakan biaya yang sama
OpenAI menemukan bahwa biaya untuk memvalidasi positif sejati (true positive) dan positif palsu (false positive) hampir sama. Artinya, setiap kandidat keliru yang lolos ke tahap validasi akan menghabiskan biaya satu sesi eksekusi penuh.
Lakukan penyaringan sebelum membuktikan. OpenAI hanya memvalidasi temuan yang dapat dijangkau oleh pengguna berhak istimewa rendah, tidak memerlukan kapabilitas khusus, dan menghasilkan bukti terukur. Buat gerbang penyaring (gates) serupa untuk kode Anda, misalnya “dapat diakses tanpa peran admin.” Temuan yang tidak lolos gerbang ini langsung ditutup disertai alasannya.
Kemudian, periksa kembali temuan terhadap kode terbaru sebelum dilaporkan, sebagaimana direkomendasikan OpenAI, demi menghindari laporan duplikat atau usang.
Tentukan aturan berhenti sebelum proses dimulai
Upaya yang gagal justru menjadi bagian yang paling mahal. Pada kandidat LPE, 69 kegagalan menghabiskan rata-rata $3.922 per percobaan, sedangkan 1.169 keberhasilan hanya menghabiskan rata-rata $360. Berdasarkan perhitungan kami, sekitar 6% percobaan menghabiskan sekitar 39% dari total $691.000 yang dikeluarkan pada tahap tersebut.
Solusi yang disarankan OpenAI adalah menetapkan syarat berhenti (give-up condition), seperti menghentikan proses setelah satu jam tanpa progres. Masukkan aturan tersebut ke dalam instruksi tugas, dan dukung dengan batas waktu tegas (hard limit) pada sesi eksekusi.
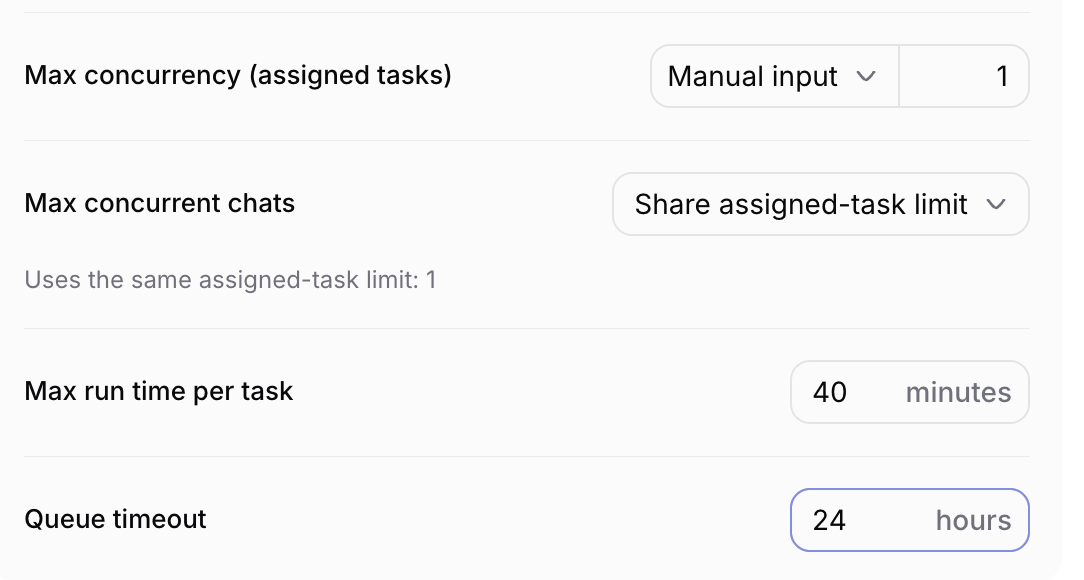
Di Sharkly, batas waktu per Tugas (Task) diatur dalam Run settings milik Agen. Pengaturan ini merupakan batas waktu maksimal, bukan pendeteksi progres, jadi pastikan aturan “tidak ada bukti baru” tetap dicantumkan dalam instruksi.
Buat orkestrasi tetap sederhana seiring peningkatan model
OpenAI sempat membangun lapisan berisi 103 teknik eksploitasi untuk GPT-5.5 Cyber, yang meningkatkan tingkat keberhasilannya dari 76,2% menjadi 88,9%. Namun, lapisan yang sama hanya menambah 1,5 poin pada GPT-5.6 Cyber, sehingga OpenAI menghapusnya.
Uji ulang kerangka kerja pendukung (scaffolding) Anda setiap kali mengganti model. Lakukan juga pemindaian ulang: sesi eksekusi bulan Oktober menemukan lebih dari 5 kali lipat celah LPE baru dibandingkan sesi Juli dengan GPT-5.6 Sol, pada kode yang bahkan telah diperkuat (hardened) selama tiga bulan tambahan.
Pertahankan tinjauan manusia sebelum merilis apa pun
Agen merancang draf perbaikan dalam bentuk pull request. Manusia yang melakukan merge. OpenAI menemukan bahwa patch pada percobaan pertama sering kali lebih besar dari yang diperlukan, melewatkan varian lain, atau melanggar konvensi kode, dan pengulangan proses telaah terbukti memperbaikinya.
OpenAI juga menyarankan pemanfaatan model untuk tinjauan adversarial (adversarial review) terhadap patch buatan manusia maupun AI. Jadi, tugaskan agen untuk mencoba menerobos perbaikan tersebut, lalu biarkan manusia yang mengambil keputusan. Jika proses review sudah menjadi hambatan utama (bottleneck) di tim Anda, bacalah panduan cara merancang tinjauan untuk agen paralel sebelum Anda menambah gelombang pull request baru.
Cara menjalankan alur kerja ini sebagai tugas di Sharkly
Task (Tugas) adalah unit kerja utama di Sharkly. Berikut salah satu cara membangun alur kerja ini:
- Buat tipe tugas (task type). Sebuah task type memiliki satu Alur Kerja (Workflow) dengan status yang berurutan. Tipe “Security finding” dapat mencakup status Candidate, Reproduced, Patch drafted, In review, dan Closed.
- Buat Kru (Crew). Crew adalah grup berisi Manusia dan Agen yang dapat digunakan kembali, dikoordinasikan oleh satu Agen pemimpin. Tambahkan Agen pemantau (scout), analis (analyst), pemeriksa (check), dan penambal (patch). Pemimpin akan memulai terlebih dahulu dan mendelegasikan tugas tertentu kepada anggota lain.
- Isolasi proses eksekusi. Gunakan direktori sementara agar setiap Tugas mendapatkan worktree-nya sendiri, dan baca panduan kami mengenai worktree terisolasi jika Anda menjalankan proses secara paralel dalam skala besar. Nonaktifkan direktori bersama Crew jika Agen pemeriksa membutuhkan independensi.
- Otomatiskan serah-terima. Sebuah Otomasi dengan pemicu status tugas dapat menjalankan Agen penambal saat sebuah Tugas mencapai status Reproduced. Eksekusi ini berjalan tanpa pengawasan dan tidak dapat mengajukan pertanyaan, serta pencocokan status berlaku di seluruh organisasi, jadi pastikan instruksinya memverifikasi Tugas pemicu tersebut.
- Tautkan pull request. Melalui integrasi GitHub, ID tugas pada branch, judul, atau deskripsi akan menautkan pull request tersebut. Tindakan merge tidak mengubah status tugas secara otomatis, sehingga peninjau yang akan menutup Tugas tersebut.
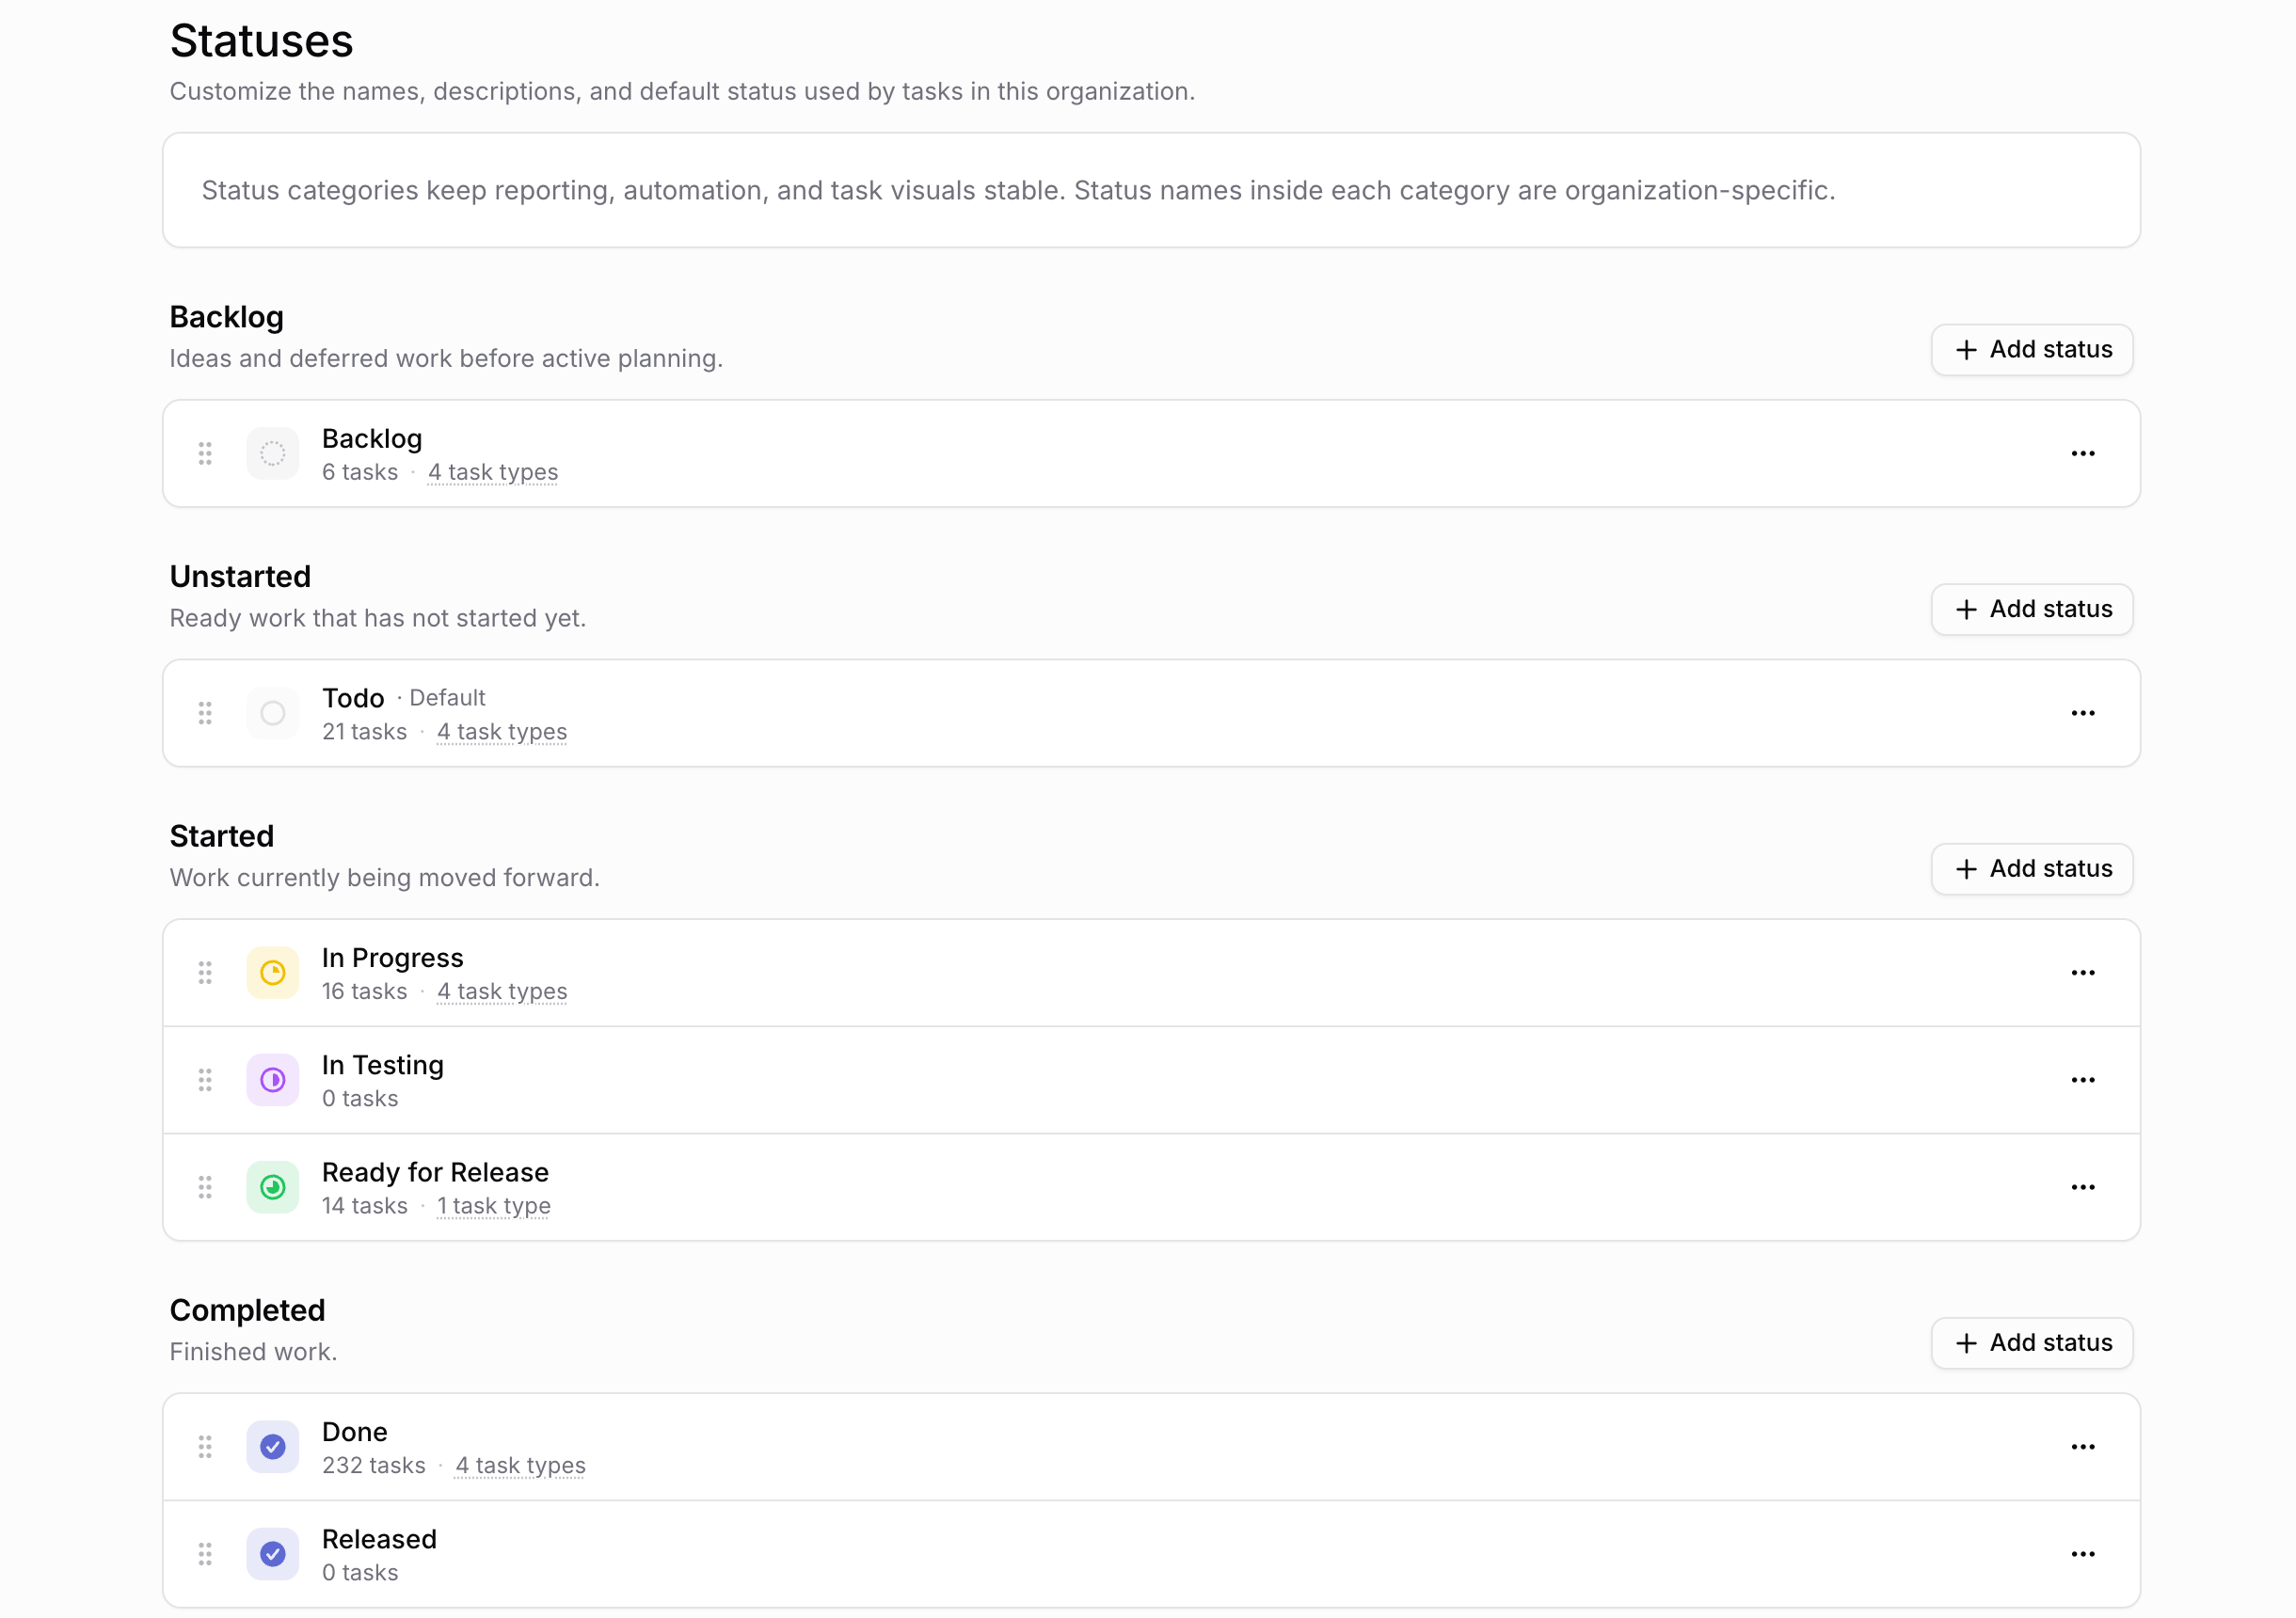
Status digunakan bersama di seluruh Organisasi, jadi tambahkan status baru untuk alur kerja ini daripada mengubah nama status yang sudah ada.
Ada satu batasan penting di sini: worktree mencegah bentrokan antartugas, tetapi bukan merupakan sandbox keamanan. Jalankan tes reproduksi di dalam kontainer atau VM sekali pakai tanpa rahasia produksi (production secrets), dan berikan akses Git sekecil mungkin yang dibutuhkan oleh Agen.
Sharkly bertindak mengoordinasikan pekerjaan ini. Claude Code, Codex, dan alat serupa menjalankan proses eksekusinya, sementara penggunaan model berjalan melalui langganan atau kunci API yang dikonfigurasi pada alat tersebut. Jika Anda ingin meningkatkan skala kerja, lihat cara menjalankan 10 agen koding AI sekaligus.
Untuk repositori kecil, cukup tugaskan satu Agen untuk satu Tugas tanpa perlu menggunakan Crew. Gunakan Crew ketika seorang pemimpin perlu mengurutkan beberapa peran dan mengumpulkan seluruh hasil kembali ke dalam satu Tugas.
Kesimpulan
Hasil yang dicapai OpenAI adalah cetak biru bagi tim Anda: persempit ruang lingkup, tuntut bukti di setiap serah-terima, periksa jalurnya, hentikan proses yang tidak membuahkan hasil sejak dini, dan pastikan manusia tetap memegang kendali atas tombol merge.
Mulailah minggu ini. Pilih satu layanan milik Anda, buat daftar titik masuk publiknya, dan buat satu Tugas validasi untuk setiap potensi celah. Panduan cepat Sharkly membantu Anda menjalankan Agen pertama di Komputer yang terhubung, dan sharkly.ai menunjukkan bagaimana lapisan tugas dan tinjauan terintegrasi dengan agen Anda.
FAQ
Apakah agen OpenAI menyerang sistem Linux yang aktif (live)?
Tidak. Eksploitasi dijalankan di dalam VM terisolasi pada lingkungan riset yang terkendali, dan peneliti manusia meninjau hasilnya sebelum dilaporkan.
Apakah seluruh 948 kerentanan Linux sudah ditambal?
Belum. Banyak di antaranya yang masih dalam proses pelaporan dan penambalan. Pada akhir pemindaian selama 10 hari, 61 celah telah ditambal di hulu (upstream) dan 43 telah memiliki patch di tahap staging.
Apakah eksploit ini dapat membobol server dari jarak jauh?
Tidak secara langsung. Kerentanan ini adalah bug eskalasi hak istimewa lokal (LPE), sehingga penyerang memerlukan akses awal lokal terlebih dahulu. Selalu perbarui patch sistem Anda dan isolasi beban kerja yang tidak tepercaya.
Berapa perkiraan biaya alur kerja ini pada repositori saya?
Angka dari OpenAI tidak dapat dijadikan acuan langsung karena mencakup skala pengujian tingkat kernel. Mulailah dari satu layanan, tetapkan batasan eksekusi, dan ukur biaya per temuan yang tervalidasi.
Apakah saya memerlukan model siber dari OpenAI?
Anda belum bisa menggunakannya saat ini, karena OpenAI menyatakannya sebagai model yang akan segera hadir. Tahapan alur kerja ini bersifat netral terhadap model, jadi Anda dapat mengujinya dengan agen koding yang sudah digunakan tim Anda dan menilai hasilnya berdasarkan bukti yang diperoleh.


