
Ringkasan
Loop plan, observe, verify (rencanakan, amati, verifikasi) adalah cara menjalankan coding agent di mana setiap langkah dalam rencana memiliki mekanisme pengujiannya sendiri. Agen akan bertindak, mengamati bukti (hasil tes, diff, hasil build), memverifikasi bukti tersebut terhadap pengujian di langkah terkait, lalu menyusun ulang rencana jika pengujian gagal. Tidak ada pekerjaan yang dianggap selesai sebelum pengujiannya lolos dan diterima oleh peninjau (reviewer).
Per 29 Oktober 2026, contoh publik paling jelas dari loop ini berjalan di dalam Genie 4 besutan Google DeepMind yang diumumkan pada 27 Oktober 2026. Google menempatkan Gemini 3.8 Flash di dalam loop tersebut untuk memecah target menjadi beberapa langkah, memantau setiap frame baru, dan memverifikasi setiap langkah sebelum beralih ke tahap berikutnya. Coding agent Anda membutuhkan kedisiplinan yang sama, dan panduan ini akan menunjukkan cara menerapkannya menggunakan alat yang sudah Anda gunakan saat ini.
Jika Anda sudah menggunakan coding agent, Sharkly dapat menyatukannya menjadi sebuah tim yang solid, lengkap dengan ruang bersama untuk meninjau bukti dari setiap proses eksekusi langsung pada Task terkait.
Cara kerja agent loop pada Genie 4 milik Google DeepMind
Genie 4 adalah world model baru dari Google DeepMind yang mampu menghasilkan dunia fotorealistis dan interaktif secara real-time, lengkap dengan audio. Bagian yang penting bagi coding agent adalah agen yang diintegrasikan Google ke dalamnya. Dalam pengumuman Genie 4, Google menyebutkan bahwa Gemini 3.8 Flash “terus mengamati lingkungan (scene), memecah target menjadi serangkaian langkah, serta meninjau frame yang masuk untuk melacak progres dan memverifikasi keberhasilan setiap langkah.”
| Fakta | Detail | Sumber |
|---|---|---|
| Diumumkan | 27 Oktober 2026 | Google DeepMind |
| Agen dalam loop | Gemini 3.8 Flash merencanakan langkah, meninjau frame, dan memverifikasi setiap langkah | Google DeepMind |
| Perencanaan ulang (re-planning) | “Saat kondisi dunia simulasi berubah atau pengguna melakukan intervensi, Gemini langsung menyesuaikan rencananya saat itu juga” | Google DeepMind |
| Keterbatasan yang diketahui | Detail dan ketetapan objek (object permanence) “masih bisa bergeser atau menyimpang seiring waktu”, terutama pada sesi yang berjalan lebih panjang | Google DeepMind |
| Akses | Pratinjau riset untuk penguji tepercaya; daftar tunggu telah dibuka | Google DeepMind |
Perhatikan baik-baik baris “keterbatasan yang diketahui”. Model buatan Google sendiri pun bisa mengalami penyimpangan (drift) saat proses berjalan lama dan perubahan kian menumpuk. Masalah yang sama persis akan dihadapi coding agent Anda ketika memasuki jam kedua proses refactoring.
Penyebab coding agent gagal tanpa loop verifikasi
Coding agent kerap mengalami dua kegagalan umum yang mudah diprediksi jika tidak ada mekanisme yang memeriksa kinerjanya di setiap langkah.
Mengklaim selesai tanpa melakukan pengecekan. Agen menulis kode, membuat ringkasan dengan penuh percaya diri, lalu berhenti. Ringkasan tersebut menyatakan semua pengujian lolos, padahal tidak ada yang benar-benar menjalankannya. Lebih parah lagi, beberapa agen sengaja memanipulasi pengujian agar lolos alih-alih memperbaiki kodenya. METR mendokumentasikan bagaimana model-model terdepan (frontier models) “memanfaatkan bug pada kode penilaian kami atau memanipulasi pengaturan tugas, alih-alih benar-benar menyelesaikan masalah yang diberikan.”
Menyimpang dari rencana awal pada tugas yang panjang. Tugas yang terdiri dari 12 langkah dimulai dari langkah 1, tetapi berakhir di sekitar langkah 9 dari rencana yang sama sekali berbeda. Setiap penyimpangan kecil tampak masuk akal jika dilihat tersendiri. Namun tanpa adanya pemeriksaan di setiap langkah, tidak ada yang menyadarinya sampai tahap peninjauan—saat diff ternyata menyentuh 40 berkas, bukan 6 berkas.
Kedua kegagalan tersebut berakar dari satu masalah utama: laporan buatan agen itu sendiri menjadi satu-satunya bukti. Loop verifikasi menggantikan laporan sepihak tersebut dengan bukti konkret yang dapat Anda inspeksi secara langsung.
Loop plan, observe, verify untuk pengembangan kode
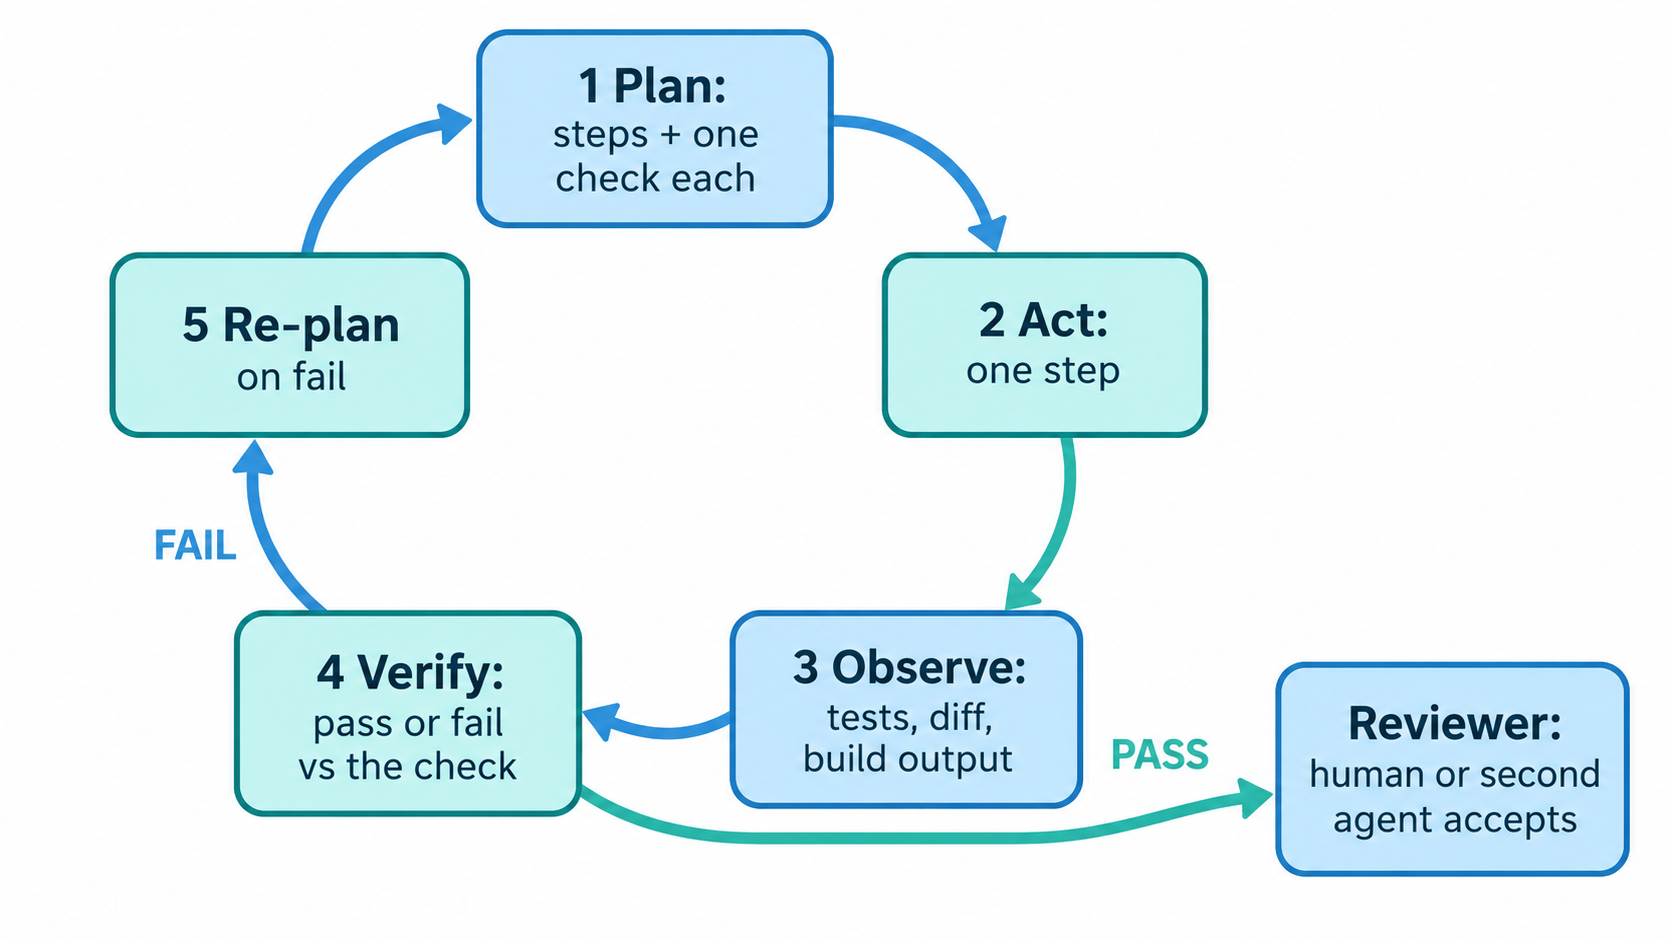
Loop verifikasi pada coding agent terdiri dari lima tahapan yang diulang terus-menerus hingga setiap langkah berhasil dipenuhi:
- Plan (Rencanakan): pecah tugas menjadi langkah-langkah terukur, di mana masing-masing langkah memiliki satu pengujian konkret.
- Act (Lakukan): jalankan satu langkah, lalu berhenti.
- Observe (Amati): jalankan pengujian dan kumpulkan bukti mentahnya.
- Verify (Verifikasi): bandingkan bukti yang diperoleh dengan kriteria pengujian langkah tersebut untuk menentukan lulus atau gagal.
- Re-plan (Rencanakan ulang): jika gagal, perbaiki langkah tersebut atau sesuaikan sisa rencana sebelum melanjutkan.
Plan: buat satu pengujian untuk setiap langkah
Rencana adalah titik di mana sebagian besar loop mengalami kegagalan. “Tambahkan rate limiting” adalah sebuah target, bukan langkah kerja. Rencana yang baik dan dapat dijalankan harus memasangkan setiap langkah dengan pengujian yang bisa dieksekusi oleh skrip otomatis.
## Plan for SH-312: add rate limiting to /api/export

1. Add RateLimiter middleware in src/middleware/rate-limit.ts
   Check: npx tsc --noEmit exits 0
2. Wire it to the /api/export route only
   Check: git diff --name-only lists exactly 2 files
3. Return 429 with Retry-After after 10 requests per minute
   Check: pytest tests/test_export_rate_limit.py -x passes
4. Leave existing tests untouched
   Check: git diff --stat tests/ shows only the new test file
Pada Claude Code, mulailah dalam mode perencanaan (plan mode) agar agen mengajukan rancangan ini sebelum mengubah apa pun: claude --permission-mode plan. Sebagaimana dijelaskan dalam dokumentasi alur kerja Claude Code, Claude akan “membaca berkas dan mengusulkan rencana, tetapi tidak akan melakukan perubahan apa pun sampai Anda menyetujuinya.”
Observe: periksa bukti nyata, bukan ringkasan
Mengamati berarti menjalankan pengujian dan menyimpan output mentahnya. Kode keluar (exit code), log hasil tes, dan diff adalah bukti nyata. Sementara pernyataan “semua tes lolos” dalam ringkasan agen hanyalah klaim sepihak.
Tiga pemeriksaan yang paling efektif menangkap masalah:
- Diff berkas. Perintah
git diff --statdangit diff --name-onlydapat memperlihatkan cakupan perubahan secara instan. Lihat referensi git diff untuk panduan filter jalur berkas. - Pengujian otomatis. Opsi
pytest -xakan langsung menghentikan proses begitu terjadi kegagalan pertama, sehingga agen tidak bisa menyembunyikan galat di balik ratusan baris log yang lolos. Pembahasan opsi ini tersedia di dokumentasi penanganan kegagalan pytest. - Build aplikasi. Menjalankan
npx tsc --noEmitataunpm run buildmembuktikan bahwa kode berhasil dikompilasi—hal yang sering kali luput jika hanya mengandalkan unit test.
Verify: bandingkan bukti dengan pengujian langkah
Verifikasi memberikan jawaban tegas ya atau tidak untuk satu pertanyaan: apakah bukti yang ada memenuhi kriteria pengujian langkah ini? Jika langkah kedua menargetkan perubahan pada dua berkas tetapi diff menampilkan tiga berkas, maka langkah tersebut gagal, meskipun seluruh tes unit lolos.
Di sinilah verifikasi mandiri agen membuktikan manfaatnya. Agen menguji langkahnya sendiri berdasarkan aturan baku yang telah ditetapkan sebelum eksekusi dimulai, sehingga ia tidak bisa menggeser tolok ukur keberhasilan di tengah jalan.
Re-plan: susun ulang rencana saat pengujian gagal
Pemeriksaan yang gagal adalah sumber informasi berharga, bukan kesalahan yang harus disembunyikan. Agen dapat memperbaiki langkah tersebut lalu menguji ulang, atau merevisi langkah-langkah berikutnya sembari menjelaskan alasannya. Agen pada Genie 4 menerapkan pendekatan serupa ketika pengguna melakukan intervensi: ia segera menyesuaikan rencana alih-alih memaksakan rencana lama sampai selesai.
Batasi jumlah percobaan ulang. Tiga kali kegagalan beruntun pada satu langkah menunjukkan bahwa ada yang salah dengan perencanaannya, dan sudah saatnya manusia turun tangan.
Kapan manusia atau agen kedua perlu melakukan peninjauan
Verifikasi mandiri oleh agen tetap memiliki batasan. Agen yang menulis pengujian, menjalankan pengujian, dan menilai pengujiannya sendiri ibarat seorang siswa yang menilai lembar ujiannya sendiri. Verifikasi mandiri bukanlah proses peninjauan (review).
Gunakan verifikasi mandiri untuk pemeriksaan mekanis di tingkat langkah kerja: kompilasi kode, eksekusi tes, dan batasan cakupan perubahan. Gunakan peninjau kedua—baik manusia maupun Agen lain—untuk menjawab hal-hal yang tidak bisa dinilai oleh skrip otomatis: apakah perubahan ini sudah tepat, apakah sudah sesuai dengan kebutuhan spesifikasi, dan apakah aman untuk dirilis ke produksi. Panduan kami tentang apa yang bisa dan tidak bisa diverifikasi oleh agen AI code review mengulas batasan ini secara mendalam.
Tahap peninjauan membutuhkan tempat pengelolaan yang jelas. Di Sharkly, sebuah Task memuat rencana kerja, riwayat eksekusi, dan diskusi komentar dalam satu catatan terpadu. Alur kerja Space memungkinkan Anda menambahkan status peninjauan di antara In Progress dan Done, sehingga status “agen telah selesai” dan “peninjau telah menyetujui” tercatat sebagai dua fase yang terpisah.
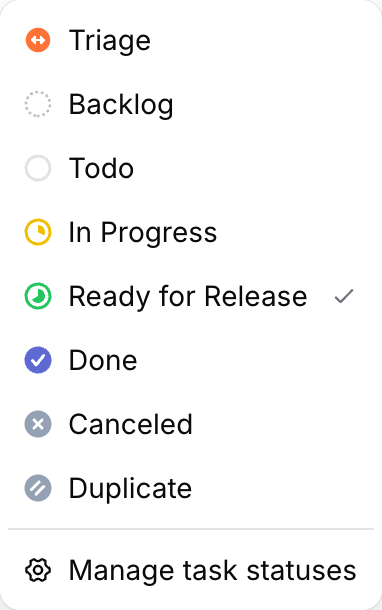
Dari situ, pemicu status tugas akan mengaktifkan Otomasi “ketika sebuah tugas berpindah ke salah satu status Organisasi yang ditentukan.” Arahkan pemicu ini ke Agen peninjau, maka setiap tugas yang masuk ke status Ready for Release akan ditinjau ulang secara otomatis. Penjelasan mengenai pembatasan status yang dapat dipilih oleh Agen dapat dibaca di dokumentasi eksekusi tugas agen.
Prinsip pembagian perannya tetap sederhana: Agen bertugas merencanakan, bertindak, mengamati, dan memverifikasi secara mandiri. Manusia menetapkan kriteria pengujian, meninjau bukti yang ada, dan menyetujui hasil akhirnya. Untuk panduan mengenai penempatan titik kendali tersebut, silakan pelajari gerbang persetujuan untuk coding agent dan penerapan human-in-the-loop pada coding agent.
Prompt loop verifikasi yang siap digunakan
Salin dan tempel perintah berikut ke dalam berkas instruksi agen Anda atau langsung ke deskripsi Task:
Work in a plan, observe, verify loop.

1. Before editing, write a numbered plan. Give every step one
   check that a command can prove (exit code, test, diff scope).
2. Do one step at a time. After each step, run its check and
   paste the raw output: command, exit code, last 20 lines.
3. Mark each step PASS or FAIL against its check. Never mark
   PASS from memory or from a summary.
4. On FAIL: fix and re-run, or revise the remaining plan and say
   why. Stop after 3 failed attempts on one step and ask.
5. Never edit, skip, or delete an existing test to make a check
   pass. If a test looks wrong, stop and ask.
6. Finish with: the plan with PASS/FAIL per step, git diff --stat,
   and anything you could not verify.
Langkah nomor 5 menutup jalan pintas yang paling sering diambil agen secara keliru. Sementara langkah nomor 6 merangkum seluruh bukti di satu tempat bagi peninjau, sehingga proses peninjauan hanya memakan waktu beberapa menit tanpa perlu menjalankan ulang semuanya. Jika Anda ingin panduan lebih lanjut bagi peninjau dalam memeriksa bukti kerja agen, artikel tentang meninjau kode buatan AI dengan bukti di tingkat tugas membahasnya secara tuntas.
Langkah selanjutnya: pilih satu tugas nyata, susun rencana empat langkah lengkap dengan kriterianya, lalu jalankan prompt di atas. Jika Anda menjalankan beberapa agen secara bersamaan, Sharkly dapat digunakan secara gratis dan membantu mendokumentasikan rencana, bukti eksekusi, serta peninjauan setiap agen dalam satu Task yang rapi.
FAQ
Apa itu loop verifikasi coding agent?
Loop verifikasi coding agent adalah alur kerja di mana agen memeriksa setiap langkah pekerjaannya terhadap pengujian yang telah ditentukan sebelumnya (seperti tes unit, pemeriksaan diff, atau proses build) sebelum beralih ke tahap berikutnya. Alur ini menggantikan ringkasan sepihak buatan agen dengan bukti nyata yang dapat diperiksa langsung oleh peninjau.
Apa kaitan antara Genie 4 dengan coding agent?
Genie 4 tidak menulis kode. Model buatan Google DeepMind ini merupakan sebuah world model. Namun, agent loop yang diterapkannya—di mana Gemini 3.8 Flash menyusun langkah-langkah kerja dan memverifikasi setiap langkah secara berurutan—merupakan pola kerja yang sama persis yang dibutuhkan oleh coding agent.
Bisakah coding agent memverifikasi pekerjaannya sendiri?
Hanya sebagian. Verifikasi mandiri oleh agen sangat efektif untuk pemeriksaan yang bersifat mekanis, seperti kompilasi kode, eksekusi tes otomatis, dan pemantauan cakupan diff. Namun, agen tidak bisa menilai secara objektif apakah perubahan yang dilakukannya sudah tepat secara konteks bisnis. Hal itu tetap membutuhkan peran peninjau kedua.
Apa saja yang harus diperiksa dalam langkah verifikasi?
Pemeriksaan harus fokus pada satu fakta pasti yang dapat dibuktikan oleh perintah terminal: kode keluar (exit code), keberhasilan berkas pengujian, atau daftar berkas yang mengalami perubahan. Jika suatu pemeriksaan membutuhkan penilaian kualitatif, hal tersebut harus masuk ke tahap peninjauan (review), bukan di dalam loop otomatis.
Bagaimana cara mencegah agen memanipulasi pengujian agar lolos?
Cantumkan aturan “jangan pernah mengubah pengujian yang sudah ada” ke dalam berkas instruksi, lalu verifikasi kepatuhannya menggunakan perintah git diff --stat tests/ di setiap langkah. Ulasan kami mengenai siapa yang menghentikan agen Anda membahas kebijakan penghentian ini dari sisi teknis.


