
Argon atau Carbon? Jalankan sebagian besar Task agen di Gemini 4 Argon dan serahkan pekerjaan sulit saja ke Gemini 4 Carbon. Google sendiri menyatakan demikian: Argon tetap menjadi pilihan default untuk sebagian besar rekayasa perangkat lunak, sementara Carbon ditujukan untuk tugas-tugas yang lebih berat. Keduanya mematok biaya $2 untuk input dan $10 untuk output per satu juta token hingga 30 November 2026, tetapi Carbon menghabiskan lebih banyak token per Task.
Ringkasan (TL;DR)
- Gunakan model hemat secara default, eskalasikan berdasarkan bukti. Mulai setiap Task dengan model yang cepat. Alihkan ke model yang lebih tinggi hanya jika Task terbukti sulit berdasarkan aturan yang terukur, atau saat Task tersebut sudah gagal satu kali.
- Harga per token yang sama tidak berarti biaya per Task-nya sama. Carbon membaca lebih banyak, bernalar lebih lama, dan memverifikasi lebih intensif, sehingga satu Task menghabiskan lebih banyak token.
- Empat sinyal penanda Task yang sulit: alur pengerjaan panjang (long horizon), melibatkan banyak berkas, berdampak pada keamanan, serta kegagalan pada percobaan pertama.
- Ukur dua metrik per Task: biaya dan tingkat kelulusan saat peninjauan (review pass rate). Tentukan perutean (routing) berdasarkan kedua metrik tersebut, bukan papan peringkat (leaderboard).
- Jadikan pemilihan model sebagai setelan, bukan keputusan yang dibuat berulang di setiap prompt. Di Sharkly, setiap Agen memiliki model Default, dan Anda dapat menggantinya (override) khusus untuk satu kali proses saat menugaskan Task.
Mengapa “model mana yang terbaik” adalah pertanyaan yang keliru
Gemini 4 Carbon resmi dirilis ke publik (GA) pada 10 November 2026 dengan model ID gemini-4-carbon. Artikel pengumuman GA dari Google memuat hal yang jarang ditemukan dalam pengumuman peluncuran produk: mereka secara gamblang menyarankan pengguna untuk tidak memakai model terbarunya untuk sebagian besar pekerjaan: “Argon tetap menjadi pilihan ideal untuk sebagian besar rekayasa perangkat lunak dan tugas-tugas berbasis pengetahuan.”
Masih dari artikel yang sama, Carbon “dibangun untuk tugas-tugas yang menguji batas kecerdasan model,” dan model ini menggunakan “lebih banyak token dibanding Argon guna mengeksplorasi secara menyeluruh, bernalar lebih mendalam, serta menjalankan putaran verifikasi yang diperluas.”
Pendekatan ini sangat selaras dengan cara tim mengoperasikan agen. Anda memiliki antrean Task dengan tingkat kesulitan yang bervariasi, dan setiap Task selayaknya ditangani oleh model paling hemat yang sanggup lolos tahap peninjauan. Memaksakan satu “model terbaik” untuk seluruh tim hanya akan membuang biaya pada Task mudah atau kurang bertenaga saat menghadapi Task yang sulit.
Jika Anda ingin memahami gambaran lengkap tentang Carbon terlebih dahulu, artikel kami tentang Gemini 4 Carbon untuk agen pemrograman membahas detail kemampuannya, sedangkan panduan Gemini 4 Argon mengulas model default tersebut.
Aturan perutean: hemat secara default, eskalasikan saat sulit
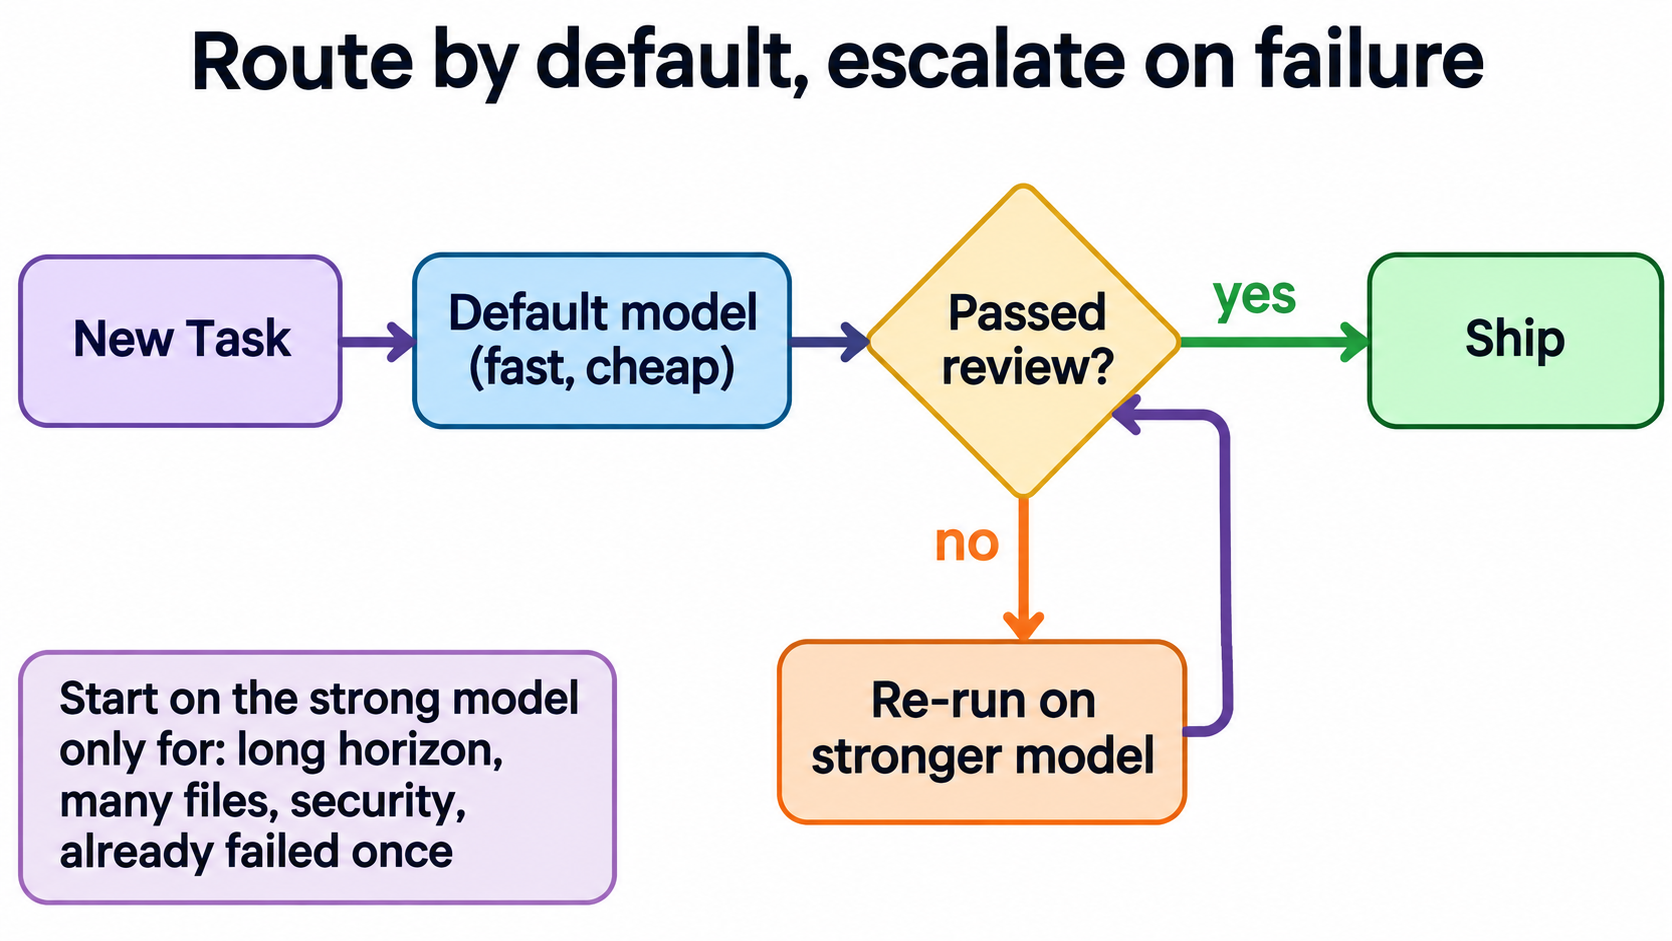
Perutean model (model routing) untuk agen koding berarti memilih model per Task, bukan per tim. Aturannya sangat ringkas: setiap Task dimulai dengan model default, dan hanya dialihkan ke model yang lebih tangguh jika terdapat sinyal tertulis bahwa tugas tersebut sulit atau jika model default gagal menyelesaikannya.
Ada dua bagian yang membuat aturan ini efektif.
- Model default yang cepat dan cukup andal untuk sebagian besar Task. Bagi tim yang memakai Gemini, model tersebut adalah Argon, sesuai anjuran Google sendiri.
- Jalur eskalasi dengan pemicu yang terukur dan dapat diaudit. “Tugas ini rasanya sulit” bukanlah pemicu. Namun, “Menyentuh kode autentikasi” adalah pemicu yang valid.
Cara mengenali Task yang sulit
Anda memerlukan sinyal yang dapat diidentifikasi dari deskripsi Task sebelum dijalankan. Empat sinyal berikut mencakup sebagian besar skenario.
Alur pengerjaan yang panjang (Long horizon)
Task yang membutuhkan banyak langkah berurutan—seperti migrasi dengan sepuluh perubahan yang saling bergantung—memberi peluang lebih besar bagi model yang lebih sederhana untuk keluar jalur (drift). Siklus verifikasi ekstra milik Carbon dirancang khusus untuk mengatasi kasus seperti ini. Sinyal pemicu: deskripsi Task mencantumkan lebih dari lima langkah, atau eksekusi sebelumnya untuk pekerjaan serupa melebihi alokasi waktu Anda.
Melibatkan banyak berkas
Perubahan yang bersifat lintas modul (cross-cutting) menuntut model untuk memahami konteks basis kode yang lebih luas secara bersamaan. Sinyal pemicu: perubahan mencakup beberapa paket (package) atau lebih dari sepuluh berkas.
Berdampak pada keamanan
Area seperti autentikasi, pembayaran, pengelolaan kredensial rahasia (secrets), dan pemeriksaan izin sangat berisiko terhadap jawaban salah yang dihasilkan dengan meyakinkan oleh model AI. Artikel GA Google menyebutkan bahwa Carbon memimpin tolok ukur SEC-bench Pro dan CWE-bench v1 saat diakses lewat Program Fairwind untuk praktisi keamanan siber. Sinyal pemicu: Task menyentuh direktori atau berkas yang telah Anda tandai sebagai area sensitif.
Sudah pernah gagal satu kali
Ini adalah sinyal yang paling hemat dan paling objektif. Jika eksekusi model default gagal dalam tahap peninjauan (review), Anda memiliki bukti nyata bahwa Task tersebut melampaui kapabilitasnya. Jalankan kembali pada model yang lebih tangguh dengan menyertakan catatan dari peninjau.
Tabel perutean awal yang bisa Anda terapkan
Gunakan tabel ini sebagai acuan awal, lalu sesuaikan kembali berdasarkan tingkat kelulusan tim Anda setelah dua minggu berjalan.
| Jenis Task | Mulai di | Eskalasikan ke | Alasan |
|---|---|---|---|
| Typo, perubahan teks/copy, pembaruan dependensi | Tingkat cepat (model Flash atau mini) | Argon | Perbedaan kode (diff) kecil, mudah ditinjau |
| Perbaikan bug dengan tes yang gagal | Argon | Carbon | Tes memberikan sinyal kelulusan yang jelas |
| Fitur baru dalam satu modul | Argon | Carbon | Standar default yang direkomendasikan Google untuk sebagian besar rekayasa perangkat lunak |
| Pembenahan kode (refactor) di banyak berkas | Carbon | Fable 5.2 atau peninjau manusia | Alur pengerjaan panjang, melibatkan banyak berkas |
| Autentikasi, pembayaran, perizinan | Carbon | Selalu ditinjau manusia | Berdampak pada keamanan |
| Setiap Task yang pernah gagal ditinjau sekali | Naik satu tingkat | Manusia | Bukti nyata lebih baik daripada asumsi |
Biaya Claude Fable 5.2 tercatat sebesar $8 untuk input dan $40 untuk output per satu juta token—empat kali lipat dari harga perkenalan Carbon—sehingga model ini diposisikan di atas Carbon sebagai langkah otomatis terakhir, bukan sebagai default. Harga Carbon sendiri akan naik menjadi $4 dan $20 setelah 30 November 2026 menurut catatan kaki Google, yang memperkecil selisih tersebut. Pastikan untuk memeriksa tarif terbaru di halaman harga Gemini API sebelum Anda menetapkan anggaran.
Eskalasikan saat gagal, bukan sejak awal
Banyak tim cenderung langsung mengarahkan apa pun yang “terdengar sulit” ke model terkuat. Pendekatan ini memang terasa aman, tetapi memakan biaya besar, padahal sebagian besar Task tersebut sebenarnya bisa diselesaikan dengan baik oleh model default.
Eskalasi berbasis kegagalan hanya membayar biaya model hemat di setiap Task, dan mengeluarkan biaya model besar hanya jika Task tersebut terbukti benar-benar membutuhkannya. Biaya satu kali eksekusi murah yang gagal sering kali jauh lebih rendah daripada satu kali eksekusi mahal yang sebenarnya tidak diperlukan.
Ada dua pengecualian untuk aturan ini, dan keduanya sudah dicantumkan dalam tabel di atas. Pekerjaan terkait keamanan langsung dimulai di tingkat tinggi karena eksekusi awal yang buruk berisiko tergabung (merged) jika terlewat saat peninjauan. Sementara itu, refactor panjang yang melibatkan banyak berkas langsung dimulai di tingkat tinggi karena kegagalan pada proses tersebut menghabiskan waktu berjam-jam, bukan hitungan menit.
Selain itu, eksekusi yang gagal hanya akan berguna jika peninjauan berhasil mendeteksinya. Model AI terkadang bisa mengakali pengujian, jadi padukan strategi eskalasi ini dengan pemeriksaan di cara menangkap agen koding yang memanipulasi tes.
Ukur biaya dan tingkat kelulusan per Task
Menentukan perutean tanpa metrik angka hanya akan berujung pada asumsi subjektif. Catat dua hal berikut untuk setiap Task.
- Biaya per Task: jumlah token input dan output dikalikan harga model terkait, diakumulasikan dari seluruh eksekusi yang dijalankan untuk Task tersebut, termasuk eksekusi yang gagal.
- Tingkat kelulusan saat peninjauan: apakah eksekusi pertama langsung lolos, atau membutuhkan eksekusi ulang maupun perbaikan manual oleh manusia?
Kemudian lakukan pembagian. Biaya per perubahan yang diterima (cost per accepted change) adalah metrik penentu dalam perutean. Model murah yang gagal separuh waktu bisa berakhir lebih mahal dibanding model tangguh yang langsung berhasil pada percobaan pertama, sebagaimana dibahas dalam alasan model yang lebih murah bisa memakan biaya lebih besar.
Data dari pihak ketiga pun menunjukkan tren serupa. Artificial Analysis melaporkan bahwa pengujian Intelligence Index mereka menghabiskan $7,76 di Gemini 4 Carbon (high) dan $26,54 di Claude Fable 5.2 (max), dengan Fable meraih skor 65 berbanding 60 milik Carbon. Selisih skor lima poin dengan biaya 3,4 kali lipat hanya sepadan jika lima poin tersebut benar-benar menentukan hasil akhir Task Anda.
Catatan log sederhana sudah cukup untuk memulai:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
Pada contoh di atas, COIN-213 gagal saat dijalankan di Argon, dieskalasikan, dan akhirnya berhasil di Carbon. Total biaya Task tersebut adalah $1,29, dan data baris ini memberi Anda kejelasan apakah Task serupa sebaiknya langsung dimulai di Carbon di kemudian hari.
Terapkan per Task di papan kerja
Aturan ini mudah dirumuskan tetapi sulit dipatuhi jika setiap developer bebas memilih model sendiri di terminal masing-masing. Terapkan mekanisme perutean langsung di tempat Task dikelola.
Tetapkan model khusus untuk setiap Agen
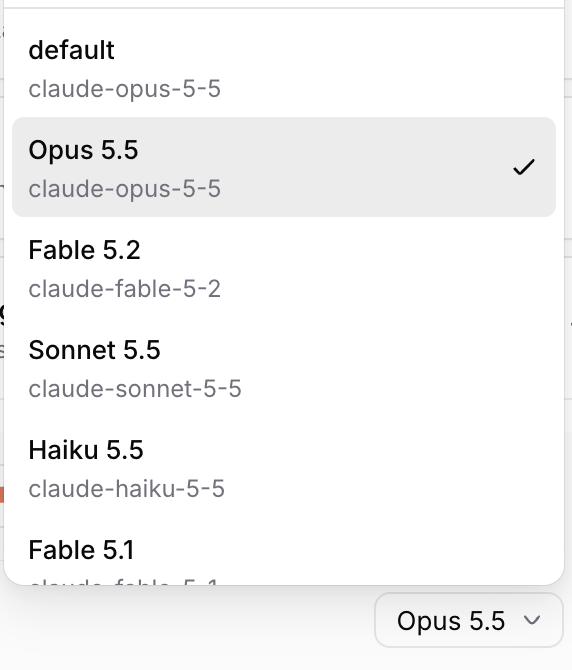
Di Sharkly, Agen secara default mengikuti model dari Runtime-nya, dan baris Model pada pengaturan Agen memungkinkan Anda memilih model lain dari katalog Runtime tersebut, serta kedalaman berpikir (thinking depth) jika model menyediakannya. Dokumentasi Agents membahas hal ini secara mendalam. Dengan begitu, Anda memiliki satu Agen untuk setiap tingkatan: Agen default dengan model cepat dan Agen eskalasi dengan model tangguh.
Eskalasikan untuk satu kali eksekusi
Saat menugaskan Task, Anda dapat memilih model khusus untuk proses tersebut guna menggantikan (override) model default Agen hanya pada eksekusi itu saja. Ini merupakan eskalasi berbasis kegagalan dalam satu langkah mudah: peninjau mengembalikan Task, dan eksekusi ulang langsung diarahkan ke Carbon tanpa mengubah Agen yang digunakan oleh anggota tim lainnya.
Simpan seluruh riwayat di satu tempat
Setiap proses menyimpan log eksekusinya, sehingga tabel biaya dan tingkat kelulusan Anda bersumber dari Task nyata yang telah diselesaikan, bukan sekadar perkiraan ingatan. Bagi tim (Crews) yang membagi pekerjaan berdasarkan peran alih-alih tingkat kesulitan, silakan baca perutean model untuk Crew agen. Dari sisi pengawasan, artikel siapa yang mengawasi agen Anda mengulas kendali yang tetap berada di tangan tim Anda. Sharkly dapat digunakan secara gratis untuk memulai.
Alternatif selain perutean per Task
- Satu model untuk semua pekerjaan. Cukup memadai bagi developer solo, tetapi boros biaya begitu jenis Task mulai bervariasi.
- Model perute otomatis (automatic router model). Model kecil mengklasifikasikan setiap prompt dan memilih model tujuan. Cara ini membuat alur keputusan tidak transparan dan tidak dapat melihat hasil peninjauan yang gagal.
- Mode tim agen (agent-team modes). Pratinjau /swarm dari Google di Antigravity menugaskan Carbon untuk perencanaan dan audit, sementara model yang lebih ringan bekerja secara paralel. Ini merupakan perutean berdasarkan peran di dalam satu pekerjaan, yang menjadi pelengkap bagi perutean per Task.
Kesimpulan
Google sendiri telah memberikan panduan perutean dalam artikel peluncuran mereka: gunakan Argon secara default, dan alihkan ke Carbon saat Task benar-benar membutuhkannya. Tentukan empat sinyal Task sulit bagi tim Anda, mulai pekerjaan lain dengan model hemat, eskalasikan saat peninjauan gagal, serta catat biaya dan tingkat kelulusan per Task. Setelah dua minggu, data riil Anda sendiri akan menyempurnakan tabel tersebut jauh lebih baik daripada tolok ukur (benchmark) mana pun.
Langkah selanjutnya: siapkan dua Agen di Sharkly—satu menggunakan model default dan satu lagi dengan model eskalasi—lalu mulai jalankan Task minggu ini melalui keduanya.
FAQ
Haruskah saya menggunakan Gemini 4 Carbon atau Argon untuk agen koding?
Gunakan Argon untuk sebagian besar Task dan simpan Carbon untuk tugas-tugas yang sulit. Artikel GA dari Google menegaskan bahwa Argon “tetap menjadi pilihan ideal untuk mayoritas rekayasa perangkat lunak”, sedangkan Carbon dirancang untuk Task yang menguji batas kemampuan model.
Apakah Gemini 4 Carbon lebih mahal dibandingkan Argon?
Secara per token, tidak: keduanya mematok biaya $2 untuk input dan $10 untuk output per satu juta token hingga 30 November 2026. Namun secara per Task, biasanya iya, karena Google menyatakan bahwa Carbon menggunakan lebih banyak token untuk mengeksplorasi dan memverifikasi solusi.
Bagaimana skema harga Gemini 4 Carbon setelah 30 November?
Catatan kaki Google menyebutkan bahwa harga perkenalan akan berakhir pada 30 November 2026, dan tarif Carbon akan disesuaikan menjadi $4 per satu juta token input dan $20 per satu juta token output.
Apa itu perutean model (model routing) untuk agen AI?
Perutean model (model routing) adalah strategi memilih model untuk setiap Task berdasarkan tingkat kesulitannya, dengan tujuan mencapai biaya terendah untuk setiap perubahan kode yang berhasil diterima.
Kapan saya harus mengeskalasikan Task ke model yang lebih tangguh?
Eskalasikan ketika Task memiliki alur pengerjaan yang panjang, mencakup banyak berkas, menyentuh kode yang sensitif terhadap keamanan, atau sudah pernah gagal saat ditinjau pada model default.
Dapatkah saya mengatur model yang berbeda untuk setiap agen di Sharkly?
Bisa. Setiap Agen memiliki opsi Model di pengaturannya untuk memilih model dari katalog Runtime, dan Anda dapat mengganti model tersebut khusus untuk satu kali eksekusi saat menugaskan Task.


