
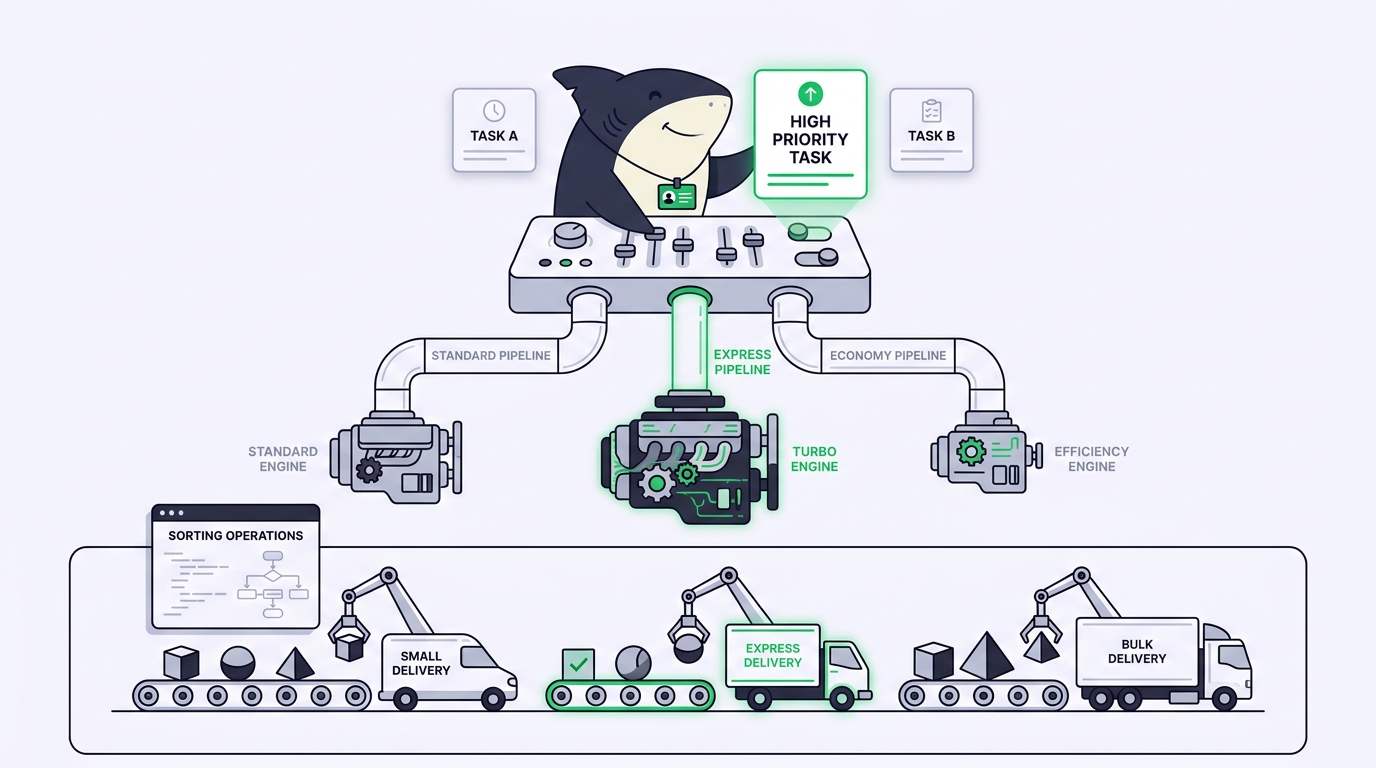
TL;DR: Berhenti mencari satu model terbaik. Cocokkan setiap model dengan bentuk tugas yang ada di depan Anda: penalaran mendalam untuk arsitektur dan refactor lintas file, cepat dan murah untuk boilerplate serta pengujian, konteks panjang untuk pertanyaan seputar seluruh repo, dan kemampuan mengikuti tool yang stabil untuk pengeditan multi-langkah. Memilih model per terminal masih cukup untuk satu atau dua agen. Begitu Anda menjalankan beberapa tugas lintas repo, pemetaan itu seharusnya disimpan dalam sebuah Agent, bukan di kepala Anda. Berikut petaannya, satu contoh penerapan, dan checklist yang bisa Anda jalankan hari ini.
Anda membuka lima terminal. Satu menjalankan refactor rumit, satu butuh sekumpulan unit test, satu menjawab pertanyaan tentang codebase yang Anda sendiri setengah lupa, satu lagi memburu test integrasi yang flaky, dan satu lagi mengganti nama sebuah simbol di empat puluh file. Semuanya diam-diam menanyakan hal yang sama: model mana yang cocok menjalankan ini? Arahkan model penalaran kelas berat ke tugas rename, dan Anda membuang token serta waktu untuk pekerjaan yang bisa diselesaikan dengan bersih oleh model cepat mana pun. Arahkan model cepat ke perubahan arsitektur, dan ia melewatkan dependensi tiga file jauhnya. Keluhan yang muncul berulang kali jarang berupa "modelnya jelek". Yang sering terdengar adalah "saya tidak tahu harus pakai yang mana".
Solusinya bukan papan peringkat. Peringkat berubah setiap beberapa minggu, dan pemenang benchmark umum sering kali justru pilihan yang salah untuk tugas spesifik Anda. Langkah yang tahan lama adalah mencocokkan model dengan bentuk tugas: seberapa dalam penalaran yang dibutuhkan, seberapa besar konteks yang harus ditampung, seberapa andal ia mengikuti tool, dan seberapa besar biaya per eksekusi. Properti-properti ini hampir tidak berubah meski nama-nama model terus berganti.
Di sinilah lapisan tugas menjadi penting. Sharkly adalah platform perintah dan manajemen Agent serba bisa. Ia berada di atas coding agent Anda, sehingga "model mana untuk tugas mana" tidak lagi menjadi keputusan yang harus Anda ambil ulang di setiap terminal. Anda menyimpan keputusan itu sekali sebagai Agent, yaitu konfigurasi yang bisa dipakai ulang berisi peran, runtime, dan aturannya, lalu menetapkan Task ke Agent yang bentuknya sesuai. Anda sudah punya coding agent. Sharkly mengubahnya menjadi sebuah tim.
Cocokkan model dengan bentuk tugasnya, bukan dengan papan peringkat
Memilih model sebenarnya adalah empat pertanyaan, yang diajukan secara berurutan.
- Kedalaman penalaran. Apakah tugasnya butuh perencanaan multi-langkah lintas file, atau hanya perubahan lokal yang mekanis? Arsitektur, refactor yang rumit, dan debugging akar masalah sangat diuntungkan oleh model penalaran yang lebih kuat. Rename, format, dan scaffolding tidak.
- Ukuran konteks. Apakah model perlu menampung seluruh repositori, spesifikasi panjang, atau log raksasa sekaligus? Pertanyaan seputar seluruh codebase dan migrasi besar diuntungkan oleh model konteks panjang, meski kemampuannya sedikit kurang dalam dalam hal penalaran.
- Keandalan mengikuti tool. Pekerjaan multi-langkah (edit, jalankan test, baca output, edit lagi) berhasil atau gagal tergantung pada seberapa konsisten model menggunakan tool tanpa keluar dari alur. Model yang bernalar cemerlang tapi lupa menjalankan test lebih buruk di sini daripada model yang lebih stabil.
- Kecepatan dan biaya. Pekerjaan bervolume tinggi dengan risiko rendah (test, boilerplate, docstring) sebaiknya diserahkan ke model tercepat dan termurah yang memenuhi standar. Simpan penalaran mahal untuk tugas yang benar-benar membutuhkannya.
Gunakan model penalaran kelas berat saat satu langkah yang salah membuat Anda menghabiskan seharian untuk debugging. Gunakan model cepat dan murah saat tugasnya mekanis dan mudah diverifikasi. Hampir setiap hari Anda membutuhkan keduanya, untuk tugas berbeda, secara bersamaan. Itulah sebabnya pengaturan satu model global terasa salah: ia memaksakan satu jawaban untuk tugas-tugas yang menginginkan jawaban berbeda.
Peta kasar dari jenis tugas ke peran model
Nama-nama tugas di bawah ini bertahan lebih lama daripada versi model tertentu. Baca model card terbaru dari vendor sebelum mengaitkan sebuah kategori dengan nama model, lalu pertahankan kategorinya.
| Tugas di depan Anda | Optimalkan untuk | Peran model |
|---|---|---|
| Arsitektur, refactor lintas file, tinjauan desain | Kedalaman penalaran | Reasoner kelas berat |
| Debugging akar masalah, pelacakan test flaky | Penalaran + tool yang stabil | Reasoner kelas berat |
| Tanya jawab seluruh repo, migrasi besar, pekerjaan spesifikasi panjang | Ukuran konteks | Model konteks panjang |
| Unit test, boilerplate, docstring, scaffolding | Kecepatan dan biaya | Model cepat dan murah |
| Rename mekanis, format, edit massal | Kecepatan | Model cepat dan murah |
| Loop agen multi-langkah (edit, test, ulangi) | Keandalan mengikuti tool | Pengguna tool yang stabil |
Dua catatan jujur. Pertama, "kelas berat" bukan berarti "selalu lebih baik". Untuk tugas rename, model penalaran mendalam lebih lambat, lebih mahal, dan tidak lebih benar daripada model cepat. Kedua, runtime seperti Claude Code, Codex, atau Gemini CLI membawa model default-nya sendiri, dan penggunaan model tetap mengikuti langganan atau API key yang dikonfigurasi di tool tersebut, jadi pilihan nyata Anda adalah model-model yang sudah dibayar tim Anda, dipasangkan ke kategori-kategori ini. Benchmark tugas publik seperti SWE-bench hanya memberi gambaran kasar sebuah model berada di tingkat mana, bukan model mana yang dibutuhkan tugas spesifik Anda.
Di mana memilih model per terminal berhenti bisa diskalakan
Untuk satu atau dua agen, memilih secara manual tidak masalah. Anda membuka terminal, mengatur modelnya, dan Anda ingat apa ada di mana karena hanya ada dua. Pengaturan yang berhasil hari ini adalah satu orang dan beberapa tool.
Masalahnya mulai muncul saat volumenya bertambah. Jalankan enam tugas di tiga repositori, dan pemetaan model ke tugas kini hanya ada di kepala Anda: terminal mana yang murah, repo mana yang Anda atur ke reasoner Selasa lalu, kenapa migrasinya lambat sekali (ternyata masih memakai model cepat). Saat rekan tim melanjutkan pekerjaan Anda, pemetaan itu tidak berpindah bersama tugasnya; ia tetap tersimpan di ingatan Anda, dan hasilnya berserakan di terminal-terminal pribadi alih-alih kembali ke satu tempat bersama.
Sebuah Agent adalah konfigurasi tersimpan tentang bagaimana suatu jenis pekerjaan harus ditangani: sebuah peran, runtime beserta modelnya, dan aturan-aturan yang menyertainya. Alih-alih memutuskan ulang model di setiap terminal, Anda membangun Agent sekali ("Test Writer" di model cepat, "Refactorer" di model reasoner) lalu menetapkan Task ke Agent yang bentuknya sesuai. Pilihan model menjadi bisa dipakai ulang, bukan permainan mengingat. Agent meneliti, mengeksekusi, menguji, dan melaporkan; manusia menentukan arah dan menerima hasilnya. Eksekusi, hambatan, dan hasil kembali ke Task, sehingga alasan di balik setiap pilihan model terlihat dari permintaan hingga rilis, bukan terkubur dalam riwayat scrollback.
Sharkly bukan pengganti Claude Code, Codex, atau tool eksekusi lainnya. Ia menambahkan lapisan tugas, konteks, dan tinjauan bersama di sekitar model yang sudah tim Anda jalankan. Jika Anda hanya menjalankan satu agen di satu terminal, Anda tidak membutuhkannya. Begitu Anda menjalankan beberapa agen secara paralel, keputusan pencocokan model justru adalah hal yang layak disimpan.
Contoh penerapan: tiga tugas, tiga Agent
Misalnya sebuah sprint memasukkan tiga tugas ke antrean.
- SH-312: ganti nama
UserSessionmenjadiAuthSessiondi seluruh repo. Mekanis, mudah diverifikasi. Arahkan ke Agent "Renamer" dengan model cepat dan murah. Ia mengedit, menjalankan type checker, dan mengembalikan diff yang bersih. Menghabiskan token reasoner di sini tidak memberi manfaat apa pun. - SH-318: alur checkout menagih ganda saat retry. Debugging akar masalah lintas service. Arahkan ke Agent "Debugger" dengan reasoner kelas berat yang penggunaan tool-nya stabil. Ia perlu merencanakan, membaca log, membentuk hipotesis, dan mengujinya. Model cepat di sini hanya akan menebak-nebak dan membuang satu siklus tinjauan.
- SH-324: jawab "bagaimana sistem billing kami direkonsiliasi dengan Stripe?" dari codebase. Pertanyaan seputar seluruh repo. Arahkan ke Agent "Codebase Analyst" dengan model konteks panjang yang mampu menampung file-file relevan sekaligus.
Setiap Agent berjalan di worktree terisolasi miliknya sendiri, sehingga tiga model mengerjakan tiga tugas sekaligus tanpa saling mengganggu. Setiap hasil kembali ke Task-nya masing-masing dengan ringkasan perubahan dan bukti. Anda meninjau tiga hasil yang sudah selesai, bukan tiga terminal yang harus Anda rekonstruksi dari ingatan. Otomatisasi berhenti di titik yang membutuhkan penilaian Anda: Anda menerima, meminta perubahan, atau memutuskan merge.
Checklist yang bisa Anda jalankan hari ini
Jalankan ini sebelum batch pekerjaan agen Anda berikutnya.
- [ ] Untuk setiap tugas, tentukan dulu bentuknya: berat penalaran, berat konteks, berat loop tool, atau mekanis bervolume tinggi.
- [ ] Tetapkan model termurah yang memenuhi standar untuk bentuk tersebut. Simpan reasoner untuk tugas yang satu langkah salahnya benar-benar membuang waktu.
- [ ] Tempatkan pekerjaan konteks panjang pada model konteks panjang, bukan pada reasoner favorit Anda karena kebiasaan.
- [ ] Untuk loop multi-langkah, utamakan keandalan mengikuti tool di atas peringkat benchmark mentah.
- [ ] Tuliskan pemetaannya sekali sebagai Agent yang bisa dipakai ulang per peran, agar Anda dan rekan tim berhenti memutuskannya ulang di setiap terminal.
- [ ] Tetap libatkan manusia dalam penerimaan akhir. Model memilih jalannya; Anda yang menyetujui hasilnya.
Cocokkan model dengan tugas, simpan kecocokan itu sebagai Agent, dan pertanyaan yang membuka artikel ini ("yang mana yang harus saya pakai?") hanya perlu dijawab sekali per peran, bukan sekali per terminal.
Jika Anda ingin tetap memakai beberapa coding agent alih-alih berkomitmen pada satu model untuk semuanya, itulah masalah yang menjadi dasar Sharkly dibangun. Anda bisa memilih model secara manual di setiap terminal, atau mengelola seluruh alur kerja di satu tempat dan membiarkan setiap hasil kembali ke Task.
FAQ
Haruskah saya pakai model dengan peringkat tertinggi untuk semua hal? Tidak. Model umum teratas lebih lambat dan lebih mahal daripada yang diperlukan untuk pekerjaan mekanis, dan tidak lebih benar di sana. Peringkat memberi tahu Anda sebuah model berada di tingkat mana; bentuk tugas Anda memberi tahu tingkat mana yang Anda butuhkan. Mencocokkan keduanya lebih baik daripada langsung memilih pemenang papan peringkat.
Bagaimana cara memilih model kalau saya belum tahu tingkat kesulitan tugasnya? Mulai dari yang murah lalu tingkatkan. Berikan tugas itu dulu ke model cepat. Jika ia macet, menebak-nebak, atau gagal saat tinjauan, itulah sinyal bahwa tugasnya berat penalaran, dan Anda naikkan ke model yang lebih kuat. Langkah tinjauan human-in-the-loop adalah tempat Anda menangkap ketidakcocokan itu sebelum hasilnya dirilis.
Apakah Sharkly memilihkan model untuk saya? Sharkly tidak memilih model sendiri. Anda mengaitkan sebuah peran ke runtime beserta modelnya saat membangun Agent, lalu menetapkan Task ke Agent yang bentuknya sesuai dengan pekerjaannya. Pilihannya tetap milik Anda; Sharkly membuatnya bisa dipakai ulang dan menjaga hasil setiap eksekusi tetap melekat pada Task, bukan di terminal pribadi.


