
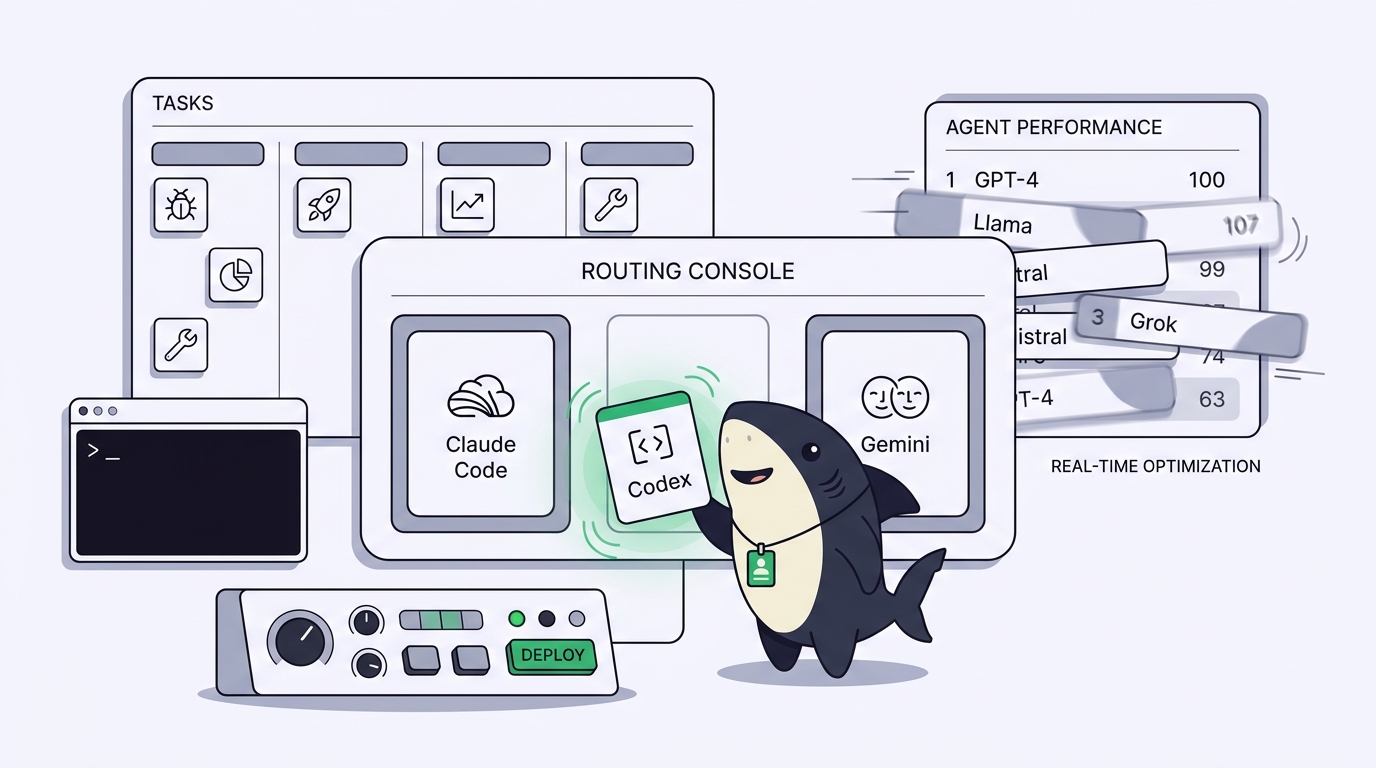
Anda sedang berusaha memilih agen coding terbaik. Anda membaca papan peringkat, menonton postingan rilis, menjalankan prompt yang sama lewat Claude Code, Codex, dan Gemini CLI untuk melihat mana yang terasa lebih tajam. Lalu sebuah model baru dirilis, peringkat berubah, dan agen yang Anda standarkan bulan lalu tiba-tiba berada di papan tengah. Jadi Anda beralih lagi.
Inilah bagian yang tidak nyaman: agen yang Anda pilih tidak mengubah minggu Anda sebanyak yang Anda kira. Yang menentukan seberapa banyak pekerjaan yang benar-benar selesai adalah apa yang terjadi di sekitar agen. Agen mana mengerjakan tugas mana, apa yang selesai, apa yang gagal, apa yang menunggu Anda tinjau. Sebagian besar developer merasakan tarikan papan peringkat dan tidak pernah menyadari bahwa papan peringkat memang bukan bottleneck-nya.
Sharkly dibangun di atas pengamatan itu. Sharkly adalah platform command dan manajemen Agent all-in-one: Anda menghubungkan Computer Anda sendiri, menetapkan Task ke Agent mana pun yang sudah Anda gunakan, dan setiap eksekusi mengembalikan diff, output pengujian, serta review-nya ke satu tempat. Sharkly berada di atas para agen, bukan di sampingnya. Artikel ini membahas mengapa lapisan manajemen lebih menentukan output Anda dibandingkan modelnya, dan apa yang harus dilakukan kuartal ini alih-alih mengejar papan peringkat berikutnya.
Agen terbaik adalah target yang terus bergerak
Papan peringkat agen coding mengukur sekumpulan masalah yang tetap dan sama pada satu titik waktu tertentu. Kedua fakta itu cepat basi. Kumpulan masalahnya bukan codebase Anda, dan momennya bukan bulan depan.
Lihatlah lajunya. Anthropic, OpenAI, dan Google masing-masing telah merilis beberapa pembaruan model yang mampu menjalankan agen coding sepanjang tahun lalu, dan peringkat relatif di antara mereka sudah berbalik lebih dari sekali [VERIFY: exact release cadence and current ranking change monthly; confirm before citing specifics]. Jika Anda menganggap “gunakan agen terbaik” sebagai sebuah keputusan, Anda bersiap untuk mengambil ulang keputusan itu setiap kali sebuah lab merilis model baru. Setiap peralihan membawa biaya: konfigurasi baru, file konteks baru, kebiasaan baru, dan serangkaian mode kegagalan baru yang harus dipelajari tim Anda.
Ini sebuah prediksi, dan saya beri label demikian. Kesenjangan antara agen coding teratas akan terus menyempit, bukan melebar. Ketika tiga agen sama-sama berhasil menuntaskan bug yang sama di repositori Anda, pertanyaannya berhenti menjadi “mana yang terbaik” dan berubah menjadi “mana yang saya beri tugas tertentu ini, dan bagaimana saya melihat hasilnya.” Pembeda utamanya bergeser dari model ke alur kerja. Pergeseran itu sudah terlihat dari cara tim membicarakan agen; cara ini akan menjadi default sebelum menjadi pengecualian.
Pertahanan terhadap target yang bergerak bukanlah bidikan yang lebih baik. Melainkan alur kerja yang tetap bertahan saat targetnya bergerak. Membandingkan agen di codebase Anda sendiri memberi tahu Anda mana yang layak dijalankan hari ini; cara itu tidak mengunci Anda pada jawaban tersebut besok.
Apa yang sebenarnya menentukan output Anda
Mari hitung ke mana waktu sebuah tugas habis. Agen menghasilkan diff dalam hitungan menit. Semua hal lainnya—menentukan agen mana yang mendapat tugas, menjaga perubahannya tetap terisolasi dari empat agen lain, mengetahui bahwa agen tersebut tersendat di langkah build, membaca apa yang dihasilkannya, menerima atau menolaknya—itulah bagian yang menghabiskan hari Anda. Tidak satu pun dari itu merupakan properti model.
Inilah masalah manajemen, dan ia muncul begitu Anda menjalankan lebih dari satu agen. Agen mana mengerjakan apa? Agen mana yang harus menerima tugas berikutnya? Apa yang selesai, apa yang gagal, apa yang perlu dilihat manusia? Bagaimana Anda mencegah tiga agen yang mengedit satu repositori menyentuh file yang sama? Semakin cakap setiap agen, semakin banyak agen yang Anda jalankan sekaligus, dan semakin tajam pertanyaan-pertanyaan ini.
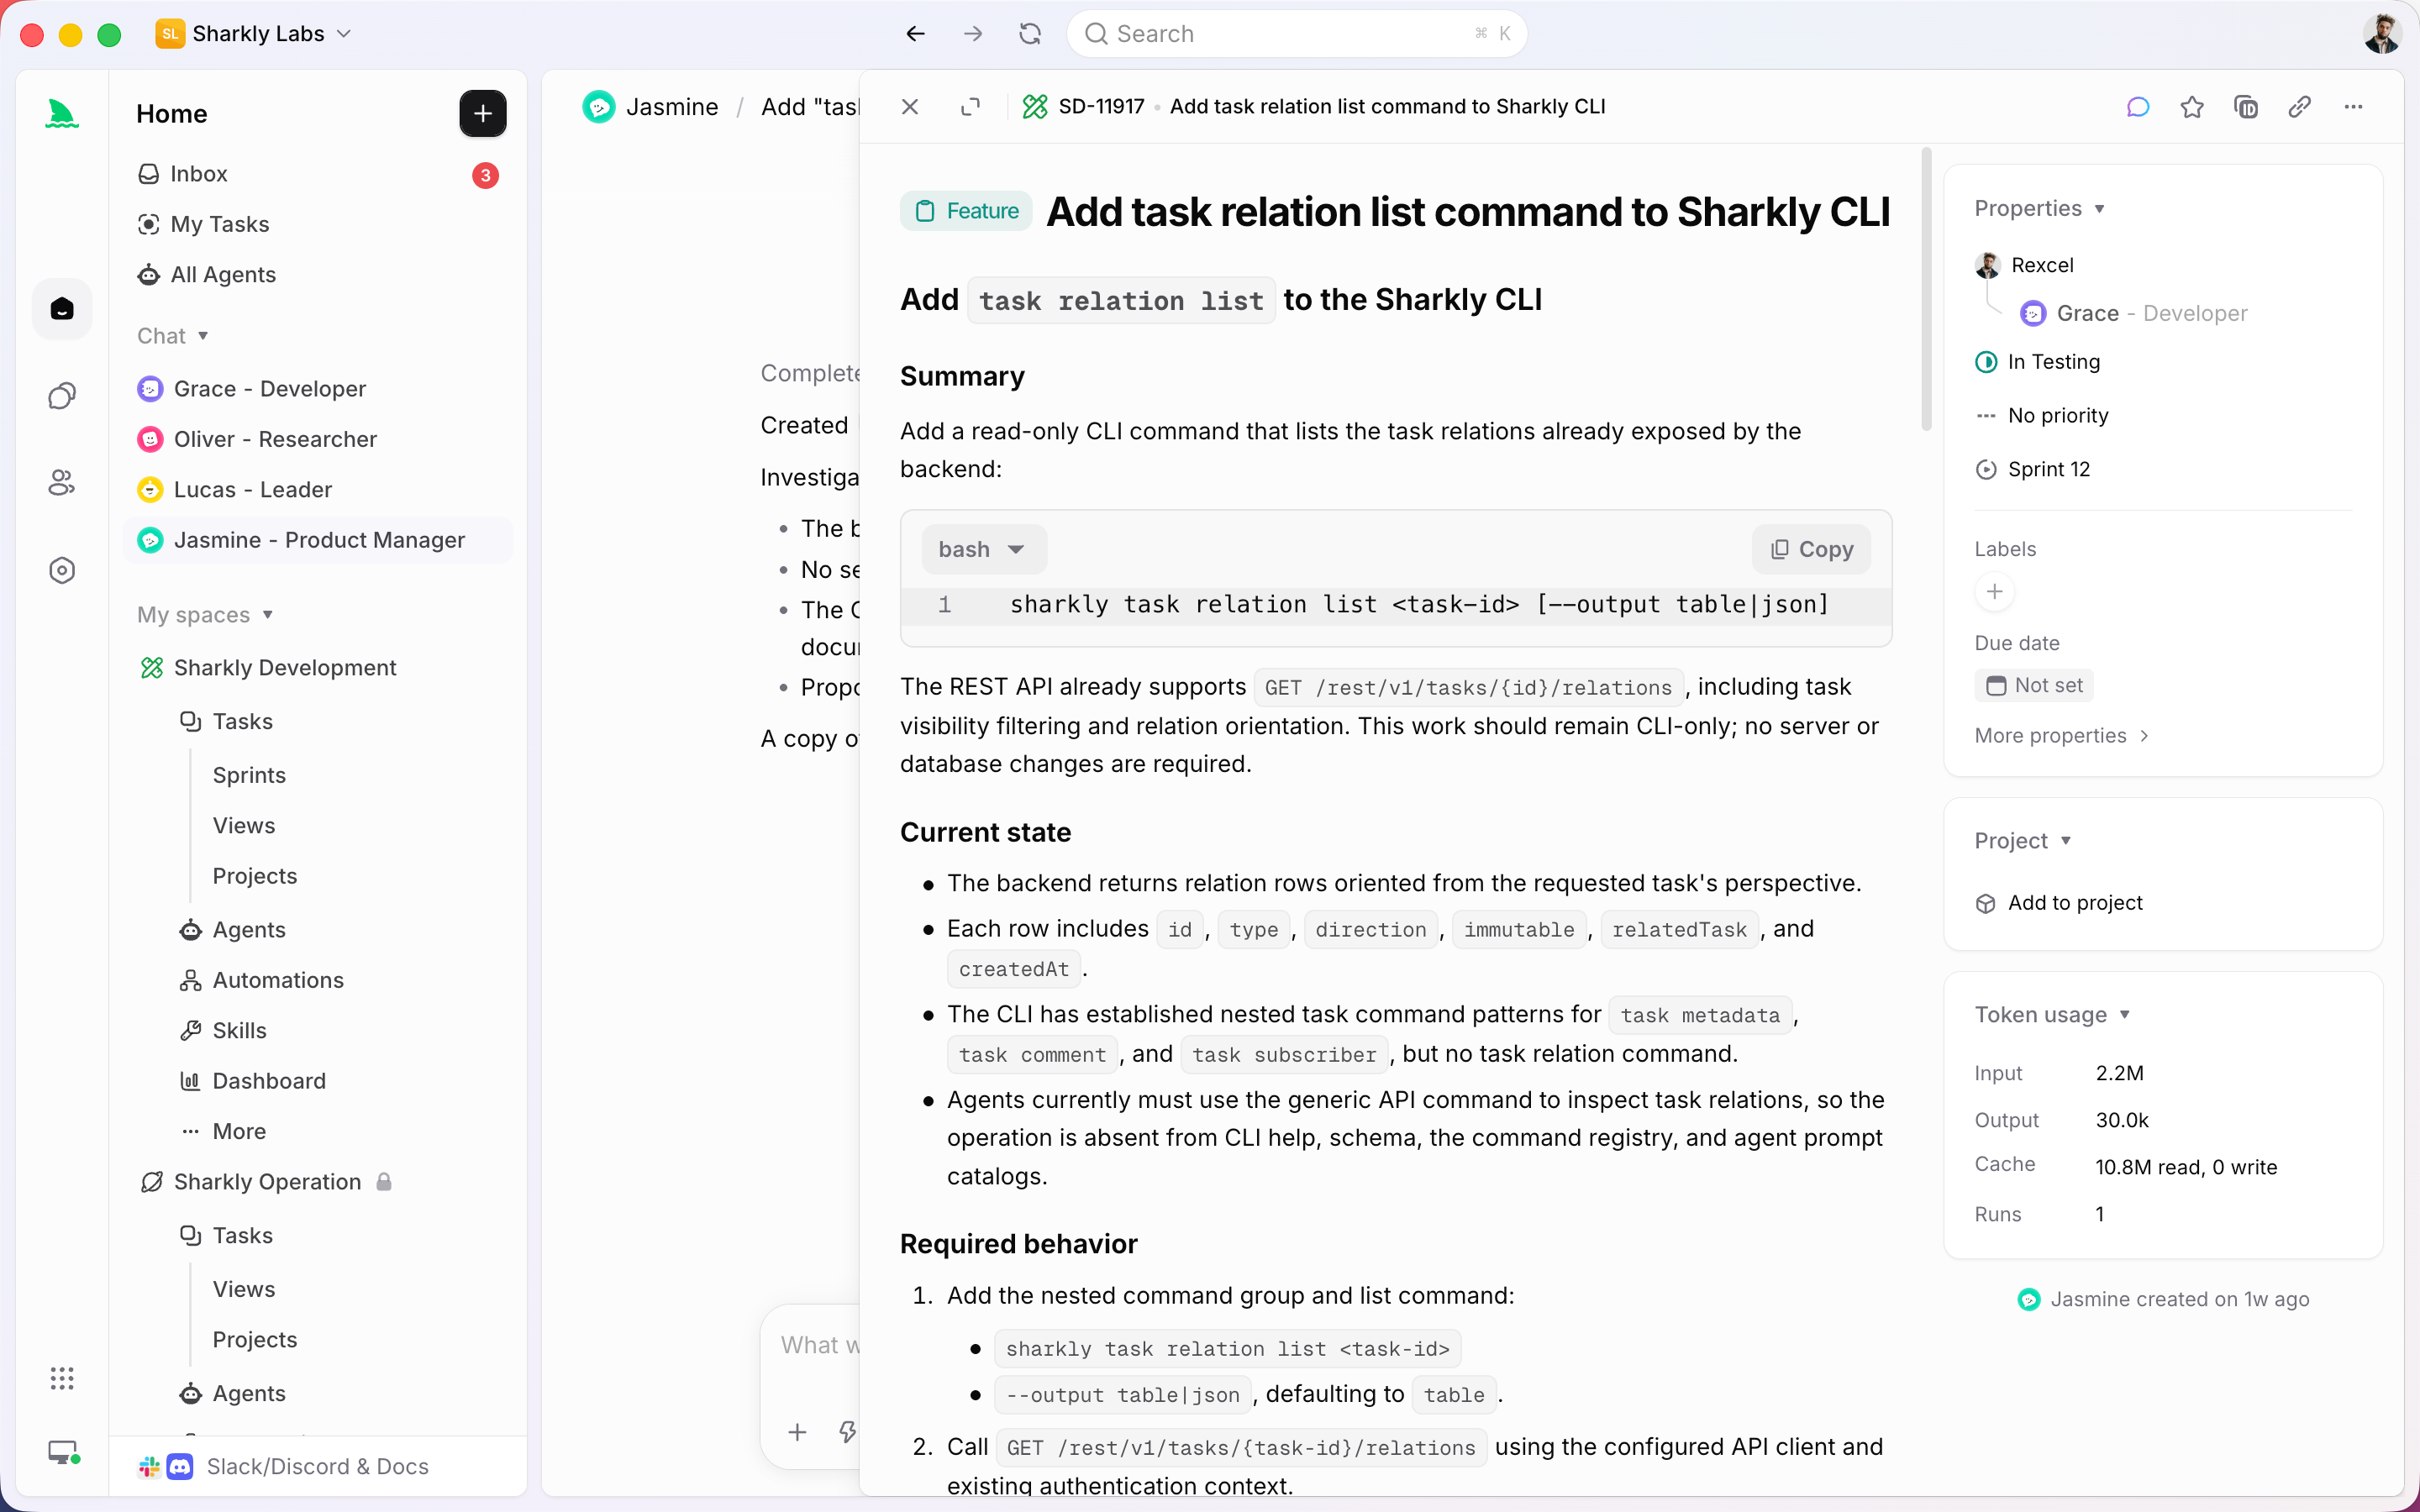
Sharkly menjawabnya sebagai sebuah lapisan, bukan alat. Task adalah unit kerja utama: Anda menetapkannya ke sebuah Agent, Agent tersebut berjalan di Computer yang terhubung dalam worktree yang terisolasi, dan eksekusi, penghambat, hasil, serta tindak lanjut semuanya kembali ke Task. Agen yang mengerjakan tugas hanyalah sebuah pengaturan pada Task, bukan arsitektur seluruh setup Anda. Ganti Claude Code dengan Codex pada tugas berikutnya dan tidak ada hal lain dalam proses Anda yang berubah. Itulah manfaat netralitas penyedia: alur kerja Anda bertahan lebih lama daripada agen mana pun yang sedang unggul saat ini.
Kapasitas review adalah batas atas yang sesungguhnya
Agen yang mencetak “done” belum menyelesaikan apa pun. Manusia tetap harus membaca diff, memeriksa pengujian, dan memutuskan. Langkah review itulah, bukan pembuatan kode, yang menjadi kendala pertama yang dihadapi hampir semua tim.
Hitungannya gamblang. Jika satu agen menghasilkan pekerjaan yang butuh sehari untuk di-review dalam dua puluh menit, lima agen menghasilkan lima hari review dalam dua puluh menit yang sama, sementara Anda tetap hanya punya sepasang mata. Agen yang lebih cepat atau lebih pintar justru memperburuk, bukan memperbaiki, karena ia mengisi antrean Anda lebih cepat. Memilih agen terbaik berarti mengoptimalkan langkah yang memang bukan bottleneck, sementara bottleneck sesungguhnya dibiarkan tanpa disentuh. Kapasitas review adalah batas nyata seberapa banyak pekerjaan agen paralel yang bisa diserap sebuah tim, dan tidak ada peningkatan model yang mengubah aritmetika itu.
Jadi pasangan keputusan yang penting bukanlah “Claude Code atau Codex.” Melainkan ini. Gunakan agen yang lebih cepat ketika kendala Anda adalah menghasilkan draf pertama sebuah perubahan. Investasikan pada alur kerja review Anda ketika kendala Anda adalah memutuskan apakah suatu perubahan sudah benar. Bagi sebagian besar tim yang menjalankan agen secara paralel, kendala kedua mengikat jauh sebelum yang pertama. Solusinya adalah membuat setiap eksekusi dapat di-review dengan bukti tingkat task: diff, output typecheck dan pengujian, ringkasan perubahan, serta batasan yang diakui agen, semuanya di satu tempat alih-alih berserakan di berbagai terminal.
Di sinilah kontrak manusia-agent membuktikan nilainya. Agen meneliti, mengeksekusi, menguji, dan melaporkan. Manusia menetapkan arah, memberikan wewenang, dan menerima hasilnya. Otomatisasi berhenti di titik yang memerlukan pertimbangan tim. Agen yang lebih baik melakukan lebih banyak dari kalimat pertama; dan tidak sama sekali dari kalimat kedua. Batas atasnya ada di sisi Anda dari garis itu.
Jadikan pilihan agen sebagai pengaturan, bukan arsitektur
Inilah batasannya, dinyatakan terang-terangan agar tidak ada yang salah paham: Sharkly bukanlah agen coding dan bukan pengganti Claude Code, Codex, atau runtime apa pun. Sharkly tidak menulis kode yang lebih baik daripada mereka. Sharkly menambahkan lapisan Task, Computer, konteks, dan review yang dibagikan di sekitar alat yang sudah tim Anda gunakan.
Perbedaan itulah intinya. Ketika pilihan agen hanyalah sebuah pengaturan, mencoba agen baru hanya menghabiskan satu tugas, bukan migrasi. Anda menghubungkan runtime-nya, menetapkannya pada kebutuhan nyata, dan membaca apa yang kembali, bersebelahan dengan hasil dari agen yang Anda pakai kemarin. Ketika pilihan agen sudah tertanam dalam arsitektur Anda, setiap eksperimen menjadi mahal dan setiap perubahan papan peringkat menjadi ancaman.
Bersikaplah jujur tentang kapan Anda tidak memerlukan ini. Jika Anda hanya memakai satu agen coding dan betah hidup di satu terminal, sesi Claude Code yang tertata baik di worktree-nya sendiri sudah cukup, dan lapisan manajemen hanyalah beban tambahan yang bisa Anda lewati. Persamaannya berubah begitu Anda menjalankan dua agen atau lebih, di lebih dari satu tugas atau repositori, dan Anda ingin hasilnya dalam bentuk yang bisa dibaca rekan tim tanpa Anda harus menceritakan isi scrollback Anda. Itulah ambang di mana manajemen agen coding menjadi lapisan yang benar-benar Anda butuhkan, bukan sekadar ide bagus.
Apa yang harus dilakukan secara berbeda kuartal ini
Berhenti menghabiskan sepekan untuk mengejar peringkat. Gunakan waktu itu untuk membangun lapisan yang membuat peringkat menjadi sekadar detail.
Tiga langkah konkret. Pertama, pilih agen Anda dengan cara yang membosankan: jalankan dua di antaranya pada tugas nyata dari backlog Anda dan simpan mana yang lebih enak dibaca pada kode Anda, dengan kesadaran bahwa Anda akan meninjau ulang keputusan itu. Kedua, ukur throughput review Anda secara jujur; jika agen selesai lebih cepat daripada kemampuan Anda menerima hasil kerjanya, peningkatan agen berikutnya tidak akan membantu, sedangkan alur review yang lebih baik akan membantu. Ketiga, berhenti mengunci satu agen ke dalam proses Anda. Alirkan pekerjaan melalui lapisan yang memperlakukan agen sebagai sesuatu yang bisa ditukar, sehingga rilis model berikutnya menjadi opsi yang Anda coba, bukan pembangunan ulang yang Anda takuti. Jika Anda masih menentukan model mana untuk tiap agen, mencocokkan model dengan peran agen adalah penggunaan waktu sore yang lebih baik daripada menyegarkan papan peringkat.
Jika Anda ingin terus memakai beberapa agen coding alih-alih berkomitmen pada satu ekosistem, itulah masalah yang dirancang untuk dipecahkan Sharkly. Unduh Sharkly, hubungkan satu Computer, dan tetapkan tugas nyata yang sama ke dua agen. Agen terbaiknya akan berubah. Cara Anda mengelolanya tidak harus ikut berubah.


