

Anda mengirim tiga run sebelum makan siang. Sembilan puluh detik kemudian, dua dari tiga terminal sama sekali belum mencetak apa pun. Salah satunya sedang menalar melalui repositori. Salah satunya kena 504 di tengah jalan dan tidak akan pernah kembali. Dari tempat Anda duduk, keduanya adalah persegi panjang scrollback yang sama dengan kursor di dalamnya.
Ini bukan masalah baru, tetapi peluncuran 2026-09-22 membuatnya lebih buruk dengan cara yang spesifik dan terukur. Pengaturan penalaran tertinggi pada model-model baru membeli akurasi dengan cara berpikir lama sebelum mengatakan apa pun. Artificial Analysis mencatat varian penalaran "max" dari GPT-6 Sol pada 102,15 detik untuk token pertama, dan GPT-6 Luna pada 124,23 detik. Itu adalah pengukuran pihak ketiga pada konfigurasi tertentu, bukan angka dari vendor, dan catatan itu penting, tetapi arahnya tidak diragukan lagi: keheningan di awal sebuah run kini cukup lama untuk tidak bisa dibedakan dari kegagalan.
TL;DR
Time to first token adalah jeda antara mengirim permintaan dan tibanya karakter pertama dari balasan, dan pada model penalaran dengan effort tinggi, jeda itulah tempat sebagian besar proses berpikir terjadi. Sebuah terminal tidak bisa memberi tahu Anda perbedaan antara run yang sedang berpikir, run yang menunggu manusia, dan run yang mati dua menit lalu, karena ketiganya tidak mencetak apa pun. Sebuah status bisa. Agen meneliti, mengeksekusi, menguji, dan melaporkan. Manusia menetapkan arah, memberikan wewenang, dan menerima hasilnya. Yang dibutuhkan kontrak itu agar berjalan adalah status run yang terlihat tanpa perlu ada orang yang mengawasinya: Sharkly menyimpan konteks, progres, penghambat, hasil, dan tinjauan manusia pada Task dari permintaan hingga rilis, sehingga pemikiran yang panjang dan run yang mati berhenti terlihat serupa.
Waktu tunggu makin lama, dan model murah bukan yang cepat
Berikut adalah hasil pengukuran pihak ketiga tentang dua model GPT-6 baru pada pengaturan penalaran maksimumnya.
| Model | ID API | Kecepatan output | Time to first token | Input / output per 1 jt token |
|---|---|---|---|---|
| GPT-6 Sol (max) | gpt-6-sol |
115,2 token/dtk | 102,15 dtk | $2 / $10 |
| GPT-6 Luna (max) | gpt-6-luna |
153,9 token/dtk | 124,23 dtk | $0,10 / $0,50 |
Baca dua kolom terakhir secara bersamaan. Luna berbiaya seperdua puluh Sol per token dan membuat Anda menunggu lebih lama sebelum ia berbicara. Biaya dan latensi adalah dua sumbu yang terpisah, dan intuisi bahwa model yang lebih murah adalah model yang lebih gesit jelas salah di sini.
Dua catatan jujur sebelum ada yang membangun dasbor berdasarkan angka-angka itu. Pertama, angka-angka itu berasal dari Artificial Analysis, bukan dari OpenAI, dan secara spesifik menggambarkan varian penalaran "max". Pengaturan effort yang lebih rendah adalah hal yang berbeda, dan angka Anda sendiri akan berubah mengikuti ukuran prompt, ketersediaan tool, dan ke mana trafik Anda diarahkan. Kedua, time to first token bukan pengukuran yang sama dengan kecepatan output. Anthropic mengatakan Claude Opus 5.5 menghasilkan output sekitar 30% lebih cepat daripada Opus 5, yang merupakan pernyataan tentang token setelah token pertama. Sebuah model bisa melakukan streaming dengan cepat namun tetap membuat Anda menatap layar kosong selama satu setengah menit.
Terminal yang sepi bukanlah sebuah status
Keheningan di terminal setidaknya punya empat penyebab, dan terminal menampilkan semuanya secara identik:
- Runtime sedang bekerja. Penalaran sedang berlangsung, belum ada output.
- Run sudah selesai sejak tadi dan sedang menunggu manusia menjawab pertanyaan.
- Permintaan gagal. Dokumentasi Sharkly blak-blakan soal betapa mudahnya hal ini salah dibaca: "Timeout / 408 / 504 berarti permintaan lambat, dibatalkan, atau tertunda oleh gateway. Itu tidak sama dengan Computer yang offline."
- Computer benar-benar sudah hilang, atau direktori yang dibutuhkan run tersebut memang tidak pernah tersedia.
Satu agen, satu terminal, dan Anda menyelesaikannya dengan menunggu satu menit lagi. Lima agen di tiga repositori dan dua Computer, dan Anda menyelesaikannya dengan berpindah-pindah tab antar jendela sambil menebak-nebak. Itulah bentuk biasa dari kekacauan agen: bukan kegagalan yang dramatis, hanya tim yang menghabiskan perhatiannya pada pertanyaan "apakah yang ini masih hidup?" beberapa kali dalam satu jam.
Refleks yang orang lakukan adalah mematikannya dan menjalankan ulang. Pada effort penalaran yang tinggi, refleks itu mahal dua kali lipat. Anda membayar seluruh penantian token pertama lagi, dan Anda membuang pemikiran yang hampir saja tiba.
Apa yang harus dipisahkan oleh sebuah status
Model Sharkly sendiri layak untuk ditiru, terlepas dari apakah Anda memakai Sharkly atau tidak, karena ia memisahkan dua hal yang disatukan oleh terminal. Ini adalah pemisahan yang sama yang membuat status run, log, dan sinyal kegagalan bisa terbaca sama sekali. Sebuah run memiliki execution state: Queued, Dispatched, Waiting for local directory, Running, Completed, Failed, atau Canceled. Sebuah Task memiliki lifecycle status, dan sebuah Agent memiliki working state di atasnya: Working, Waiting for human reply, Waiting for human review, atau Error. Dokumentasi menyatakan batasnya dengan gamblang: status run ini "tidak secara otomatis menyiratkan bahwa Task memiliki workflow status yang sama."
Pemisahan itulah jawaban lengkap atas pertanyaan macet-atau-sedang-berpikir.
| Apa yang ditampilkan terminal | Apa yang mungkin sebenarnya terjadi | Apa yang membedakannya | Siapa yang bertindak selanjutnya |
|---|---|---|---|
| Tidak ada apa-apa, sudah 100 dtk | Running, sebelum token pertama | Run state adalah Running, log punya timestamp dispatch | Tidak ada. Biarkan saja. |
| Tidak ada apa-apa, sudah 10 mnt | Waiting for human reply | Working state berubah, Task memunculkan item perhatian di Inbox | Assignee menjawab dalam konteks |
| Tidak ada apa-apa, selamanya | Failed | Run state adalah Failed, execution log membawa judul dan respons asli dari model-service | Assignee membaca log sebelum mencoba ulang |
| Tidak ada apa-apa, tidak pernah mulai | Queued atau Waiting for local directory | Run state, plus kumpulan direktori mana yang sibuk | Bebaskan direktori atau tambah kapasitas paralel |
Tidak satu pun dari keempat baris itu memerlukan orang yang mengawasi pada saat perubahannya terjadi. Itulah intinya. State-nya tercatat, dan pertanyaan "apakah ini sedang berpikir atau macet?" menjadi hal yang Anda cari, bukan hal yang Anda tunggui.
Timeout per-Task yang Anda set bulan Maret
Sebuah Agent di Sharkly membawa jumlah maksimum Task yang berjalan paralel dan timeout per-Task. Sebagian besar tim menetapkan timeout itu sekali, di awal, berdasarkan seberapa lama mereka bersedia menatap terminal. Jika angka itu dua menit dan sejak itu Anda memindahkan sebuah Agent ke pengaturan penalaran max, Anda telah mengonfigurasi kebijakan yang membatalkan run selama fase berpikir dan melaporkannya sebagai kegagalan.
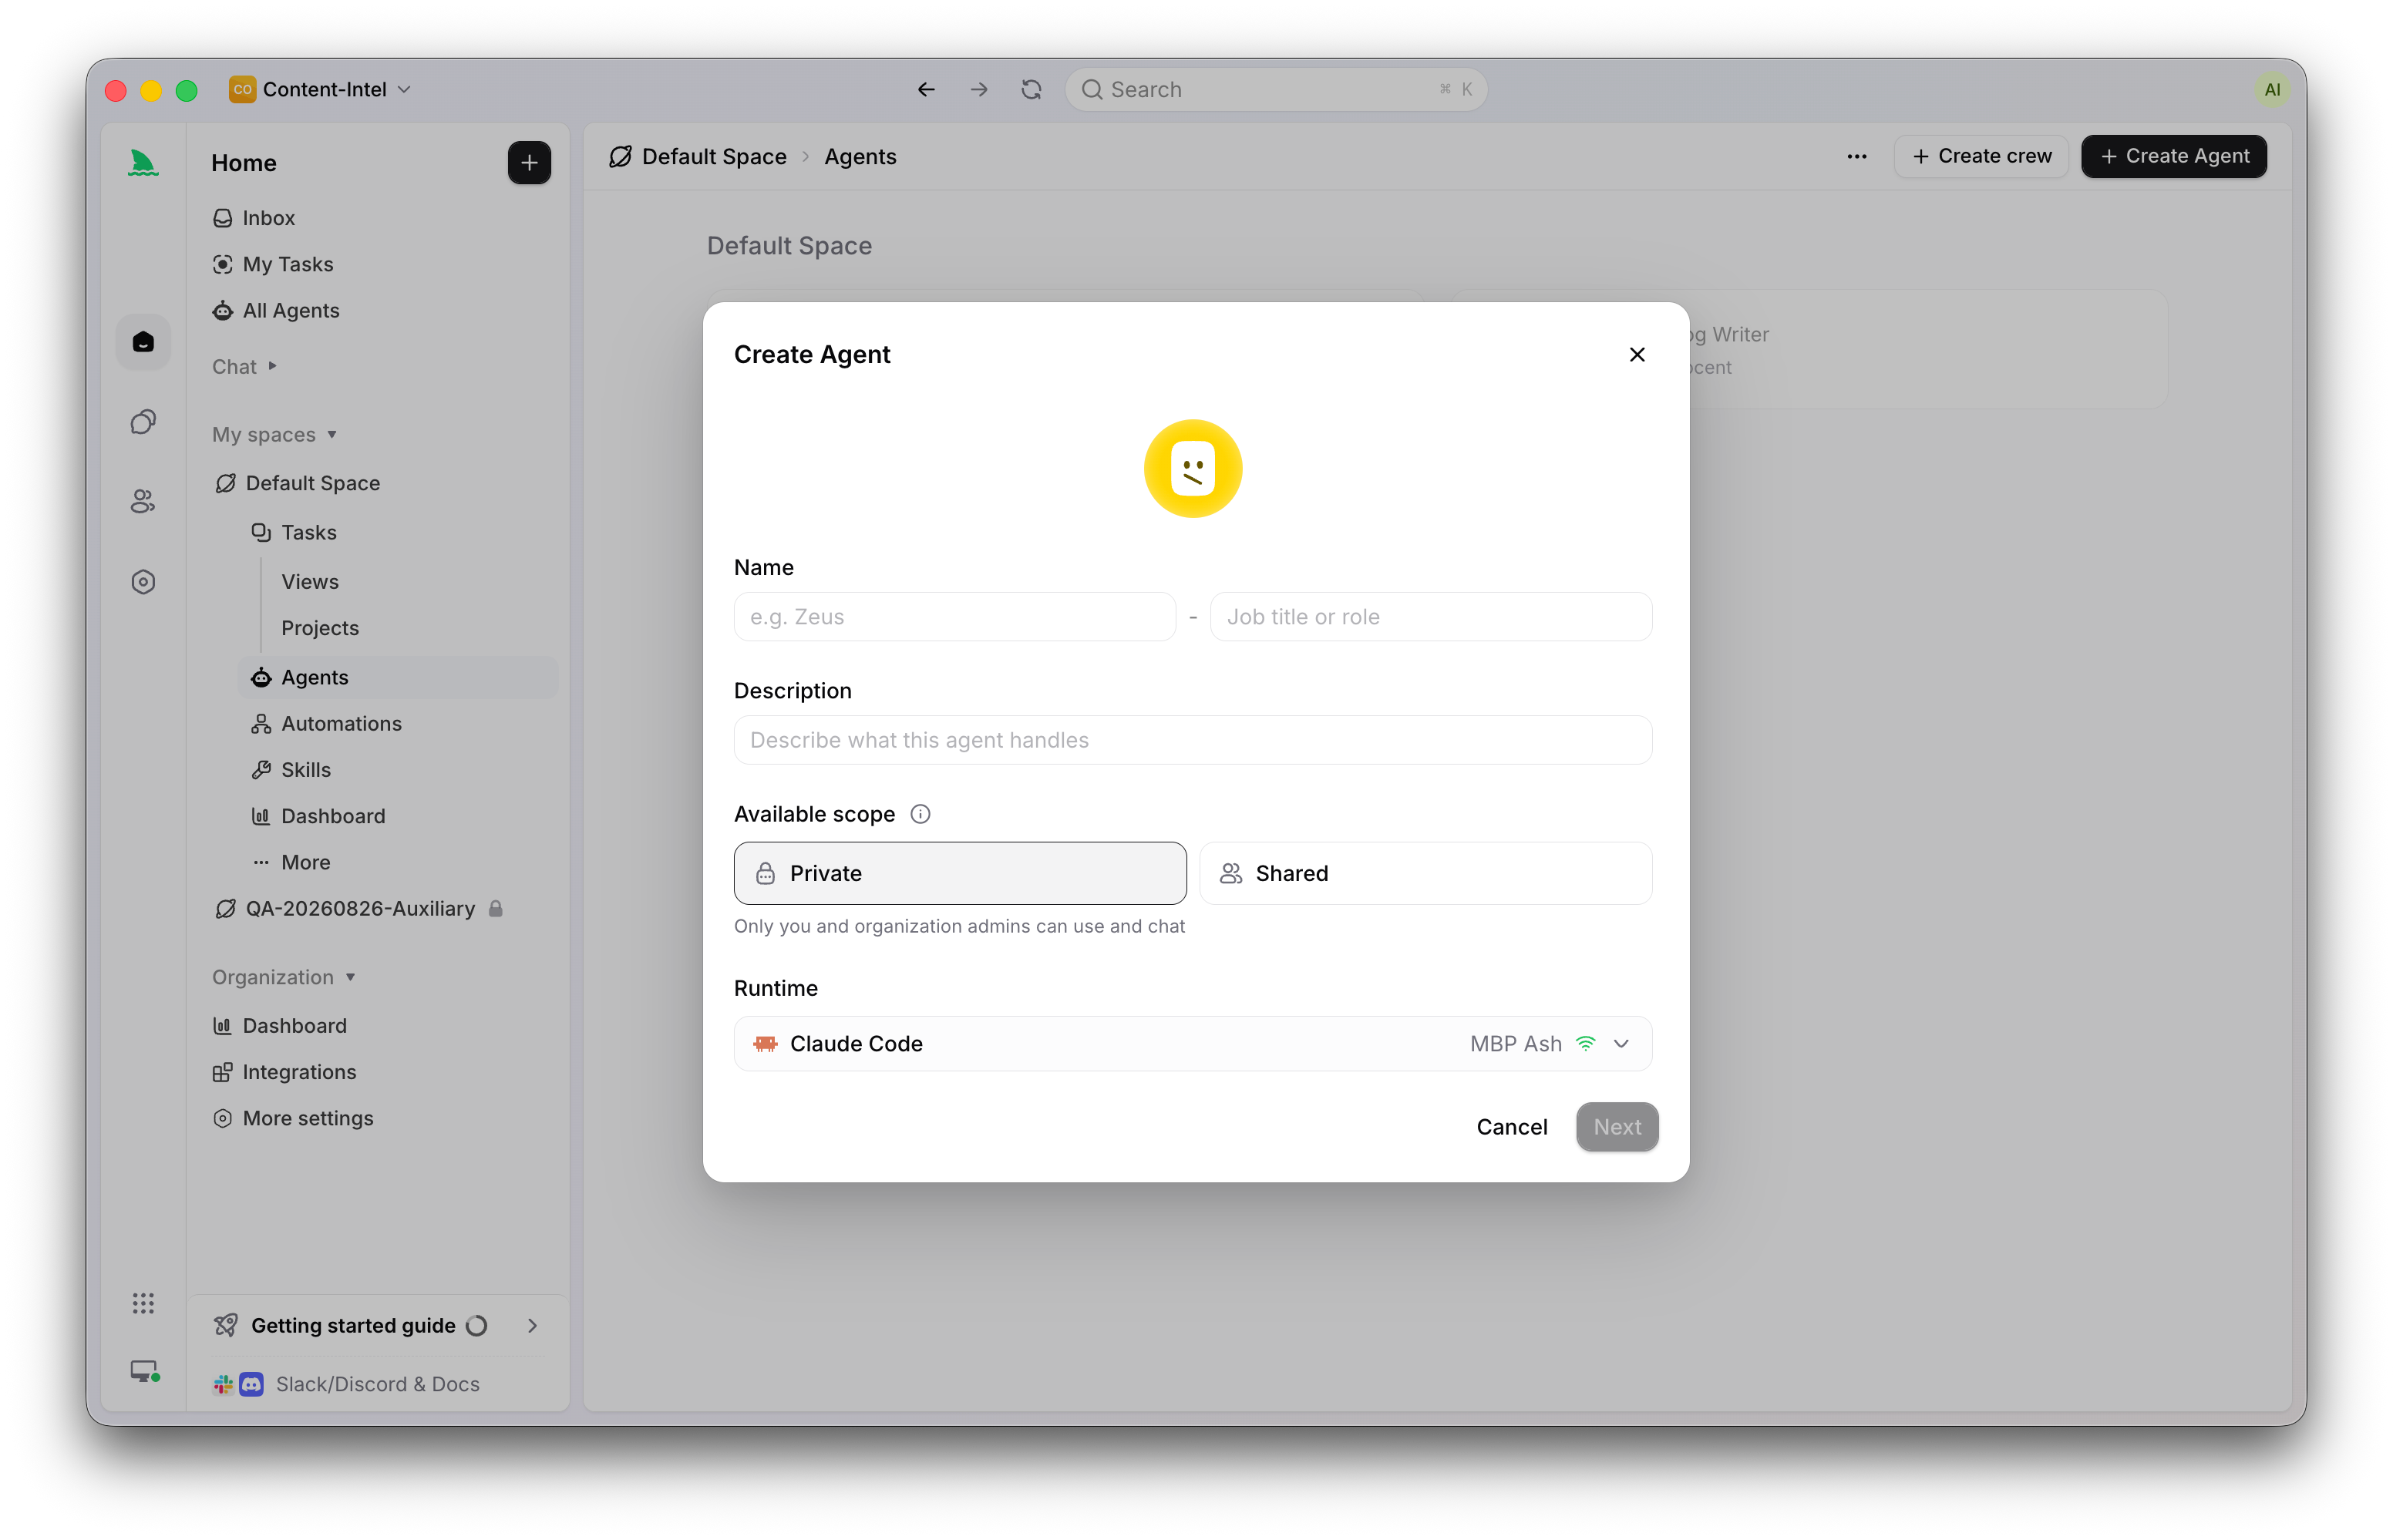
Coba periksa milik Anda minggu ini. Batas bawahnya bukanlah "berapa lama saya bersedia menunggu", melainkan "berapa lama Runtime ini memakan waktu pada level effort yang benar-benar saya pakai, ditambah pekerjaannya sendiri". Untuk run yang token pertamanya saja bisa memakan waktu lebih dari seratus detik, timeout di bawah lima menit adalah lemparan koin yang berkedok kebijakan.
Dua pengaturan terkait yang layak diperiksa sekaligus. Maximum parallel running Tasks adalah batas konkurensi Anda yang sesungguhnya, dan ketika semua direktori yang dikonfigurasi sibuk, run baru akan duduk di Waiting for local directory alih-alih gagal, yang merupakan perilaku benar yang tampak seperti hang jika Anda hanya mengawasi terminal.
Apakah caching mengatasinya?
Sebagian, dan bukan bagian yang Anda inginkan. Prompt caching OpenAI untuk GPT-6 memberikan diskon 90% untuk pembacaan input yang di-cache dengan hit rate yang lebih tinggi secara default, menambahkan breakpoint eksplisit sehingga Anda bisa memilih di mana sebuah prefix yang di-cache berakhir, dan tidak lagi mematahkan cache ketika Anda mengubah reasoning effort atau ketersediaan tool. GitHub melaporkan lebih dari 50% lebih sedikit token prompt yang memerlukan pemrosesan baru di miliaran permintaan. Itu adalah kemenangan biaya dan latensi yang nyata pada prompt, dan perbaikan untuk perubahan effort benar-benar berguna bagi agen yang meningkatkan sebuah task dari pengaturan murah ke pengaturan mahal di tengah alur.
Namun itu tidak menghilangkan proses penalarannya. Cache yang hangat berarti lebih sedikit dari prompt Anda yang diproses dari awal. Itu tidak berarti modelnya sudah memikirkan bug Anda. Tetap anggarkan waktu tunggunya.
Kapan menanggung waktu tunggu, dan kapan tidak
Gunakan pengaturan penalaran maksimum ketika tugasnya adalah sesuatu yang tidak ingin Anda jalankan dua kali: migrasi, refactor lintas bagian, apa pun yang jawaban salahnya lebih mahal daripada sembilan puluh detik. OpenAI melaporkan Sol pada pengaturan xhigh-nya mencetak 33,2% pada AutomationBench 1.0.6 dengan biaya $0,27 per task, yang merupakan bentuk dari pertukaran tersebut. Akurasi kini murah dari sisi uang dan mahal dari sisi waktu nyata.
Gunakan pengaturan effort yang lebih rendah ketika ada orang yang duduk menunggu jawabannya. Pekerjaan interaktif, pertanyaan cepat tentang sebuah file, perbaikan kecil yang terbatas ruang lingkupnya: masalah keheningan sebagian besar menghilang pada effort yang lebih rendah, karena token pertama muncul saat Anda masih ingat apa yang Anda tanyakan.
Dan batas yang jujur: jika Anda menjalankan satu agen untuk satu Task, Anda tidak perlu papan untuk hal ini. Cukup tail log-nya. Masalah state dimulai pada titik ketika jumlah run melebihi jumlah terminal yang bisa Anda awasi secara bermakna, yang bagi sebagian besar orang adalah sekitar tiga.
Apa yang tidak diperbaiki oleh ini
Sebuah status memberi tahu Anda bahwa sebuah run sedang Working. Ia tidak memberi tahu Anda bahwa run itu sedang melakukan sesuatu yang berguna, dan agen yang salah dengan penuh keyakinan menunjukkan state hijau yang sama dengan agen yang baik selama run tersebut berlangsung, yang pada Opus 5.5 bisa mencapai 18 jam atau lebih. Membedakan "berjalan" dari "berjalan dengan baik" tetaplah masalah tinjauan, dan tinjauan tetap menjadi pekerjaan manusia. Otomasi berhenti di titik di mana penilaian tim dibutuhkan.
Jika Anda sudah menjalankan beberapa agen sekaligus, perubahan terkecil yang berguna minggu ini bukanlah model baru. Melainkan membuat state setiap run bisa dibaca tanpa membuka terminal, sehingga sembilan puluh detik keheningan berikutnya menjadi informasi alih-alih pertanyaan.

