Claude Fable 5.2を評価する際は、明確な受け入れ基準、同一の環境、そして現在すでに利用しているベースラインを用意し、リポジトリの実情に即した代表的なタスクで検証することが不可欠です。受け入れられた変更、レビュー工数、所要時間、総コストを総合的に測定してください。試行を複数回繰り返し、失敗したケースも破棄せずに記録したうえで、単一のベンチマークスコアではなくタスクのカテゴリごとに導入可否を判断しましょう。
Anthropicは2026年11月9日にFable 5.2を発表しました。その公式発表では、コーディングおよび推論能力の向上が報告されています。しかし、これらはベンダー側による評価と実験結果の主張にすぎません。実際のプロジェクトにおける依存関係、コーディング規約、リリース要件に対して、このモデルがどの程度機能するかを証明するものではありません。
評価においては、より踏み込んだ問いに答える必要があります。「許容可能なレビュー負荷で任せられる業務はどれか?」という点です。すでに複数のコーディングエージェントを併用している場合、Sharklyを使えばタスクとレビューコンテキストを一元的に管理できます。
本ガイドでは検証のための実験手順を提案しています。特定の測定・比較結果を提示するものではありません。
代表的なタスクセットを構築する
リポジトリでの評価とは、実際の開発現場で生じる要件に基づき、コーディングワークフローを厳密に比較するプロセスです。成否の判定基準は、テストやレビューを経て「変更が実際に受け入れられたかどうか」です。一見それらしく見えるパッチ、テストコマンドの成功、自信に満ちた完了メッセージだけでは、受け入れられたことにはなりません。
まずは、直近のメンテナンス作業から選んだ12件のタスクから始めるとよいでしょう。この件数はパイロット運用として推奨する規模であり、統計的な保証を与えるものではありません。バグ修正、小規模な機能追加、リファクタリング、原因調査などのタスクを、普段のバックログに近い比率で含めてください。
開始地点となるコミットが明確で、期待される動作を理解しているレビュアーが存在するタスクを選定します。答えが自明な課題ばかりを選ぶのは避けてください。正しい対応として質問を投げかけたり、不足している依存関係を指摘したりすることが求められるタスクも、少なくとも1件は含めるようにしましょう。
過去の課題を利用する場合は、提供するコンテキストから解決策のコードを削除してください。また、修正内容がすでに公開されていたかどうかも記録しておきます(モデルが学習データとして遭遇している可能性があるためです)。後で確認テストを行うために、未公開のタスクも別枠で用意しておきましょう。
試行を開始する前に、必ず受け入れ基準を文書化してください。例えばAPIのページネーションの修正であれば、結果が空の場合、ページ境界の処理、無効なカーソル、既存クライアントとの後方互換性などを明記します。変更を許可するスコープや、承認に必要なチェック項目も含めておきましょう。
| カテゴリ | タスク例 | 受け入れの証拠 |
|---|---|---|
| バグ修正 | カーソル境界処理の修正 | リグレッションテストおよび既存テストスイートのパス |
| 小規模な機能追加 | 任意のクエリフィルタリング機能の追加 | デプロイ契約テスト(Contract Test)のパスとデフォルト値のドキュメント化 |
| リファクタリング | 重複したバリデーションロジックの共通化 | 公開仕様の動作維持とコードレビューの承認 |
| 原因調査 | 断続的なタイムアウトの診断 | 再現手順の提示と裏付けのある原因説明 |
明確な比較を行いたい場合は小さなタスクを用います。複数のタスクやツールの連携・協調性まで評価対象とする場合は大きめのタスクを選び、その実験結果は切り離してスコアリングしてください。
エージェント実行前に検証条件を固定する
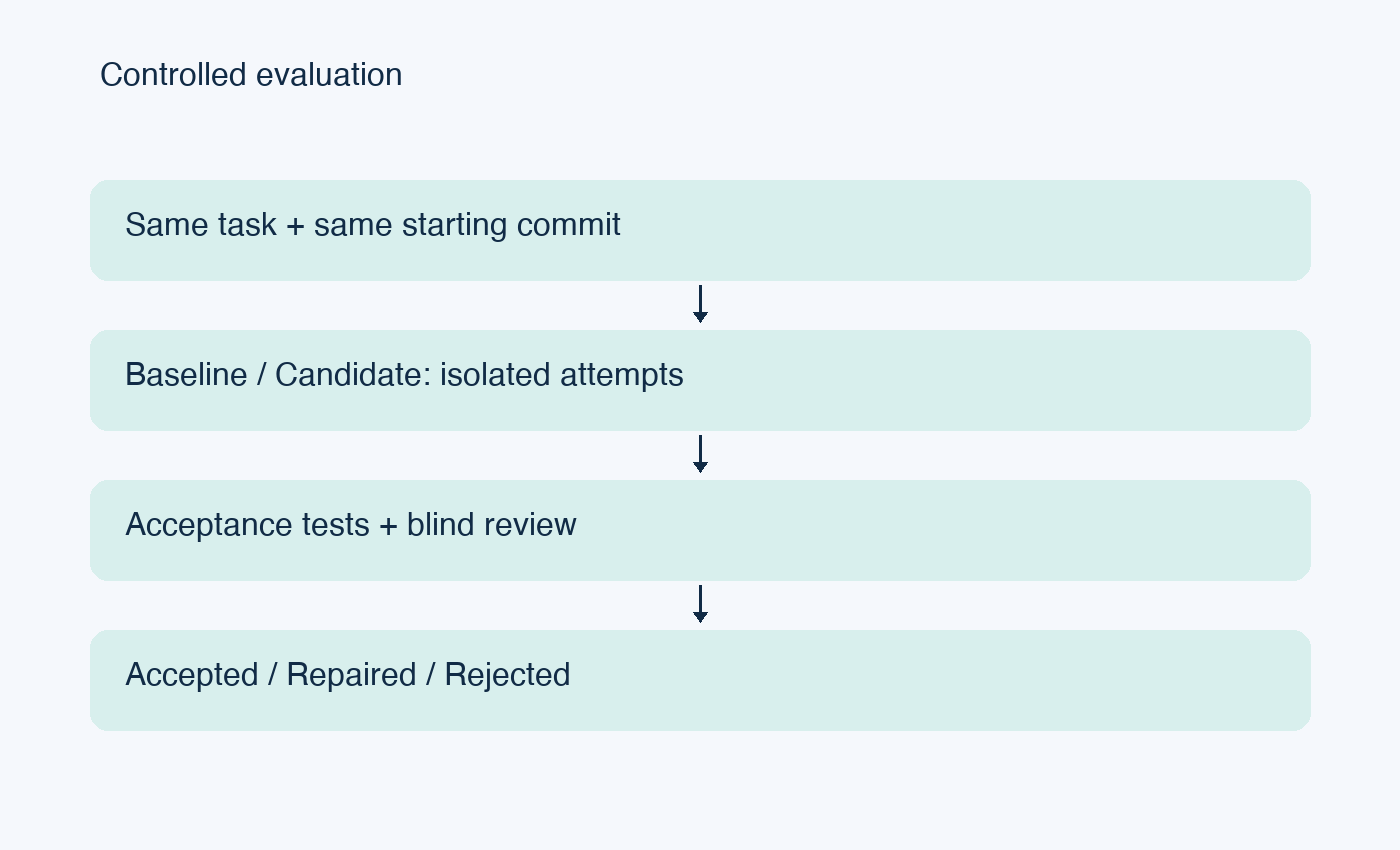
リポジトリのコミット、OS、依存関係のロックファイル、ツールのバージョン、モデル識別子、および設定を記録します。エージェントハーネス(モデル周辺でツール、コンテキスト、実行環境の挙動を提供するソフトウェア基盤)のバージョンも固定してください。
Fable 5.2を現在のワークフローと比較します。純粋なモデル比較を行う場合は、対応している限り同一のハーネスを使用する必要があります。ワークフロー全体の比較であれば異なるツールを用いても構いませんが、その結論には使用した構成の全体像を明記しなければなりません。
権限、ネットワークアクセス、初期コンテキスト、制限時間は同等に保ちます。依存関係のインストール時間を経過時間に含めるかどうかも定義しておきましょう。ある試行で編集されたファイル、正解を含むキャッシュ、会話履歴などが別の構成の試行に引き継がれないように徹底してください。
試行ごとにクリーンなチェックアウト環境または分離されたworktreeを使用します。複数作業ツリーで単一リポジトリを共有する方法については、Gitのworktreeドキュメントを参照してください。なお、ファイルの分離だけではデータベース、ポート、外部サービスは分離されません。これらにも個別のテスト環境を割り当ててください。
人間の介入ルールを明確に定めておきましょう。例えば「すべての構成で参照可能な情報のみを用いた1回限りの確認・明確化応答を認める」といった形です。介入に費やした時間はすべて記録してください。レビュアーが裏で密かに実装を手直ししてしまうと、検証で測定しようとしている前提が崩れてしまいます。
ペアでの試行を実施し、失敗ログも保持する
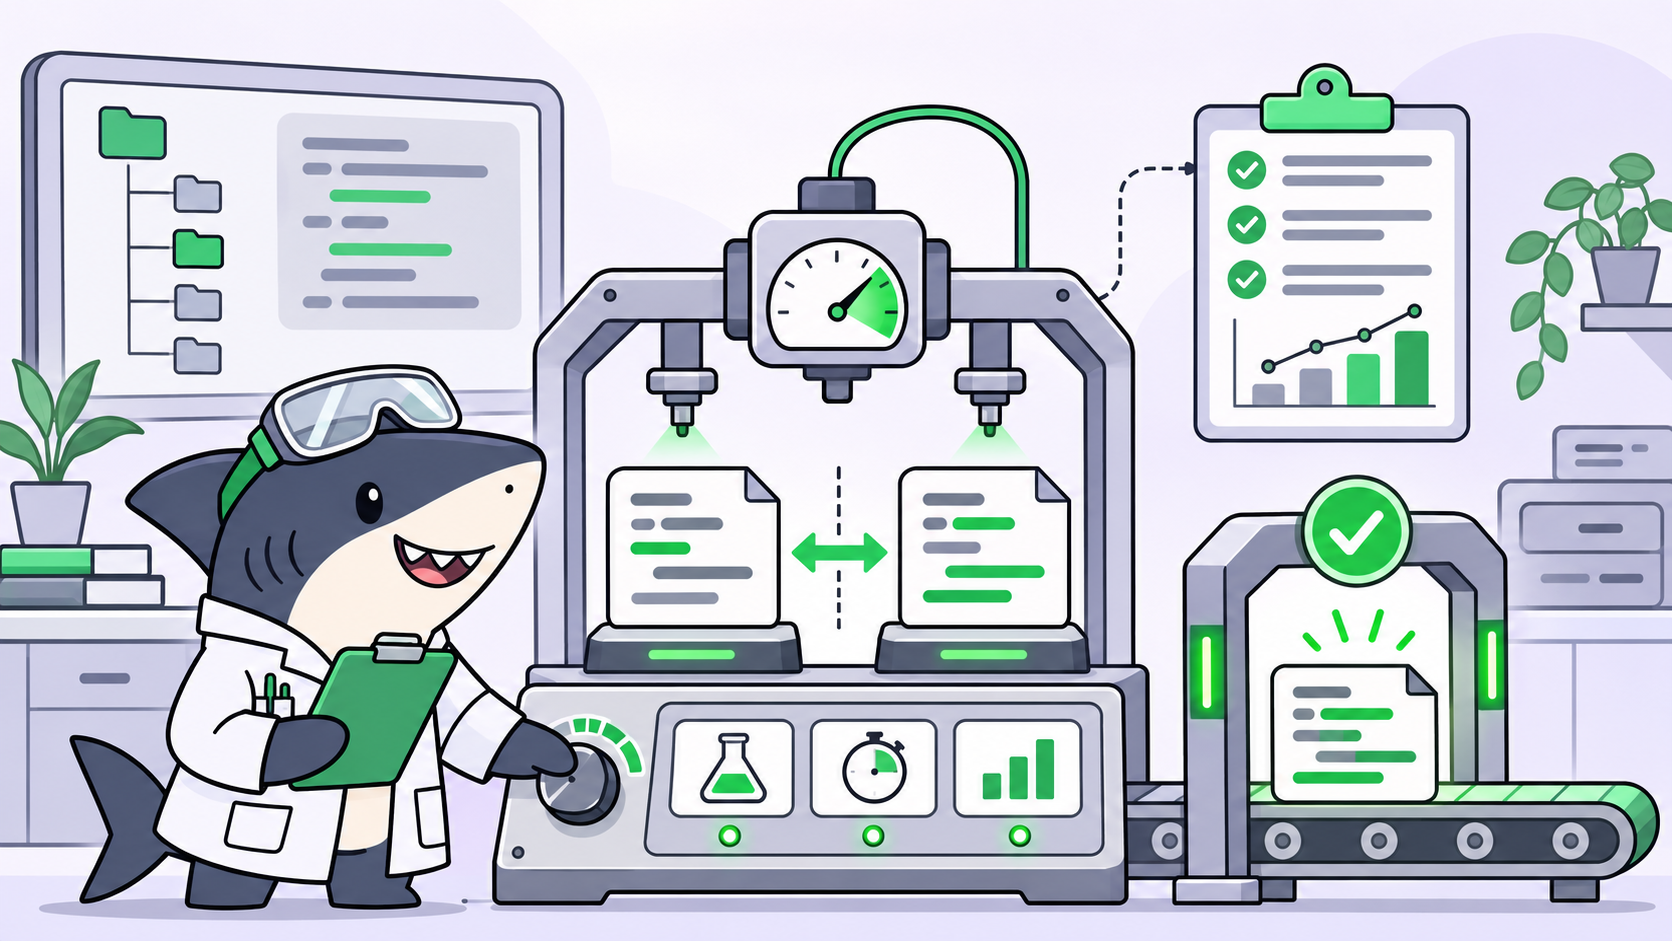
各構成を同じタスクに対して実行します。一時的な外部サービスの遅延が特定の候補に有利・不利に働かないよう、実行順序は交互に入れ替えてください。リソースが許す限り試行を繰り返しますが、その繰り返し回数は結果を見る前にあらかじめ決めておきます。
実践的なパイロット運用としては、タスクごとに各構成3回の試行を行うのが現実的な目安です。これをエンジニアリングの出発点と捉えてください。サンプル数が少ない段階では、稀にしか起きない障害の傾向や、全面的な優位性について精緻な主張を展開することはできません。
すべての試行について、プロンプト、設定、タイムスタンプ、トランスクリプト(対話ログ)、パッチ、ツール出力、最終判定を保存してください。タイムアウトや途中で中断された実行も一つの結果として記録します。これらを除外してしまうと、実際の運用環境でデプロイした場合よりも安価で高速であるかのように見誤ってしまいます。
テスト用のフィクスチャや認証情報は、本番環境から完全に切り離してください。リポジトリに既存のテスト手順をそのまま適用しましょう。Pythonリポジトリの場合、pytestのドキュメントにフィクスチャとテスト実行に関する解説があります。ただし、定義した受け入れ基準が要件を十分に網羅しているかどうかまでは、テストフレームワーク自体は判断してくれません。
速度よりも先に正当性をレビューする
可能であれば、レビュアーにはどのモデルが生成したパッチかを知らせずに(ブラインドで)検査してもらいます。要件の充足度、リグレッションのリスク、保守性、テストの品質、不要な変更が含まれていないかなどを網羅した共通の評価基準(ルーブリック)を用いましょう。
タスクがテストを要求している場合、テストをパスすることは必須条件ですが、テスト自体が誤った挙動を許容するように書かれている可能性もあります。アサーションが元の要件と整合しているかを慎重に確認してください。チェックの無効化、許容誤差の意図しない緩和、エラーのもみ消し、失敗する処理ルートを迂回するような変更がないか警戒が必要です。
結果は「そのまま受け入れ」「手直し後に受け入れ」「却下」の3つに明確に分類します。修正に要した分数と、修正内容の内訳も記録してください。手直しを伴う変更をメインの「受け入れ率」にカウントするかどうかは、あらかじめ決めておきます。
調査タスクについては、論拠の整合性を評価します。有用な調査レポートとは、事実の観察を提示し、仮説を論理的に切り分け、再現可能な次のステップを示しているものです。裏付けのない自信満々な診断を評価してはいけません。
受け入れ変更あたりのコストを算出する
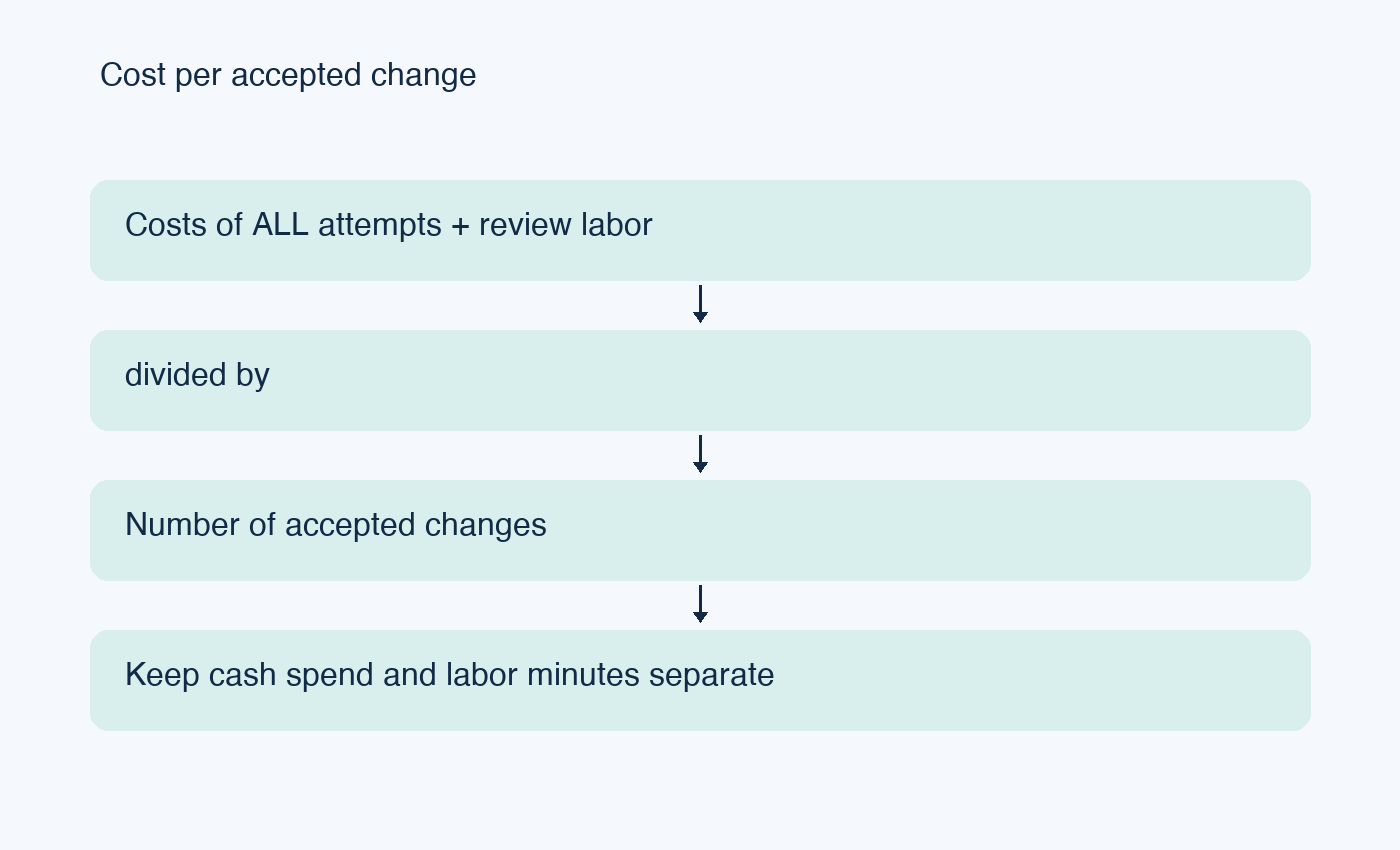
「受け入れ変更あたりのコスト」は、事前に定義した基準に照らして受け入れられた変更数で、評価にかかった総コストを割ることで算出します。分子には失敗した試行の費用も含めてください。変更が1件も受け入れられなかった場合は、発生したコストと受け入れ数ゼロをそのまま報告します(この場合、比率は有限な値になりません)。
以下の指標をセットで追跡してください:
- タスクカテゴリごとの受け入れ率
- タスク開始からレビュー可能な状態になるまでの実時間(経過時間)
- 人間のレビューおよび手直しにかかった時間(分)
- すべての試行で発生したモデルおよびツールの利用料金
- 関連するインフラ費用(金額が大きい場合)
- 観測期間中に検出されたリグレッション
請求額だけでなく、トークン消費量と参照した価格情報の取得日も併記して記録します。キャッシュされたトークン、リトライ、実行ツールの呼び出しによってコストは大きく変動します。出力の長さだけで費用を見積もることは避けてください。
レビュアーの時間に金銭的な単価を割り当てる場合は、それが社内固有の前提数値であることを明記します。他の人が比較計算をやり直せるよう、金銭的支出と作業工数(分)は分けて提示してください。モデルの生成コストが安くても、エンジニアの対応時間が余計にかかるケースは多々あります。
評価の証跡をタスクと紐付けて保持する
Sharklyは、コーディングエージェントを取り巻く作業プロセスを管理するプラットフォームです。タスク、エージェント、コンピューティング環境、実行コンテキスト、人間のレビューを公式ワークフローに従って一元管理できます。最新の用語定義やセットアップ手順については、Sharklyのドキュメントを確認してください。
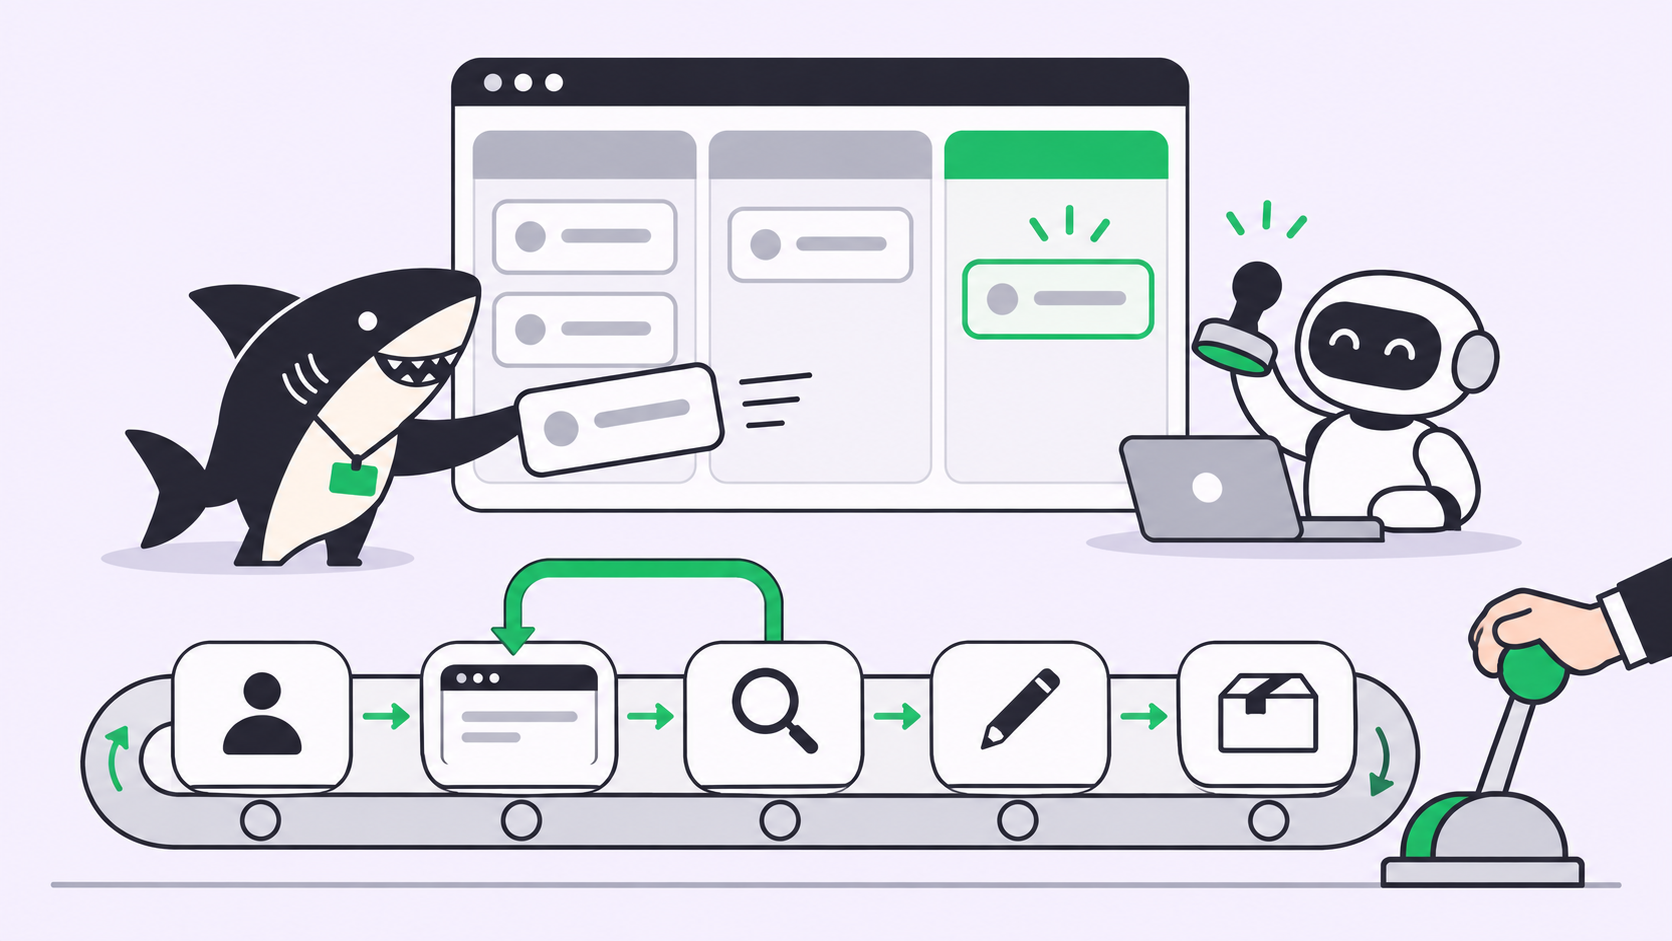
この検証実験では、各タスク(Task)に受け入れ基準を記載し、パッチ、テスト証跡、判定結果を同じ作業レコードに集約します。分析のしやすさを優先するなら、評価台帳をスプレッドシートやバージョン管理されたデータファイルで管理しても構いません。プラットフォーム側が実験用の評価指標をすべて自動計算してくれるとは考えないようにしましょう。
単一の試行には単一のエージェント(Agent)を使用します。チーム連携(Crew)を導入するのは、エージェント間の協調そのものが評価目的である場合だけにしてください。途中で体制を変更すると、評価に別の変数が紛れ込んでしまいます。
エージェントはコードを実行して証跡を報告する役割を担います。人間は受け入れ基準を定義し、変更内容を精査し、リリースを承認します。コードが自動チェックをすべて通過した場合であっても、この役割分担は依然として極めて重要です。
カテゴリごとに導入の可否を判断する
導入基準は結果を見る前に定めておきます。まず許容できる正確性を最優先とし、その基準をクリアした構成同士でコストと所要時間を比較します。セキュリティへの影響が大きい領域や、テストカバレッジが不十分なカテゴリは、初期ロールアウトの対象から外しておきましょう。
パーセンテージだけでなく、具体的な件数も併記してください。「3件中2件成功」と「300件中200件成功」では、同じ成功率でも意味合いがまったく異なります。「絶対的な勝者」を安易に宣言するのではなく、結果の不確実性や失敗のパターンを丁寧に読み解くことが大切です。
プロンプト、ハーネス、モデルのバージョン、あるいはリポジトリ構成に大きな変更を加えた際には、必ず評価を再実施してください。後から改善度合いを検証できるよう、過去の構成も再現可能なベースラインとして保存しておきましょう。
まずはSharklyで代表的なメンテナンスタスクを1つ選び、明確な受け入れ基準を設定して、得られた成果物を既存のワークフローと比較してみてください。成功と失敗の両方の要因をしっかり説明できるようになってから、徐々に検証の対象を広げていきましょう。
よくある質問(FAQ)
公開されているコーディングベンチマークでこの評価を代替できますか?
候補モデルを絞り込むための参考にはなります。しかし、自社リポジトリ固有のコーディング規約、依存関係、レビュー基準、運用上の制約まではカバーできません。
すべての試行でまったく同じプロンプトを使用すべきですか?
タスク情報の前提を揃え、事前に定めたプロンプティング方針に従う必要があります。ツール固有のラッパー(追加指示など)も記録に残し、差異をあとから検証できるようにしてください。
手直しを加えたパッチは成功としてカウントしますか?
あらかじめ判定ルールを決めておいてください。手直しなしの受け入れと手直し後の受け入れは分けて報告し、ワークフローの比較には修正にかかった時間も含めるようにします。
タイムアウトはどのように採点すべきですか?
設定した制限時間内での「失敗」として記録します。発生したコストや経過時間も結果に計上してください。
チームへの展開(ロールアウト)を拡大する適切なタイミングはいつですか?
複数回の試行を通じて特定のタスクカテゴリが受け入れ基準を満たし、かつレビュアーがそのカテゴリで起きやすい典型的な失敗パターンを把握・理解できたタイミングで展開を広げてください。
参考リソース
リポジトリ環境の分離についてはGitドキュメント、統制されたテスト環境の構築についてはpytestフィクスチャガイド、そしてエージェントの作業管理と人間によるレビューの運用についてはSharklyを参照してください。