
Codex のタスクを1つ走らせていて、任せたいバグ修正があり、カバレッジが必要なテストスイートがあり、ずっと後回しにしているリファクタリングがある。この4つは互いに独立している。同時に走らせられない理由はない——ただし実務上の理由を除けば。2つの Codex セッションを同じチェックアウトに向ければ、互いの編集を上書きし始める。あなたが望んだ並列性は、望んでいなかったマージへと変わってしまう。
複数の Codex タスクを同時に走らせるのは、スイッチを入れる機能というより、自分で組み立てるセットアップだ。方法は3つある。Codex のクラウドタスク、複数のローカル CLI セッション、そして1つのセッション内のサブエージェントだ。どれも本物の並行性をもたらすが、どれにも書き込みが重なった瞬間に表面化する失敗モードが1つある。本ガイドでは3つすべてを、各ステップのコマンドと想定される失敗を明示しながら順に解説し、最後にタスクボードが引き継ぐ領域を紹介する。
そのタスクボードが Sharkly だ。あなたはすでに Codex を持っている。Sharkly はその上位に位置する。Codex を Runtime として実行し、並列実行のそれぞれを、専用の分離されたチェックアウト、専用のログ、専用のレビュアーを持つ Task に変える。本記事ではまず手動セットアップを扱う。自動化する前に、自分が何を自動化しようとしているのかを理解すべきだからだ。
TL;DR
Codex の並列エージェントとは、一度に1つではなく複数の Codex タスクを同時に実行することだ。方法は3つある。Codex クラウドタスク(OpenAI のドキュメントによれば、それぞれが分離された環境で実行される)、複数のローカル codex CLI セッション、あるいは1つのセッション内のサブエージェントだ。これらすべてを支配するルールは「作業単位ごとに1つのワーキングコピー」である。各タスクに専用の git worktree を与えれば、同時編集が同じファイルに触れることはない。数個のタスクまでならこれで十分スケールする。それを超えると、どのエージェントが何をしたかの追跡と、各結果を個別にレビューすることがボトルネックになる。それが Sharkly の加えるレイヤーだ。
Codex を並列実行する3つの方法
どの方法を選ぶかは、どれが最も強力に聞こえるかではなく、作業がどこで実行され、どれだけ見える必要があるかで決める。
| 方法 | 実行の仕組み | 分離 | 向いている用途 |
|---|---|---|---|
| Codex クラウドタスク | 各タスクが専用のクラウド環境で実行される | 強固、タスク単位 | 後からレビューする、委任された自己完結型タスク |
| 複数の CLI セッション | マシン上で複数の codex プロセスを実行 |
デフォルトではなし。チェックアウトを共有 | ライブで見守りたいローカル作業 |
| 1つのセッション内のサブエージェント | 1つのセッションが生成されたスレッドをディスパッチする | セッションディレクトリを共有 | 読み取り中心の作業:調査、トリアージ、テスト |
作業の範囲が明確で、後から結果を確認すればよいなら Codex クラウドタスクを使う。実行中に各ランを操作したいならローカル CLI セッションを使う。作業の大部分が読み取りならサブエージェントを使う。生成されたエージェントは1つのワーキングディレクトリを共有し、Codex サブエージェントの挙動によれば、セッションはすべての完了を待って1つの統合された返答を返すからだ。この最後の形は並列での書き込みには向かない。エージェントが同時にコードを編集すると競合が生まれ、単一のサマリーは部分ごとにレビューできない。
ステップバイステップ:複数の Codex タスクをローカルで衝突なく実行する
ローカルの方法は、多くの人が最初に手を伸ばす方法であり、最初に壊れる方法でもある。ここでは生き残るセットアップを紹介する。
ステップ1. 各タスクに専用のチェックアウトを与える。 git worktree とは、同じリポジトリに裏打ちされた、専用のブランチを持つ2つ目のワーキングディレクトリだ。タスクごとに1つ作成する:
git worktree add ../app-authfix -b fix/token-refresh
git worktree add ../app-tests   -b test/checkout-coverage
git worktree add ../app-refactor -b refactor/api-client
これを省略した場合の失敗: 同じフォルダ内の2つの codex セッションが同じファイルを編集し、後から書いた方が黙って勝ち、両方とも成功を報告する。損失はレビューで、あるいは本番で見つかる。
ステップ2. worktree ごとに1つの Codex セッションを開始する。 各ディレクトリでターミナルを開き、そこで Codex を実行する:
cd ../app-authfix && codex
これを省略した場合の失敗: 1つのセッションのコンテキストに4つの目標が混在し、どの変更がどのタスクのものかを見失う。
ステップ3. 人間がキーボードの前にいる必要のないものはスクリプト化する。 自己完結型のタスクなら、非対話モードでプロンプトなしに最後まで実行される:
cd ../app-tests && codex exec "add tests for the checkout flow until coverage passes"
これを省略した場合の失敗: あなたを必要としなかったセッションにつきっきりで座り続けることになり、並列で走らせる意味がなくなる。
ステップ4. 1ブランチずつ意図的にマージする。 各 worktree はブランチなので、個別にレビューしてマージする。エージェント同士が互いの作業をマージすることは決して許さない。これを省略した場合の失敗: 3つのブランチが一度に着地し、マージコミットで競合が表面化し、どのエージェントの変更が原因だったか分からなくなる。
その後に worktree をきれいに整理する手順については、コーディングエージェント向け worktree を後始末の手間なく管理するを参照してほしい。同じ worktree パターンは複数の Claude Code エージェントを実行する場合にも使われており、設計上ランタイムに依存しない。
DIY セットアップがスケールしなくなる地点
worktree は衝突を解決する。しかしすべてを解決するわけではなく、壁は見た目より近くにある。
3〜4個のタスクならこのセットアップは持ちこたえる。8個になると、ターミナルのグリッドはワークスペースではなく記憶力テストになる。失敗は劇的ではない。じわじわと積み重なる:
- 全体像を見失う。 どのウィンドウが認証修正か?どれが完了した?20分前に失敗してそのまま放置されているのはどれ?状態はあなたの頭の中にしかなく、画面からスクロールして消えていく。
- レビューに区切りがない。 各セッションの出力はスクロールバックの壁だ。何に触れ、何を実行し、どこで止まったかのタスク単位の記録がなく、ある結果を受け入れて別の結果をきれいに却下することができない。
- 何も共有されていない。 チームメイトが進捗を確認したくなった瞬間、あなたは diff を Slack スレッドにコピーしている。作業は実在するが、見えない。
これらはあらゆる並列エージェントのワークフローが行き着く同じ3つの問題であり、数が増えるとチームが並列コーディングエージェントを管理する専用ツールに手を伸ばす理由でもある。分離は解決済みの問題だ。可視性とレビューはそうではない。少なくともターミナルのグリッドでは。
タスクボードが加えるもの
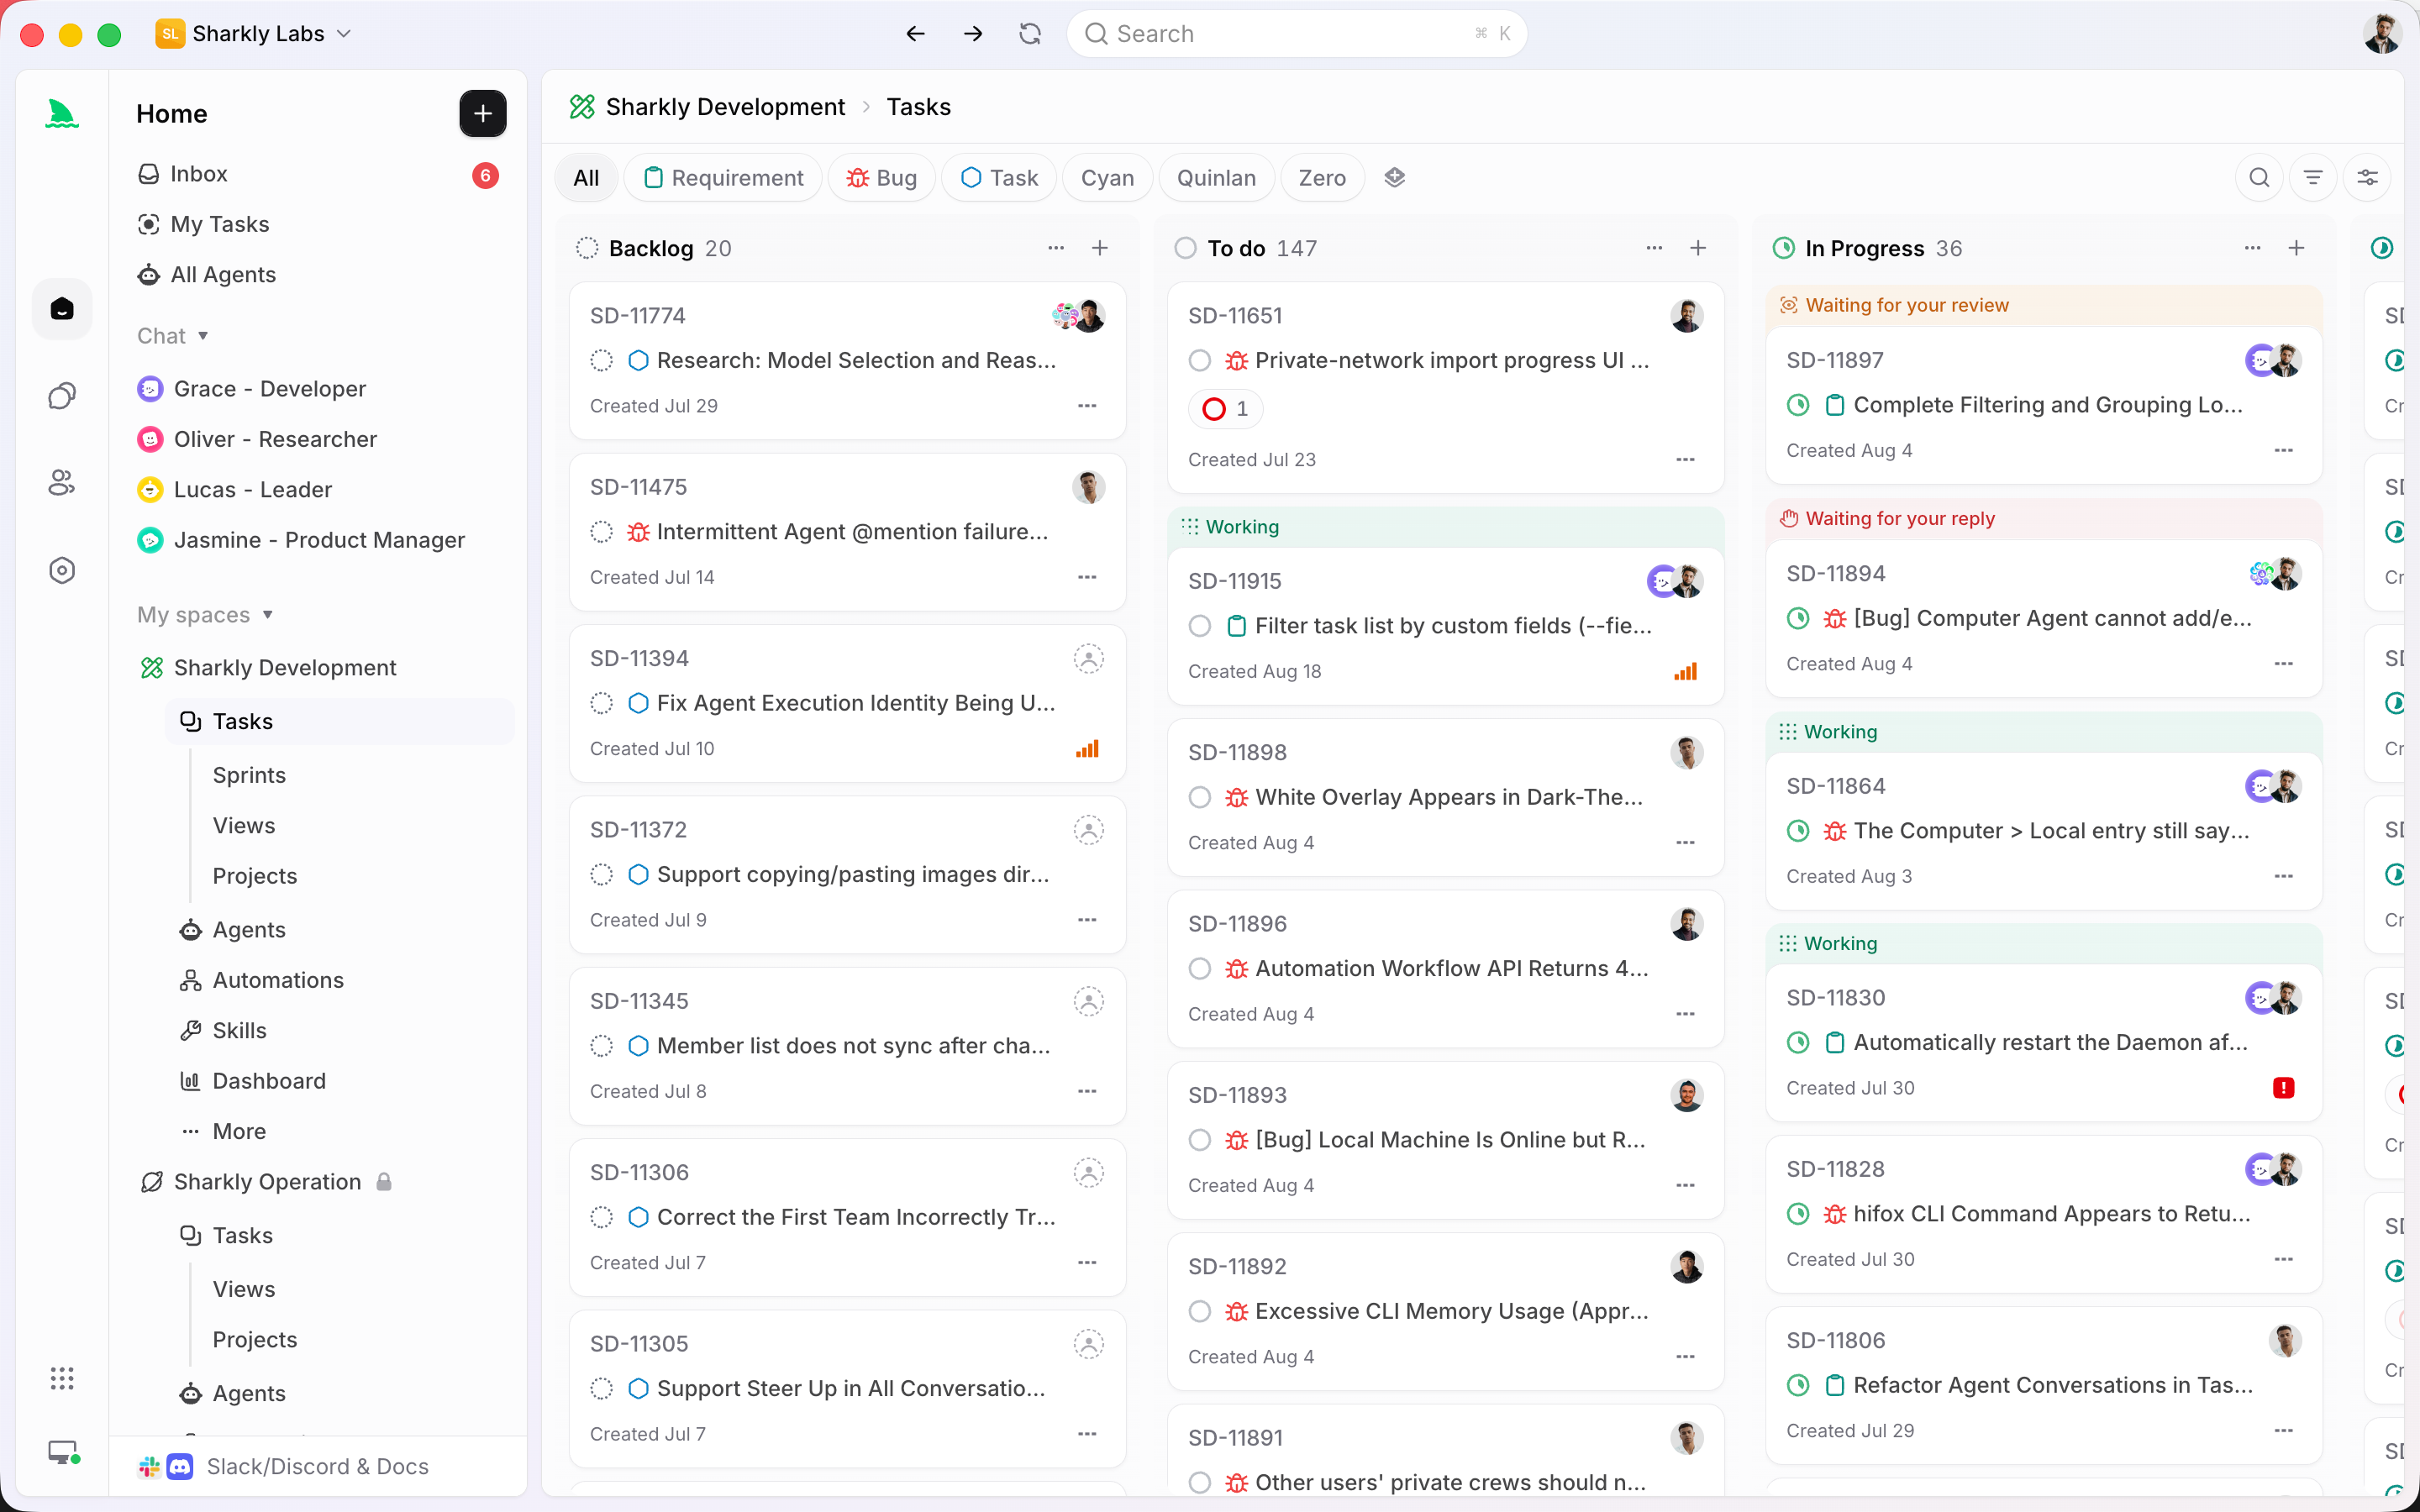
ここで、エージェントの上位にあるレイヤーがその存在価値を示す。Sharkly では Task が1つの作業単位の共有記録であり、Codex タスクを並列で走らせることは Task を並列で走らせることになる。
各 Task は自動的に分離された git worktree を確保するので、分離された worktree 内の並列エージェントは自分でスクリプトするものではなく、デフォルトの動作になる。1つのリポジトリに対して10個の Task、共有状態はゼロ、git worktree add を手で打つ必要もない。編集を行っている Runtime は依然として Codex であり、その周囲に分離が提供される。
要点は分業にある。エージェントは調査し、実行し、テストし、報告する。人間は方向性を定め、権限を与え、結果を受け入れる。自動化はチームの判断が必要なところで止まる。だから各ランは、トリガー、ツール呼び出し、どこで止まったかを含む専用の実行ログを保持し、最終結果はターミナルを流れ去るのではなく Task に返る。コンテキスト、進捗、ブロッカー、結果、人間のレビューは、リクエストからリリースまで見える状態に保たれ、サマリーのサマリーを読むのではなく、それぞれを個別にレビューする。その報告面については、AI コーディングエージェントが完了した作業を追跡する方法を参照してほしい。
Sharkly は Codex の代替ではない。すでに動かしているエージェントの周囲に、共有タスク、チェックアウト、コンテキスト、レビューのレイヤーを加えるものだ。Codex セッションを常に1つしか動かさないなら、必要ない。1つのコードベースに対して複数を動かし、流れを見失っているなら、それこそがこれが作られた問題だ。上記の worktree セットアップを手で構築してもよいし、既存の Codex タスクを Sharkly 経由で実行して、ワークフローに状態を管理させてもよい。
今日から実行できるチェックリスト
- タスクごとに1つの git worktree、それぞれ専用のブランチ。2つのタスクがチェックアウトを共有しない。
- worktree ごとに1つの Codex セッション、あるいはあなたを必要としないタスクには
codex execを使う。 - サブエージェントは読み取り中心の作業にのみ使う。同時書き込みは別々のチェックアウトに保つ。
- 1ブランチずつマージし、着地する前にそれぞれをレビューする。
- どのタスクがどれで、それぞれが何に触れ、結果がどうだったかの記録を、チームメイトが見られる場所に残す。
- ターミナルのグリッドが頭に収まらなくなったら、追跡とレビューをタスクボードに移し、各ランが結果を1つの共有の場所に返すようにする。
よくある質問
Codex は複数のタスクを同時に実行できますか? はい。Codex クラウドは OpenAI のドキュメントに従い、分離された環境でタスクを実行し、ローカルでは複数の codex セッションを同時に実行できる。制約は Codex ではなくチェックアウトにある。各ローカルタスクに専用の git worktree を与えれば、編集が衝突しない。
並列で実行できる Codex エージェントの数は? マシンとモデルクォータが許す限りいくつでも。ただし実用的な上限はもっと低い。1人が実際にレビューできる同時結果の数だ。数個を超えると、計算資源ではなく追跡とレビューが制限になる。
worktree は必要ですか、それともターミナルをもっと開くだけではだめですか? 同じディレクトリでターミナルを増やすと、同じファイルへの同時書き込みと、気づかないうちの上書きが発生する。worktree は各セッションに専用のディレクトリとブランチを与え、それがローカルの並列化を安全にする。AI コーディングエージェント向け git worktreeを参照してほしい。
Codex のサブエージェントと並列タスクの違いは? サブエージェントは1つのセッション内で実行され、そのワーキングディレクトリを共有し、1つの統合された返答を返す。読み取りやトリアージに向いている。並列タスクは別々のチェックアウトを持つ別々のランであり、同時書き込みと独立したレビューに必要なものだ。


