
要約: GPT-6.2のレート制限は、APIではAstraとSolで同一です。Buildティアで5,000 RPM・1,000,000 TPM、Launchで10,000 RPM・4,000,000 TPM、Growで15,000 RPM・40,000,000 TPMです。制限は組織単位・プロジェクト単位で適用されるため、同じキーを使うすべてのエージェントがこの枠を共有します。エージェントチームにとっては、リクエスト数ではなくトークン/分が先に上限に達します。
OpenAIは2026年11月17日にGPT-6.2 AstraとGPT-6.2 Solをリリースしました。Astraは最難関のタスク向けのフロンティアモデルで、Solはより安価な日常用途モデルです。OpenAI自身の言葉を借りれば、Solは「大規模なエージェント運用を支える」ために作られています。
エージェント1体ではまず上限に達しません。しかし1つのAPIキーで6体動かせば、昼までに達してしまいます。このガイドでは、GPT-6.2のレート制限、Codexプランの上限、そしてキューで待機するようにエージェントチームを設計する方法を解説します。すでに複数のコーディングエージェントを運用しているなら、Sharklyで同時に実行するエージェントの数を制御できます。
使用ティア別のGPT-6.2レート制限
GPT-6.2 AstraとGPT-6.2 Solは、OpenAIのSolモデルページとAstraモデルページに記載されている、同一の標準レート制限表を共有しています。RPMは1分あたりのリクエスト数、TPMは1分あたりのトークン数です。先に使い切った方が制限になります。
| ティア | 昇格条件(クレジット購入累計) | 月間利用上限 | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5,000 | 1,000,000 |
| Launch | $100 | $5,000 | 10,000 | 4,000,000 |
| Grow | $500 | $200,000 | 15,000 | 40,000,000 |
昇格条件と月間利用上限の数値は、OpenAIのレート制限ガイドに基づいています。ティアはクレジット購入の累計が各しきい値を超えると自動的に昇格します。月間利用上限は、自分で設定する支出上限とは別の制限です。
Astraはトークンあたり4倍の価格です(100万トークンあたり入力$8・出力$40。Solは$2・$10)。しかしレート制限は同一です。どちらの上限に達するかは、エージェントが消費するトークン量次第です。
CodexにおけるGPT-6.2の利用上限の仕組み
APIキーではなくChatGPTプラン上でCodex経由でエージェントを実行している場合は、別の上限が適用されます。OpenAIのCodex料金ページでは、タスクの規模によって1メッセージあたりのコストが変わるため、5時間ウィンドウごとのローカルメッセージ数が範囲で示されています。
| モデル | Plus | Standard Business |
|---|---|---|
| GPT-6.2 Astra | 6〜50 | 6〜50 |
| GPT-6.2 Sol | 17〜180 | 17〜180 |
| GPT-6.1 Sol | 15〜160 | 15〜160 |
| GPT-6 Astra | 5〜45 | 5〜45 |
エージェントチームに関わる4つのポイントがあります:
- Proプランには現在5時間制限がありませんが、週次制限は適用される場合があります。
- ローカルメッセージとクラウドチャットは同一の枠を共有します。クラウドタスクはローカルメッセージよりも多くの枠を消費することがあります。
- 高速モードは枠を余計に消費します。GPT-6.2モデルではFastモードは含まれる利用量の2倍、Ultrafastは6倍を消費します。
- 長いセッションはメッセージあたりのコストが高くなります。OpenAIによれば、多くのコンテキストを保持するタスクは枠を「大幅に多く」消費します。
リポジトリの半分を読み込んだエージェントは、毎ターン大きなコンテキストを送信するため、メッセージ数は急速に減っていきます。同じパターンについて、AnthropicのプランではClaude Codeの利用制限で扱いましたが、Codex Pro上限引き下げへの対処も同じロジックで対応できます。
エージェントチームを制限するのはRPMではなくTPM
コーディングエージェントは数千の小さなリクエストを送るのではなく、少数の大きなリクエストを送ります。各ターンで、それまでの会話全体——指示、読み込んだファイル、ツールの出力、自分自身のそれまでの推論——を再送信します。
典型的な例として、1ターンあたり80,000入力トークン、毎分6ターンのエージェントを考えてみましょう。これは6 RPM、約480,000 TPMに相当します。Buildティアと比較すると:
- RPM: 5,000のうち6使用。ほど遠い。
- TPM: 1,000,000のうち480,000使用。エージェント2体で満杯になる。
実際の数値は異なるはずですが、この比率は変わりません。エージェントはトークンを大量に消費し、リクエスト数は少ないのです。この例のエージェントでは、理論上限はBuildで1プロジェクトあたり2体、Launchで8体です。後述のサイジング手順にある30%のヘッドルームを確保すると、Buildで1体、Launchで5体になります。Growではレート制限はもはやボトルネックではなく、月間$200,000の上限や自分で設定した予算が律速になります。
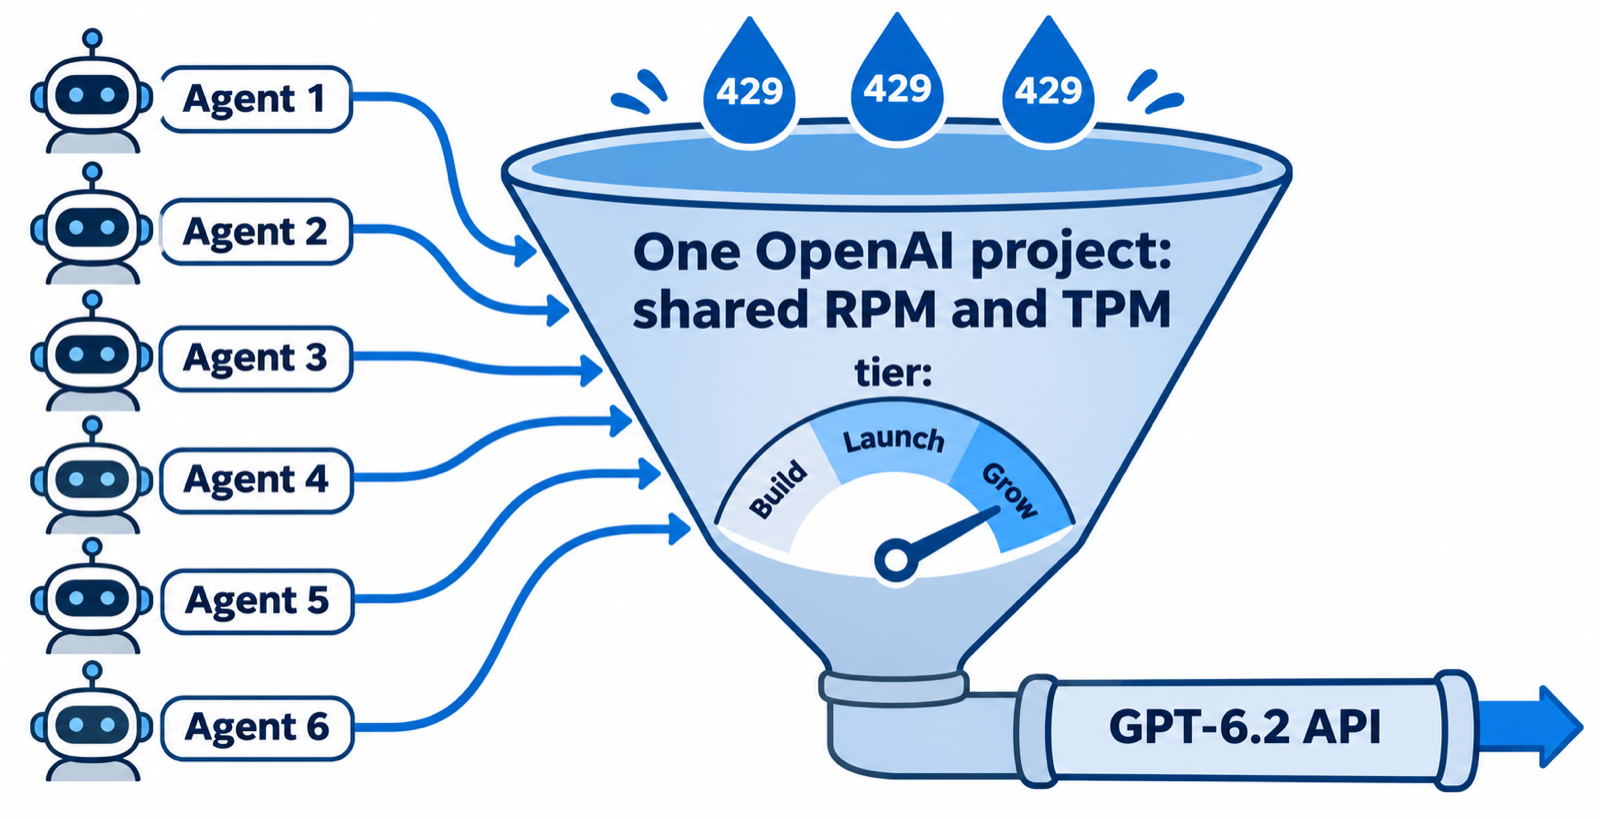
制限は組織全体で共有される
OpenAIのレート制限は、ユーザー単位ではなく組織レベルとプロジェクトレベルで定義されます。1つのプロジェクトのキーを使うすべてのエージェントは、同じプールから消費します。さらに一部のモデルファミリーには、制限ページに共有制限が設定されている場合があり、あるモデルへのトラフィックが別のモデルの枠を消費することもあります。
GPT-6.2ティアに合わせたエージェント並列数の設計方法
対策は、同時に実行するエージェント数を上限設定し、余分な仕事をキューで待機させてAPIでの衝突を避けることです。効果的な手順は以下の通りです:
- OpenAIプラットフォームの Settings → Organization → Limits で自分のティアを確認する。
- 実際のエージェント実行を1回計測する。ランタイムの使用量出力から、1ターンあたりの入力トークン数と毎分のターン数を記録する。
- TPMを1エージェント分のTPMで割り、スパイクに備えて30%のヘッドルームを残す。
- プロジェクトを使用するすべてのエージェントに対し、その数を並列数の上限として設定する。
- 1週間は429エラーを監視し、その後1段階ずつ上限を引き上げる。
Sharklyでは、各エージェントに最大並列数(割り当てタスク)設定、分単位の最大実行時間、時間単位のキュータイムアウトがあります。上限に達すると、新しいタスクは空きが出るまでQueued状態で待機します。チャットも同じ制限を共有できるため、会話が上限をすり抜けることはありません。

Computerにもそれぞれタスク並列数の上限があります。Sharklyのドキュメントには、並列数を上げるとCPU、メモリ、ディスク、プロバイダーの容量、リポジトリの帯域幅の消費が増えるため、現在の負荷が安定してから引き上げるよう記載されています。
エージェントをOpenAIプロジェクトに分ける
プロジェクトレベルの制限を利用すると、エージェントグループを分離できます。レビューエージェント用と一括リファクタリング用に、別々のOpenAIプロジェクトを割り当てましょう。暴走したリファクタリングは自分のプロジェクトの制限に達するだけで、レビューを圧迫しません。組織レベルの制限は合計に適用されるため、これは優先順位の設定であり、容量の追加ではありません。
APIキーで認証するランタイムの場合は、そのキーをエージェントの環境変数として設定します。Sharklyはエージェントの起動時にエージェントの環境変数をプロセスに注入します。各エージェントグループに、それぞれのOpenAIプロジェクトのキーを与えれば、トラフィックが正しい制限に計上されます。
タスクあたりのトークンを監視する
Sharklyのエージェントヘッダーには、割り当てタスク数、総実行回数、使用トークン数が表示されます。月間合計だけでなく、タスクあたりのトークン数に注目してください。他の3倍のトークンを消費するタスクタイプは、AstraではなくSolに切り替える、あるいはタスク記述をより厳密にする第一候補です。
大量処理をオフピークに移す
各エージェントのランタイム設定には、作業をオフピーク時間帯にスケジュールするための稼働時間スイッチがあります。テスト生成、依存関係の更新、ドキュメント整備などを設定しましょう。これらのタスクは夜間に実行され、日中のキャパシティを、人が待っている仕事のために確保できます。
GPT-6.2の429エラーへの対処方法
上限を設定していても、時折 429 に遭遇します。OpenAIのガイドには具体的な対応が示されています:
Retry-Afterヘッダーがあればそれに従い、最低待機時間として扱う。- なければ、ランダムなジッター付きの指数バックオフを使う。
x-ratelimit-remaining-tokensとx-ratelimit-reset-tokensを読んで、どれだけ余裕があるかを確認する。- リトライをネストしない:自前でリトライする場合はSDKのリトライを無効化する。さもないと両者が掛け合わさる。
- クォータエラーや課金エラーはリトライしない。人の対応が必要です。
server_is_overloaded を伴う 503 は、モデル側が混雑していることを意味し、自分の責任ではありません。同じバックオフで対処します。
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
AstraかSolか:どちらのモデルが制限をより有効に使えるか
レート制限は同一なので、選択はトークン使用量と価格で決まります。アーキテクチャの変更、難しいバグ、長時間の自律実行にはAstraを使います。定型的な作業はすべてSolに任せましょう。PlusプランのCodexでは、SolはAstraの約3倍のメッセージを5時間ウィンドウで処理でき、これがコスト差の最も明確な指標です。
一般的な解は混合チームです。GPT-6 AstraをCrewリーダーとして使うように、Astraのエージェント1体が統括し、複数のSolエージェントが部品を処理します。定型的な作業は安価なモデルに任せるというのが、GPT-6 Lunaを退屈な80%に使うという発想の背景にあるロジックです。
GPT-6.2のスループットを上げるその他の方法
- Batch API。同期レート制限の対象外で、標準料金の50%で利用できます。評価や一括分類には最適ですが、インタラクティブなエージェントには不向きです。
2hまたは8hウィンドウでのバックグラウンドモード。これはリアルタイムのTPMではなく、別のBatch/Backgroundキュー制限に計上されます。- プロンプトキャッシング。キャッシュ済み入力はAstraで100万トークンあたり$0.40、Solで$0.10。同じコンテキストを再送するエージェントにとって大きな節約になります。
まとめ
GPT-6.2のレート制限は、リクエスト単位では寛大ですが、トークン単位では厳密です。エージェントチームにとっての実効的な制限は、「ティアのTPM ÷ 1エージェントの消費量」であり、これはプロジェクト上の全エージェントで共有されます。1回の実行を計測し、並列数をその数より低く設定し、ノイズの多いエージェントグループを別プロジェクトに分離し、残りはキューに吸収させましょう。
これはスクリプトとセマフォで構築することもできますし、Sharklyでエージェントごとに設定することもできます。Computerを1台接続し、CodexでGPT-6.2 Solを使うエージェントを1体作成し、最大並列数を2に設定して、退屈なタスクを割り当ててみてください。エージェントを並列に実行する詳細については、AIコーディングエージェントを10体同時に実行する方法をご覧ください。
よくある質問
GPT-6.2のレート制限は?
APIでは、GPT-6.2 AstraとSolは同一の制限を共有しています:Buildで5,000 RPM・1,000,000 TPM、Launchで10,000 RPM・4,000,000 TPM、Growで15,000 RPM・40,000,000 TPMです。
GPT-6.2 AstraはSolよりレート制限が厳しいですか?
いいえ。OpenAIはすべてのティアで両モデルに同じRPMとTPMを提示しています。Astraはトークンあたりの価格が高いため、レート制限ではなく予算を先に消費します。
より高いOpenAIの使用ティアに移行するには?
ティアはクレジット購入の累計に応じて自動的に昇格します:Buildは$5、Launchは$100、Growは$500です。
レート制限はAPIキー単位ですか、それとも組織単位ですか?
組織単位かつプロジェクト単位です。プロジェクト内のすべてのキーは同じプールから消費するため、1つのプロジェクトで10キー・10エージェントを運用しても、制限は1つしかありません。
CodexでGPT-6.2 Astraのメッセージは何回使えますか?
PlusおよびStandard Businessでは、OpenAIの推定でGPT-6.2 Astraは5時間ウィンドウあたり6〜50回のローカルメッセージ、Solは17〜180回です。Proプランには現在5時間制限がありませんが、週次制限が適用される場合があります。
RPMには余裕があるのに、なぜエージェントが429エラーに達するのですか?
エージェントは大きなコンテキストを送信するため、1分あたりのリクエスト数が上限に達するずっと前に、1分あたりのトークン数が使い切られます。レスポンスヘッダーの x-ratelimit-remaining-tokens を確認してください。
Sharklyは独自のモデル制限を追加しますか?
いいえ。Sharklyは既に使っているコーディングエージェントを実行するものであり、モデルのクォータはチームが接続したツール、プラン、APIアカウントに依存します。Sharklyが制御するのは、各エージェントが同時に実行するタスク数です。