
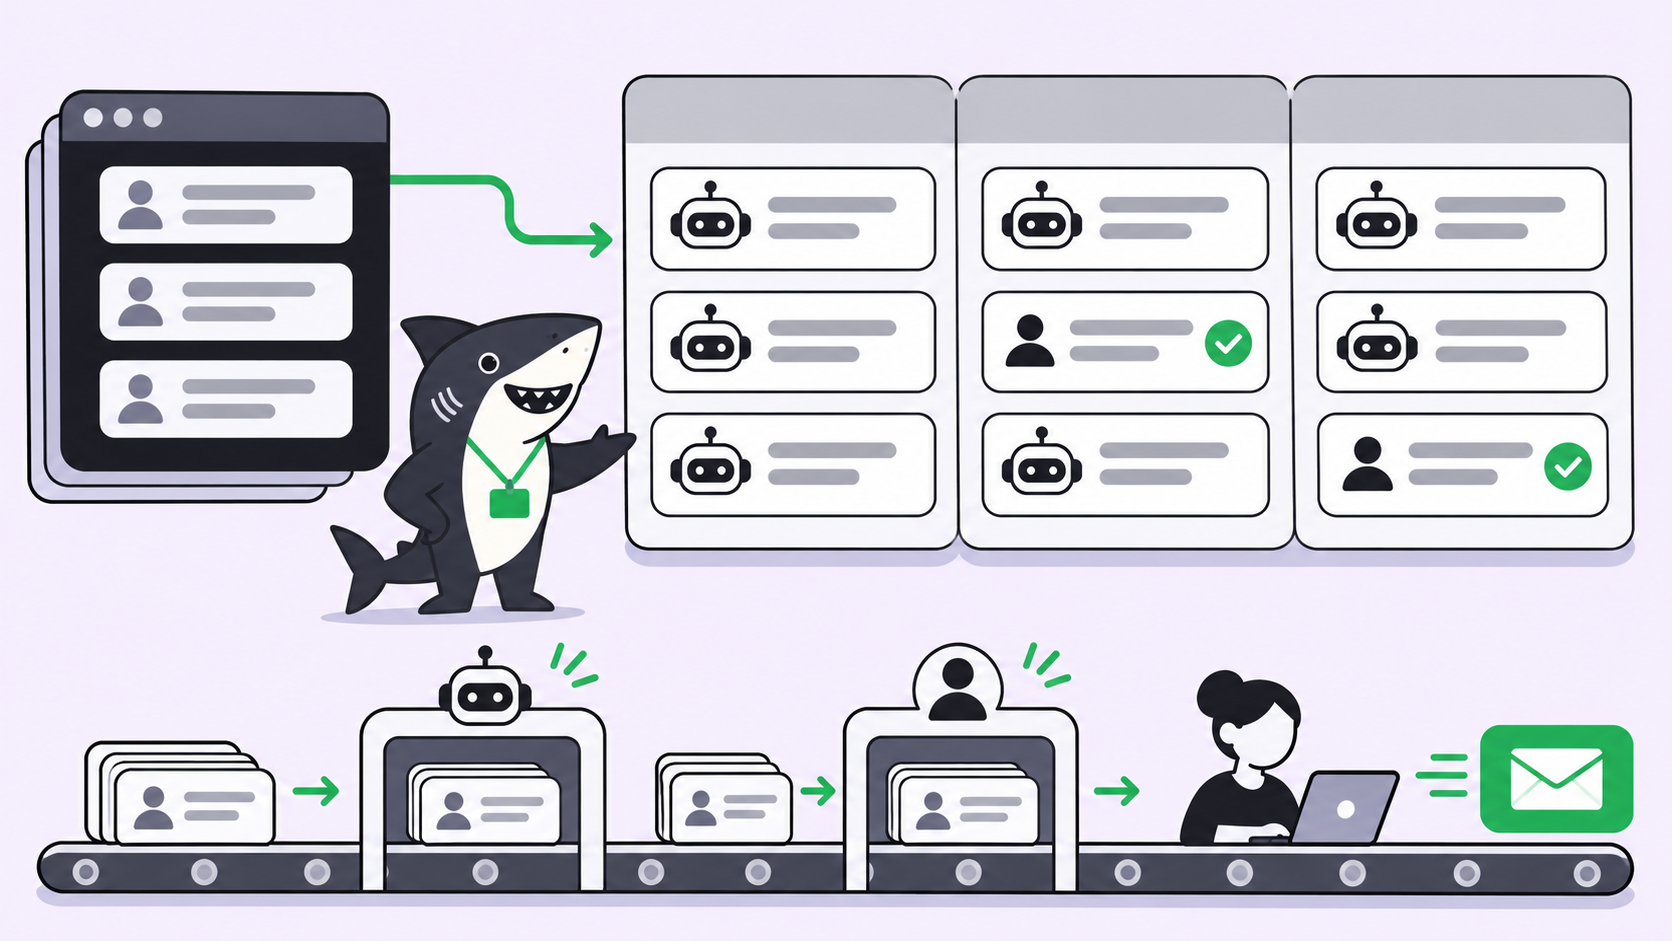
要約(TL;DR): 業務をステージごとのボードタスク(ICPフィルター、ルールファイル、クオリフィケーション、人物検索、メールアドレスの特定と検証、シグナル、アウトリーチ)に分割することで、Claude Code上でGTM(Go-To-Market)を運用できます。データ層としてTregを利用し、エージェントが各データタスクを実行します。人間がルールファイルを管理し、メール送信前には必ずファーストライン(冒頭の一文)を承認します。
Claude CodeでGTMを運用するというのは、「良質なアカウントを50件見つけて、バイヤー宛てにメールを書いて」という1つの長いプロンプトを実行するだけのように思えるかもしれません。デモであればこれでも機能します。しかし、検索ツールのAPI上限に達したり、そのメールを誰が承認したのか誰も答えられなくなったりした瞬間に破綻します。
TregのGTMエンジニアリング・プレイブックは、データに関する部分を網羅しています。ICPからロールアウトまでの16章で構成され、6回の記録された実行、502件のログ記録されたAPIコール、そして5.03ドルの従量課金実績に基づいています。なお、ここに記載されている数値はすべてTreg自身の測定結果であり、第三者による独立した再現検証はまだ行われていないため、自社のデータ行で実際にテストしてください。
もう半分の重要要素は「連携と管理(コーディネーション)」です。プロセスの停止責任者、アウトリーチ担当者、ステージごとの行数(リード件数)の把握などがこれに該当します。1つのセッションだけでこれらすべてを管理することはできません。本記事では、このプレイブックをSharkly上のタスクとして展開し、エージェントがClaude CodeまたはCodexで各ステージを実行しつつ、プレイブックで指定された2つのゲート(関門)に人間を配置する方法を解説します。
Claude CodeでのGTM運用に単一セッションではなくカンバンボードが必要な理由
エージェントを長時間単一セッションで走らせると、GTM業務では致命的となる3つの失敗要因が見えなくなってしまいます。
- チェックポイントなしのコスト消費: 本来除外すべきだったデータ行に対して有料のエンリッチメントを実行してしまう問題。
- サイレントな障害発生: Tregは自身の実行時にプロセスを止めることなく発生したエラーを挙げています。検索ツールの容量上限到達、バイインググループ向けエンドポイントの容量超過、3件のアカウントに対するレート制限、そして1.08ドルの再実行コストを要したパーサーバグなどです。
- 送信責任者の不在: プレイブックのアウトリーチルールは極めて明確です。「人間が目を通していないものは一切送信しない」。
これらはいずれもチーム運営上の問題であり、明確な責任(オーナーシップ)、ステータス管理、そしてステージごとの記録によって解決できます。これは、エージェント業務に対する人間のオーナーシップで提唱されたモデルをリードリストに応用したものです。
システム構成:各コンポーネントの実行環境
それぞれ1つの役割を担う3つのレイヤーで構成されます。
| レイヤー | ツール | 役割 |
|---|---|---|
| 実行 | Claude Code または Codex | プロンプトの実行、ルールファイルの読み込み、CSVの書き出し |
| データ | Treg | 企業および人物検索、エンリッチメント、メールアドレスの特定と検証、採用・資金調達シグナルの取得(APIコールごとの従量課金) |
| 連携・管理 | Sharkly | ステージごとのタスク管理、タスクごとの担当者(Assignee)設定、レビュー状態の管理、実行ログの記録 |
エージェントを実行するコンピューター(環境)でTregを一度セットアップします。Tregのセットアップファイルより:
# install the CLI and the treg skill for every agent it detects
curl -fsSL https://treg.to/install.sh | sh

# browser sign-in (GitHub, Google, or an emailed code)
treg login

# headless Computer: pass a token instead of a browser
curl -fsSL https://treg.to/install.sh | sh -s -- --token "$TREG_TOKEN"
あるいは、エージェントに set up treg - https://treg.to/llms.txt という1行を貼り付けるだけでも構いません。Tregによると、認証済みの新規アカウントには1.00ドルの無料クレジットが初回一度だけ付与され、APIコールはプロバイダーの正規レート(マークアップ0%)で請求され、検索失敗時の課金は0.00ドルです。
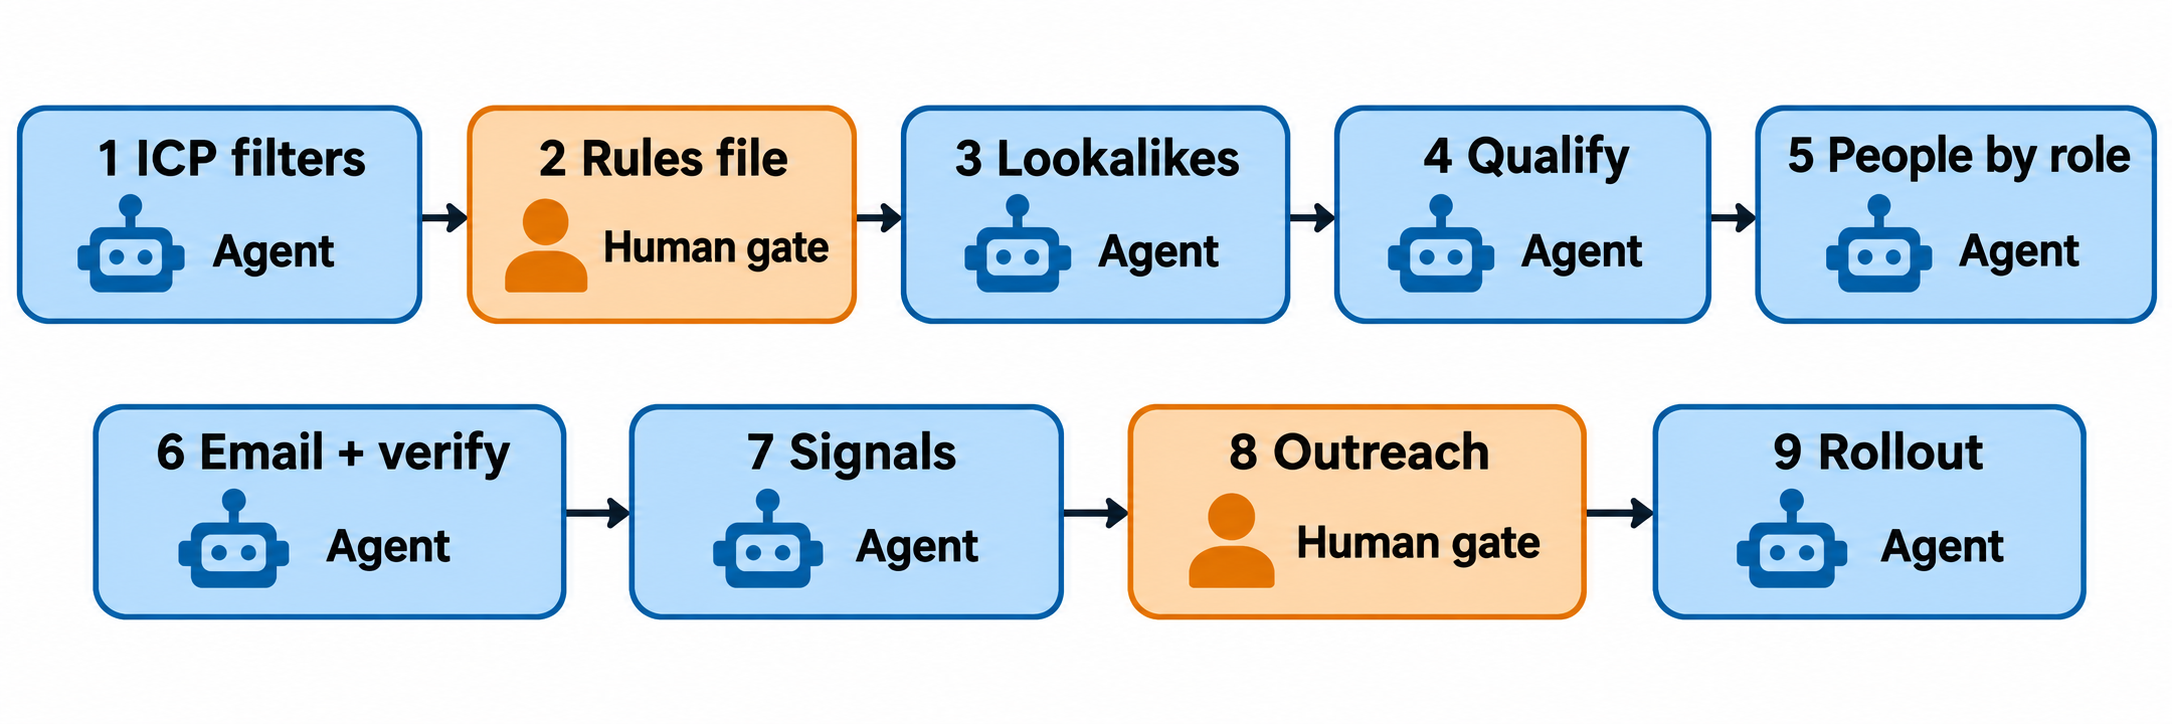
ボードタスクとしてのGTMパイプライン
以下は、プレイブックをタスクにマッピングした一覧です。3列目は、そのステージにおけるTregの実測記録です。
| タスク(プレイブックの章) | 担当者 | Tregの実測記録 |
|---|---|---|
| フィルターとしてのICP + 無料カウント (1-2) | エージェント | CompanyEnrich、B2B+SaaS、従業員51〜200名、米国:10,403件、2024年以降の資金調達:1,357件 |
| ルールファイル (3) | 人間 | 人間が管理するゲート:しきい値、除外条件、利用額上限、停止権限者 |
| 類似企業(ルックアライク)の検索 (4) | エージェント | 0.006ドルで候補71社を抽出、71社中8社が50%のICPチェックを通過 |
| 課金前のクオリフィケーション (5) | エージェント | 50社:27社通過、21社除外。合計2.33ドル、配信可能リード1件あたり0.12ドル |
| 役職別の人物検索 (6) | エージェント | 8社のアカウントにおける「マーケティング」担当:20名、0.00ドル(連絡先情報の取得が有料ステップ) |
| メールアドレスのウォーターフォール検索 + 検証 (7-8) | エージェント | 60名:配信可能32件、リスクあり16件、不明4件、無効8件、0.65ドル |
| シグナル検知 (9-10) | エージェント | 27社:16社で過去60日以内にGTM関連の募集ポジションあり、1.35ドル |
| アウトリーチ (11-12) | エージェントが下書き作成、人間が承認 | ニュースに基づくファーストライン19件中、4件が合格以上の評価 |
| タギング、指標測定、ロールアウト (14-16) | エージェント + 人間 | ステージごとのデータ行数集計、未加工レスポンスの保存、1回あたりの利用額上限 |
エージェントがフィルタリングできるICPをどのように定義すべきか?
フィルターとチェックの2つに分割します。フィルターとは、国、従業員数、カテゴリー、資金調達状況など、データプロバイダーが検索可能なフィールドです。一方、チェックとはデータ行ごとに行う定性的な判断であり、有料ステップに進む前に必ず実行します。
タスクの説明には、Tregのプロンプトをそのまま記載できます。「tregを使用し、icp.md内のICPを企業検索プロバイダー2社向けのフィルターに変換してください。無料の件数カウントエンドポイントのみを使用すること。」受け入れ基準もプレイブックに準拠します。2社の無料カウント結果が概ね一致し、サンプル10行の内容が適切であることを確認するまで、有料リストの購入は行いません。
なぜルールファイルには人間の責任者が必要なのか?
しきい値の設定次第で、抽出されるリストが大きく変わるためです。Tregの検証では、ICPの一致率しきい値を50%に設定した場合は48社中27社が通過しましたが、60%に設定した場合はわずか14社にとどまりました。これはビジネス上の重要な意思決定であるため、ルールファイルの策定タスクは人間が担当します。
ルールは、すべてのステージが参照できる場所に配置します。SharklyのSkillはエージェント作業用の再利用可能な指示群をパッケージ化できるため、ルールファイルを9つのプロンプトに毎回貼り付ける代わりに、すべてのGTMエージェントに紐付けられた1つのSkillとして管理できます。
# gtm-rules.md (owner: the person who can stop the run)
icp_threshold: 0.50
max_spend_per_run_usd: 3.00
drop_if: [no_usable_domain, headcount_outside_51_200]
send_only: verifier_verdict == "deliverable"
stop_owner: "growth lead"
every_stage_reports: [rows_in, rows_out, metered_cost]
ステージ3〜7:費用をかける前のクオリフィケーション
これらは「低コストな処理から先に実行する」データタスクです。人物検索を開始する前にクオリフィケーションが完了するよう、タスク間を「ブロックする/ブロックされる(blocks / is blocked by)」のリレーションで関連付けます。コストを抑えるためには、この実行順序が極めて重要です。Tregの実績では、50社のクオリフィケーションを2.33ドルで完了させており、有効なドメインを持つ48社すべてにエンリッチメントを実施した場合の見積もりは4.12ドルでした。
プレイブックの2つのルールを受け入れ基準として設定します。第1に、類似企業も通常の企業と同様の規模フィルターおよびICPチェックを通過させること。第2に、検証によって「配信可能(deliverable)」と判定されたアドレスのみを配信シーケンスに投入することです。Tregによる60人を対象とした検証では、検索ツールが60件のアドレスを返したものの、検証ツールを通過したのは32件でした。
各データタスクの終了時には、エージェントがコメントを残します(入力行数、出力行数、Tregの従量課金コスト)。実行ログと合わせることで、これがそのステージの受領書(明細記録)となります。
送信ボタンを押す権限を人間が握り続けるには?
アウトリーチタスクでは、エージェントが調査と下書きの作成を行ったら、そこで処理を停止させます。Tregの実験では、ニュースに基づくファーストライン19件のうち、合格以上の評価を得られたのはわずか4件でした。そのため、エージェントはタスクを「人間のレビュー待ち(waiting for human review)」の状態にして待機し、レビュアーが承認、編集、または書き直しを行います。このパターンはヒューマン・イン・ザ・ループのコーディングエージェントで解説しましたが、メール送信業務にもそのまま適用できます。
Sharklyがプレイブックのルールを確実に維持する仕組み
- ステージごとに1つのタスク: 各ステージにステータス、担当者(エージェント、Crew、または人間)、および受け入れ基準を付与します。
- レビュー状態による通知のルーティング: エージェントはタスクを「人間の返答待ち」または「人間のレビュー待ち」に設定でき、これらのシグナルは担当者の受信トレイ(Inbox)に集約されます。
- 実行ログ(Run Record): 実行の開始・終了時刻、ツール呼び出し、Runtimeイベント、失敗の詳細を表示し、ロールアウトの章で求められる監査証跡を提供します。
- 親タスクによる成果物の管理: 「第4四半期マーケティングバイヤーリスト」などを親タスクとし、9つのステージをそのサブタスクとして紐付けます。
9つのタスクを自分で個別に割り当てたくない場合は、Sharkly Crewsで解説されているように、Crewリーダーが親タスクを分割して各ステージを委任することも可能です。Sharklyは無料で使い始めることができ、モデルの使用料金はお使いのRuntimeに既に連携されているClaude CodeまたはCodexのプランで処理されます。
シグナル検知:ソースのリンクがなければシグナルとみなさない
シグナル検知タスクには、最も厳格な受け入れ基準を設ける必要があります。Tregの調査では、27アカウント中16件で過去60日以内にオープンなGTMポジションが見つかりましたが、取得された675件の求人情報のうち355件はすでに募集が終了していました。
転職(役職変更)データはさらに深刻です。新しい役職を発表した148名を対象にしたTregの調査では、連絡先データベースは平均して68%の確率で新しい勤務先を見落としていました。リアルタイムの公開プロフィール読み取りでは148名中49名しか検出できなかったものの、そのうち47名で正確でした。ここでもプレイブックの原則が適用されます。「ソースのリンクがなければ、アウトリーチは行わない」。
資金調達前の採用活動に関するTregの検証では明確なグループ間の差異が見られなかったため、タイミングに関するシグナルをスコアリングに組み込む前に、自社の受注・失注データで効果を検証してください。
Tregの数値が示していること、示していないこと
Tregは人物検索ページで、精読に値する2つの比較データを公開しています。
- 正確なメールアドレス1件あたりのコスト: 2026年10月のリード100件を対象としたテストにおいて、Clayが84件で3.77ドルだったのに対し、Tregは正確な業務用メールアドレス92件を100件あたり0.58ドルで取得できたと報告しています。
- エージェントの精度: LessieAIによる全119タスクの「People Search Bench」におけるB2Bプロスペクティングタスクにおいて、Claude Code単体では精度43%だったのに対し、Claude CodeとTregの組み合わせでは78.2%に達し、リスト完成までの所要時間も2.8分から1.4分へと短縮されたと報告されています。
これらはベンダーが実施日時点の定価で検証した結果であり、Treg自身も数件程度の差は同等とみなすべきだと注記しています。これらの数値を参考にしながら、まずは自社のデータ50件で検証する項目を選定してください。
ソフトウェアのように段階的にロールアウトする
最終章のルールは「シャドー運用で実績を積むまで、自律稼働させてはならない」というものです。ボード上ではこれを3つのフェーズに分けて進めます。
- シャドー運用(Shadow): エージェントがすべてのデータタスクを実行しますが、アウトリーチタスクはレビュー待ちのまま維持し、一切送信しません。
- 小規模セグメント(Small segment): 1つのティア、1週間限定で運用します。ルールファイルと照らし合わせながら、データ行数と配信可能リード1件あたりのコストを監視します。
- データ処理のみを自動化し、送信は絶対に自動化しない(Autonomy for data, never for sending): データタスクは自動化機能(Automation)によってスケジュール実行しますが、送信の判断は常に人間が行います。
複数の実行を同時にモニタリングする方法については、並行稼働するコーディングエージェントを監視する方法をご覧ください。
まずは1つのステージから始める
Claude CodeによるGTMがうまく機能するのは、各ステージが小さく分割され、コストが明確で、担当者が決まっており、誰がプロセスを停止し誰が送信を承認するかがボード上で明確になっている場合です。まずは小さく始めましょう。SharklyでICPタスクとルールファイルタスクを作成し、無料件数カウントを実行した上で、初めて有料ステージへと進めるようにしてください。
よくある質問(FAQ)
GTMエンジニアリングとは何ですか?
Tregのプレイブックでは、Go-To-Market戦略を再現可能なワークフローへと落とし込むシステムの設計・構築・保守と定義されています。これには、アカウントのターゲティング、リードのエンリッチメント、スコアリング、シグナル監視、リサーチ、インバウンドルーティングが含まれ、アウトバウンドメッセージの送信前には必ず人間のレビューが行われます。
Tregのリード1件あたりのコストはどれくらいですか?
2026年9月23日にTreg自身が実施した実行では、クオリファイされたリードのコストは配信可能リード1件あたり0.12ドル、リスト全体で2.33ドルでした。APIコールは使用ごとの従量課金制であり、検索失敗時の請求は0.00ドルです。
AIエージェントがレビューなしでコールドメールを送信すべきですか?
いいえ、送信すべきではありません。Tregのプレイブックでは、人間が目を通していないメールは一切送信しないと定められており、実際の実証でもエージェントが調査・作成したファーストライン19件のうち、合格以上の評価を得たのはわずか4件でした。
GTMエージェントのルールはどこで管理しますか?
数値なしきい値、明示的な除外条件、利用額上限、そしてプロセスの停止権限を持つ担当者1名を明記した「ルールファイル」で管理します。SharklyではこれをSkillとしてパッケージ化できるため、すべてのエージェントに同じルールを読み込ませることができます。
Claude Codeの代わりにCodexでも動作しますか?
はい、動作します。TregのセットアップはClaude Code、Codex、Cursorに対応しており、Sharklyエージェントは同一のボードからどちらのRuntimeでも実行できます。一般的なセットアップについては、AIタスクマネージャー:エージェント業務の割り当て、追跡、レビューをご覧ください。