Anthropicは10月7日にClaude Haiku 5.5をリリースし、その役割を「コーディング作業におけるサブエージェントとして、Opus 5.5やSonnet 5.5とうまく連携する」という一行で表現しました。ローンチ記事によると、料金は10万トークン以下のプロンプトで入力100万トークンあたり0.10ドル、出力100万トークンあたり0.50ドル、それを超える場合はそれぞれ0.50ドルと2.50ドルとなっています。ページ内に掲載された6件の導入事例のうち2件が、同じような活用パターンを示しています。Rogo社では、大規模モデルがプレゼン資料を作成する傍らで、Haiku 5.5のサブエージェントがForm 10-K(年次報告書)から売上高の行を抽出し、Cognition社はDevin FusionにおいてOpus 5.5の「相棒」としてHaiku 5.5を動作させています。
この位置づけはモデル自体の話です。複数のエージェントを運用するチームにとって、より本質的で難しい問いは「管理ボード」をどう設計するかという点にあります。サブエージェントは、他のエージェントの実行プロセス(run)の内部に存在します。独自のTaskもAssignee(担当者)もステータスも持たないため、サブエージェントがミスを犯した場合、その失敗はリードエージェントの名前で上がってきます。安価な作業は今や大量にこなせるほどコストが下がっており、真の論点は「その作業をどこで可視化すべきか」にあります。
TL;DR
Haiku 5.5の出力がリードエージェントによって消費・検証される用途(情報検索、要約、コード探索、コンテキスト圧縮など)であれば、実行プロセス内のサブエージェントとして維持してください。一方で、出力がそのまま成果物として出荷される場合や、人間による承認が必要な場合、あるいは単独で失敗する可能性がある場合は、独立したAgentおよび独自のTaskを割り当てましょう。Claude Codeでは、サブエージェントファイル内でhaikuというエイリアスではなく、model: claude-haiku-5-5と完全なIDを指定してください。また、組み込みのExploreサブエージェントはHaikuではなく、メイン会話のモデルで動作することを忘れないでください。Sharklyでは、安価なAgentはCustom argumentsの設定で切り替えられるため、両方の運用レーンで同一のComputerを共有できます。エージェントは調査、実行、テスト、報告を行い、人間は方向性を決め、権限を与え、成果物を承認します。
上位レイヤーからはサブエージェントが見えない
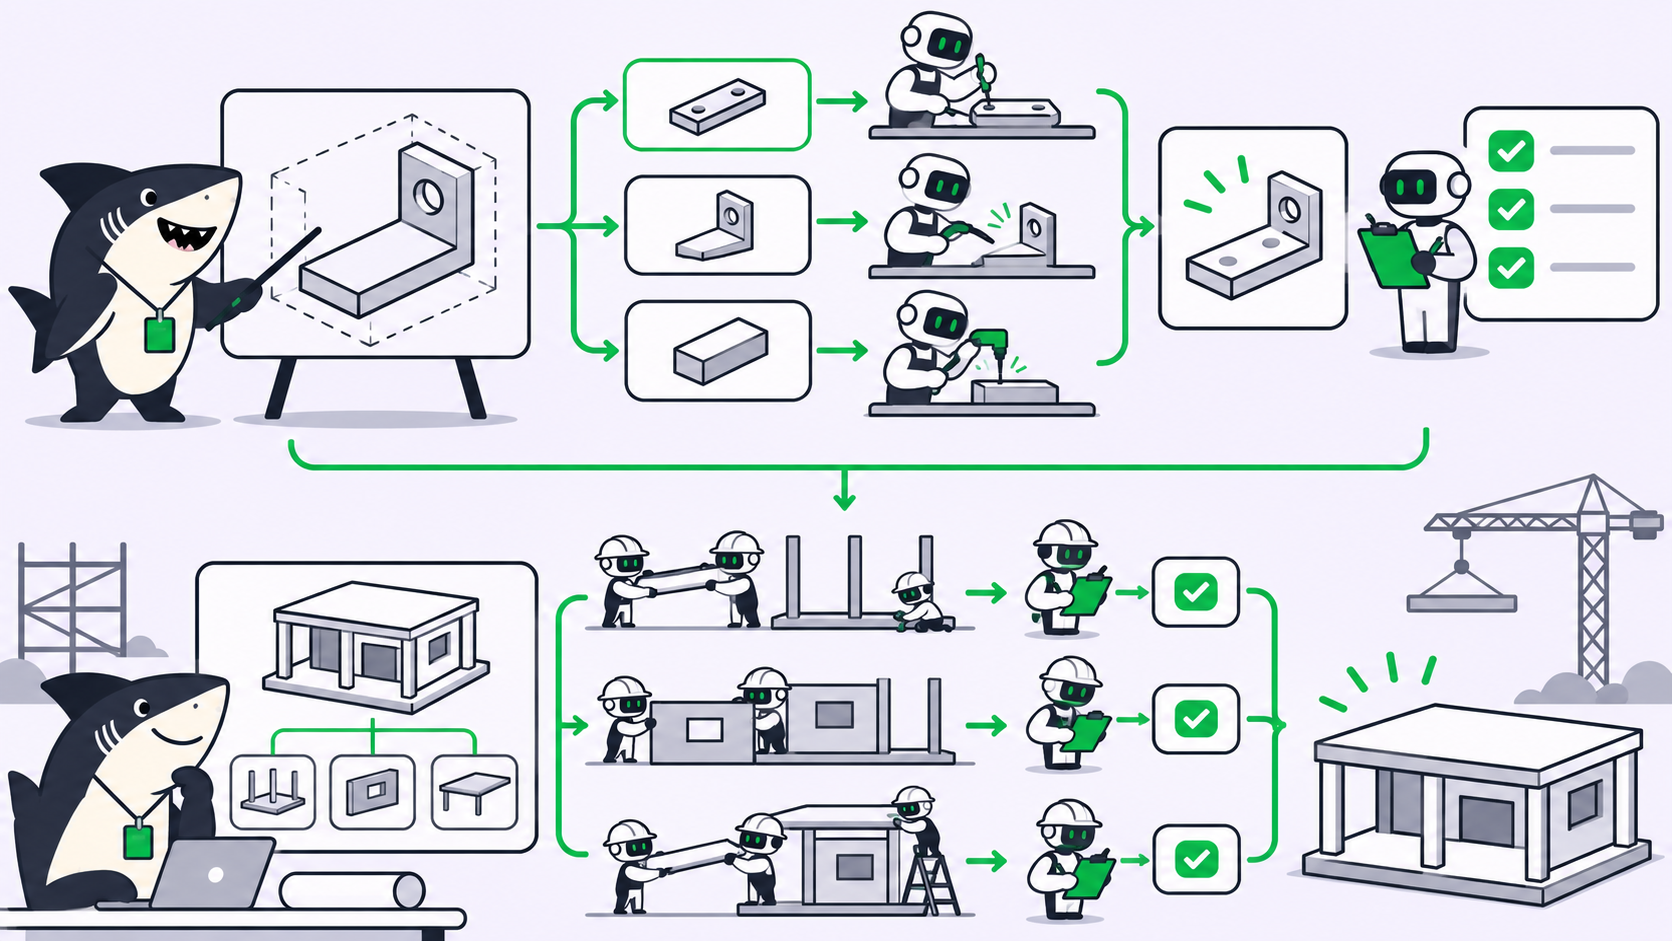
サブエージェントとは、リードエージェントが自身のセッション内で起動し、限定的な作業を任せ、その結果を読み取るアシスタントです。これは多くの業務にとって適切な設計であると同時に、ひとつの境界線でもあります。つまり、サブエージェントが行う処理はすべて単一の実行プロセス(run)の内部で完結するということです。
管理ボード側から見ると、マネージャーが問うべきあらゆる項目において、これら2つの配置手法には違いが現れます。
| 問い | 実行内のサブエージェントとしてのHaiku 5.5 | Taskを持つ独立AgentとしてのHaiku 5.5 |
|---|---|---|
| 成果物の責任者は誰か? | 暗黙的にリードエージェント | 明示的にTaskの担当者(Assignee) |
| 作業はどこに表示されるか? | リードエージェントの実行ログおよび最終回答の内部 | 独自のTask、実行状態、および実行ログ |
| 誰がチェックするのか? | 次のステップに進む前に、リードモデルが確認 | 承認前に、人間またはレビュアーが確認 |
| 失敗した場合はどうなるか? | リードエージェントが吸収するか、そのまま引き継ぐ | Task自体に失敗が表示される |
| 実行の途中で人間が介入・回答できるか? | 不可(リードエージェントとだけ対話する) | 可能(質問はTaskおよび受信トレイに返される) |
| セットアップのコストは? | リポジトリ内のファイル1つ | AgentとTaskの作成 |
この問題のCodex版については、以前このブログでも取り上げました。セッションが多数のサブエージェントにファンアウトされると、レビュアーの目には集約された1つの回答しか見えなくなります。Anthropicがまさにその用途に合わせて設計し価格を設定したため、Haiku 5.5ではこのトレードオフがより魅力的な選択肢に見えてしまいます。Rogo社のパターンがうまく機能するのは、リードモデルが売上高の行を受け取ってスライド資料内に落とし込み、外部に出る前に人間がその成果物をレビューするからです。仮にサブエージェントに誤りがあっても、そのレビューの中で表面化します。
では、同じモデルを出力そのものが成果物となるタスク(マイグレーション、設定変更、データ修正、顧客への返信など)に適用したらどうなるでしょうか。サブエージェントとして実行させた場合、その作業はリードエージェントの要約の一部としてしか管理ボードに届きません。diff(差分)のどの部分が安価なモデルによって生成されたのかは誰にも分からず、Taskを承認する人間は、誰が作成したのか追跡できない作業を承認することになります。
明文化された判断ルール
Lunaに関する一連の記事では、どのような作業を安価なモデル層に割り振るべきかについて、「難易度ではなく検証可能性でルーティングせよ」と結論づけました。Haiku 5.5はそこに第2の評価軸を加えます。作業が十分に安価になったら、「その出力を誰が消費するのか」によって配置場所を決める必要があります。
Haiku 5.5 placement rule

In-run subagent when ALL of these hold:
  - the output is read by the lead agent, not shipped
  - the lead checks or uses it before continuing
  - a wrong answer shows up downstream, inside reviewed work
  examples: file lookups, codebase exploration, log and doc summaries,
            classification, pulling one fact from a long document

Own Agent and own Task when ANY of these hold:
  - the output ships (a diff, a message, a record, a submitted form)
  - a person has to accept it
  - it can fail, stall, or need a human answer independently
  - you want its acceptance rate measured separately from the lead's
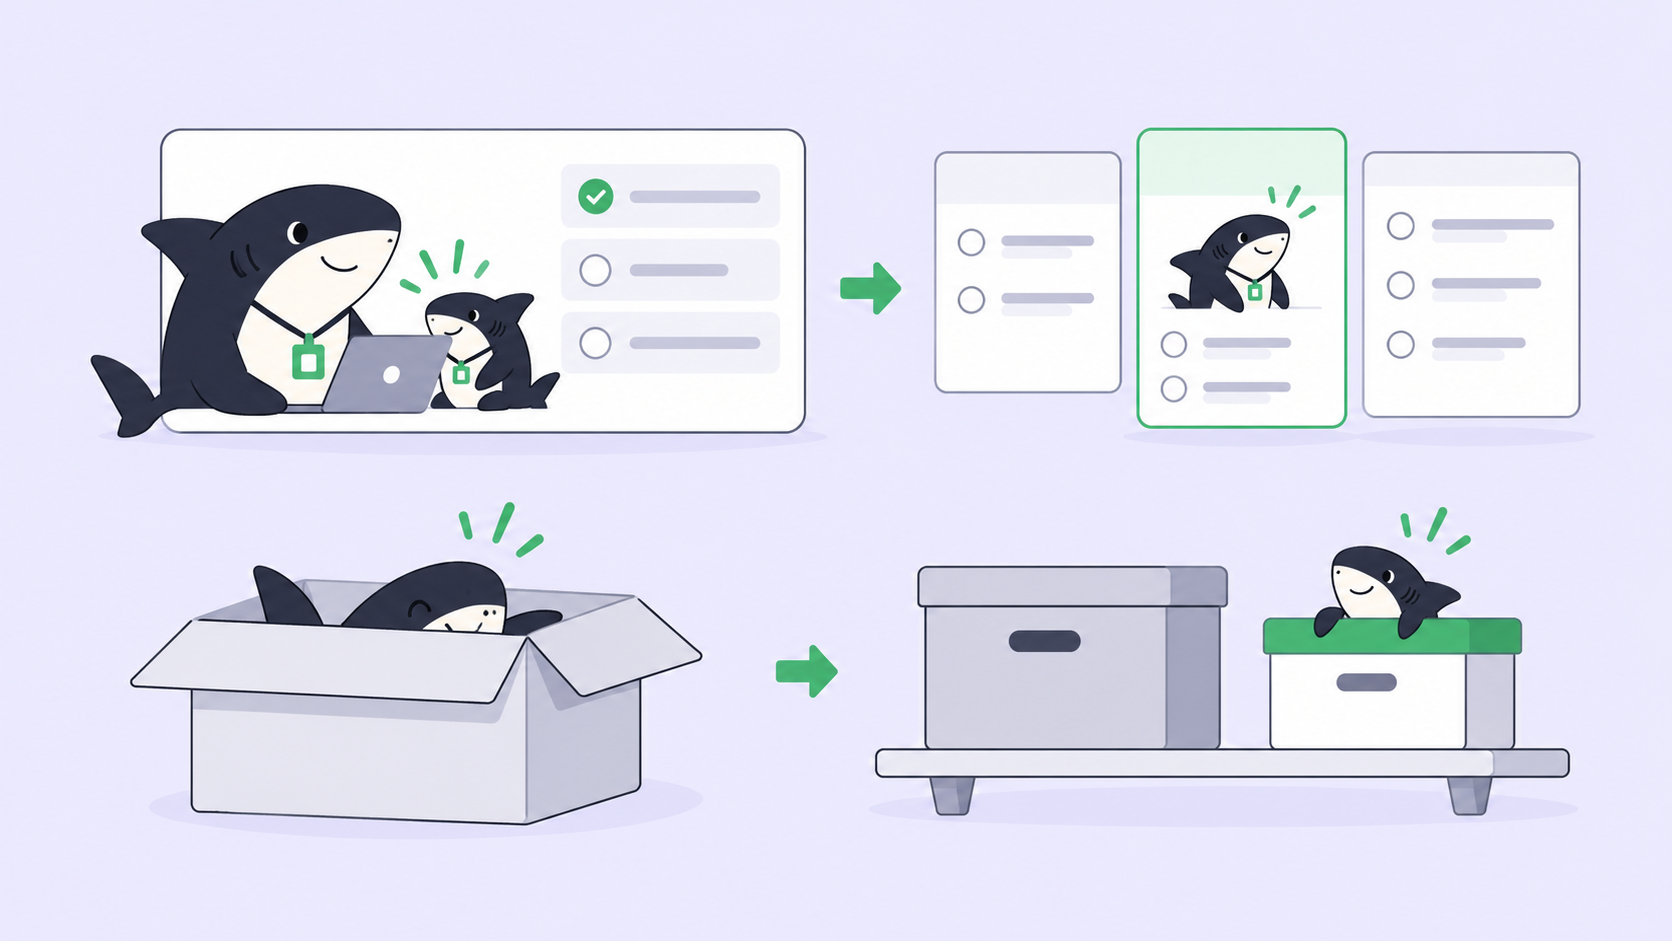
リードエージェントが必要とする1つの答えに作業が集約される場合は、サブエージェントを使用してください。チームが担当者の名前を紐づけて管理したいような作業には、独立したTaskを使用してください。
Sharklyには中間的な選択肢もあります。Crew機能では、リーダーAgentが特定の作業のためにメンバーAgentをメンションし、指名されたメンバーは同じTask上で実行されてそのチャットに結果を追加します。Haiku 5.5のメンバーは独自のTaskを立てることなく、同一Task上で可視化されます。1人の人間が統合された結果全体を承認する場合は、これを利用してください。異なる担当者が別々の部分をレビューする場合は、独立したTaskに分割してください。
両レーンの設定方法
どちらのレーンにも、設定ミスを起こしやすい注意点が1つずつあります。
Claude Codeにおけるサブエージェントレーン。 Claude CodeでHaiku 5.5を使用するには、v2.1.293以降が必要です。サブエージェントのドキュメントによると、サブエージェントのmodelフィールドにはsonnet、opus、haiku、fable、完全なモデルID、またはinheritを指定できます。ここでは完全なIDを固定して指定してください:
---
name: lookup
description: Find files, symbols and config values. Read-only.
model: claude-haiku-5-5
---
Answer with paths and line numbers. Do not edit files.
エイリアスの使用には落とし穴があります。モデル設定ドキュメントによると、haikuがHaiku 5.5として解決されるのはAnthropic APIのみです。Amazon Bedrock、Google Cloud、Microsoft Foundry、およびClaude Platform on AWSでは、依然としてHaiku 4.5として解決されます。異なるプロバイダのComputer間でサブエージェントファイルを共有していると、同じ名前でありながら異なる2つのモデルが実行されてしまう可能性があります。各ホストにおいてhaikuが何を指すか、そしてClaude Codeがバックグラウンド機能で何を使用するかは、ANTHROPIC_DEFAULT_HAIKU_MODELによって設定されます。
もうひとつの盲点は、組み込みのExploreサブエージェントがHaikuではなく、メイン会話のモデルを使用する点です。リードがOpus 5.5であれば、探索もOpus 5.5で実行されます。ドキュメント自体が推奨している回避策は、組み込み設定を上書きするExploreという名前のユーザーまたはプロジェクトのサブエージェントを作成し、model: haikuを指定して低コストなモデルで探索を実行することです。前述のファイルにその名前を付け、完全なIDを保持するようにしてください。
SharklyにおけるAgentレーン。 Sharklyはモデルを自動選択しません。Agentsのドキュメントには、「AgentはRuntimeのデフォルトモデルに従います。特定のモデル名を保証または表示することはありません。モデルを変更するには、AgentまたはRuntimeのCustom argumentsで指定してください」と記載されています。Agent上にモデル選択のドロップダウンや思考の深さ(thinking-depth)の調整コントロールはありません。そのため、安価なAgentを運用するには、同一のComputerおよび同一のClaude Code Runtime上に2つ目のAgentを作成し、リードAgentはデフォルトのまま維持しつつ、2つ目のAgentのCustom argumentsにclaude-haiku-5-5を指定します。公式セットアップガイドであるSharklyでClaude Haiku 5.5エージェントを実行する方法で、詳しい手順を解説しています。
Taskにはモデル名が表示されないため、安価なAgentの指示に「最終回答でモデル名を報告すること」という一行を追加してください。Claude Codeにおいて、Haiku 5.5はデフォルトでmediumエフォートに設定されており、思考プロセス(thinking)を無効化することはできません。したがって、そこで設定するエフォート値が各実行のコストを左右することになります。
10万トークンの価格分岐点がもたらす影響
配置の判断は、支払う価格の決定にも直結します。Haiku 5.5が100万トークンあたり0.10ドル/0.50ドルで済むのは、プロンプトが10万トークン以下にとどまる場合のみです。これを超えると、料金は5倍の0.50ドル/2.50ドルに跳ね上がります。Anthropicによると、Haiku 4.5へのリクエストの約90%はこの閾値以下に収まっていたとのことです。
サブエージェントの呼び出しは、この閾値内に収まりやすい形態です。指示は限定的で、読み込むコンテキストも短く、1つの答えを返して終了します。一方、長大なTaskに取り組む単独のAgentは、この閾値を超えやすい形態と言えます。Claude Codeは、Haiku 5.5のようなネイティブ1Mコンテキストモデルに対してデフォルトで約967Kトークンに達するまで圧縮を行いません。これは100Kを大幅に超過しているため、長期にわたるHaiku 5.5の実行では、後半ターンの大部分が高額な料金レートで消費される可能性があります。長いTaskへの対策は、リードの実行内に戻すことではなく、Taskを分割することです。
これにより、配置の二者択一にコスト面での明確な指針が生まれます。低価格レートを維持しやすい、短時間で読み取り主体の呼び出しには、実行内のサブエージェントを使用してください。出荷される成果物には独立したAgentを使用し、コンテキストの上限を迎える前に実行が完了するようTaskのサイズを調整しましょう。
変わらない2つのこと
Anthropicは能力の限界についても率直に述べています。複雑な自律型コーディングタスクにおいては、依然としてSonnet 5.5とOpus 5.5が「より優れた選択肢」であり、ローンチ時の比較表によると、最高エフォート設定でのTerminal-Bench 4.0のスコアはSonnet 5.5の70.6%に対し、Haiku 5.5は39.2%にとどまります。Haiku 5.5はワーカーやアシスタントであり、リードではありません。
そして、ワーカーが安価になったからといって、承認にかかるコストまで安くなるわけではありません。Haiku 5.5をサブエージェントとして実行する場合でも、独立したAgentとして実行する場合でも、成果物の責任者は必ず存在します。サブエージェントレーンはその責任者をリードの実行内部に隠してしまいますが、Agentレーンはそこに名前とステータスを明示します。中途半端な状態で実行が終了する可能性があるブラウザやデスクトップの作業において、この違いはあっという間に高くつくことになります。これについては、安価なブラウザエージェントとレビューキューで論じています。なお、同じ定価であるHaiku 5.5とGPT-6 Lunaのどちらを選ぶかという問題はまた別であり、同価格帯における2つの低コストRuntimeで解説しています。
この配置ルールを一度明確に定義し、リードが確認する情報検索にはサブエージェントを使い、実際に出荷される成果物にはすべて独自のTaskを与えましょう。すでに複数のエージェントを運用しているなら、Sharklyを使えばそれらのタスクと成果を一元管理できます。