
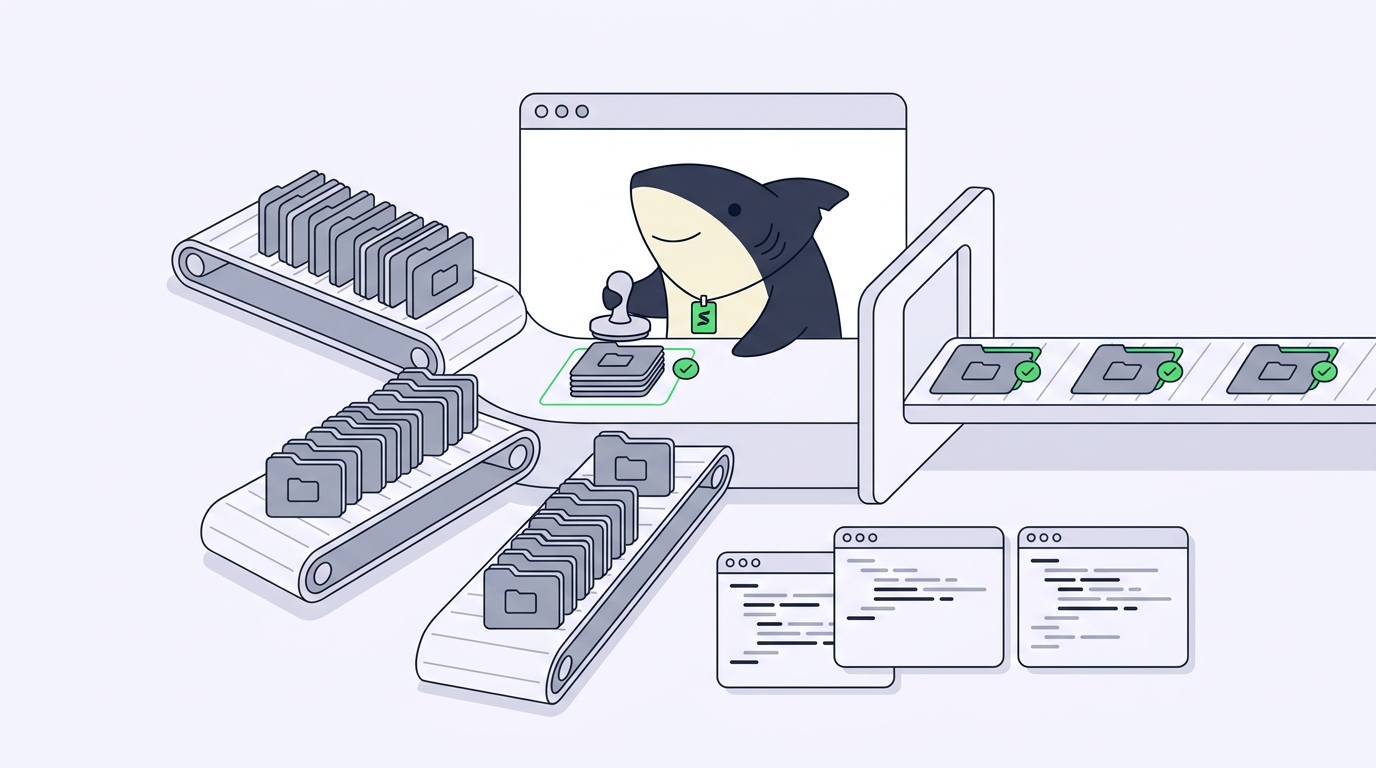
3つのコーディングエージェントを同時に走らせた最初の瞬間、ボトルネックは実行ではなくなります。バグをClaude Codeに、リファクタリングをCodexに、テストカバレッジの穴を3つ目のRuntimeに渡せば、40分後には3つのブランチが揃っています。しかしそこで本当の待ち時間が始まります。3つすべてがあなたを待っているからです。最初のdiffを読んで承認すると、残り2つはアイドル状態のまま。実行は並列、レビューは直列——これでは並列化の恩恵はほとんどありません。
これは、エージェントの並列実行に習熟したチームが必ず陥る罠です。ボトルネックは消えるのではなく、「エージェントがどれだけ速くコードを書けるか」から「人間がどれだけ速く結果を読み、判断し、受け入れられるか」へと移動します。4つ目のエージェントを追加すればさらに悪化します。完了した作業のキューが長くなるだけで、レビュアーは依然として1人だからです。
解決策は、レビューを速くすることでも、もっと信頼することでもありません。頭の中に置き去りにされた後回しの作業ではなく、ワークフローの明示的な一部としてレビューを設計することです。本記事でたどるのはそのワークフローであり、まさにSharklyが中心に据えて作られている課題でもあります。目標、diff、エビデンス、そして各エージェント実行のレビューを1つのTaskに保つことで、レビューキューは開きっぱなしのブラウザタブの山ではなく、目に見えて管理できるものになります。
並列エージェントがボトルネックをレビューへ移す理由
レビューはキューです。完了したエージェント実行はある割合で到着し、人間はある割合でそれを処理します。到着が処理を上回れば、キューは無限に膨らみます。話はこれで全部であり、だからこそエージェントの生のスループットは最適化すべき数字ではないのです。1時間に10個のエージェントが完了しても、あなたが1時間に注意深く受け入れられる変更が3つなら、荷役場にクリップボードを持った1人しかいない工場を作ったことになります。
ほとんどのツールはこれを覆い隠します。プルリクエストの山は作業を見せてくれますが、どの項目が本当に判断待ちなのか、まだ実行中なのか、すでにマージ済みなのかは分かりません。キューは実在しますが、タブと通知と記憶に分散しています。最初の設計目標はこれを可視化することです。見えないボトルネックは管理できないからです。レビュー容量の算術に関する関連記事では、並列度が上がったときに何が起こるかを掘り下げています。
運用モデル:誰が割り当て、誰が実行し、誰がレビューし、誰が受け入れるか
ステータスに手を付ける前に、4つの役割に名前を付けましょう。これらは別々の職務であり、混同することがレビューを混沌と感じさせる原因です。
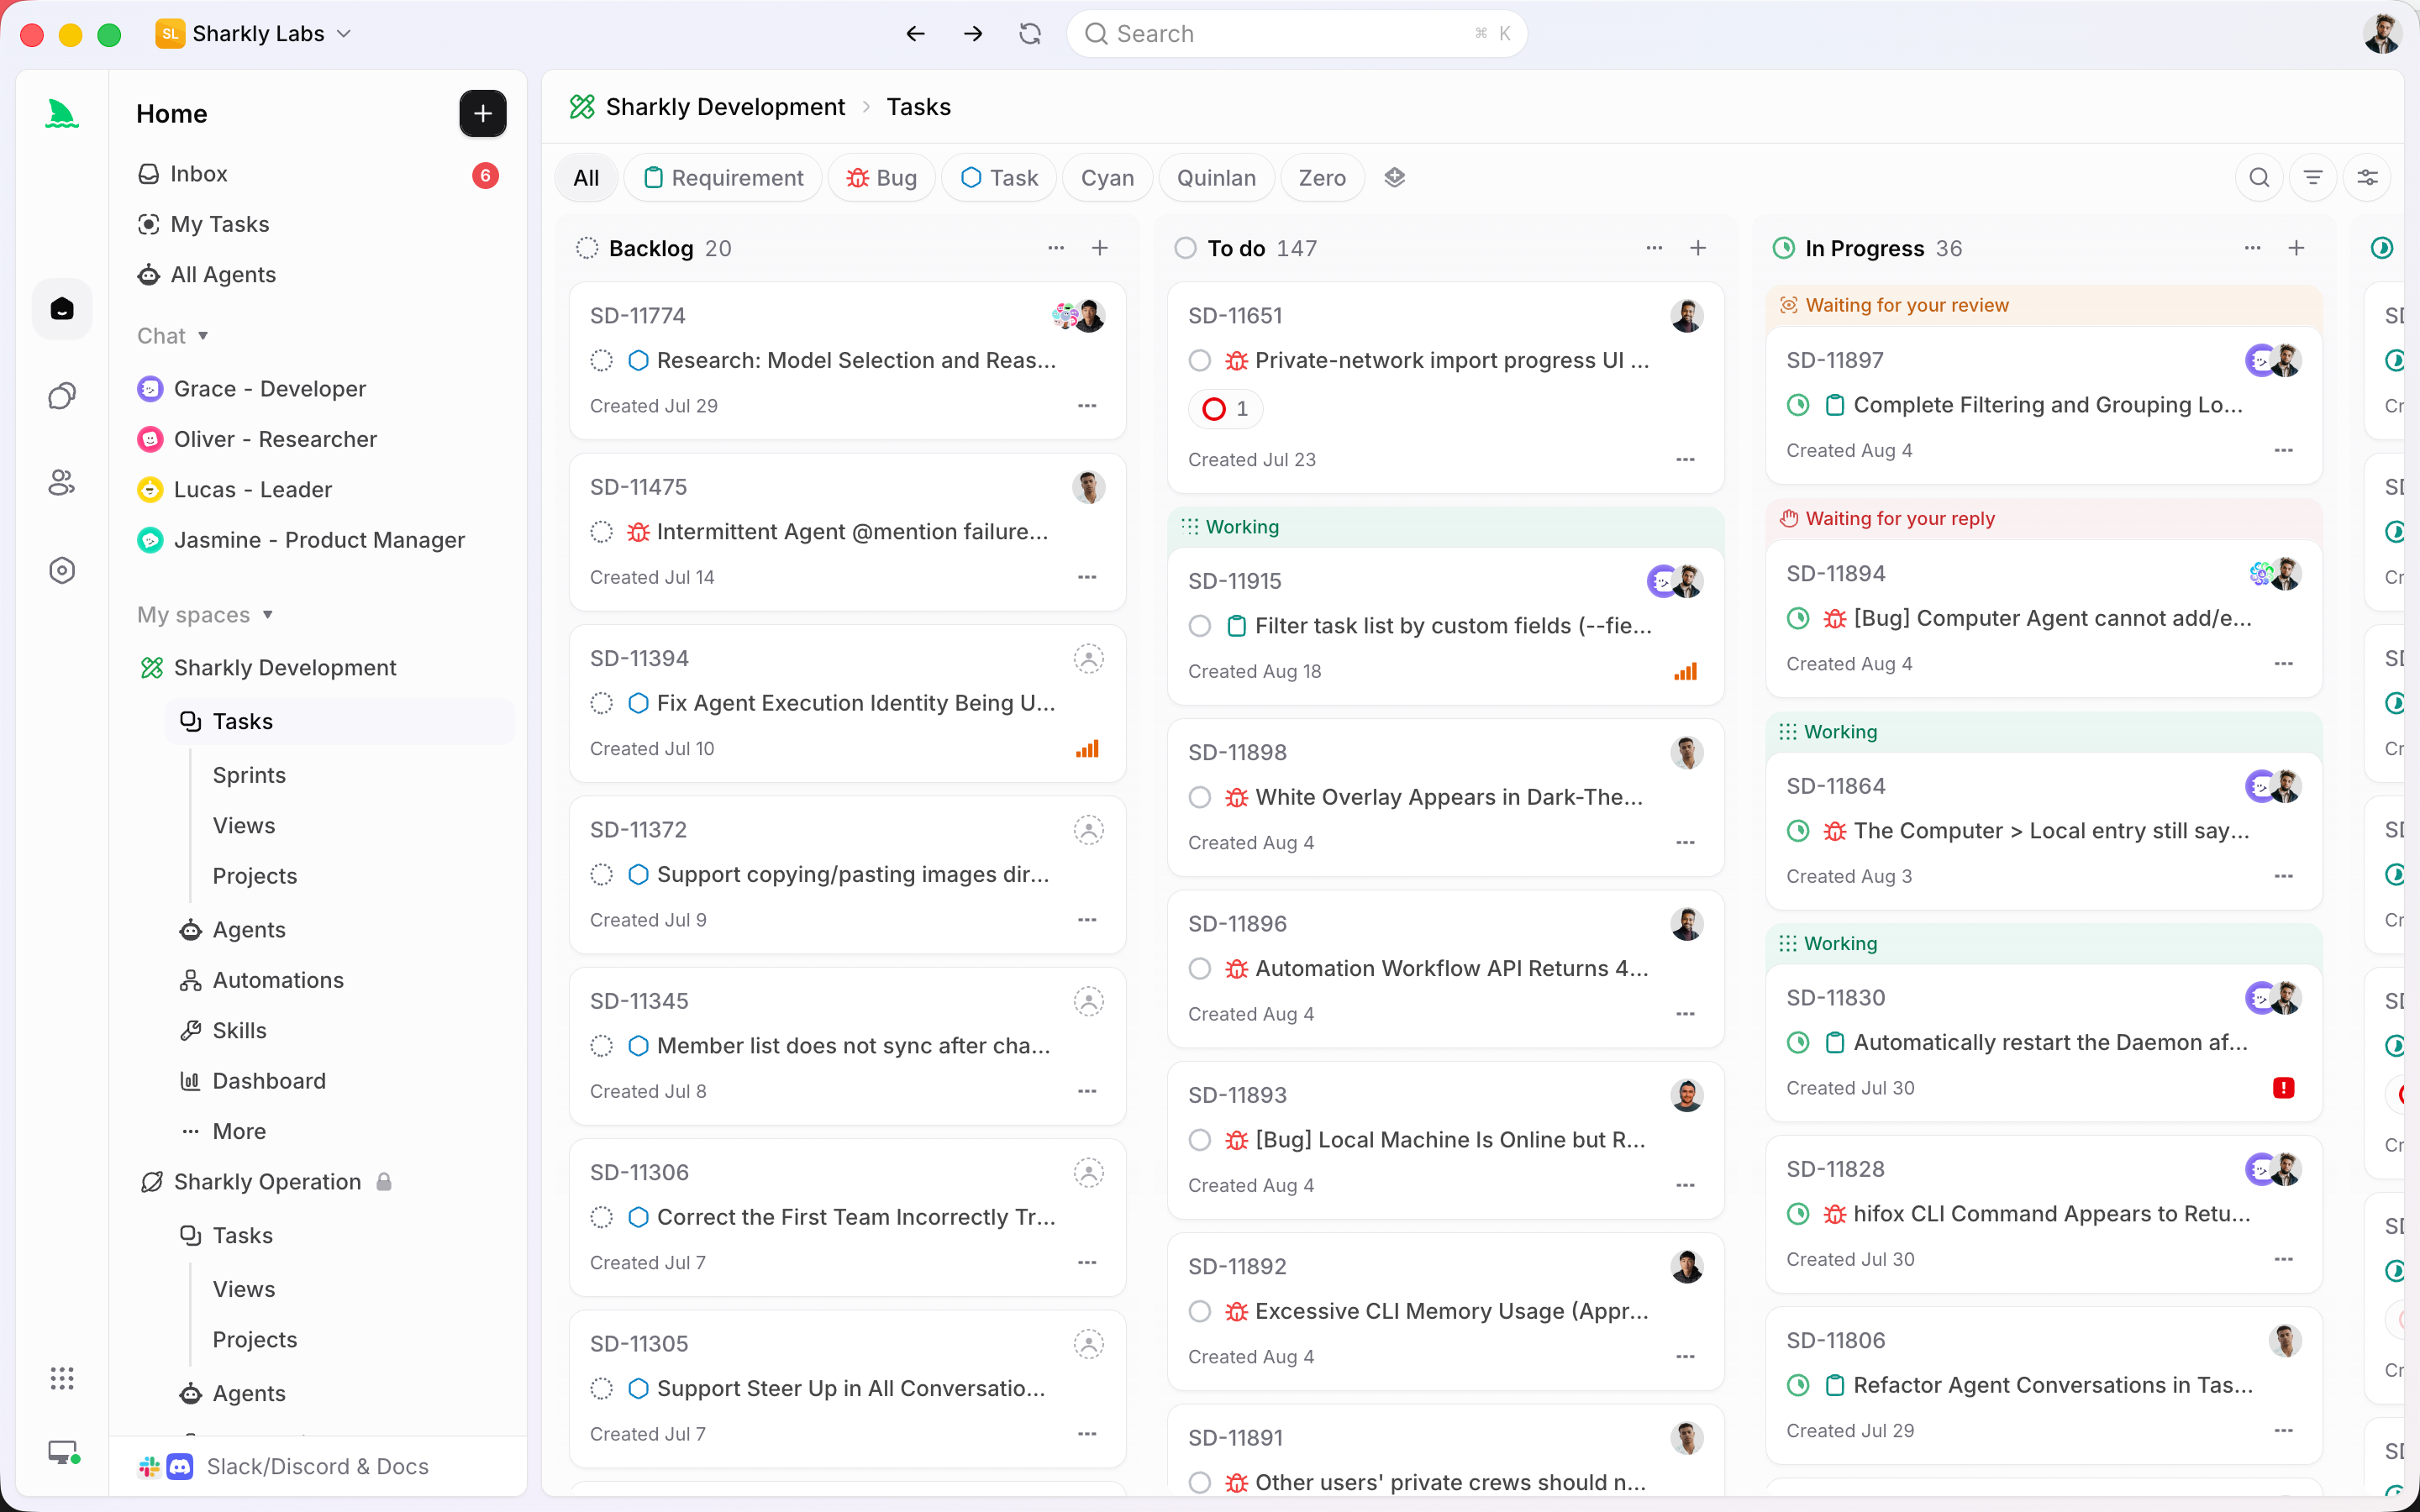
誰かが作業を割り当てます。意図を、受け入れ基準を伴うスコープの定まったTaskに変えるのです。何かがそれを実行します。AgentがComputer上で、Runtimeで実行し、変更と、何を行ったかの記録を生み出します。誰かが結果をレビューします。diffとエビデンスを読み、基準を満たしているかを判断します。誰かがそれを受け入れます。マージしてリリースする決断を下すのです。これは「コードは問題なさそうだ」とは別の判断です。
Sharklyはこの契約を、付箋に貼っておく価値のある一行で述べています。エージェントは調査し、実行し、テストし、報告する。人間は方向性を示し、権限を与え、結果を受け入れる。自動化はチームの判断が必要とされる場所で止まります。割り当てと受け入れは設計上人間の仕事です。実行はAgentの仕事です。レビューは、キューが形成される場所であるがゆえに、工学的に設計しなければならない職務です。
有用な境界線をひとつ。マージされたPRは、受け入れられた結果と同じものではありません。マージはgitの操作です。受け入れとは、その変更がTaskの求めたことを成し遂げたかを人間が判断することです。この2つが1クリックに集約されると、レビューの質はその瞬間にレビュアーが持っていた気力の分だけに落ちてしまいます。
役割、ステータス、レビューゲート
Taskに、エージェントと人間が行き来する少数のステータスを与えることで、キューに形を与えましょう。Taskは作業の主要な単位です。目標、会話、実行を保持します。ステータスの要点は、エージェントがTaskをレビューゲートの直前まで進められるようにし、それを越えられるのは人間だけにすることです。
| ステータス | ここへ移動させる人 | 意味 |
|---|---|---|
| Backlog | 人間 | スコープが定まり、未着手。ここでは実行は起きない。 |
| Ready | 人間 | 実行許可済み。Agentが引き受け可能。 |
| In progress | Agent | 実行が分離されたworktreeで進行中。 |
| Ready for review | Agent | 実行完了。変更とエビデンスが添付され、人間を待っている。 |
| Changes requested | 人間 | コメント付きで差し戻し。フォローアップ実行が同じTaskで継続する。 |
| Done | 人間 | 受け入れ、マージ、リリース済み。 |
ゲートとは、Ready for reviewへの遷移と、Doneへの遷移のことです。エージェントは自力でゲートに到達できますが、通過はできません。この1つのルールが、10個のエージェントを安全に走らせることを可能にします。エージェントたちはReady for review列を並列で埋め、あなたは品質を正直に保てるペースでそれを消化します。列の長さこそが、可視化されたボトルネックなのです。
ここで正直な判断のペアを示します。ユーザーに出荷される変更、あるいは金銭・認証・データ移行・パブリックAPIに触れる変更にはすべてゲートを設けましょう。使い捨てのスパイク、どうせ再生成する定型のボイラープレート、まだ誰も到達できないフラグの裏側の作業にはゲートを設けないこと。何にでもゲートを設けると、人間を必要としなかった変更のためにボトルネックをレビュアーへと押し戻すだけです。承認ゲートでは、よりリスクの高い作業のどこで止めるべきかを扱っています。
スケールするようにレビューを設計する
並列エージェントの出力をレビューすることは、チームメイトのPRをレビューすることとは同じではありません。量は多く、バースト的に到着し、どう作られたかについて知っていることはしばしば少ないのです。3つの動きが、レビュアーの項目あたりのコストを下げます。
エビデンスは記憶ではなくTaskに添付しましょう。実行は、変更の概要、型チェックとテストの出力、ビルド結果、既知の限界を、すべて記録として返すべきです。Ready for reviewの項目を開くとき、あなたが読んでいるのは事件ファイルであり、何が起きたかを再構築しているのではありません。これがタスクレベルのエビデンスでレビューすることと、信頼を取り戻すために自分で全部を再実行することとの違いです。
キーストロークではなく、判断をレビューしましょう。機械でチェックできる性質、フォーマット、型安全性、テストが通るかどうかは、Taskがあなたに届く前に機械でゲートすべきです。Googleのコードレビューのガイドラインも同じ分け方をしています。ツールが検証できるものは自動化し、人間は設計と適合性に注意を注ぐのです。あなたの希少な判断力は「これは正しい変更か」に向けられるべきで、「コンパイルが通ったか」ではありません。
進行中の作業に上限を設けましょう。In progressに同時に置けるTaskの数に厳格な制限を設けることで、Ready for review列が決してスケールしない壁になるのを防げます。これはエージェントに適用したカンバンのWIP制限の考え方です。5つがすでにあなたを待っているときに6つ目の実行を始めても、スループットは増えず、キューが隠れるだけです。また、実行中のエージェントを監視することも役立ちます。ゲートに到達する前に、詰まった実行と遅い実行を見分けられるようになるからです。
実例をひとつ、チケットからマージ済みPRまで
実物らしいTask、SH-312を取り上げましょう。「パブリック検索エンドポイントにレート制限をかける」。人間がBacklogで受け入れ基準(キーごとに毎分Nリクエストを超えたら429、ドキュメント化されたヘッダー、テスト)とともに形を整え、Readyに移します。
3つのAgentが同じSpaceで並列に作業しています。1つがSH-312を引き受け、設定されたリポジトリをComputer上にクローンし、分離されたworktreeで実行するので、そのブランチが飛行中の他の2つの実行と衝突することはありません。リミッターを書き、テストを追加し、型チェックとテストスイートを実行し、タイトルにTask IDを載せたPRを開き、変更の概要、通過したテスト出力、そして既知の限界を1つ記したうえでSH-312をReady for reviewに移します。その限界とは、カウンターがプロセス内にあり、インスタンス間で共有されていないことです。
あなたは15個のタブではなく、そのTaskを開きます。エビデンスはそこにあり、既知の限界の注記が役立つ部分です。テストは通っていますが、インスタンス間の共有状態はあなたが下すべき設計上の判断なのです。あなたはコメントを残してChanges requestedに移します。そのコメントが同じTaskでフォローアップ実行を開始し、Agentはカウンターを共有ストアに切り替えて、更新されたエビデンスを返します。今度はあなたが受け入れます。SH-312をDoneに移すのはあなたの判断であり、あなたの名前が付いたステータス変更として記録されます。gitマージの静かな副作用ではありません。
その間、他の2つのAgentはReady for reviewに座っています。キューが受信箱ではなく列であるおかげで、あなたは次にそれらを、順番に、流れを見失わずに消化します。
人間のために残す一線
並列エージェントは、レビューが制約になるまではスループットの話であり、それ以降は待ち行列の話です。多くのエージェントから価値を引き出すチームは、レビューを設計されたインフラとして扱います。明示的なステータス、エージェントが到達できても越えられないゲート、Task上のエビデンス、人間によるチェックの前の機械チェック、そして同時に進行できる量の制限です。
これをworktree、ブランチ命名規則、そして規律によって手作業で構築することもできます。あるいはSharklyにワークフローを任せることもできます。割り当て可能なAgents、実行とそのエビデンスを保持するTasks、そしてReady for reviewがあなたの消化する列となるボードを使えば、エージェントは調査・実行・テスト・報告を行い、人間は最後の判断を保持します。すでに複数のエージェントを走らせているなら、記憶に頼るのではなく、それらのタスクと結果を管理する1つの場所になります。
FAQ
レビューが直列なら、エージェントを並列で走らせても時間の節約になりますか? 完了した実行があなたの受け入れ速度を上回るまでは、節約になります。それを超えると、追加のエージェントはレビューキューを膨らませるだけで、何も早く出荷しません。利得は、レビューを可視化し、人間を必要とするものだけにゲートを設けることから生まれます。
エージェントの変更はすべて人間がレビューすべきですか? いいえ。ユーザーに出荷される変更、あるいは認証・データ・金銭・パブリックAPIに触れる変更にはゲートを設けましょう。低リスクまたは再生成可能な作業は、機械チェックのみで通します。何にでもゲートを設けると、人間を必要としなかった変更のためにボトルネックをレビュアーへと押し戻すことになります。
PRをマージすることは作業を受け入れることと同じではありませんか? いいえ。マージはgitの操作であり、受け入れとは、その変更がTaskの基準を満たしているかを人間が判断することです。この2つを分けておくことが、量が多いときにレビューの質を保ちます。人間の判断をどこに残すかについてはhuman-in-the-loopのコーディングエージェントをご覧ください。


