
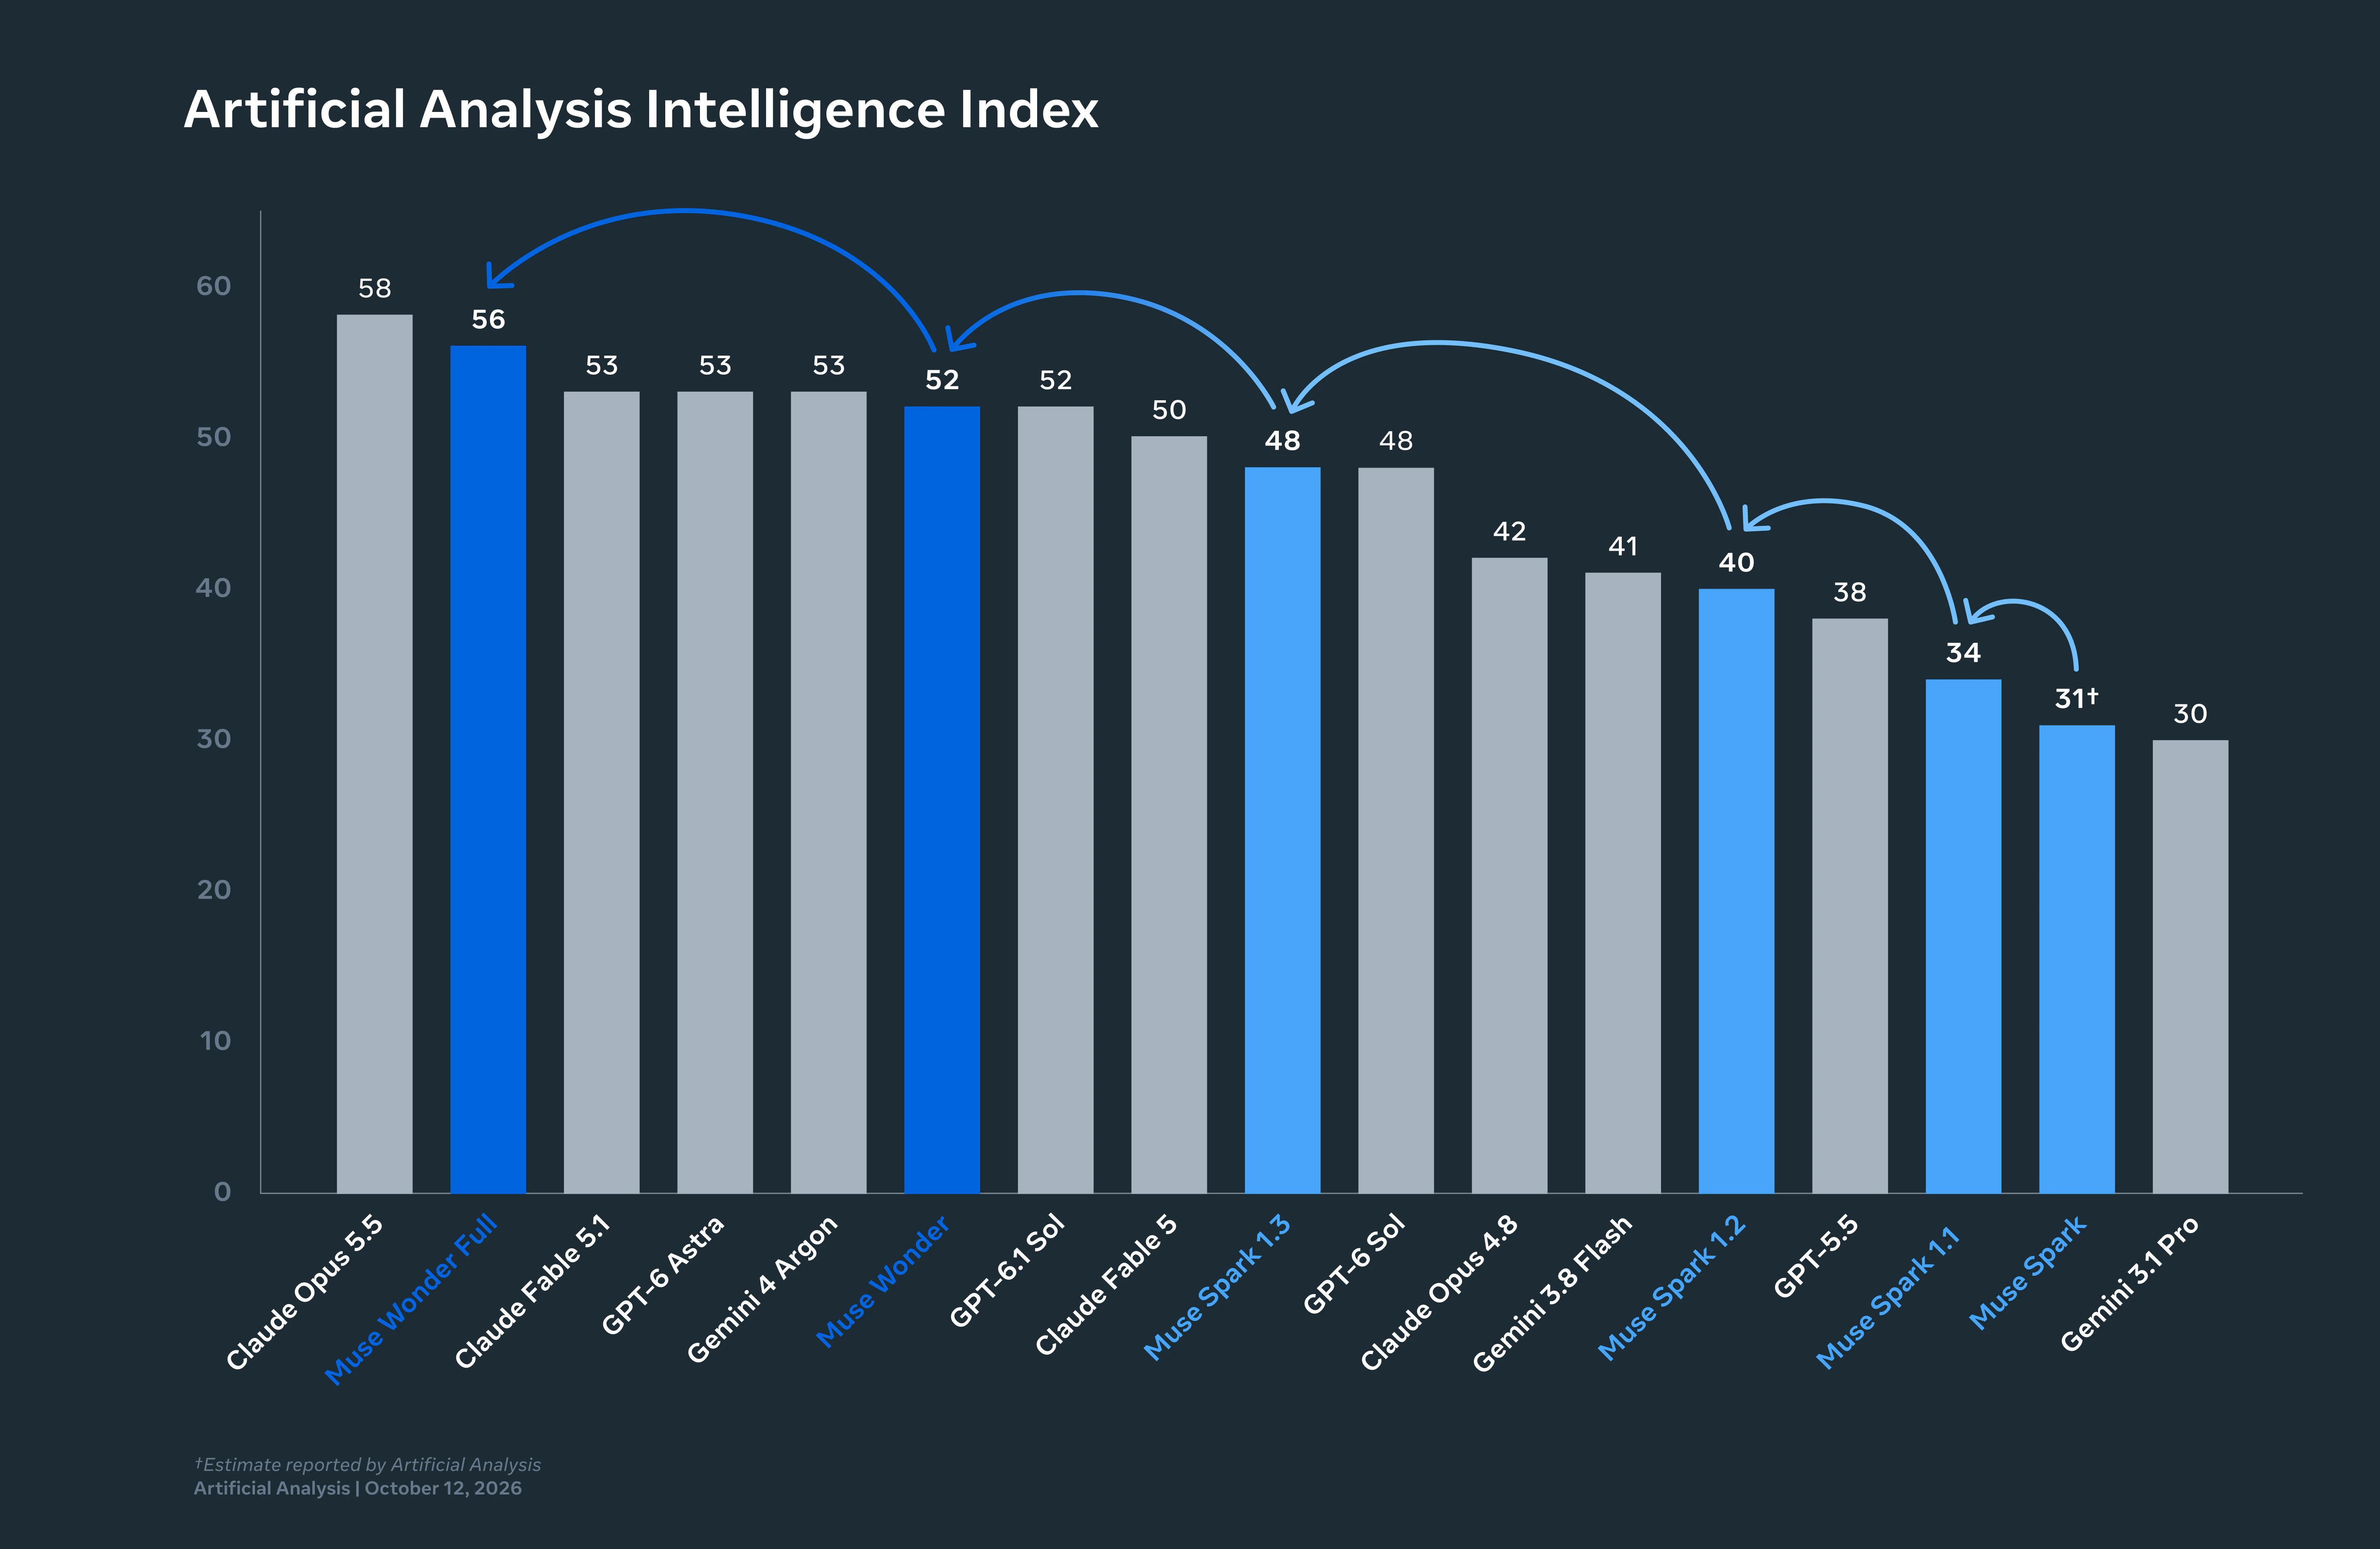
Muse WonderとClaude Opus 5.5の料金体系は同じで、入力トークン100万あたり4ドル、出力トークン100万あたり20ドルです。そのため、Crewにとってこの2つの選択は予算の問題ではなく、ルーティングルールの問題となります。Metaのモデルカードによると、長時間のコーディング作業を測定するベンチマーク(SWE-Marathon)ではWonderがリード(53.1対46.3)している一方、ターミナル作業(59.6対52.0)、総合的な知能(第三者機関のインデックスで58対52)、知識(46対25)ではOpusが上回っています。これら4つの数値は、特性の異なる2つのAgent像を描き出しています。デフォルトを1つ固定するのではなく、これらの数値に基づいてタスクを振り分ける(ルーティングする)ボードのほうが、双方の強みを最大限に引き出すことができます。
本記事では、これらの数値を実際のタスク割り当て方針へと落とし込みます。どのTaskをMuse Wonder Agentに任せ、どのTaskをOpus 5.5に残すべきか、それぞれがレビューキューにどのような影響を与えるか、そして運用開始から1週間後にそのルールが機能しているかをどう判断するかを解説します。なお、Metaレーンのセットアップ手順については「SharklyでMuse Wonderエージェントを実行する方法」をご覧ください。
ルーティングを判断するための重要指標
| 評価項目 | Muse Wonder | Claude Opus 5.5 | 出典 |
|---|---|---|---|
| SWE-Marathon(長時間コーディング実行) | 53.1 | 46.3 | Metaモデルカード |
| DeepSWE 1.1 | 78.8 | 74.2 | Metaモデルカード |
| Terminal-Bench 4.0 | 52.0 | 59.6 | Metaモデルカード |
| AA-Omniscience(知識量) | 25 | 46 | Artificial Analysis |
| ハルシネーション率 | 27% | AAランキングによるとより低い | Artificial Analysis |
| 知能指数(Intelligence Index) | 52 | 58 | Artificial Analysis |
| コーディングエージェント指数(Coding Agents Index) | 63 | 66 (Claude Code) | Artificial Analysis |
| インデックスタスクあたりのコスト | $4.52 | $5.98 | Artificial Analysis |
| 入力対応 | テキスト、画像、動画、音声 | テキスト、画像、PDF | ベンダー公式ドキュメント |
この表は、2つの異なるプロファイルとして読み取ることができます。Wonderは「粘り強く、出力が簡潔なためタスクあたりのコストが低く、知識の想起は弱めだが、動画や音声の入力を受け付ける」という特性です。Opusは「総合的な知能が高く、シェル操作に長けており、知識量が豊富だが、タスクあたりのコストは高め」という特性です。どちらか一方が優れているわけではなく、適したTaskが異なるのです。
Muse Wonder Agentに適したTask
共通するキーワードは「障害を伴う長期タスク」です。Metaはこのモデルを「Active Focus(能動的集中力)」と呼ばれる、別のアプローチを試しながら障害を乗り越える能力に特化して訓練しました。SWE-Marathonはまさにその能力を測定するために構築されたベンチマークです。
- テストスイートを常にグリーンに維持しながら進める複数ファイルのリファクタリング。 手順が多く、各ステップで検証が可能で、失敗した際には第2、第3のアプローチが求められるタスクです。
- 依存関係やフレームワークの移行。 アップグレード、破損、修正、再試行の繰り返しという典型的な長期タスクであり、11ステップ目になっても諦めない粘り強さがモデルに求められます。
- フレーキーテスト(不安定なテスト)を相手にした修正と検証のループ。 自身のコードによるバグなのか、テストスイート自体の問題なのかを見分ける必要がある実行です。
- 動画や音声の入力を伴うTask。 バグの画面録画や、要件を話した通話の音声記録などです。Opus 5.5はこれらを直接入力として受け取ることができません。
実行プロセス自体が自律検証できるよう、受入条件を明確に記述してください。Wonderは「packages/api 内のすべてのテストがパスし、チェンジログにエントリが追加されていること」といった具体的なTaskで最大の真価を発揮します。逆に、「何をもって完了とするか」をモデル自身が判断しなければならない状況は最も苦手とします。
Opus 5.5に残すべきTask
- ターミナル操作が中心の作業。 インフラ構築スクリプト、デプロイパイプライン、エージェントがシェル内で常駐して作業するようなあらゆるタスクです。Terminal-Benchにおける7.5ポイントの差は無視できない実力差です。
- 事前の知識量に依存するあらゆるタスク。 Omniscienceのスコア(Wonderの25対Opusの46)が示す通り、Wonderは事実を見落とす確率が約2倍高くなります。初見のライブラリAPI、マイナーなエラーコード、特定のドメイン知識などについて、Wonderがドキュメント検索や推測に頼らざるを得ない場面でも、Opusは記憶に基づいて即座に回答できます。
- レビュアー役。 他のAgentが作成したdiffを読み、それが正しいかを判断するAgentには、手持ちの中で最も知能の高いモデルを据えるべきです。総合インデックスで見ればそれはOpusであり、「複数モデル混成のCrewパターン」でもすでに高コストなモデルをそのポジションに配置しています。
- 短時間で完結するシャープなTask。 DeepSWEでは両者の差はわずかですが、総合知能ではOpusがリードしています。実行時間が10分程度で済むのであれば、Wonderの持つ「粘り強さ」という利点は現れません。
レビューキューに与える影響
ルーティングの変更は、レビュアーの目の前に届く成果物の質と形を変えます。そして、それこそが真のコスト要因となります。
長期TaskにおけるWonderの実行は、より長い試行錯誤のプロセス(より多くの試行、巻き戻されたアプローチ、多くのコミット)を生み出します。これはモデルが粘り強く責務を果たしている証拠ですが、裏を返せばdiffを見るだけでは全容が掴めないことを意味します。レビュアーは実行ログを確認する必要があるため、Agentの指示書には「試行した内容の記録を継続的に残すこと」を含めておく必要があります。「人間のレビューこそがボトルネックである」という原則は、ここではさらに強く当てはまります。粘り強いモデルは、1タスクあたりにレビューすべき分量を減らすどころか、むしろ増やすのです。
Wonderの知識不足は、「自信満々に提示される誤った詳細情報」として現れます。存在しないフラグや、2バージョン前に名前が変わったメソッドなどです。Artificial Analysisの測定によるハルシネーション率27%は同クラスのモデルとしては低い部類ですが、27%は決してゼロではありません。確信が持てない事項は必ずリポジトリ内で確認すること、そして確認できなかった場合はその旨を明記することをAgentに指示し、レビュアーにはまさにその箇所をスポットチェックさせましょう。
同じTaskをOpusに実行させると、より短く的確なプロセスを辿る傾向があり、タスクあたりの請求額は高くなります。その代わり、1回の実行あたりのレビュー負荷は軽くなります。ただし、Taskが長期にわたり障害が多い場合、Opusは途中で匙を投げて停止してしまう可能性が高くなります。その結果、「中途半端な状態で戻ってきて、スコープの再定義が必要なTask」という、別の種類の負担がキューに溜まることになります。
タスク振り分けの実例3選
具体的な実例を見ることで、タスク割り当て時にルールを適用しやすくなります。
「全サービスにわたってORMをv5からv7にアップグレードし、すべての統合テストをパスさせる」 —— Wonderが適任です。何十ものステップがあり、各段階で新たなテスト失敗が発生し、かつ明確なゴールラインが存在します。モデルの粘り強さが最大の武器となり、実行プロセス自体が受入条件を自己チェックできます。
「新しいステージング環境用のTerraformを作成してapplyを実行する」 —— Opusが適任です。シェル操作が多く、インフラ固有の知識が求められ、重大な影響を伴うアクションです。Terminal-BenchのスコアからもOpusが適格です。また影響範囲の大きさを考慮すると、どちらのモデルを採用するにせよ、apply の前に一旦処理を止めて人間に確認を求めるべきです。
「決済Webhookが二重発火する原因を究明し、修正案を提案する」 —— 原因究明と説明にはOpusが適しています。決済プロバイダーのリトライ仕様を理解しているかという「知識の想起」に依存するためです。提案された修正案がテストを伴う複数ファイルの変更に発展した場合は、そのフォローアップTaskをWonderに回すとよいでしょう。
基本パターンは、「明確なゴールラインによって定義されるTaskはWonderへ、事前に知っておくべき知識によって定義されるTaskはOpusへ」です。両方の要素が含まれるTaskは分割してください。Sharklyはまさにそうしたタスク分割を前提に設計されており、レーンごとにAgentあたり1つのTaskを割り当て、引き継ぎ内容は誰かの頭の中ではなくボード上に記録されます。
両モデルを並行運用し、結果を評価する
このルールをボードに適用して1週間運用し、実際のTask結果から判断してみましょう。
- Muse Wonder Agentを新規作成し、Opus 5.5 Agentもそのまま残します。SharklyのUI上にはモデルIDが表示されないため、両Agentの指示書に、レポートの冒頭にモデルIDを記載するよう設定しておきます。
- 個人の好みではなく、上記のルールに従って割り当てます。障害が多く長期にわたるタスクはWonderへ、ターミナル操作や知識が必要なタスクはOpusへ、そしてレビュー役はOpusへ割り当てます。
- 1週間後、各Agentが完了したTaskを抽出し、「成果物ではなく質問が返ってきた回数」「2回目の再実行が必要だった回数」「発生したレビューコメントの数」の3項目を集計します。
もしWonderの長期Taskが少ない再実行回数で完了し、OpusのターミナルTaskが少ない修正回数で完了していれば、そのルールは正しく機能しています。逆に、WonderのTaskが再実行を削減した分以上にレビューコメントを増やしているようであれば、割り当てるタスクの範囲を絞り込んでください。表に記載された数値はベンチマークの平均値にすぎません。本当に重要なテストは、あなた自身の現場のTaskです。
これらによる追加料金がSharklyの請求に上乗せされることはありません。モデル利用料はComputerに設定されたMetaおよびAnthropicのAPIキー経由で直接課金され、定価設定も同一であるため、コストの差は実行ごとの usage ブロックに報告される消費量の違いのみとなります。
今月、モデルの勢力図が変化しました。しかし、リクエストからリリースに至るまで、コンテキスト、進捗状況、障害、成果物、そして人間によるレビューの可視性を保ち続ける重要性は変わりません。worktreeを使って手動でこの仕組みを構築することもできますし、Sharklyを使ってワークフロー全体を効率的に管理することもできます。


