

TL;DR
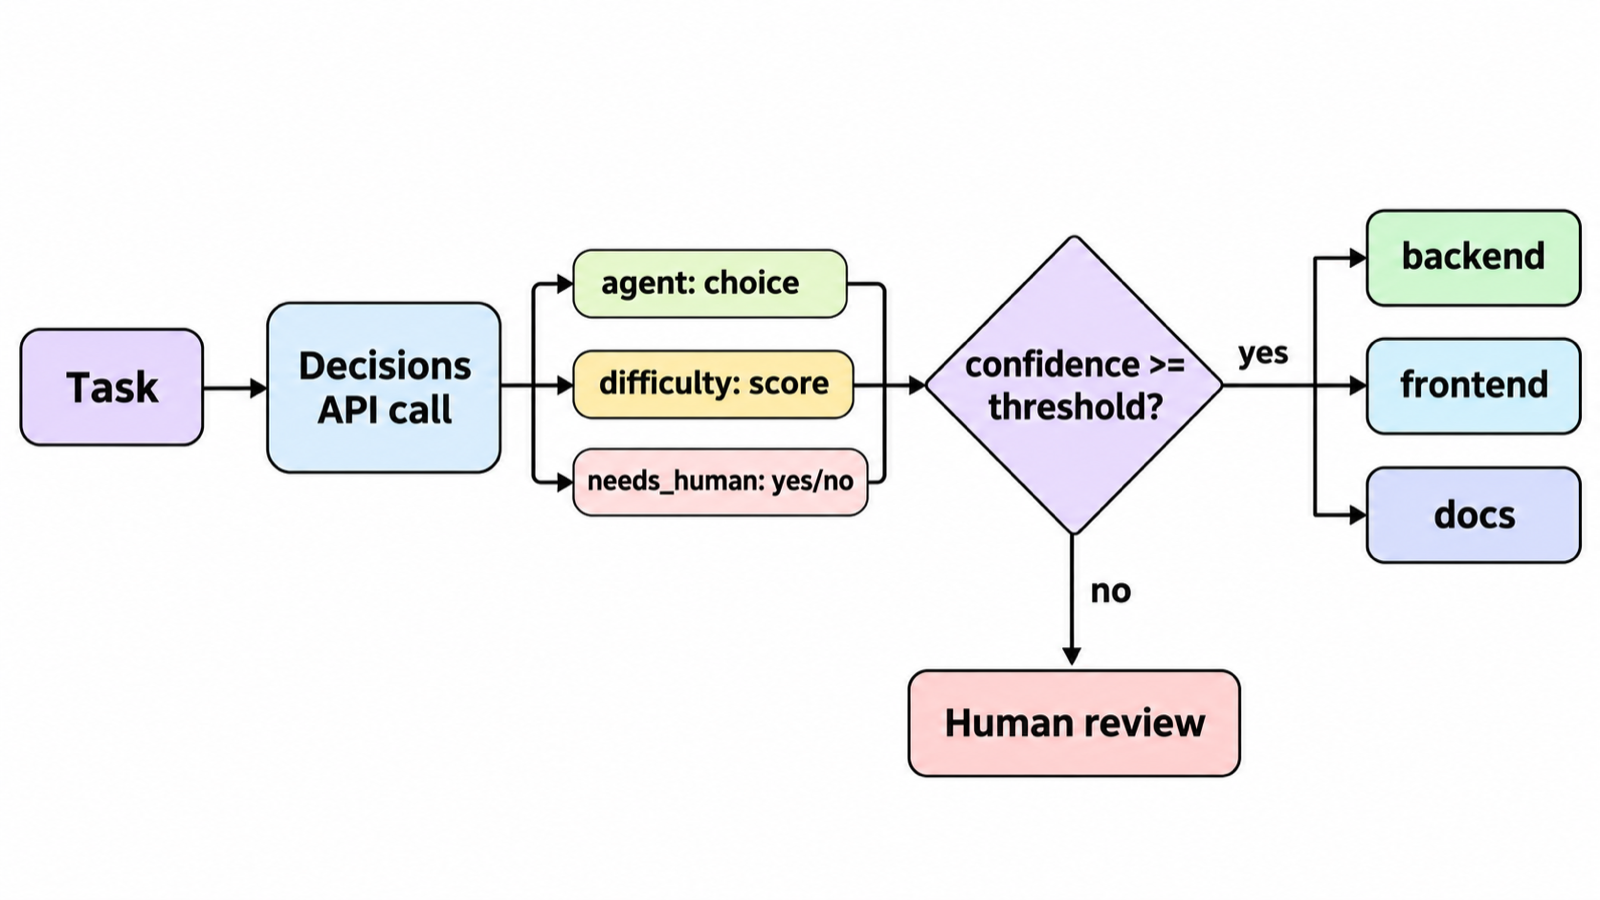
Gemini Decisions APIを使ってAIエージェントのタスクをルーティングするには、タスクのタイトルと説明を3つの質問とともにgemini-decision-1に送信します。担当エージェントを決定するchoice、難易度を評価するscore、そして人間による判断が先決かを判定するnoulです。確信度が設定したしきい値を超えた場合は自動でタスクを割り当て、それ以外はすべて人間の確認に回します。
はじめに
複数のコーディングエージェントを運用しているチームなら、誰もが同じ雑務に直面します。新規タスクを誰かが1件ずつ確認し、誰に割り振るかを判断しなければならないという作業です。バックエンド用エージェントか、それともフロントエンド用か? コストの低いモデルか、高性能なモデルか? すぐに着手できる状態なのか、それともまだ人間の意思決定が必要なのか?
Googleは2026年11月11日、まさにこの作業に特化したツールをリリースしました。Gemini Decisions APIは、テキストを生成する代わりに、クローズドクエスチョンに対してキャリブレーション(較正)済みの確率を返します。Google自身もGemini Notebook内部でこれを使用し、各クエリを適切なモデル層や思考レベルへと振り分けており、日常的なクエリのレイテンシを最大40%削減できたと述べています。
本記事では、エージェント管理ボード向けに同様のルーターを構築します。タスク1件につき1回のAPI呼び出し、3つの質問、1つのしきい値を用い、判定に確信が持てない場合はスムーズに人間へと引き継ぎます。実際に動かして試すボードが必要なら、Sharklyで無料から始められます。なお、ルーティングポリシーそのもの(どんなタスクに高性能モデルを充てるべきか)については、まずroute agent tasks by difficultyをご覧ください。本記事では、そのポリシーを適用するためのAPI呼び出しの実装を取り上げます。
Gemini Decisions APIの仕組みと機能
Gemini Decisions APIは、共有された入力に対して型付けされた質問を評価し、それぞれの質問に対する確率と確信度スコアを返すエンドポイントです。テキストを一切生成しないため、出力トークン数は常にゼロです。そのため、パース処理を挟むことなく、数値に基づいて直接コードを条件分岐させることができます。
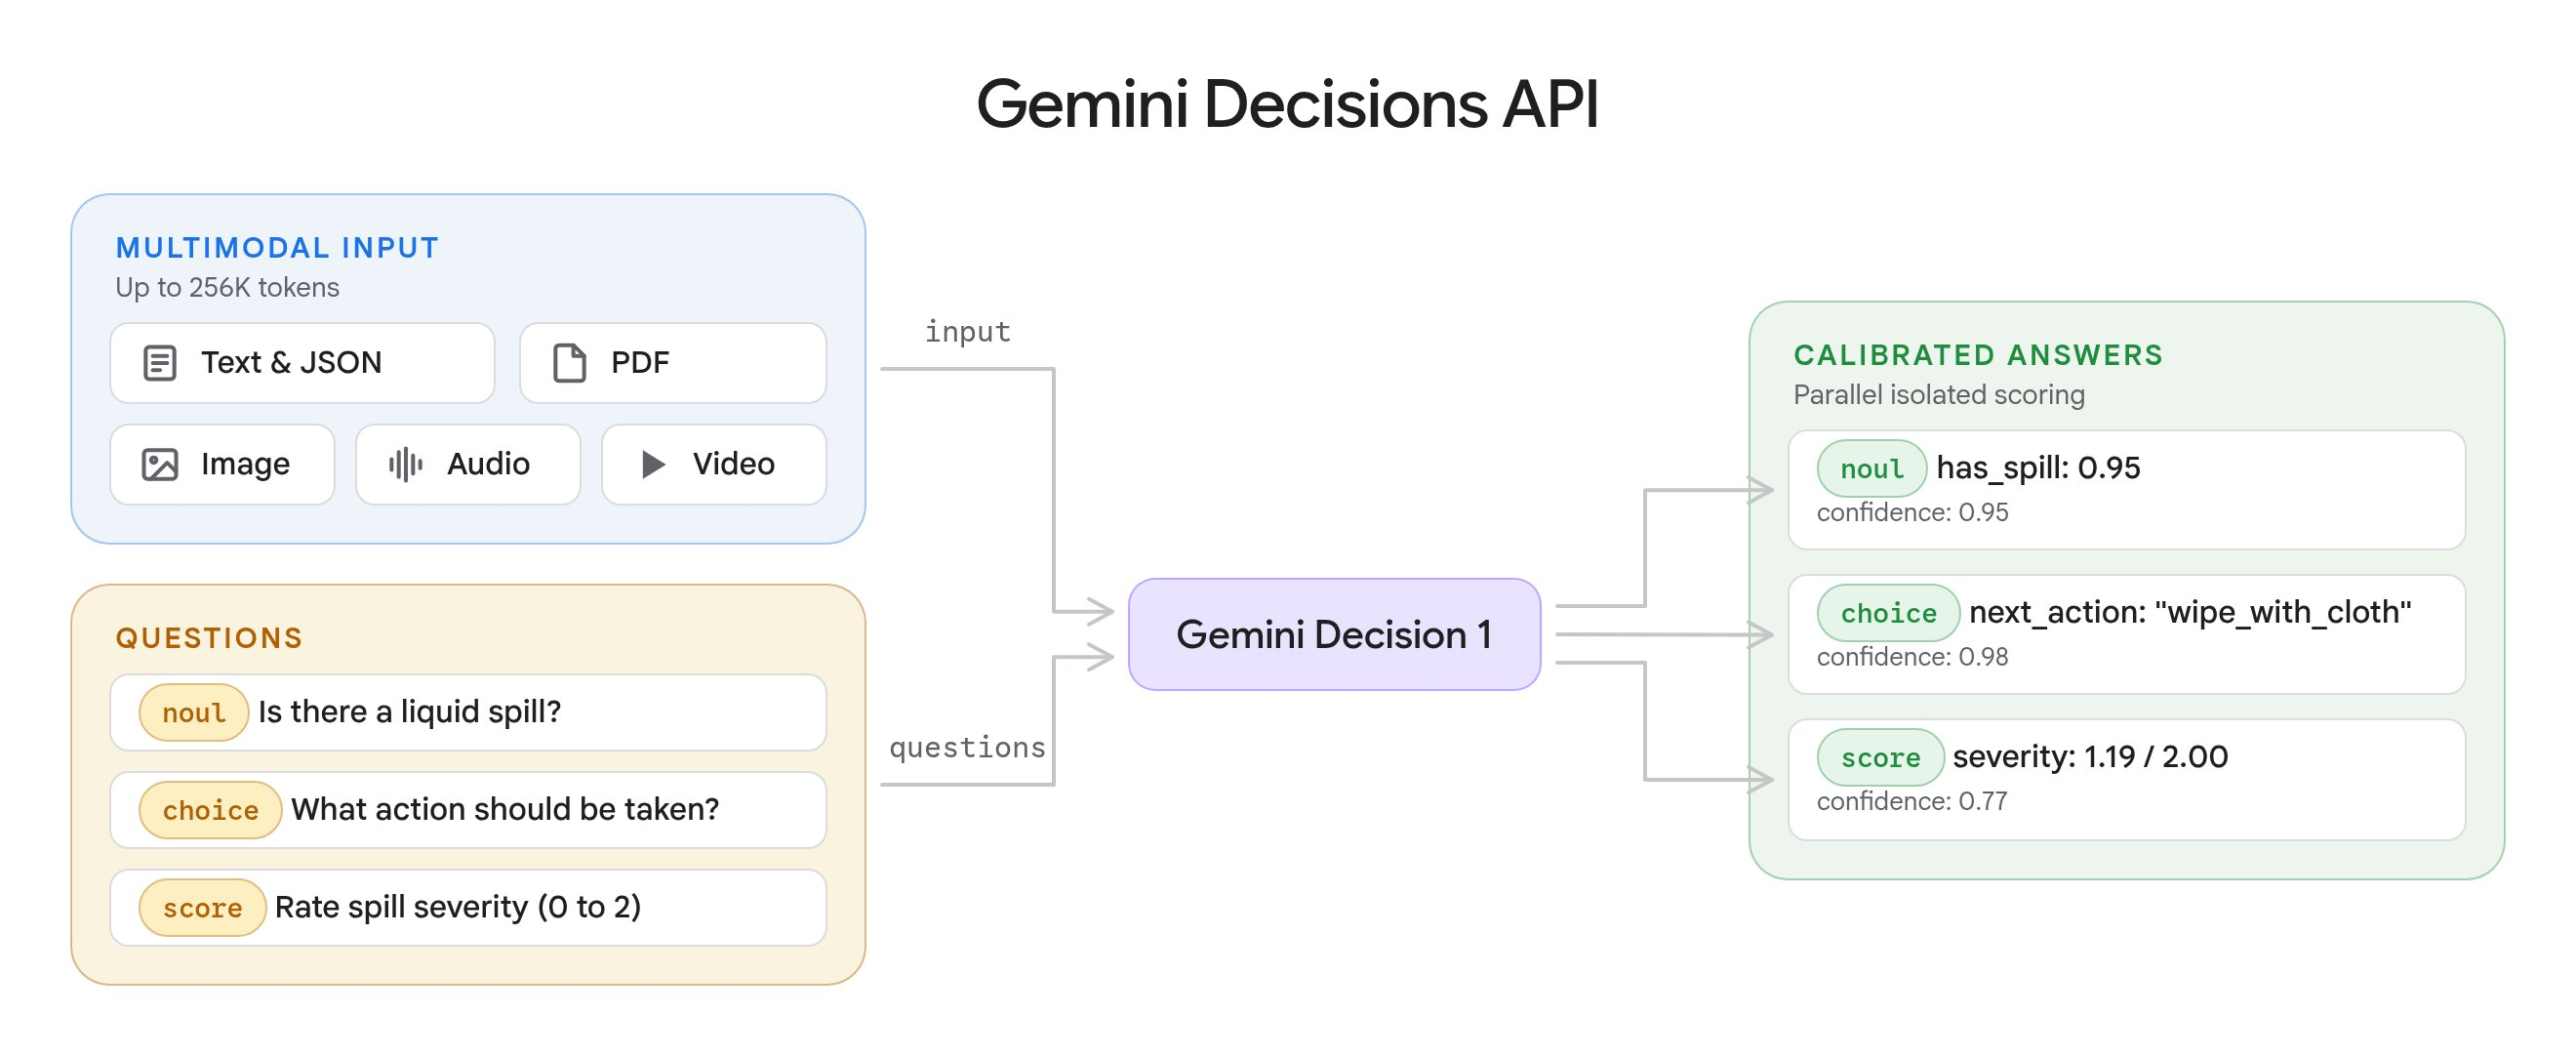
ルーティングは次の3つの質問タイプでカバーできます。
| タイプ | 判定する内容 | 返却される値 |
|---|---|---|
choice |
2〜255個の選択肢から1つを選択 | choice, probabilities, confidence |
score |
順序付き評価基準(ルーブリック)に基づくスコアリング | score, probabilities, legend, confidence |
noul |
Yes または No | noul (0.01 to 0.99), confidence |
1回のリクエストで、同一の入力に対して最大1,000個の質問を送信できます。Decisions APIの公式ドキュメントによると、質問は1回のフォワードパスで処理され、互いの質問を参照することはありません。そのため、質問を追加しても他の質問の回答が変わることはありません。Googleによると、エンドツーエンドのレイテンシは150〜250ミリ秒で、質問数が1個でも100個でもほぼ一定です。
以前公開したJev and decision models above coding agentsをお読みいただいた方には、馴染みのある構成かもしれません。今回の違いはより実用的な点にあります。Googleがホストするモデルを使い、3つの質問を定義し、それをタスク管理ボードへ連携させるという点です。
ルーティング呼び出しの実装:タスクあたり3つの質問
ルーターの実装コードは以下のとおりです。実行にはgoogle-genai 3.2以降と、Google AI Studioで取得したGEMINI_API_KEYが必要です。
import json
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

AGENTS = {
    "backend": "Server code, APIs, database migrations, and backend tests.",
    "frontend": "UI components, styling, client state, and frontend tests.",
    "docs": "README files, docs pages, and changelogs. No code changes.",
    "other": "Work that fits none of the options above.",
}

DIFFICULTY = [
    "Trivial: one file, obvious change, no design decision.",
    "Routine: a few files, follows a pattern already in the repo.",
    "Involved: several modules or a new pattern, needs new tests.",
    "Hard: cross-cutting, touches auth or data migrations, or the spec is thin.",
]

def ask(task):
    state = json.dumps({
        "title": task["title"],
        "description": task["description"][:8000],
    })
    result = client.decisions.create(
        model="gemini-decision-1",
        input=state,
        questions={
            "agent": {
                "type": "choice",
                "instructions": "Which agent should take the task in `title` and `description`?",
                "criteria": AGENTS,
            },
            "difficulty": {
                "type": "score",
                "instructions": "How hard is this task for a coding agent working alone?",
                "criteria": DIFFICULTY,
            },
            "needs_human": {
                "type": "noul",
                "instructions": "Does a person need to make a decision before any agent starts?",
                "criteria": {
                    "true_description": "The spec is ambiguous, contradicts itself, or asks for a product, security, or pricing call.",
                    "false_description": "The spec is clear enough to implement as written.",
                },
            },
        },
    )
    return result.answers
上記のコードには、ドキュメントに明記されているものの見落としやすい重要なポイントが4つあります。
モデルはキー名を認識しません。参照されるのはinstructionsとcriteriaのみです。そのため、instructionsに完全な質問文を記述し、すべての選択肢に説明を添える必要があります。
選択肢のキーはアルファベット順にソートされます。APIはスコアリングを行う前に、選択肢のキーをUTF-8バイト順で並べ替えます。その他をまとめるフォールバック用のキーをnone_of_the_aboveではなくotherにしているのはそのためです(none_of_the_aboveだと実際の選択肢よりも前にソートされてしまうため)。
スコアのレベルは線形(リニア)である必要があります。返されるscoreは各レベルのインデックス(今回の例では0〜3)の確率加重平均です。隣り合うレベル同士の違いが明確にわかるように定義してください。
質問の判定に必要な情報のみを送信してください。ドキュメントでも、無関係な情報を含めると精度が低下すると指摘されています。コメントスレッド全体を渡すよりも、タイトルと説明文だけを渡す方が通常は良い結果が得られます。
自社タスクの実績データから確信度のしきい値を決める
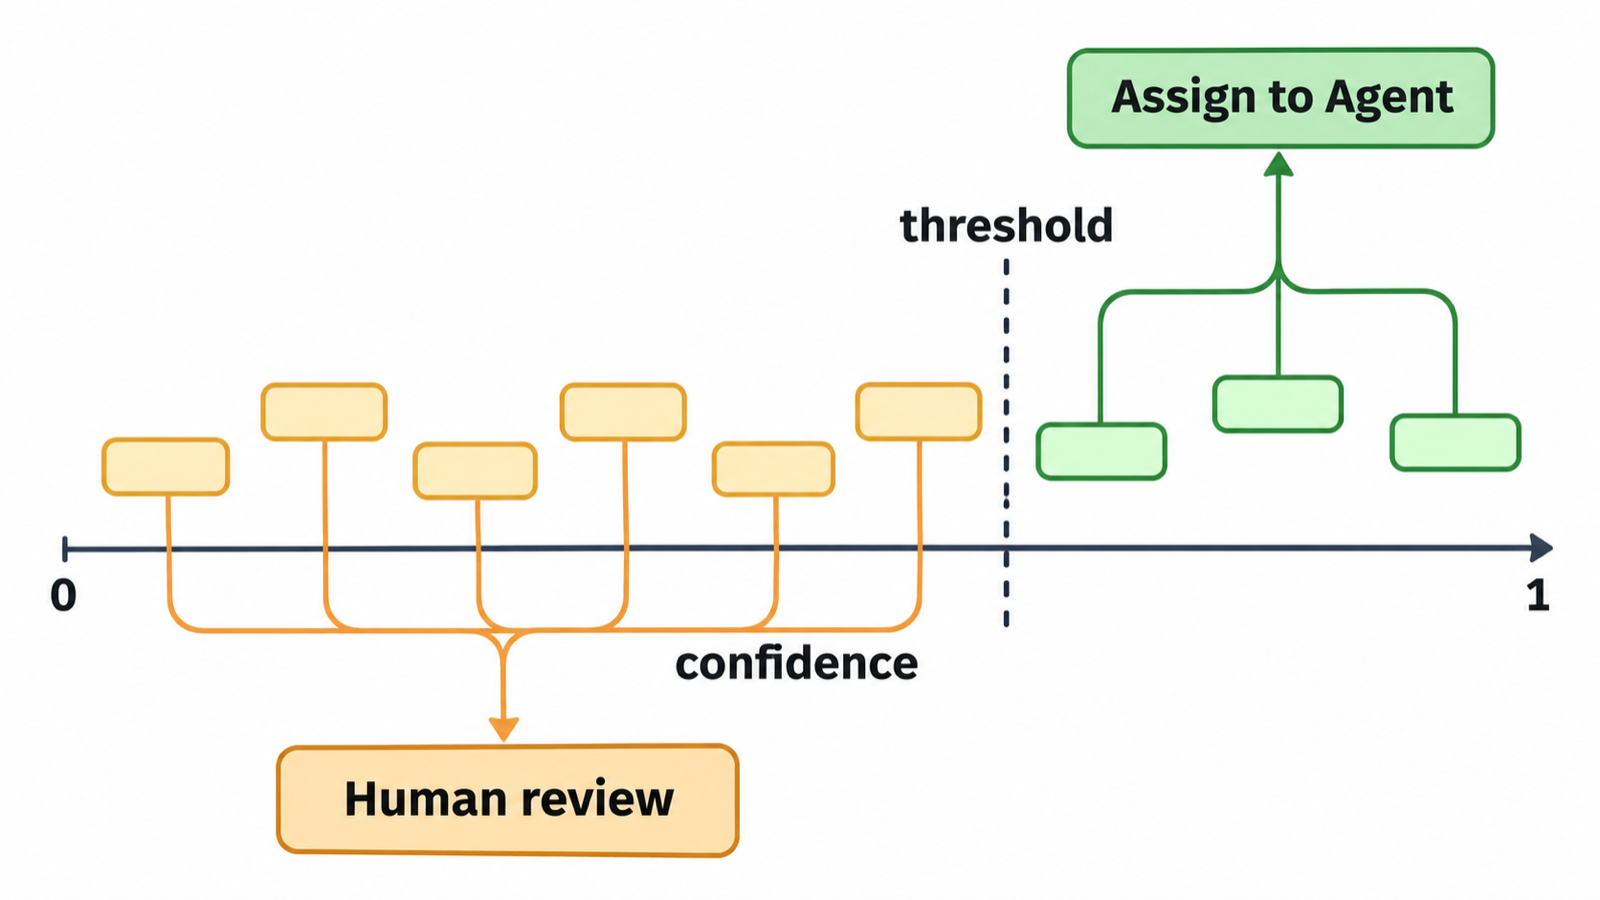
回答の値は「何をすべきか」を示し、確信度は「人間に確認せずに実行してよいか」を示します。choiceの回答の場合、確信度は最上位の選択肢の確率と一致します。noulの場合はmax(noul, 1 - noul)となります。
こちらが意思決定レイヤーのコードです。
AUTO = 0.75      # assign without a person above this
HARD = 2.4       # difficulty score that earns the strong-model Agent

def decide(a):
    if a["needs_human"].noul >= 0.5:
        return ("human", "needs a decision first")
    if a["agent"].choice == "other" or a["agent"].confidence < AUTO:
        return ("human", f"router unsure ({a['agent'].confidence:.2f})")
    tier = "strong" if a["difficulty"].score >= HARD else "default"
    return (f"{a['agent'].choice}-{tier}", "auto")
0.75という数値をそのまま鵜呑みにしないでください。Googleのガイドラインでは、自チームの実際のデータからラベル付きのサンプルを用意してしきい値を設定することが推奨されています。直近で完了したタスクを50〜100件抽出し、どのエージェントが各タスクを完了したかを記録した上で、それらをask()に流してみましょう。自動ルーティングされたタスクがチームの判断と一致する、最も低いしきい値を選択します。誤った自動割り当ては実行失敗と再アサインのコストを生み、不要な人間への保留は数分のロスを生みます。キリの良い数字を適当に選ぶのではなく、この両者のトレードオフを比較検討して設定してください。
注意すべき落とし穴が2つあります。1つ目は、noulの確率は決して0.99を超えないため、> 0.99のような条件判定は永久にマッチしない点です。2つ目は、scoreが1.5のとき、「レベル1と2で意見が割れている」のか「4つのレベル全体で迷っている」のかのどちらも意味し得る点です。厳密な判断が必要な場合は、probabilitiesの値も併せて確認してください。
Sharklyボードにルーターを組み込む
ルーターはシンプルなPythonコードなので、どこでも実行できます。Sharklyボード上で動かす場合、タスクが作業可能な状態になった瞬間をトリガーにするのが最もスマートです。
1. レーンと階層(ティア)ごとにエージェントを作成する。たとえばbackend-default、backend-strong、frontend-defaultのように作成します。Sharkly Agentsのドキュメントにあるとおり、各エージェントはデフォルトでランタイムのモデルを使用しますが、「Model」設定項目からそのランタイムのカタログ内にある別のモデルを選択できます。ここで、タスクの難易度に応じたモデル選択が結びつきます。
2. sharkly CLIで判定結果を反映する。
import subprocess

def apply(task_id, target, reason, a):
    note = (f"Router: agent={a['agent'].choice} ({a['agent'].confidence:.2f}), "
            f"difficulty={a['difficulty'].score:.1f}, "
            f"needs_human={a['needs_human'].noul:.2f}")
    if target == "human":
        subprocess.run(["sharkly", "task", "comment", task_id,
                        "--body", f"{note}. Held for a person: {reason}."], check=True)
        return
    subprocess.run(["sharkly", "task", "edit", task_id,
                    "--delegate-agent", target], check=True)
    subprocess.run(["sharkly", "task", "comment", task_id, "--body", note], check=True)
タスクが準備完了ステータスにある場合、エージェントを割り当てるとすぐに実行が開始されます。判定の確率値をタスクのコメントに書き残しておくことは、一見地味ですが非常に重要です。1か月後にルーターの挙動を検証・監査する際の手がかりになります。
3. ステータス変更をトリガーに設定する。SharklyのAutomation(自動化機能)は、指示内容、担当エージェント、およびトリガーを管理します。軽量なルーター用エージェントに「自身を起動したトリガータスクに対してroute.pyを実行する」という指示を与え、チームが「着手可能」を表すステータスに対してタスクステータストリガーを追加します。タスクステータストリガーによって開始された実行ログは元のタスクに紐づくため、ルーティングの記録が作業内容とともに残ります。CLIからの設定例は以下のとおりです。
sharkly automation trigger create <automation-id> --kind task_event --to-status "Ready"
ルーティング呼び出しにかかるコスト
Googleのリリース発表によると、Gemini Decision 1の料金は入力トークン100万件あたり0.10ドルで、出力トークンは無料(0ドル)です。共有された入力は、質問の数にかかわらず1リクエストにつき1回分のみ課金されます。
| 項目 | トークン数(推定) |
|---|---|
| タスクのタイトルと説明文 | 2,000 |
| 基準を含む3つの質問 | 300 |
| ルーティング1回あたりの合計 | 2,300 |
| 1,000タスクをルーティングした場合 | 230万トークン(約0.23ドル) |
ルーターのコストは、エージェントがタスクを1回実行する費用よりも安価です。また、Google AI Studioにはプロトタイピング用の無料枠も用意されています。
導入前に知っておくべき制約事項
本APIはGemini Developer API上でv1betaとして提供されており、Google Cloud版Geminiへの提供は「近日対応」とされています。ドキュメントによると、コンテキストキャッシュ、Batch API、FlexおよびPriority推論はサポートされていないため、重複する入力であっても毎回全トークンがカウントされます。階層別のレート制限はGoogleのレート制限ページに記載されているので、すべてのタスクを単一のAPIキーでルーティングする前に必ず確認してください。
タスクの説明文は信頼できない入力として扱ってください。ドキュメントでも、ユーザーが入力したテキストが自身の分類を意図的に誘導しようとする可能性があると警告されています。チーム外のユーザーがタスクを登録できる運用の場合は、ルーターの判定結果にかかわらず、認証、決済、本番データに関わるタスクは必ず人間の確認・承認を通すようにしてください。
Googleが発表しているベンチマーク(一連の評価スイートにおいて最も低いキャリブレーション誤差を記録、Interactions API経由のGemini 3.5 Flash-Liteと比較して約5倍安価など)は、あくまでGoogle側の公表値です。真に指標とすべきベンチマークは、自チームのラベル付けされたタスク実績です。
ルーティング呼び出しが適さないケース
Decisions APIによる判定が効果的なのは、人間がトリアージする以上のペースでタスクが届き、かつ選択肢が固定されている場合(特定のエージェント群、特定のモデル層、Yes/Noのゲート判定など)です。一方で、ラベルによって行き先が一意に決まるようなケースでは、単純なルール処理を使いましょう。たとえばdocsタグの付いたタスクはすべてdocsエージェントに割り当てるのであれば、単なるif文のほうがコストもかからず、判断を誤ることもありません。
ルーターに自然言語で理由を説明させたい場合や、仕様書を書き直させたい場合、タスクをサブタスクに分解させたい場合は、代わりに生成モデルを使用してください。Decisions APIが返すのは数値であり、テキストではありません。複数の役割にタスクを分割・割り振る場合は、リーダー役が目標をブレイクダウンするCrew構成の方が適しています。詳細はmodel routing for agent Crewsを参照してください。
まとめ
ルーティングはクローズドな選択問題であり、Gemini Decisions APIはまさにそうした意思決定のために作られています。1回のAPI呼び出し、型付けされた回答、しきい値設定が可能な確信度スコア、そして1セントにも満たないわずかなコストで実現できます。残された作業はあなた自身の手にかかっています。わかりやすい選択肢の説明を記述し、過去の完了タスクを使ってしきい値を調整し、確信度の低いタスクは人間のレビューへ回す仕組みを整えましょう。
まずは1つのレーンから始めてみてください。新規のバックエンドタスクを1週間ルーティングしてみて、ルーターの選択結果をチームが本来下していたであろう判断と比較し、問題がなければ適用範囲を広げていきます。エージェント、自動化、人間によるレビューが一元管理された実際のボードでルーターを動かすには、Sharklyの使い方ガイドをご覧ください。
よくある質問(FAQ)
Gemini Decisions APIとは何ですか?
2026年11月11日にリリースされたGemini APIのエンドポイントです。テキスト、画像、音声、動画、PDFに関するYes/No、選択、スコアリングの質問に回答します。gemini-decision-1モデルを使用し、生成テキストの代わりにキャリブレーションされた確率と確信度を返します。
Gemini Decision 1の利用料金はいくらですか?
Googleの料金表によると、入力トークン100万件あたり0.10ドル、出力トークンは0ドルです。同一リクエスト内の共有入力に対する課金は1回のみです。また、Google AI Studioにはプロトタイピング向けの無料枠も用意されています。
1回のリクエストでいくつの質問を投げられますか?
入力と全質問を合わせた262,144トークンのコンテキストウィンドウの範囲内で、1〜1,000個の質問を設定できます。選択式の質問には2〜255個の選択肢を指定可能です。
ルーティングにはどの確信度しきい値を使うべきですか?
万人に共通する一意の数値はありません。Googleは、自社の実際のトラフィックから得られたラベル付きデータをもとにしきい値を設定することを推奨しています。過去に完了した50〜100件のタスクでテストを行い、自動判定がチームの判断と一致するしきい値を選定してください。
Decisions APIでエージェントが使用するモデルを選択できますか?
間接的に可能です。難易度を評価するscoreの質問を行い、高スコアのタスクをより強力なモデルが設定されたエージェントにマッピングします。Sharklyでは、各エージェントにそのランタイムのカタログから任意のモデルを設定できます。
Gemini Decisions APIはVertex AIで利用できますか?
現時点では利用できません。Googleのリリース発表によると、Google CloudのGeminiへの対応は近日公開予定とされています。現在はGemini Developer API上でv1betaとして提供されています。

