
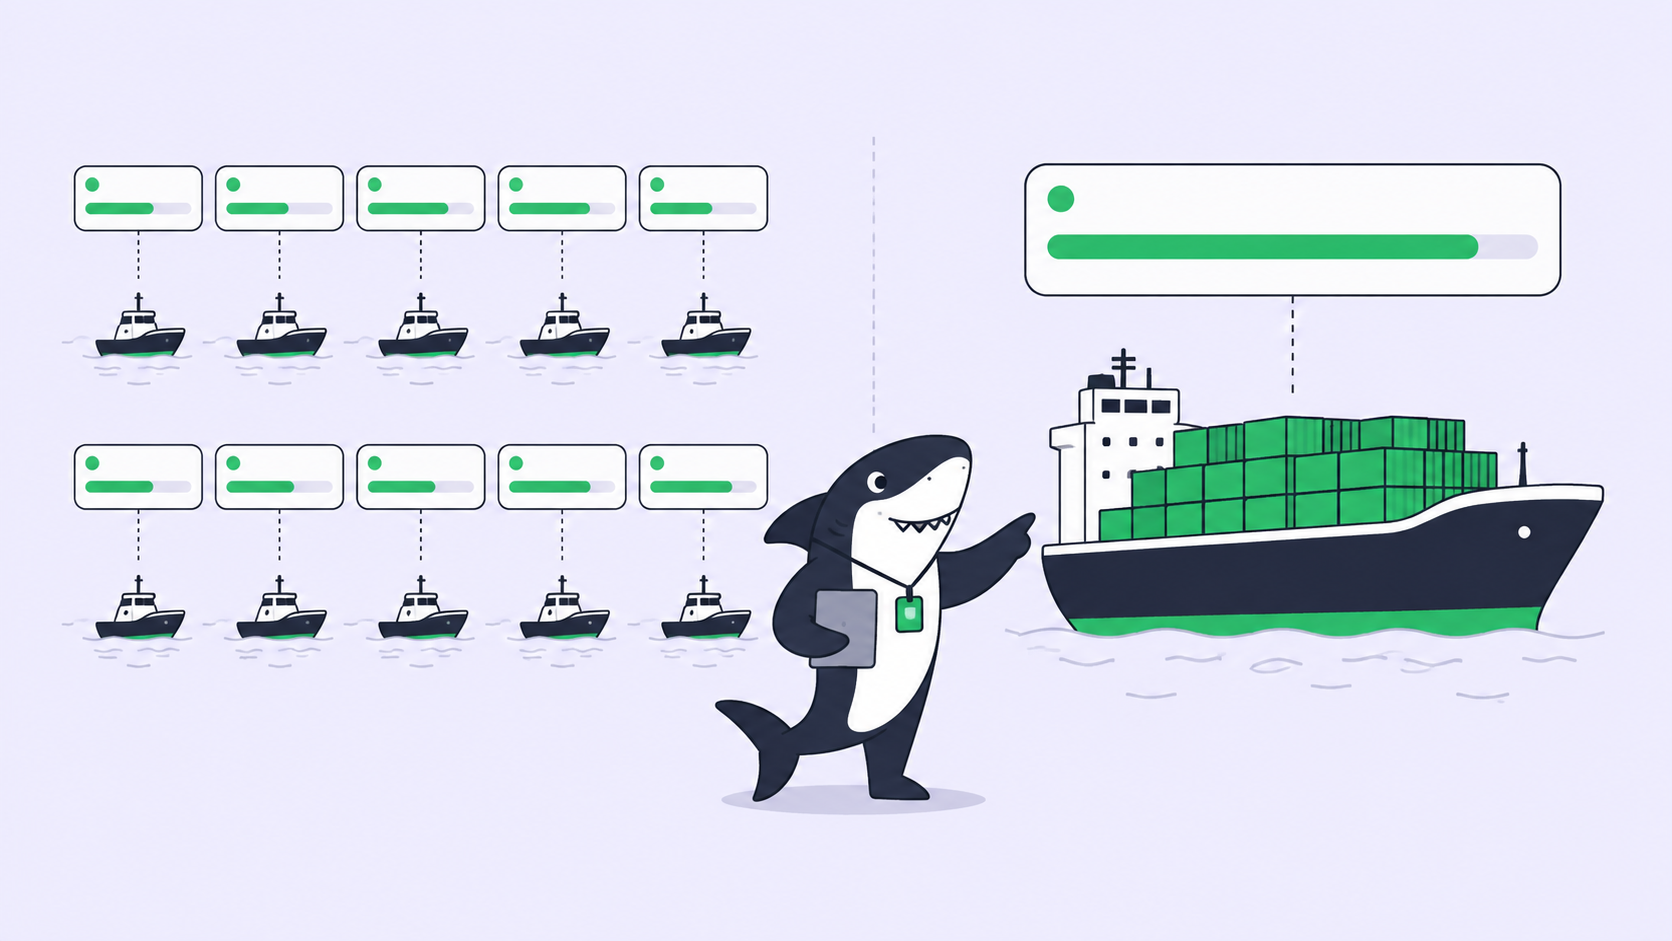
レビュアーの人数は決まっている。そして2026-09-22以降は、もう何も決めてくれないモデル料金表もある。GPT-6 Lunaの定価は入力100万トークンあたり$0.10、出力100万トークンあたり$0.50で、API idはgpt-6-luna。Claude Opus 5.5は$4と$20、API idはclaude-opus-5-5。これは課金メーターの入力・出力の両側で40倍の開きであり、両ベンダー自身の定価から弊社が計算した数字だ。かつては理論上の話でしかなかった問いが、これで毎週のシフト組みの判断に変わる。同じ予算を投じるなら、安いエージェントを10体走らせるか、高いエージェントを1体走らせるか。
この2つの構成は、互いの代替品ではない。両者を分けるのはモデルの品質ではなく、それは実行の始まりではなく終わりに現れる。それぞれが人の前に置く作業量が違うのだ。
この問いを現実のものにする計算
OpenAIは価格表ではなく、スコアの隣にタスクあたりのコストを公表している。こちらのほうがよほど役に立つ。DeepSWE 1.1において、推論エフォート最大のLunaは66.6%を記録し、OpenAIいわくこれは中程度のエフォートにおけるClaude Opus 5およびFable 5に匹敵するスコアだという。しかもタスクあたりのコストはOpus 5より93%、Fable 5より96%低い。
最初の数字から逆算すると、Opus 5の1タスクはおよそLunaの14タスク分にあたる。つまり同じハーネス上では、Lunaを10回走らせてもOpus 5を1回走らせるコストの7割程度で済む。この掛け算は、OpenAIが示した93%という数字から弊社が導いたものだ。
Anthropicは、Opus 5.5はOpus 5より実行コストが40%低いと述べている。これを当てはめると、比率は9対1あたりまで下がる。この数字は異なるハーネスで測られた2社の測定値を鎖のようにつないだものなので、数値そのものではなく方向性として受け取ってほしい。安い試行10回と高い試行1回のコストは、どちらの計算の仕方でも、ほぼ同じになったということだ。
| GPT-6 Luna | Claude Opus 5.5 | |
|---|---|---|
| API id | gpt-6-luna |
claude-opus-5-5 |
| 入力/出力(100万トークンあたり) | $0.10 / $0.50 | $4 / $20 |
| キャッシュ入力 | 読み取り90%オフ | 読み取り$0.20、書き込み$5 |
| コンテキストウィンドウ | 1M | 1M |
| ベンダーによる長時間稼働の主張 | 記載なし | 18時間以上タスクに留まる |
| Artificial Analysis Index | 37 | 58、212モデル中1位 |
この表には2つの注意点が付きまとう。OpenAIの見出しは「SolとLunaはそれぞれGPT-5.6のプロモーション価格より50%安い」というものだが、「プロモーション」はOpenAI自身の言葉であり、比較対象は定価ではなく割引価格だ。そして2本のローンチ記事は直接対決ではない。両ベンダーが同じ日にAutomationBenchのスコアを報告しているものの、ハーネスのバージョンも推論エフォートも異なる。この2つのパーセンテージを同じ行に並べれば、どちらのラボも実施していない比較が出来上がってしまう。上記のタスクあたりコスト比が成立するのは、それが単一ベンダー自身の測定の内側から出てきた数字だからだ。
ひとつのトレードオフに見える3つの構成
「エージェント10体か1体か」は、実のところ3つの配置であり、レビューの段階でそれぞれ挙動が異なる。
| 構成 | レビューに届くもの | 勝者を選ぶのは誰か | うまくいく条件 |
|---|---|---|---|
| 安いエージェント10体 × タスク10件 | diff 10件、判断10回 | 人間が10回 | バックログが広く、各項目が独立して受け入れ可能 |
| 安いエージェント10体 × タスク1件 | diff 1件、判断1回 | テストスイート | 人間が読まなくても機械が試行を順位付けできる |
| 高いエージェント1体 × タスク1件 | diff 1件、判断1回 | 人間が1回 | 長いタイムホライズン、弱い自動シグナル、あるいは全体を通じて判断を要する変更 |
値下げが実際に解き放つのは真ん中の行であり、そして多くのチームが飛ばしてしまうのもこの行だ。同じタスクを10回走らせ、型チェックとテストとビルドを通過した試行を採用する。これは、試行1回が実際の金銭コストを伴わなくなって初めて手の届く戦略になった。ベンチマークの合格率が3分の2前後なら、単発の試行は3分の1が失敗する。もし試行が互いに独立に失敗するなら、10回試してすべてが失敗することはまずない。だが実際には独立ではない。要件が曖昧なタスクやフィクスチャの欠落は、どの試行も同じように打ち負かす。ファンアウトが買えるのはばらつきであって、保証ではない。
多くのチームが実際に手を伸ばすのは最初の行で、これが高くつく。ドルの話ではない。エージェント10体をタスク10件に走らせればdiffが10件出てくる。そしてその1件1件を人が読み、エージェントが何を選んだのかを理解し、マージする責任を負わなければならない。このコストは2026-09-22に下がったわけではなく、どのモデルのリリースでも触れられない。並列エージェント作業で人間のレビューがボトルネックになる理由、そして人間の1作業日がエージェントの何作業日を吸収できるかについては以前も書いたが、そこの計算はトークンが安くなっても変わらない。
Lunaでエージェントを10体走らせても、アウトプットが10倍になるわけではない。届く作業が10倍になるだけだ。安いモデルが買うのは試行だ。レビューキャパシティは買えない。そして請求書だけを見ていると、この2つは混同しやすい。
通用するのは「承認された変更あたりのコスト」
承認された変更あたりのコストとは、人が実際に読んで承認したdiff 1件につき、チームが推論にいくら払ったかだ。これは出荷された仕事に直結する唯一のエージェントコスト指標である。誰もレビューしていない試行は、何も出荷していないからだ。
この定義は、3つの構成をたちどころに整理してくれる。タスク1件へのファンアウトは、10回の試行を1回のレビュー判断に割り振るので、試行が安くなれば承認された変更あたりのコストは一直線に下がる。タスク10件に横展開する構成では、1回の試行が1回のレビュー判断に対して10回分に分かれるので、試行が安くなっても推論のコストは下がる一方でレビューのコストは横ばいのままで、そちらが制約になる。高いエージェント1体に深く任せる構成は、レビュアーの目の前にあるその1回の試行がマージに値する確率を高める。
実務でしか見えてこない第二の効果がある。安い試行10回と高い試行1回では、一緒に作業するときの感触が違う。Artificial Analysisはこれらのモデルの推論エフォート最大版について、最初のトークンまでの時間をLunaが124.23秒、Solが102.15秒と測定している。これは特に最大版についてのサードパーティの数字であり、これをもとに計画を立てる前に確認しておく価値がある。10体のエージェントがそれぞれ2分間沈黙してからようやく1文字を出すのは、速いパイプラインではない。10個の実行が同時にハングしたように見えるだけだ。これはモデルの問題ではなくステータスの問題である。
判断の分かれ目
機械が決めるなら、安いエージェントを10体使う。つまり、人が介在せずに走る本物の受け入れシグナルがそのタスクにある場合だ。今日は失敗し、必ず通らなければならないテスト、型チェック、ビルド、lintルール、再現スクリプトなどがそれにあたる。トリアージ、ラベリング、テストの土台づくり、機械的なリファクタリングは条件を満たす。変更がうまくいったかどうかが意見ではなくコマンドで判定できるものも同様だ。
人が決めるなら、高いエージェントを1体使う。変更を受け入れるのにコードを読んで見解を形成する必要があるなら、試行を増やしても助けにはならず、読む量が増えるだけだ。長いタイムホライズンの作業でも同じことが言える。AnthropicによればOpus 5.5は18時間以上タスクに留まる。午後ひとつ分のあいだ目標を保持し続ける実行は、同じ中途半端な理解から毎回やり直す10回の実行より価値がある。
受け入れシグナルを書くのを避けるためにファンアウトを使ってはいけない。自動判定のないもっともらしいdiffが10件あるのは、diff 1件より悪い。もっともらしいdiffが10件あると、その中から選ぶ作業は1件をレビューするより難しく、しかもその作業は、守ろうとしていた当の人のところに降りかかるのだ。
横展開の構成が上位レイヤーに求めるもの
エージェントを10体同時に走らせるのは、コストの問題である前に調整の問題だ。必要な部品はすでに知られている。各実行を専用のworktreeで動かすことで、2体のエージェントが同じファイルを編集してもインシデントにならないようにする。タスク1件につきアサイニーを1人にして、オーナーシップが曖昧にならないようにする。そして実行中・待機中・失敗を区別するステータスを用意する。
エージェントは、その作業をどう扱うべきかを定義する。コンピュータはホストとローカルリソースを提供する。ランタイムはセッションを実行する。タスクは共有レコードとしてあり続ける。10個の実行が1時間のうちに次々と終わるとき、最後のこの部分が、その1時間を10個のターミナルを巡る宝探しに変えずに済ませてくれる。
終了したLunaの実行は、プライベートなセッションログではなく、そのタスクに次のようなものを返すべきだ。
SH-312  Add retry with backoff to the webhook dispatcher
Runtime   gpt-6-luna (fan-out, 8 attempts, 3 passed the suite)
Selected  attempt 6, smallest diff of the passing set
Evidence  typecheck ok, 214 tests pass, build ok, coverage +0.4%
Known limit  no test for the 429 path, dispatcher is not idempotent yet
Status    Ready for review, waiting on a human
重要なのは選択の行だ。何が決めたのかが書かれているので、レビュアーは自分が機械の選択を追認しているのか、それとも自分で選んでいるのかが分かる。選択の記録がない10回の試行は、1件のタスクのふりをした10倍の作業にすぎない。
結論
スイートが判定し、バックログが広くてエージェントを忙しく保てるなら、安いエージェント10体のほうが出荷量が多い。受け入れの判断が人間で、タイムホライズンが長く、あるいは自動シグナルが弱いなら、高いエージェント1体のほうが出荷量が多い。ほとんどのチームは両方を欲しがるはずで、それは好みではなくタスクの種類で振り分けるべきだ。これがモデルをエージェントの役割にマッチングするで述べた主張である。
どちらの構成でも最後のステップは変わらない。エージェントは調査し、実行し、テストし、報告する。人は方向を定め、権限を与え、結果を受け入れる。モデルの価格は1日で40倍動いた。そしてチームが責任をもって受け入れられる変更の数は、まったく動かなかった。
すでに複数のエージェントを動かしているなら、Sharklyはコンテキスト、進捗、ブロッカー、結果、そして人間のレビューを、リクエストからリリースまで一箇所で見えるようにしてくれる。diffを生み出したランタイムが何であっても関係ない。


