

코딩 에이전트에게 어떤 함수가 어디에서 호출되는지 물어보고 무슨 일이 벌어지는지 한번 지켜보자. 에이전트는 grep을 돌리고, 파일 세 개를 읽고, 다른 패턴으로 다시 grep하고, 또 네 개를 더 읽은 끝에 결국 정확한 답을 내놓는다. 그 과정에서 컨텍스트는 세션이 끝나면 잊어버릴 소스 코드로 가득 찬다. 꼬리 질문을 하나 던지면 같은 과정을 처음부터 다시 반복한다.
codebase-memory-mcp는 이 루프를 없애준다. 스타 41,536개에 MIT 라이선스, C로 작성된 이 도구는 올해 불어닥친 에이전트 툴링 물결 가운데 업무 방식을 가장 적게 바꾸고 가장 큰 효과를 내는 항목이다. 이 도구는 에이전트에게 여러분의 코드에 대한 기억을 부여한다. 팀에게 작업에 대한 기억을 부여하지는 않으며, 이 둘은 서로 다른 문제다.
TL;DR
이 글은 코딩 에이전트를 확장하는 오픈 소스 도구를 정리한 글에서 다룬 다섯 편의 심층 분석 중 하나다.
codebase-memory-mcp는 저장소를 함수, 클래스, 호출 체인, 라우트로 이루어진 영구 지식 그래프로 인덱싱한 뒤, grep 대신 그래프에서 구조적 질문에 답한다. 프로젝트 측이 측정한 바로는 구조적 질의 다섯 건을 그래프로 처리하면 약 3,400 토큰, 파일을 하나씩 훑으면 약 412,000 토큰이 든다. 단일 네이티브 바이너리로 동작하며 런타임이나 API 키가 필요 없고, 전부 로컬에서 실행되며 어떤 MCP 클라이언트와도 호환된다. 우선 이것부터 설치하자. 그리고 에이전트가 한 일에 대한 기록을 어디에 둘지는 별개로 결정하자.
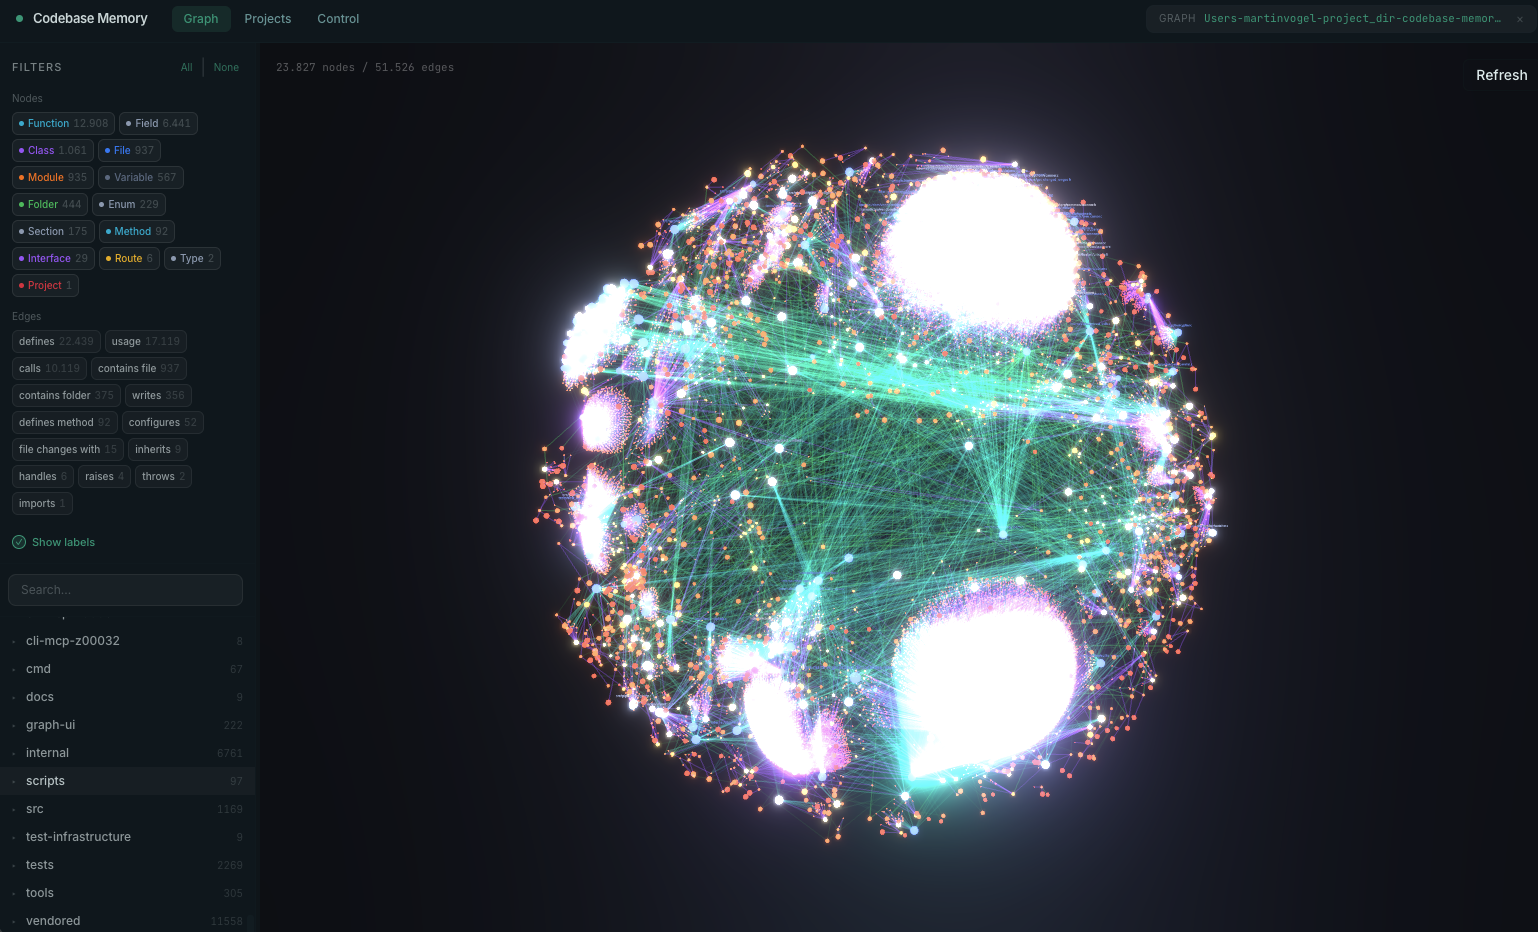
무엇을 해주는가
파싱은 tree-sitter를 통해 160개 이상의 언어를 처리하며, Python, TypeScript·JavaScript 계열, Go, Java, Rust, C#, C++ 등 핵심 언어군에는 시맨틱 타입 해석이 추가로 적용된다. 그 결과는 검색, 호출 체인 추적, 아키텍처 개요, 영향도 분석, 데드 코드 탐지, 그래프 질의, 서비스 간 HTTP 연결을 아우르는 15개의 MCP 도구로 제공된다. Model Context Protocol을 지원하는 클라이언트라면 무엇이든 사용할 수 있으며, 프로젝트는 45개의 지원 에이전트 환경을 명시하고 있다.
| 측정 항목 | 보고된 수치 |
|---|---|
| 구조적 질의 5건 | 약 3,400 토큰 vs 파일별 약 412,000 토큰 |
| 동료 검토 비교 | 토큰 10배 절감, 도구 호출 2.1배 절감, 답변 품질 83% |
| 리눅스 커널 인덱싱 | 2,800만 줄, 7만 5천 개 파일, 3분 |
| 구조적 질의 지연 시간 | 1ms 미만 |
이 두 토큰 수치를 함께 읽어보자. 99% 절감은 그래프가 최상의 성능을 낼 때의 구조적 질의 5건에 해당한다. 31개 저장소를 대상으로 한 프리프린트 수치는 10배다. 10배를 기준으로 계획하고, 그보다 좋은 결과는 덤으로 여기자.
설치하기
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bash
Windows용 PowerShell 설치 스크립트도 있으며, 프로젝트 측은 실행 전에 읽어볼 것을 권장한다. 설치 프로그램은 여러분의 코딩 에이전트를 감지해 해당 MCP 항목을 기록한다. 에이전트를 재시작한 뒤 프로젝트를 인덱싱하라고 지시하자.
첫날부터 적용할 만한 설정 두 가지:
codebase-memory-mcp config set auto_index true
codebase-memory-mcp --ui=true --port=9749
그래프 뷰어는 바이너리에 내장되어 있으며, 인덱스가 예상한 범위를 제대로 담았는지 확인하는 데 유용하다.
프로젝트가 직접 문서화한 두 가지 주의 사항이 있고, 둘 다 30초쯤 투자할 가치가 있다. Microsoft Defender가 릴리스 바이너리를 오탐으로 표시할 수 있는데, 프로젝트 측은 보통 62개 엔진 중 61개가 정상 판정을 내리며 같은 탐지 계열이 GitHub CLI와 마이크로소프트 자체 Go 툴체인도 건드린다고 밝힌다. 또한 이 도구는 코드베이스를 읽고 에이전트 설정 파일에 기록하는데, 이는 도구의 본래 역할이며 숨김없이 명시되어 있다. 셸로 파이프하기 전에 설치 스크립트를 읽어보자.
왜 이것부터인가
현재 툴링 물결에 있는 다른 모든 것은 업무 방식을 바꾸라고 요구한다. 역할 라이브러리는 프롬프트를 작성하는 방식을 바꾸고, 병렬 워크트리는 작업을 조직하는 방식을 바꾸며, 웹 접근은 무엇을 요청하는지를 바꾼다.
이 도구는 아무것도 바꾸지 않으면서 모든 세션을 더 저렴하게 만든다. 익힐 습관도 없다.
과소평가되는 부분은 품질 효과다. 파일을 읽는 데 40만 토큰을 쏟는 에이전트는 그만큼 문제를 추론할 여유가 줄어들고, 긴 세션에서는 초반에 읽은 내용에 대한 기억이 점점 흐려진다. 그래프에서 답을 얻으면 컨텍스트를 비워둘 수 있다.
이 변화는 무엇을 질문하는지에서 드러난다. 예전에는 5만 토큰과 2분이 들어서 피했던 질문이 이제는 거의 공짜다. 시그니처를 바꾸기 전 영향도 분석을 돌리면 "그건 안전할 거야"라는 말이 목록으로 바뀐다. 낯선 저장소에서 호출 체인을 추적하는 편이 진입점을 찾으리라는 기대를 걸고 파일 다섯 개를 거슬러 읽는 것보다 낫다.
코드에 대한 기억은 작업에 대한 기억이 아니다
여기 경계가 있고, 꽤 선명하다.
그래프는 여러분의 코드로 만들어지므로 코드가 무엇인지는 안다. 재시도 헬퍼가 결제 클라이언트를 호출한다는 사실은 알려줄 수 있다. 하지만 7월에 백오프가 왜 바뀌었는지, 누가 결정했는지, 대안은 무엇이었는지, 리뷰를 거쳤는지는 알려주지 못한다. 그 이력은 이미 사라진 터미널 세션에 존재했을 뿐이다.
팀은 이 점을 묘한 비대칭으로 체감한다. 에이전트는 팀의 어떤 사람보다도 코드베이스를 잘 기억하지만, 그 코드를 만들어낸 결정에 대해서는 아무것도 기억하지 못한다.
인덱스는 또한 머신별로 존재한다. 하나의 계정 아래 캐시 디렉터리에 저장되고, 코디네이션 데몬을 통해 로컬 세션 간에 공유되지만, 그 머신의 경계를 넘지 못한다.
작업 기록이 사는 곳
Task는 Sharkly의 핵심 작업 단위다. 요청, 컨텍스트, 실행, 방해 요소, 결과를 각자의 프롬프트와 터미널 세션에 흩어놓는 대신 하나의 공유된 장소에 담아둔다.
각 요소는 하나의 역할만 맡는다. Agent는 작업을 어떻게 처리할지 정의한다. Computer는 호스트와 로컬 리소스를 제공한다. Runtime은 그곳에 이미 설치된 코딩 도구를 사용해 실제 에이전트 세션을 수행한다. Task는 공유 기록으로 남는다.
이런 분리는 두 도구의 조합을 구체적으로 만들어준다. 인덱스는 Computer의 로컬 리소스이므로, 인덱싱된 저장소를 가진 Computer에서는 3분짜리 콜드 스타트 대신 이미 데워진 그래프를 쓸 수 있다. Agent는 저장된 구성이므로, 에이전트가 인덱스와 적절한 권한을 갖춘 설정을 머신마다 다시 만드는 대신 그대로 재사용한다. 그리고 실행, 방해 요소, 결과, 후속 논의는 모두 태스크 타임라인으로 돌아오며, 바로 그곳에서 변경의 근거가 살아남는다.
Sharkly는 Claude Code나 Codex, 또는 codebase-memory-mcp를 대체하는 것이 아니다. 이들 주위에 공유 태스크, Computer, 컨텍스트, 제어, 리뷰 계층을 더한다. 모델 사용은 해당 도구에 설정된 구독이나 API 키를 통해 계속 이루어진다.
코드 메모리 더하기 작업 메모리, 이것이 조합이다. 하나는 에이전트에게 저장소에 대한 기억을 주고, 다른 하나는 팀에게 에이전트가 그 안에서 무엇을 했는지에 대한 기억을 준다.
각각이 필요한 시점
팀 규모와 상관없이 지금 codebase-memory-mcp를 설치하자. 로컬에서 동작하고 워크플로 변경도 필요 없으며, 비용 절감 효과는 개발자 한 명에게나 스무 명에게나 똑같이 적용된다.
추론이 세션보다 오래 살아남아야 할 때 공유 작업 시스템을 추가하자. 릴리스 전에 리뷰가 이루어질 때, 한 명 이상이 같은 저장소를 건드릴 때, 또는 석 달 뒤에 누군가 왜 이 변경을 했는지 물을 때다. 그래프는 코드가 무엇을 하는지는 답해준다. 왜인지는 절대 답해주지 않는다.
에이전트는 조사하고, 실행하고, 테스트하고, 보고한다. 사람은 방향을 정하고, 권한을 부여하고, 결과를 받아들인다.
자주 묻는 질문
Claude Code 외의 에이전트에서도 동작하나요? 네. MCP 서버이므로 어떤 MCP 클라이언트든 동작하며, 프로젝트는 Cursor, Codex, Windsurf, OpenCode, Aider를 포함한 45개의 지원 에이전트 환경을 명시하고 있습니다.
제 코드가 제 컴퓨터를 떠나나요? 아니요. 처리는 전적으로 로컬에서 이루어지며, 프로젝트 측은 자체적으로 네트워크 요청을 보내지 않고 백그라운드에서 업데이트를 확인하지도 않는다고 밝히고 있습니다. 믿기보다 직접 확인하고 싶다면 소스가 공개되어 있습니다.
토큰 99% 절감이 현실적인가요? 그 수치는 최상의 경우인 구조적 질의 5건에 해당합니다. 31개 저장소를 대상으로 한 동료 검토 수치는 토큰 10배 절감, 도구 호출 2.1배 절감입니다. 10배를 기준으로 계획하세요.
얼마나 큰 저장소까지 처리할 수 있나요? 제시된 최대치는 2,800만 줄의 리눅스 커널을 3분에 처리하는 것입니다. 일반적인 애플리케이션 저장소는 밀리초 단위로 인덱싱됩니다.
여러 에이전트가 동시에 실행될 때도 도움이 되나요? 네, 오히려 평소보다 더 도움이 됩니다. 다섯 개 에이전트가 같은 저장소를 grep하면 낭비가 다섯 배가 됩니다. 각 Task 실행은 여전히 자체적으로 격리된 워크트리를 사용하고, 구조적 인덱스는 Computer에서 공유됩니다.
요약
2026년 물결에서 가장 눈에 띄지 않으면서 가장 큰 효과를 내는 도구다. 단일 네이티브 바이너리 하나면 되고, 워크플로를 바꿀 필요도 없으며, grep으로 찾을 필요가 없는 질문에 답하느라 에이전트가 소비하는 토큰을 실측 기준 10배 가까이 줄여준다. 설치하고, 프로젝트를 인덱싱하고, 그래프 뷰어를 한 번 열어 무엇을 만들어냈는지 확인해보자.
그다음 경계를 분명히 하자. 이 도구는 저장소를 기억할 뿐 작업을 기억하지 않으며, 변경 뒤의 결정은 무언가가 붙들고 있지 않는 한 세션과 함께 사라진다. Sharkly가 바로 그 역할을 한다. Task는 공유 기록이고, 실행은 이미 비용을 지불하고 있는 런타임을 통해 연결한 Computer에서 돌아가며, 결과는 사람이 검토하고 승인할 수 있는 곳으로 돌아온다.


