

Jev는 TypeSafe AI가 선보인 새로운 모델로, 코드나 산문을 작성하지 않습니다. 프로그램 상태를 조각으로 넘겨주고 답이 필요한 질문을 선언하면, 보정된 확률이 담긴 타입화된 답변을 돌려줍니다. TypeSafe는 이를 System One Model이라고 부릅니다. 2026년 9월 16일 Vercel AI Gateway에 올라왔고, 그래서 갑자기 모든 피드에 등장한 것입니다.
여러 코딩 에이전트를 운영하는 팀에게 흥미로운 지점은 모델 자체가 아닙니다. 결정 모델이 스택 어디에 자리하느냐입니다. 에이전트가 작업을 만들어내고, 어려운 문제는 휴먼 리뷰가 병목인 이유에서 논했듯 한꺼번에 다섯 개 실행 결과를 어떻게 처리할지 결정하는 것입니다. 어떤 것은 사람이 필요하고, 어떤 것은 병합해도 되고, 어떤 것은 막혀 있는지를 말이죠. Jev는 바로 이런 종류의 질문을 위해 만들어졌습니다. 이 글에서는 Jev가 무엇이고 무엇이 아닌지, 그리고 에이전트 위 어디에 위치하는지를 설명합니다.
Jev란 무엇인가
System One Model은 텍스트 대신 결정을 반환하는 모델입니다. TypeSafe의 출시 글은 이를 "비정형 상태를 입력받아 타입화된 확률적 결정을 출력한다"고 표현합니다. 세 가지 속성이 중요합니다.
출력 형태는 호출 전에 선언됩니다. 각 질문의 타입을 미리 정의하면 모델은 그 안에서만 답할 수 있습니다. 파싱할 텍스트도, 잡아낼 스키마 불일치도 없습니다.
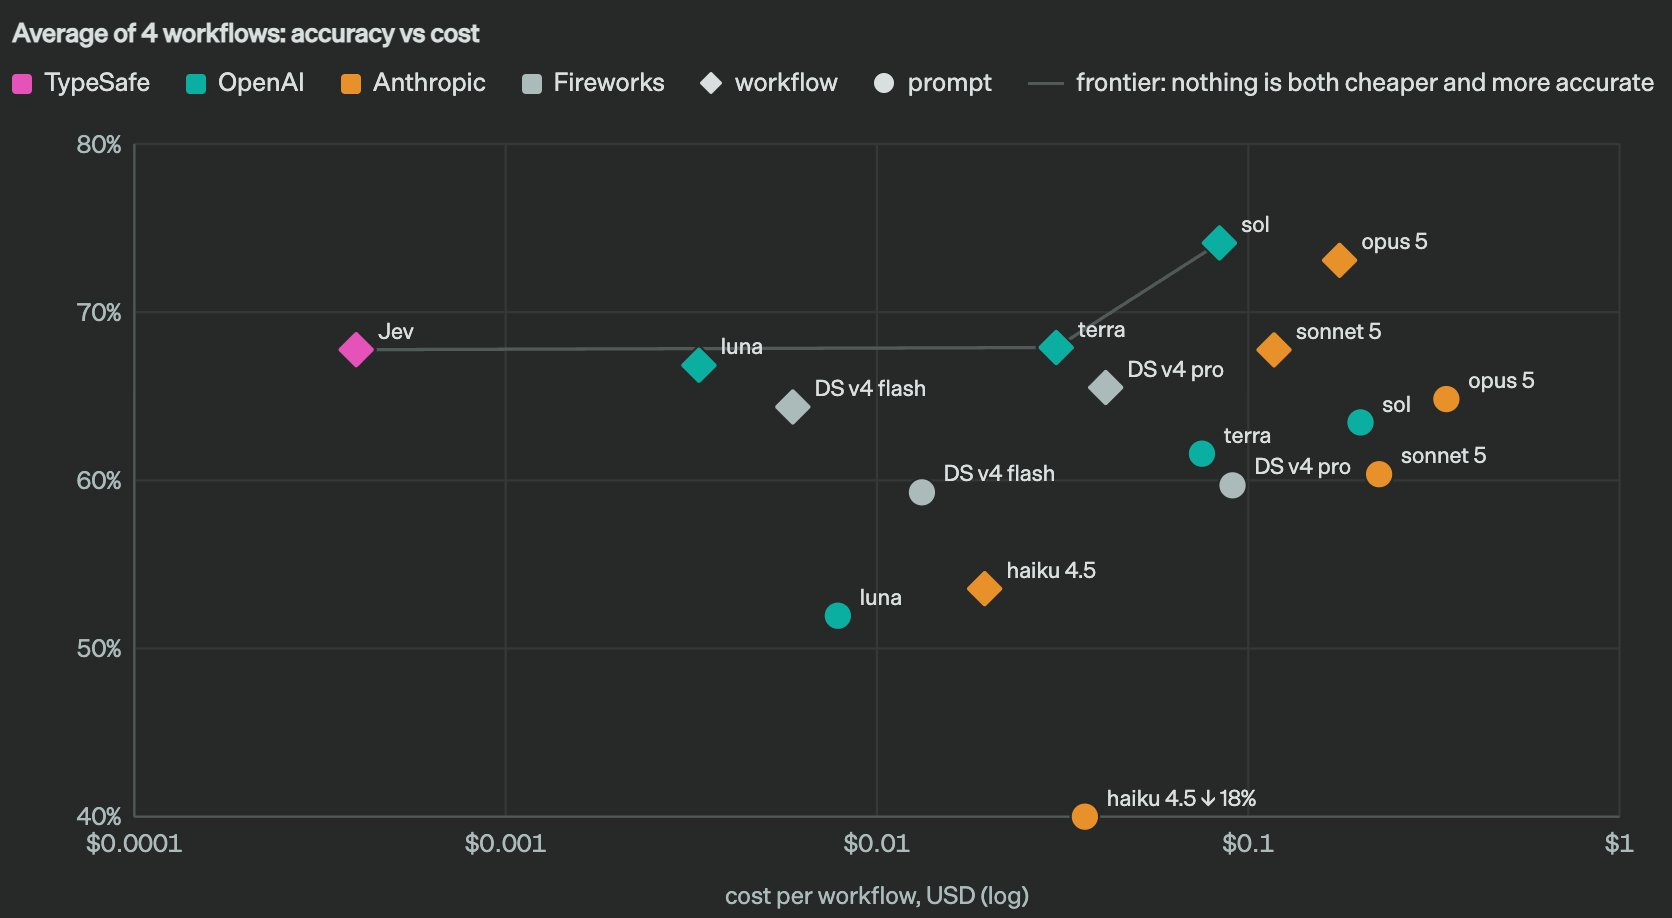
모든 답에는 확률이 따라붙습니다. 예/아니오 질문은 true가 아니라 0.97을 반환합니다. 선택 질문은 옵션 전체에 걸친 분포를 돌려줍니다. TypeSafe는 이를 Calibrated Decisions를 위한 강화 학습(Reinforcement Learning for Calibrated Decisions)이라고 부르는 방법으로 훈련했으며, 확신이 높을수록 정확도도 높다는 것이 주장입니다. 덕분에 임계값을 정할 수 있습니다. 그 이상은 자동화하고, 나머지는 사람에게 넘기는 식이죠.
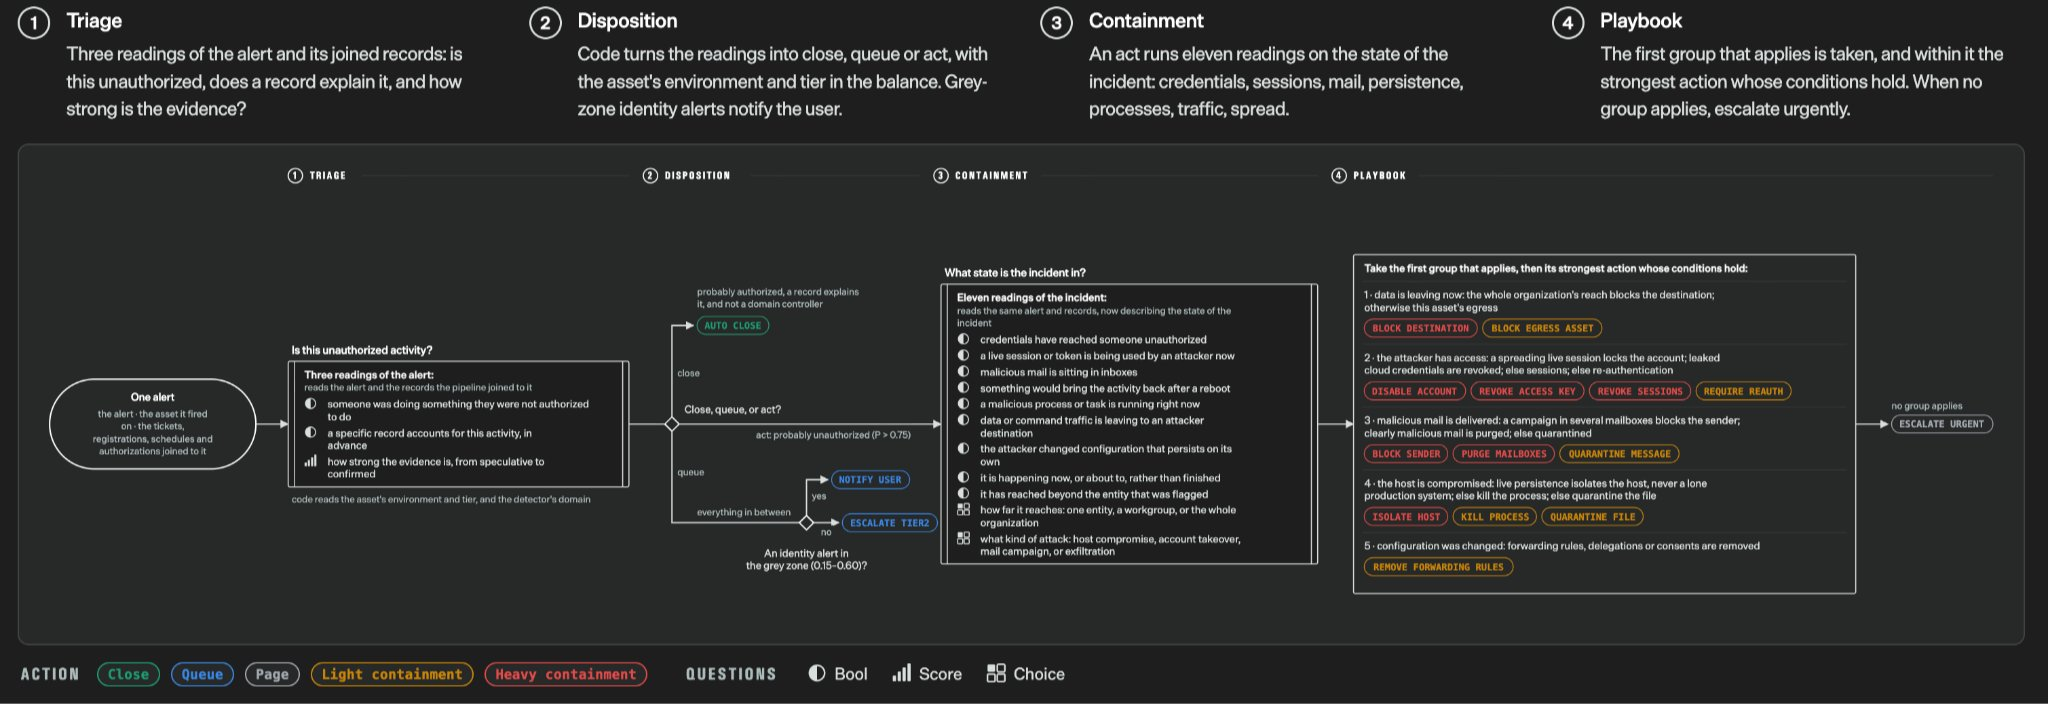
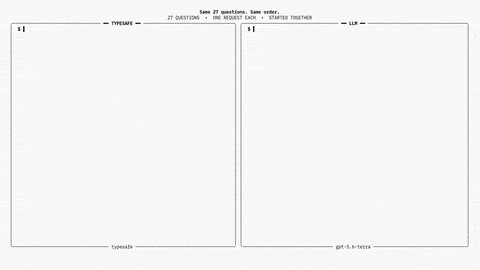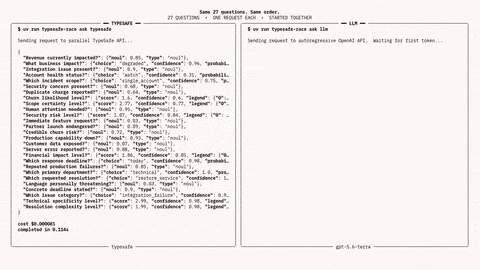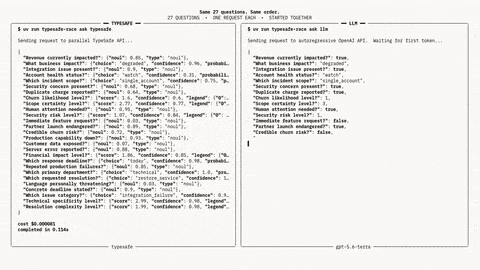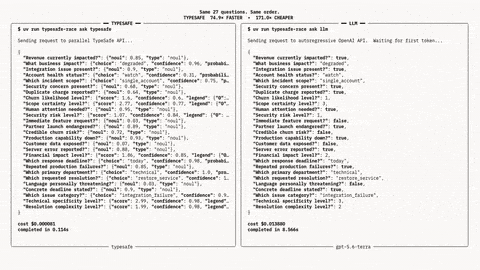
모든 질문은 하나의 요청에서 병렬로 답변됩니다. TypeSafe가 종단 간 70ms에서 500ms라는 시간을 제시하는 이유입니다. 이는 벤더가 제시한 수치이며 독립적인 벤치마크는 아니지만, 아키텍처가 이를 설명해줍니다. 토큰을 하나씩 생성하지 않기 때문입니다.
세 가지 질문 유형
Jev의 API는 세 가지 기본 요소를 노출합니다. 각각은 사용자가 정한 키 아래에 들어가는 JSON 객체이며, 모두 동일한 state를 기준으로 평가됩니다.
Noul은 예/아니오 확률입니다. {"type": "noul", "instructions": "Does this run need a human before merge?"}는 {"noul": 0.91}을 반환합니다. 코드에서 임계값을 적용하면 됩니다.
Choice는 최대 255개까지 이름이 붙은 옵션 집합에서 하나를 고릅니다. 옵션 이름과 설명을 매핑한 criteria를 넘기면, 답변에는 선택 결과, 전체 분포, 그리고 신뢰도 수치가 담깁니다.
Score는 상태를 2~10단계의 순서가 있는 평가 기준에 배치합니다. 답은 확률 가중치가 적용된 위치이므로, 어떤 버그는 "우회 방법이 존재함"과 "차단급" 사이의 1.3으로 평가될 수 있습니다.
Vercel AI SDK를 통하면 예/아니오 유형은 boolean이라 하고 필드는 probability입니다. TypeSafe 자체 엔드포인트를 쓰면 noul입니다. 같은 개념이지만 키가 다릅니다.
결정 모델이 에이전트 위 어디에 자리하는가
우리가 쓰는 사고 모델은 이렇습니다. 모델은 토큰을 만들어냅니다. 코딩 에이전트(Claude Code, Codex, Gemini CLI, OpenCode)는 토큰을 Computer 상의 변경으로 바꿉니다. 관리 계층은 누가 무엇을 할지, 결과를 어떻게 처리할지를 결정합니다. Jev는 중간 계층이 아니라 최상위 계층에 속합니다. 에이전트가 아니며 파일을 편집할 수 없습니다. 관리 질문에 대한 빠르고 타입화된 답을 제공할 뿐입니다.
에이전트를 병렬로 돌리는 모든 보드에서 세 가지 질문이 떠오르고, 각각이 Jev의 기본 요소에 대응합니다.
어떤 Assignee가 이 Task를 맡아야 하는가? 각 Agent가 잘하는 것을 설명하는 criteria와 함께 Agent들에 대한 Choice를 사용합니다. 상태는 Task 제목, 설명, 연결된 저장소입니다. 이것은 AI 백로그 관리와 트리아지에서 설명한 트리아지 단계를, 사람이 티켓 40개를 읽는 대신 100ms짜리 호출 하나로 처리하는 것입니다.
이 실행은 병합 전에 사람이 필요한가? 실행의 diff 요약, 테스트 결과, 변경된 경로를 대상으로 한 Noul을 사용합니다. 0.85를 넘으면 리뷰를 위해 보류하고, 0.15 미만이면 승인 게이트를 통과시키고, 그 사이면 플래그를 세웁니다. 핵심은 리뷰어를 없애는 것이 아닙니다. 리뷰어의 오후 시간이 정말 필요한 실행에 쓰이도록 하는 것입니다.
이 변경은 얼마나 위험한가? "겉모습 수준"부터 "인증 또는 결제를 건드림"까지의 Score를 같은 상태에 적용합니다. 이 수치는 리뷰 큐를 정렬하는 데 쓰이며, 이는 코딩 에이전트가 완료한 작업을 추적하는 방법의 대부분을 차지하는 목적이기도 합니다.
커뮤니티가 먼저 도달했습니다. 출시 후 일주일 만에 개발자들은 Jev 위에 구축한 단계별 코드 리뷰 워크플로, 컴팩션 요약을 어떤 도구 호출을 유지할지에 대한 Jev 결정으로 대체하는 Claude Code 플러그인, 그리고 Jev로 작업을 라우팅하는 "소프트웨어 팩토리 포먼"을 내놓았습니다. 이들은 모두 에이전트 위의 결정 계층이며, 이것이 바로 중요한 패턴입니다.
정직한 결정 규칙
질문에 정해진 답 집합이 있고 확률이 함께 필요할 때 Jev를 쓰세요. 라우팅, 심각도, "리뷰 필요", "막혔는가", "이 PR 설명이 정직한가" 등이 그렇습니다. 이런 질문은 보드가 하루에 백 번씩 던지는 것들입니다.
상태에 담기지 않은 판단이 필요한 질문에는 Jev를 쓰지 마세요. "이게 올바른 아키텍처인가"는 Choice가 아닙니다. "고객이 이걸 받아들일까"는 Score가 아닙니다. 그런 것에 대한 확률은 결정처럼 보이는 숫자일 뿐입니다. 그 선 반대편에는 사람이나, 추론을 설명할 수 있는 언어 모델을 두세요.
그리고 확률이 리뷰 게이트를 대체하게 두어서는 안 됩니다. "병합해도 안전함"에 대한 0.96은 그 실행을 사람의 큐 맨 위에 올리라는 강한 신호이지, 사람을 건너뛰라는 이유가 아닙니다. Sharkly가 그리는 경계는 팀의 판단이 필요한 지점에서 자동화가 멈춘다는 것입니다. 결정 모델은 이 선을 옮기지 않습니다. 다만 선의 사람 쪽에 있는 큐를 더 짧고 더 나은 순서로 만들어줄 뿐입니다.
호출하기
직접 호출: console.typesafe.ai에서 받은 Bearer 키와 모델 jev-latest(현재 jev-1.13.0)로 POST https://api.typesafe.ai/v1/systemone을 호출합니다. Vercel AI Gateway를 통하는 경우: AI SDK 7의 experimental_evaluate를 통해 모델 typesafe-ai/jev를 사용하며, Gateway 문서에 따르면 평가 기능은 OpenAI 호환 엔드포인트가 아니라 AI SDK를 통해서만 사용할 수 있다는 점을 기억하세요.
세 가지 질문에 한 번에 답하는 트리아지 호출:
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
TypeSafe의 모델 페이지에 따른 가격: 입력 토큰 백만 개당 $0.042, 출력은 과금되지 않음, 요청당 64k 토큰이며 그중 상태에 32k, 텍스트 전용입니다. 이 가격이라면 위 트리아지 호출 비용은 1센트의 일부에 불과하며, 그래서 모든 Task와 모든 실행에 이를 돌리는 것이 현실적입니다.
이것이 Sharkly와 어떤 관계인가
Sharkly는 여러분 대신 Jev를 호출하지 않으며, 결정 모델도 아닙니다. 이미 운영 중인 에이전트를 둘러싼 공유 Task, Computer, 컨텍스트, 리뷰 계층입니다. Jev 같은 모델이 주는 것은 그 계층이 드러내는 라우팅과 리뷰 결정을 저렴하고 타입화된 방식으로 내리는 수단입니다. 어떤 Assignee인지, 어느 큐인지, 얼마나 긴급한지 말이죠. Task를 생성하고 Agent를 고르는 Automation에 연결하거나, 완료된 실행의 출력이 리뷰어에게 도달하기 전에 실행해볼 수 있습니다. 어느 쪽이든 결정은 사람이 볼 수 있는 곳에 남으며, 이것이 확률이 무엇을 말하든 지켜져야 하는 부분입니다.
에이전트를 두 개 이상 운영 중이고 리뷰 큐가 문제라면, Sharkly 시작하기에서 결정 모델이 연결되는 보드, Computers, 리뷰 흐름을 다룹니다.
FAQ
Jev는 코딩 에이전트인가요?
아닙니다. 코드를 생성하거나 파일을 편집할 수 없습니다. 넘겨준 상태에 대해 선언된 질문에 확률과 함께 답할 뿐입니다. 작업은 에이전트가 만들어내고, Jev는 그 결과를 어떻게 처리할지 결정하는 데 도움을 줍니다.
코드 리뷰를 대체할 수 있나요?
아니며, 대체해서도 안 됩니다. 리뷰 큐의 순위를 매기고 명백한 사례를 걸러낼 수는 있습니다. 병합 결정은 사람에게 남으며, 이것이 이 전체 워크플로가 의존하는 경계입니다.
보정되었다는 것은 무슨 뜻인가요?
Jev가 0.9라고 말하면, 그런 종류의 질문에서 약 90%는 맞아야 합니다. 임계값을 신뢰하기 전에 여러분의 실행에서 직접 검증하세요. 라벨을 붙인 diff가 수십 개만 있어도 그 숫자가 말하는 대로인지 확인할 수 있습니다.
사용하려면 Vercel이 필요한가요?
아닙니다. 직접 API는 Bearer 키만 있으면 동작합니다. 이미 AI SDK를 쓰고 있다면 Gateway가 편의를 제공합니다.


