
AI 에이전트를 위한 무료 웹 스크래핑이 이제 여러분의 하드웨어에서 직접 돌아갑니다. Firecrawl Local은 사이트를 스크래핑·크롤링·맵핑하여 마크다운으로 변환하는 단일 Rust 바이너리로, MCP 서버로서 Claude Code, Codex, Cursor, Gemini CLI에 연결되며 localhost에서 Firecrawl v2 API에 응답합니다. FIRECRAWL_CLOUD=off로 설정하면 어떤 페이지, 쿼리, URL도 외부로 나가지 않습니다.
요약
- 설치:
cargo install firecrawl-local(Rust와 C 컴파일러 필요). 저희 빌드는 5분 55초가 걸렸고 19MB 바이너리가 생성되었습니다. - 연결:
firecrawl-local init이 감지된 모든 지원 에이전트 도구에 MCP 서버를 추가합니다. - 비용: 스크래핑, 크롤링, 맵핑, 배치 스크래핑은 $0입니다. 검색, 차단된 페이지, Alexandria 데이터 제공자는 클라우드를 끄지 않는 한 Firecrawl Cloud로 전송됩니다.
- 프라이버시 스위치:
FIRECRAWL_CLOUD=off로 모든 것을 로컬에 유지할 수 있습니다. - 팀 설정: 에이전트가 실행되는 Computer마다 한 번씩 설치하면, 그 Computer의 모든 에이전트가 동일한 스크래퍼를 사용합니다.
Firecrawl Local이란
Firecrawl Local은 Firecrawl 팀이 만든 단일 바이너리로, 웹 페이지를 가져와 깔끔한 마크다운으로 정리하고 호스팅된 Firecrawl API가 반환하는 것과 동일한 JSON을 돌려줍니다. 데이터베이스, 큐, 컨테이너가 필요 없습니다. Firecrawl은 2026년 11월 18일 이 제품을 발표했고, crates.io의 크레이트는 그보다 일주일 전에 0.1.0 버전으로 올라왔습니다.
README에서는 세 가지 사용 방법을 설명합니다. CLI, 에이전트용 MCP 서버, 그리고 v2 API의 로컬 사본입니다. 정리(cleaning) 코드는 호스팅 API와 같은 소스에서 컴파일되므로, 노트북에서 생성된 마크다운 페이지는 두 곳에서 모두 접근 가능한 페이지에 대해 클라우드가 반환하는 것과 일치합니다.
Firecrawl의 출시 게시물은 스크래핑 프리미티브가 자체 호스팅 Firecrawl보다 37배 빠르고 메모리는 230배 적으며 대기 상태에서 11MB라고 주장합니다. 이는 Firecrawl 측 수치이며, README에는 측정 방법이 공개되어 있지 않습니다. 저희는 아래에서 메모리 부분을 직접 측정했습니다.
여러 코딩 에이전트를 이미 운영 중이라면, 호출당 요금 없이 모두에게 줄 수 있는 첫 번째 스크래퍼입니다. 이 가이드의 나머지 부분에서는 설정, 프라이버시 스위치, 그리고 Sharkly에서 팀 전체 에이전트에게 동일한 도구를 제공하는 방법을 다룹니다.
에이전트에게 로컬 스크래퍼가 필요한 이유
웹을 읽지 못하는 에이전트는 오래된 학습 데이터로 작업합니다. 본 적 없는 API를 추측하거나, 사용자에게 문서를 채팅에 붙여넣어 달라고 요청합니다.
호스팅 스크래핑 API는 이 문제를 해결하지만 두 가지 비용이 추가됩니다. 모든 페이지가 과금되는 호출이므로 400페이지짜리 문서 사이트 크롤링은 청구서에 한 줄로 남습니다. 그리고 에이전트가 여는 모든 URL이 다른 사람의 서버를 거치는데, 에이전트가 고객의 도메인이나 미공개 경쟁사 페이지를 조사할 때 이는 중요한 문제입니다.
로컬 스크래퍼는 두 비용을 모두 제거합니다. 페이지를 자체 네트워크에서 가져오고 자체 CPU에서 정리합니다. 대신 설치와 노트북의 한계를 직접 감수해야 합니다.
Firecrawl Local 설치
Rust와 C 컴파일러가 필요합니다. macOS에서는 xcode-select --install로 컴파일러를 설치할 수 있고, Debian이나 Ubuntu에서는 build-essential을 설치하세요. Rust는 rustup에서 받습니다.
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
두 가지 추가 사항은 선택입니다. Chrome이나 Chromium이 있으면 JavaScript가 필요한 페이지를 렌더링할 수 있고, 없어도 정적 페이지는 작동하지만 스크립트가 많은 페이지는 경고와 함께 반환됩니다. MCP 서버에는 Node.js 22 이상이 필요한데, firecrawl-local mcp가 npx를 통해 firecrawl-mcp npm 패키지를 실행하기 때문입니다.
CLI에서 스크래핑, 크롤링, 맵핑하기
대부분의 에이전트 작업은 세 가지 명령으로 처리됩니다.
# One page as markdown
firecrawl-local scrape https://example.com --markdown

# Up to 50 pages, one markdown file each
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Every URL a site exposes
firecrawl-local map https://firecrawl.dev
저희는 2026년 11월 19일 클라우드를 끈 상태로 각각 실행했습니다. example.com 단일 스크래핑은 1.6초에 끝났습니다. Firecrawl 자체 문서에 대한 10페이지 크롤링은 4.2초가 걸렸고 144KB의 마크다운을 생성했습니다. map은 3.9초 만에 문서 URL 목록을 반환했습니다.
| 명령 | 유용한 플래그 |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (기본값 100), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| 모든 명령 | --browser auto|never|always |
저희 실행에서 발견한 한 가지 함정: 프록시를 통해서만 웹에 접근할 수 있는 네트워크에서는 첫 스크래핑이 TLS 오류로 실패했습니다. HTTPS_PROXY를 설정하니 해결되었고, 바이너리가 표준 프록시 환경 변수를 인식한다는 것을 확인했습니다.
MCP로 AI 에이전트에 연결하기
MCP(Model Context Protocol)는 에이전트 도구가 외부 도구를 로드하는 표준 방식입니다. Firecrawl Local은 자신을 그중 하나로 등록합니다.
firecrawl-local init --dry-run   # show what would change
firecrawl-local init             # write it, backing up each config first
저희 Mac에서의 드라이 런은 다섯 개의 대상이 나열되었습니다: ~/.claude.json의 Claude Code, Claude Desktop, ~/.cursor/mcp.json의 Cursor, ~/.gemini/settings.json의 Gemini CLI, ~/.codex/config.toml의 Codex입니다. Windsurf도 설치되어 있으면 지원합니다. init 후 각 도구를 재시작하면 서버를 로드합니다. --agent cursor를 사용하면 한 도구만 설정할 수 있습니다.
직접 추가하려면 바이너리를 stdio 서버로 등록합니다:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
에이전트는 표준 Firecrawl MCP 도구를 받습니다. 스크래핑, 크롤링, 맵핑, 배치 스크래핑은 로컬에서 실행되고 나머지는 Firecrawl Cloud로 갑니다. --public-only 플래그는 저희가 추가한 것이며, 아래 보안 항목에서 설명합니다.
프라이버시를 위해 클라우드 끄기
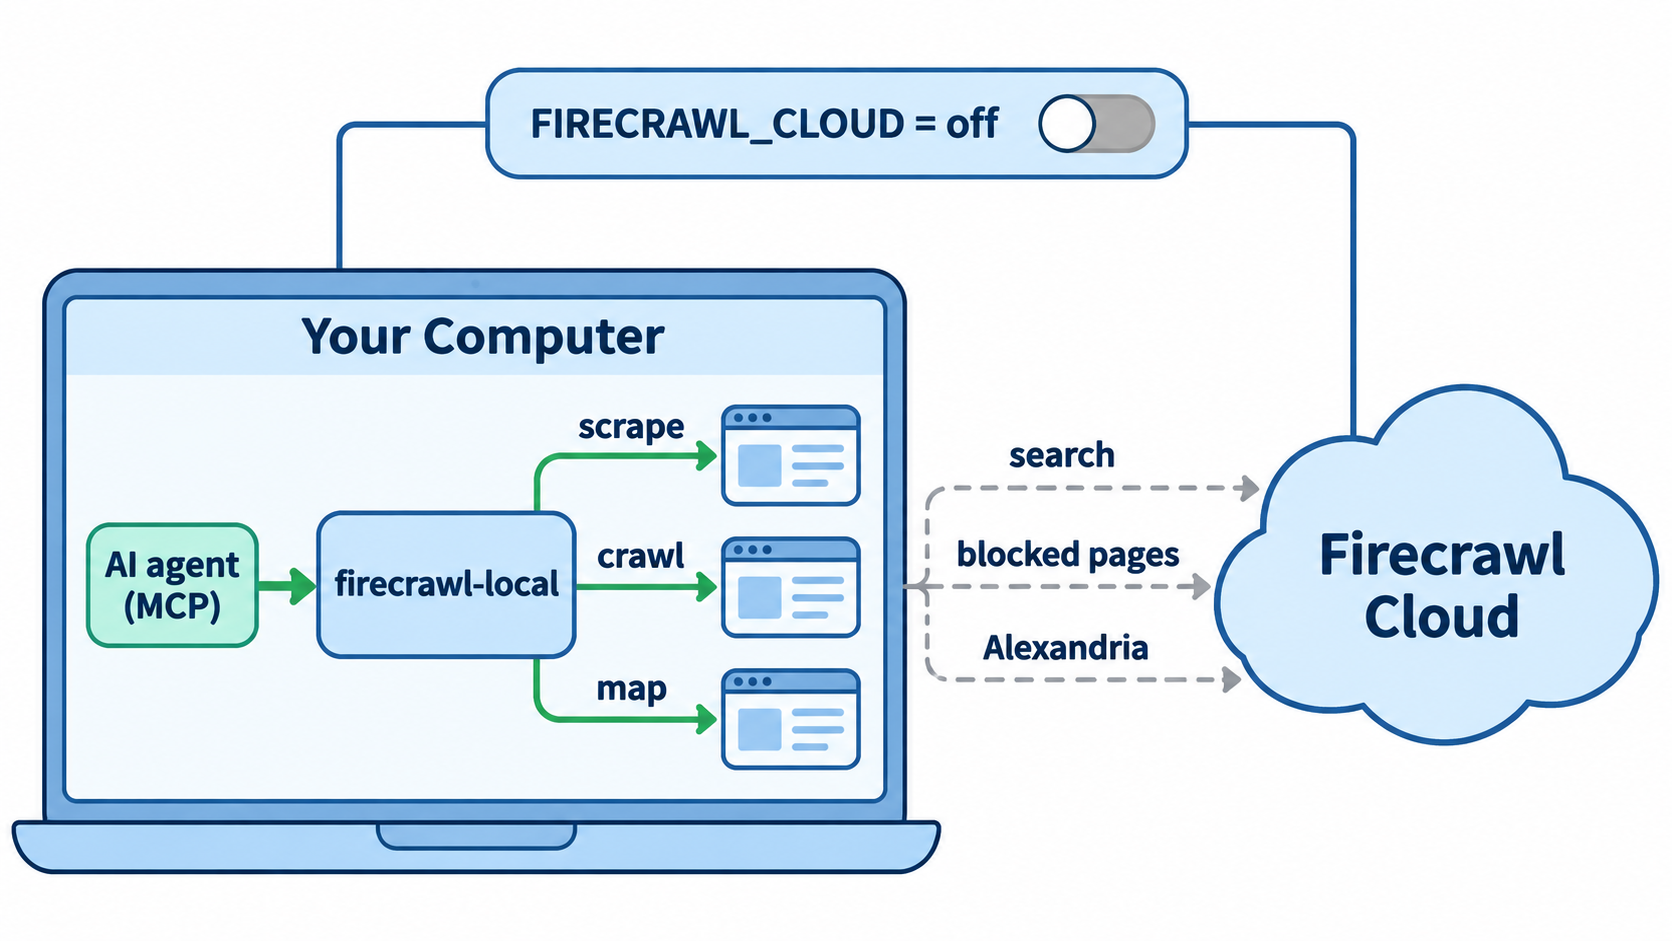
세 가지 작업은 Firecrawl Cloud가 필요합니다. 노트북에는 검색 인덱스도 없고 사이트 차단을 우회할 방법도 없기 때문입니다.
| Firecrawl Cloud로 전송되는 것 | 이유 | 계정 |
|---|---|---|
| 검색 쿼리 | 로컬 검색 인덱스가 없음 | 불필요; 키 없는 검색은 요청 수 제한 있음 |
| 차단한 페이지의 URL | 클라우드가 대신 가져옴 | 불필요 |
| Alexandria 데이터 제공자 | 제공자가 클라우드에서 실행됨 | 필요, firecrawl-local login으로 무료 계정 |
| 무작위 설치 ID와 도구 이름 | 설치 수 집계 | 불필요 |
FIRECRAWL_CLOUD 변수는 이 인계 방식을 제어합니다. auto(기본값)는 위의 모든 항목을 허용합니다. search는 검색 쿼리만 전송합니다. off는 아무것도 전송하지 않으며, 인식할 수 없는 값도 off로 간주됩니다. 클라우드에서 가져온 페이지에는 "source": "firecrawl-cloud"가 태그되어 무엇이 나갔는지 감사할 수 있습니다.
고객 사이트나 내부 조사 작업이라면 off로 시작하세요. 웹 검색을 잃게 되므로 이미 신뢰하는 검색 도구와 함께 사용하세요.
Firecrawl API를 로컬에서 실행하기
firecrawl-local serve는 로컬 라우트에 대해 API 키 없이 3002 포트에서 Firecrawl v2 API에 응답합니다. 기존 SDK 코드는 URL 하나만 바꾸면 됩니다.
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
로컬 라우트는 POST /v2/scrape, POST /v2/map, 상태 및 취소 엔드포인트가 있는 크롤링과 배치 스크래핑, 그리고 GET /health입니다. /v2/search처럼 다른 /v2 라우트는 클라우드로 전달됩니다. v0와 v1은 제공되지 않습니다.
실행 중 메모리를 측정했습니다. serve 프로세스는 유휴 상태에서 상주 메모리 10MB, 스크래핑 한 번 후 16MB였습니다. 이는 Firecrawl의 11MB 주장에 거의 부합합니다. API를 통한 스크래핑은 "creditsUsed": 0과 "engine": "local-fetch"를 반환했습니다.
에이전트에 중요한 보안 기본값
숨겨진 지시가 있는 페이지를 읽는 에이전트는 내부 URL을 가져오도록 조종당할 수 있습니다. OWASP는 이런 부류의 공격을 프롬프트 인젝션으로 분류하며, 스크래퍼는 그 경로로 쓰이기 쉽습니다.
serve는127.0.0.1에 바인딩되며,--allow-private를 전달하지 않는 한 localhost와 사설 주소를 거부합니다.127.0.0.1:22를 스크래핑하도록 요청하니BLOCKED_TARGET이 반환되었습니다.--host로 다른 호스트에 바인딩하려면--token이 필요합니다.- 링크 로컬과 클라우드 메타데이터 주소는 리다이렉트 후에도 모든 모드에서 차단됩니다.
scrape,crawl,mcp는 키보드 앞에 있는 사람을 위해 실행되므로 기본적으로 사설 네트워크에 접근할 수 있습니다. 신뢰할 수 없는 사이트를 탐색하는 에이전트에는--public-only를 추가하세요.- 크롤링은
robots.txt(RFC 9309 표준)를 읽으며, 사이트 소유자는FirecrawlLocal로 크롤러를 지정할 수 있습니다.
고려해야 할 한계
- 로컬에서는
json이나summary형식과 브라우저actions를 지원하지 않습니다.summary요청은 메타데이터와 형식이 건너뛰어졌다는 경고를 반환했습니다. - 스크린샷에는 Chrome이 필요합니다.
- 크롤링과 배치 작업은 메모리에 저장되며, 시작 1시간 후 만료되고
serve가 중지되면 종료됩니다. - 라이선스: 저장소는 AGPL-3.0입니다. 수정한 사본을 호스팅 제품에 포함해 배포하기 전에 법무팀과 상의하세요.
큐, 워커, 모든 형식에 대해서는 Firecrawl의 셀프 호스팅 가이드에서 전체 서버를 다룹니다.
팀의 모든 에이전트에게 동일한 스크래퍼 제공하기
에이전트가 하나인 개발자 한 명이라면 여기서 멈춰도 됩니다. 여러 에이전트를 운영하는 팀은 다른 문제에 부딪힙니다. 각 에이전트의 도구는 그것이 실행되는 컴퓨터의 설정에 존재하고, 어떤 에이전트가 웹을 읽을 수 있는지 아무도 추적하지 않습니다.
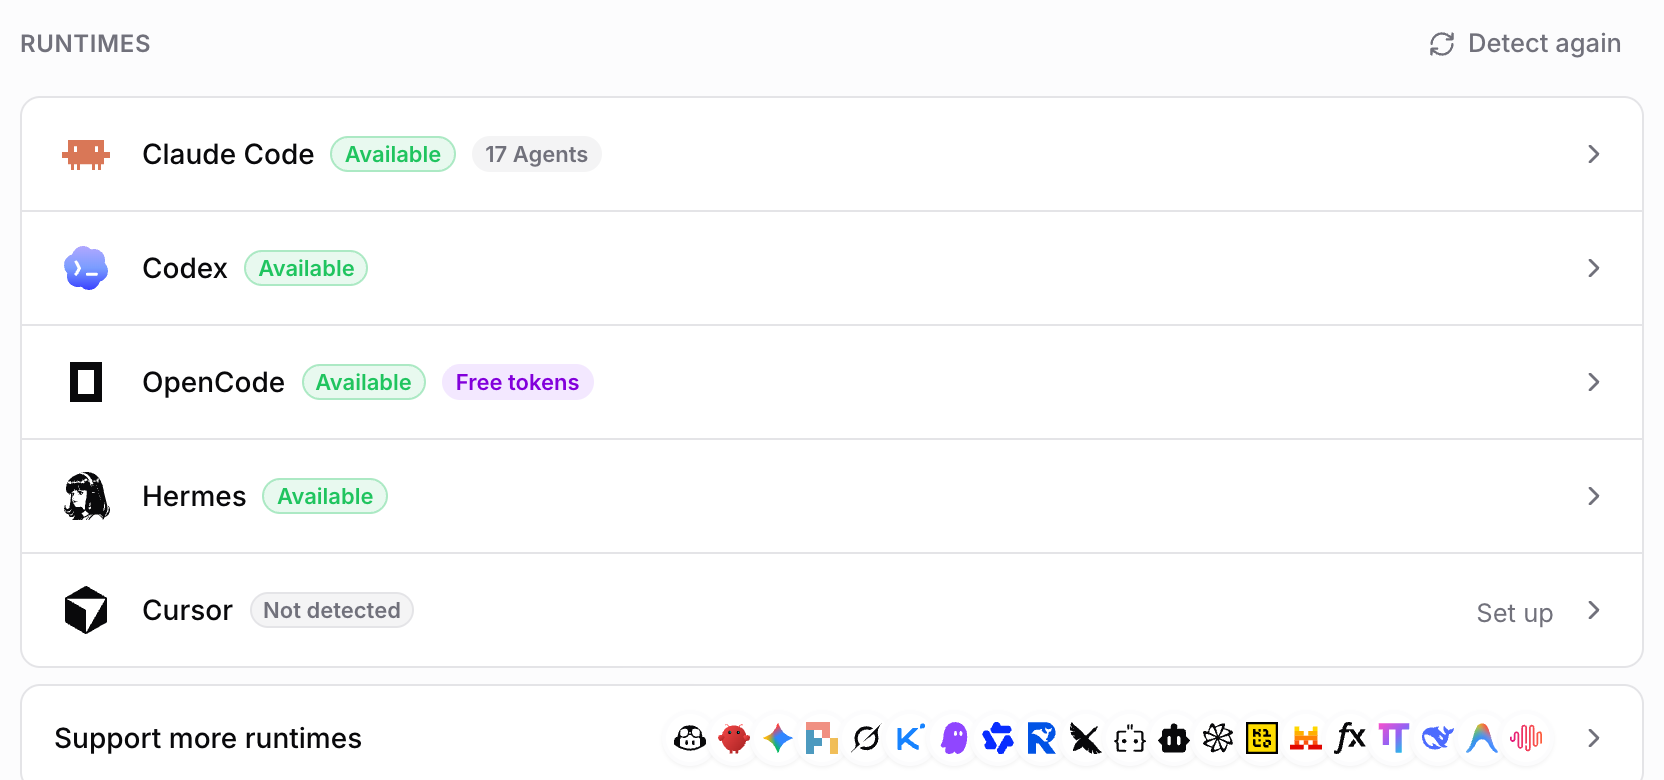
Sharkly에서는 Agent가 Runtime을 통해 Computer(연결한 노트북, 서버, 컨테이너)에서 실행되며, Runtime은 그곳에 설치된 에이전트 도구(예: Claude Code, Codex)입니다. 도구는 직접 사용할 때와 같은 방식으로 Computer에 설치합니다. 이후 Agent의 Tools, Knowledge & MCP 설정에 해당 Computer의 Claude Code에서 상속되는 MCP 서버가 나열되며, 여기에는 init이 기록하는 스코프인 사용자 설정 stdio 서버도 포함됩니다.
즉, 설정 방법은 다음과 같습니다: Computer에 Firecrawl Local을 설치하고 init을 실행한 뒤, Agent 설정을 열고 Check를 클릭합니다. 저희는 패널에 사용자 설정 stdio 서버가 나열되는 것을 확인했지만, Sharkly Task 내에서 Firecrawl 스크래핑을 아직 실행해 보지 않았으므로 먼저 읽기 전용 Task로 테스트하세요.
항상 켜져 있는 Computer에 스크래퍼 배치하기
노트북은 잠자기 상태가 됩니다. Computer로 등록한 작은 Linux 서버(Computers 문서에 따라 sit_ 설치 토큰으로 sharkly computer register 실행)는 계속 켜져 있으므로, 해당 서버를 가리키는 모든 Agent가 하나의 스크래퍼와 하나의 FIRECRAWL_CLOUD 정책을 공유합니다. 변수는 Agent의 Runtime 환경에 설정하여 마지막에 로그인한 사람이 아닌 Agent 자체에 정책이 따라다니게 하세요.
여기서부터 조사는 할당 가능한 작업이 됩니다. Crew 리더가 "이 다섯 업체의 문서를 맵핑하기"를 Task로 나누면 각 Agent가 자기 몫을 로컬에서 크롤링하고 결과가 사람 검토를 위해 보드에 올라갑니다. Sharkly는 현재 최대 5명 조직까지 무료이며, Agent와 Computer는 좌석을 차지하지 않고 모델은 여러분의 구독을 그대로 사용합니다.
실제 활용 사례
- 문서 수집: 에이전트가 의존성을 업그레이드하기 전에 라이브러리 문서를 마크다운으로 크롤링합니다.
- 리드 조사: 리드 목록 구축 튜토리얼처럼 로컬 스크래핑을 Alexandria 제공자와 함께 사용합니다.
- 체인지로그 모니터링: 예약된 Task가 매일 업체 사이트를 맵핑하고 새 URL을 표시합니다.
- 프라이버시 조사: 클라우드를 끄고 고객 페이지나 출시 전 페이지를 스크래핑하여 네트워크 밖으로 아무것도 내보내지 않습니다. 웹 검색을 꺼도 데이터 유출을 막을 수 없는 이유에 대한 저희 글에서 다른 유출 경로를 다룹니다.
결론
Firecrawl Local은 AI 에이전트를 위한 무료 웹 스크래핑을 6분 빌드와 init 명령 하나로 만들어 줍니다. 사적인 작업에는 FIRECRAWL_CLOUD=off를 유지하고, 신뢰할 수 없는 사이트에는 --public-only를 추가하며, 속도 주장은 직접 측정하기 전까지는 Firecrawl 측 수치로 취급하세요.
다음 단계: 에이전트가 이미 사용하는 Computer에 설치한 뒤, 해당 Computer를 Sharkly에 연결하여 팀의 모든 Agent가 동일한 스크래퍼와 동일한 규칙을 갖게 하세요. 더 많은 $0 설정은 팀을 위한 무료 AI 에이전트에서 확인하세요.
FAQ
Firecrawl Local은 무료인가요? 네. 스크래핑, 크롤링, 맵핑, 배치 스크래핑은 API 키 없이 로컬에서 실행되며, 저희 테스트 스크래핑은 크레딧 0 사용을 보고했습니다. 검색과 Alexandria는 Firecrawl Cloud를 사용합니다.
Firecrawl Local에 Docker가 필요한가요? 아니요. 데이터베이스, 큐, 컨테이너가 없는 단일 바이너리입니다. Docker는 선택 사항일 뿐이며, 컨테이너에서 JavaScript 렌더링을 하려면 Chrome 샌드박스를 허용하는 seccomp 프로필이 필요합니다.
firecrawl-local init이 지원하는 에이전트는 무엇인가요? Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI, Codex입니다. 다른 MCP 클라이언트는 firecrawl-local mcp를 stdio 서버로 등록할 수 있습니다.
모든 스크래핑을 Firecrawl 서버 밖에서 유지할 수 있나요? 네. FIRECRAWL_CLOUD=off로 설정하세요. 검색, 차단된 페이지 폴백, Alexandria를 잃게 됩니다.
Firecrawl Local이 자체 호스팅 Firecrawl보다 빠른가요? Firecrawl은 37배 빠르고 메모리는 230배 적다고 합니다. 저희는 유휴 메모리 10MB를 측정하여 메모리 주장과 부합함을 확인했으며, 자체 호스팅 서버와의 속도 벤치마크는 하지 않았습니다.
Firecrawl Local은 오픈 소스인가요? 저장소는 AGPL-3.0 라이선스입니다. 수정한 사본을 호스팅 서비스의 일부로 배포하기 전에 라이선스를 읽어보세요.


