

TL;DR: GPT-6.2 가격은 Astra가 입력 토큰 백만 개당 $8, 출력 토큰 백만 개당 $40이며, Sol은 각각 $2와 $10입니다. 캐시된 입력 읽기는 $0.40과 $0.10입니다. 예시로 든 20턴 에이전트 작업 하나는 프롬프트 캐싱이 작동할 때 Astra 기준 약 $3.23, Sol 기준 약 $0.81이 들고, 캐싱이 없으면 그 4배가 듭니다.
OpenAI가 2026년 11월 17일 GPT-6.2 Astra와 GPT-6.2 Sol을 출시했습니다. Astra는 가장 어려운 작업을 위한 프론티어 모델이고, Sol은 일상용 모델로 모델 페이지에서 “대규모 에이전트 구동”을 위해 만들어졌다고 설명합니다.
백만 토큰당 가격만으로는 에이전트 팀이 얼마를 쓸지 알기 어렵습니다. 에이전트는 매 턴마다 컨텍스트를 다시 전송하기 때문에 청구액은 캐싱, 컨텍스트 길이, 동시 실행 에이전트 수에 따라 달라집니다. 이 가이드는 GPT-6.2 가격표를 작업당·월별 비용으로 환산하고, 비용을 예측 가능하게 유지해 주는 상한선을 보여줍니다. 이미 코딩 에이전트를 나란히 운영하고 있다면 Sharkly에서 에이전트별로 상한선을 설정할 수 있습니다.
GPT-6.2 Astra와 Sol 가격
2026년 11월 20일 기준으로 확인한 Astra 모델 페이지와 Sol 모델 페이지의 표준 API 가격표입니다. 모든 가격은 백만 토큰당 금액입니다.
| 백만 토큰당 가격 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 입력 | $8.00 | $2.00 |
| 캐시된 입력 (읽기) | $0.40 | $0.10 |
| 캐시 쓰기 (30분 보관) | $10.00 | $2.50 |
| 캐시 쓰기 (12시간 보관) | $20.00 | $5.00 |
| 출력 | $40.00 | $10.00 |
| 컨텍스트 윈도우 | 1,050,000 | 1,050,000 |
Sol은 모든 항목에서 정확히 Astra의 4분의 1 비용입니다. 두 모델은 같은 컨텍스트 윈도우와 같은 속도 제한을 공유하므로, 청구서에서 이 둘을 가르는 것은 가격입니다.
총액을 좌우하는 가격 규칙
모델 페이지에 있는 다섯 가지 규칙이 기본 요율보다 에이전트 청구액을 더 크게 움직입니다:
- 긴 컨텍스트 추가 요금. 입력 토큰이 272K를 넘는 요청은 전체 요청에 대해 입력과 캐시는 2배, 출력은 1.5배를 지불합니다.
- 캐시 쓰기는 추가 비용이 듭니다. 프리픽스를 캐시에 쓰는 비용은 30분 보관 시 일반 입력의 1.25배, 12시간 보관 시 2.5배입니다.
- 캐시 읽기는 저렴합니다. GPT-6.2에서 캐시 읽기는 OpenAI의 프롬프트 캐싱 가이드에 따르면 일반 입력의 0.05배입니다.
- Batch는 표준 요율의 50%입니다.
- 속도에는 비용이 듭니다. Fast 모드는 표준 요율의 2배입니다. Ultrafast는 2027년 2월 28일까지 3배, 2027년 3월 1일부터 6배입니다.
GPT-6.2는 Flex 처리를 지원하지 않습니다. 그 대체재는 할인된 백그라운드 완료 윈도우로, 아래에서 다룹니다.
GPT-6.2에서 에이전트 작업 하나의 비용
예시 코딩 작업 하나를 가정해 보겠습니다: 20턴, 턴당 입력 토큰 60,000개, 턴당 출력 토큰 2,000개입니다. 전체 작업으로는 입력 토큰 120만 개, 출력 토큰 40,000개입니다. 실제 수치는 다를 테니 여러분의 수치로 바꿔 계산해 보세요.
| 시나리오 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 캐시 히트 없음 | $11.20 | $2.80 |
| 캐시 히트 90% | $3.23 | $0.81 |
| 캐시 히트 90%, 8시간 백그라운드 윈도우 | $1.94 | $0.49 |
캐시 행은 입력의 90%를 캐시에서 읽고 나머지 10%는 30분 캐시 쓰기로 청구된다고 가정합니다. 이는 비관적인(최악에 가까운) 경우이므로, 실제 캐시 실행은 이 수치와 같거나 낮아야 합니다.
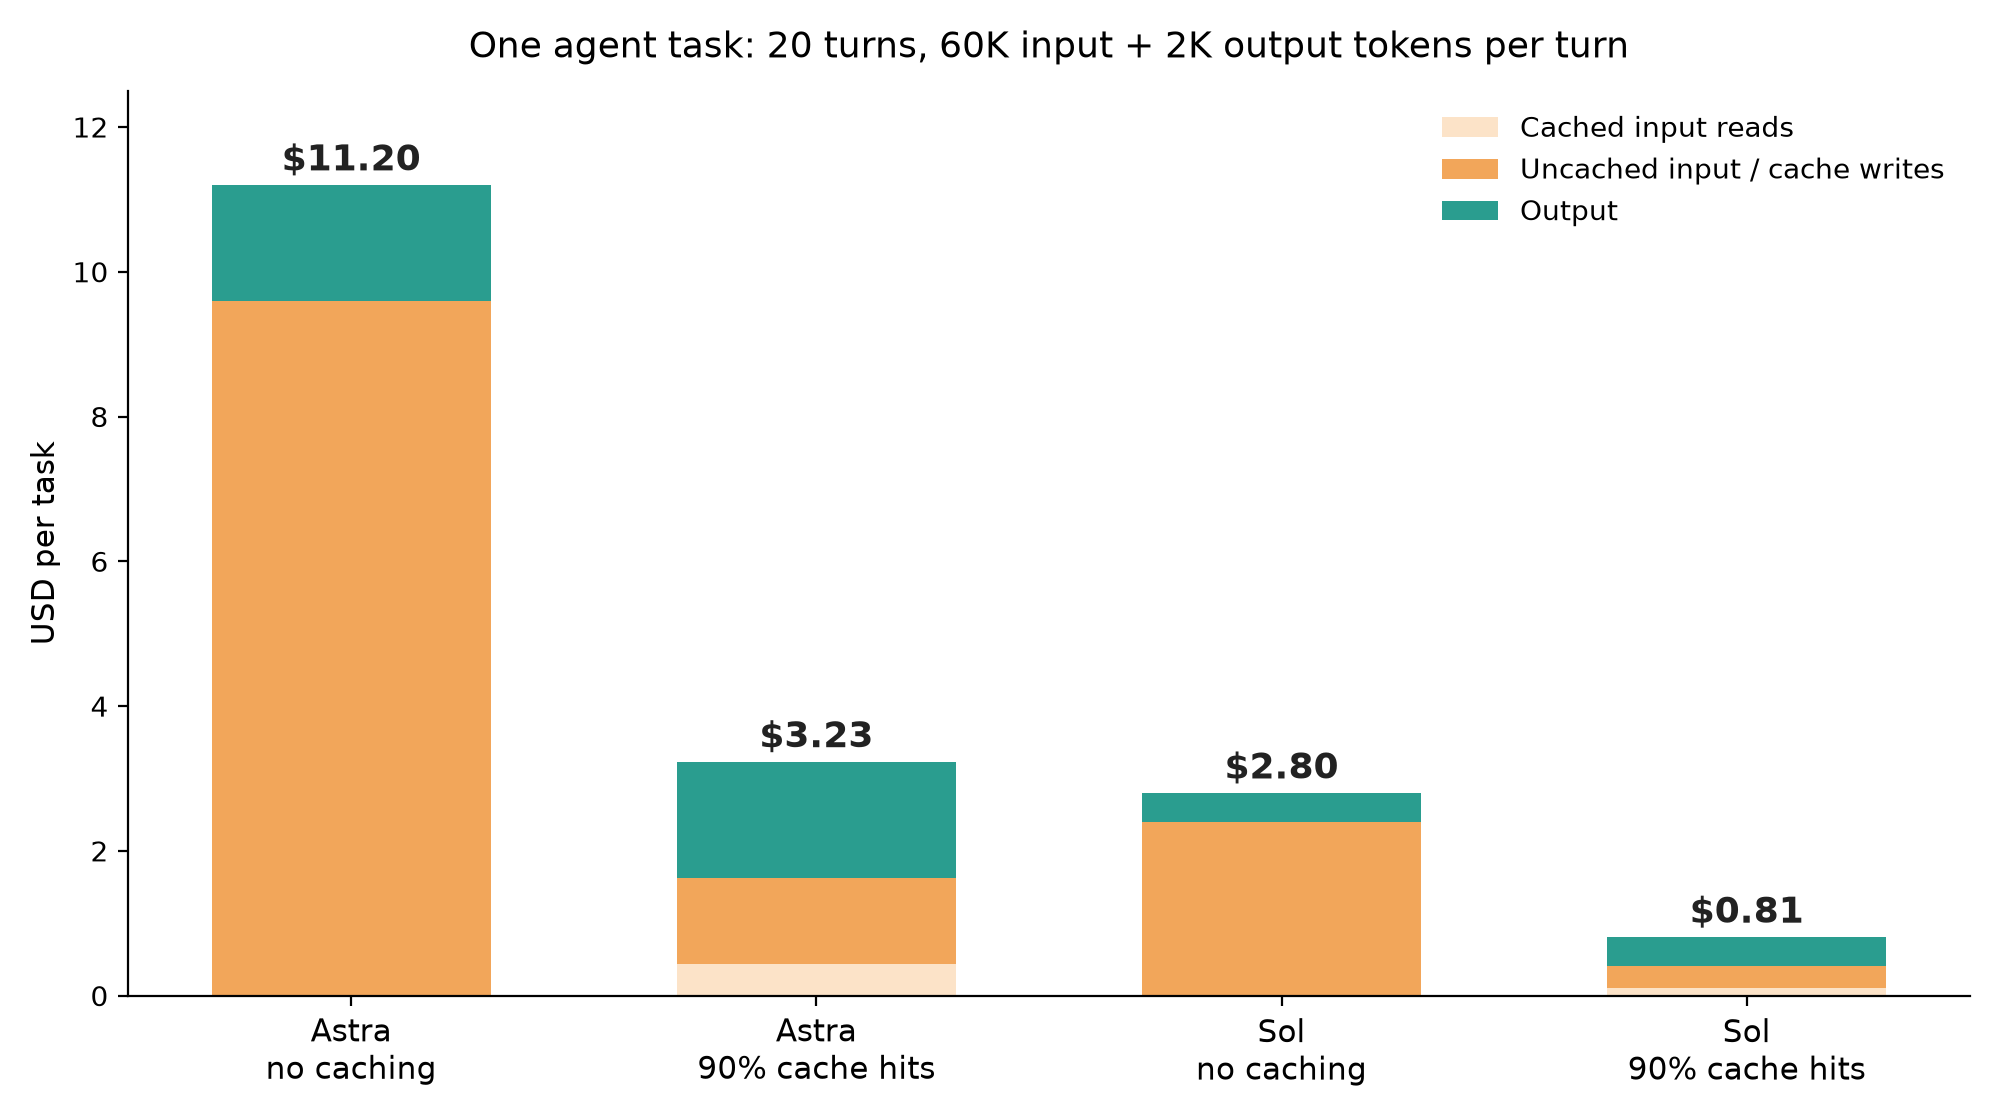
주목할 수치가 두 가지 있습니다. 캐싱은 두 모델 모두에서 작업 비용을 약 71% 줄입니다. 그리고 캐시가 작동하는 Astra 작업은 캐시 없는 Sol 작업과 비용이 거의 비슷합니다. 캐시가 깨진 저렴한 모델은 캐시가 잘 되는 비싼 모델과 비용이 거의 같습니다.
긴 컨텍스트 추가 요금이 때리는 지점
저장소의 절반을 읽는 코딩 에이전트는 턴당 입력 토큰 272K를 넘을 수 있습니다. 출력 2,000개, 캐시 없음 조건으로 Sol의 두 턴을 비교해 보겠습니다:
- 입력 토큰 270,000개: 입력 $0.54 + 출력 $0.02, 총 $0.56.
- 입력 토큰 300,000개: 입력 $1.20 + 출력 $0.03, 총 $1.23.
컨텍스트가 11% 커졌을 뿐인데 비용은 2배 이상입니다. 에이전트 하네스가 컨텍스트를 압축한다면 272K 미만으로 유지하세요. 저렴한 모델이 더 비쌉 수 있는 이유에 대한 글도 같은 논리에 기반합니다: 토큰당 가격보다 수용된 변경당 가격이 중요합니다.
월간 에이전트 팀의 GPT-6.2 비용
이제 캐시 기준 수치를 확장해 보겠습니다. 에이전트 5개가 하루 8개 작업씩 22근무일 동안 완료한다고 합시다. 한 달에 880작업입니다.
| 팀 구성 | 월간 작업 수 | 월간 모델 비용 |
|---|---|---|
| 5개 에이전트 모두 Astra | 880 | $2,842 |
| Astra 리드 1개, Sol 에이전트 4개 | 176 + 704 | $1,139 |
| 5개 에이전트 모두 Sol | 880 | $713 |
혼합 구성은 전부 Astra일 때보다 60% 저렴합니다. 프론티어 모델은 계획 수립과 어려운 리뷰에 유지하고, 일상 작업은 Sol로 보내는 방식입니다. 리드 역할은 GPT-6 Astra를 크루 리더로에서, 같은 논리는 같은 예산으로 더 많은 에이전트, GPT-6 Sol에 담겨 있습니다.
가격은 하나의 상한일 뿐입니다. 낮은 사용량 등급에서는 돈보다 분당 토큰 수가 먼저 에이전트 팀을 멈추게 하는데, GPT-6.2 속도 제한 가이드가 이를 등급별로 정리해 줍니다.
Codex 플랜과 API 키 비교
에이전트가 ChatGPT 플랜의 Codex를 사용한다면 토큰당 지불하는 것이 아니라 할당량을 소비합니다. Codex 가격 페이지에 따르면 GPT-6.2 Astra는 Plus 및 Standard Business에서 5시간 윈도우당 로컬 메시지 6~50개, Sol은 17~180개로 추정됩니다. 긴 세션은 할당량을 더 빨리 소진하므로, 위의 토큰 계산은 여전히 어떤 작업이 먼저 한도에 도달하는지 예측해 줍니다.
GPT-6.2 Codex 가이드에서 두 모델의 설정 방법을 다룹니다.
에이전트 팀의 GPT-6.2 비용 줄이는 방법
아래 순서는 가장 많은 돈을 아끼는 것부터 나열한 것입니다:
- 캐싱이 작동하게 만드세요. 안정적인 지침은 입력 앞부분의
developer메시지에 넣고, 이전 턴을 절대 재작성하지 마세요. 프리픽스가 바뀌면 캐시 미스입니다. - 기본값은 Sol로 하세요. 작업이 여러 서비스에 걸치거나 Sol이 같은 유형의 작업을 두 번 실패할 때만 Astra로 승격하세요.
- 요청당 입력 토큰을 272K 미만으로 유지하세요.
- 자체 하네스에서 API를 호출할 때는 대량 작업을 백그라운드 윈도우로 보내세요.
- 평가와 오프라인 작업에는 Batch를 사용하고, 대화형 에이전트에는 절대 사용하지 마세요.
- Fast와 Ultrafast는 누군가 결과를 기다리고 있지 않다면 끄세요.
Flex를 대체하는 할인 백그라운드 윈도우
OpenAI의 백그라운드 모드 가이드는 Responses API에서 GPT-6.2 기준 공개 베타로 제공되는 두 가지 할인 완료 윈도우를 나열합니다: 표준보다 30% 낮은 2h와 40% 낮은 8h입니다. 이들은 라이브 토큰 한도가 아닌 Batch 속도 제한을 공유합니다.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
나중에 응답 ID를 폴링하거나 웹훅을 사용하세요. 아침 전까지 아무도 필요로 하지 않는 테스트 생성, 의존성 업그레이드, 문서 점검에 적합합니다.
Sharkly에서 에이전트별 GPT-6.2 지출 관리
Sharkly는 토큰을 재판매하지 않습니다. 각 실행은 Runtime에 이미 연결된 Codex 플랜이나 API 키로 청구되므로, OpenAI 청구서가 단일한 진실의 원천으로 유지됩니다. Sharkly가 주는 것은 그 청구서로 흘러가는 작업량에 대한 통제입니다.
각 Agent에는 해당 Runtime이 보고하는 모델을 나열하는 Default model 행이 있습니다. 일상 Agent는 Sol로, 리드 Agent는 Astra로 설정하세요. 특정 작업이 더 필요할 때는 Sharkly 문서에 설명된 작업별 재정의를 사용할 수 있습니다: 담당자 선택기에서 Agent 위에 마우스를 올리고 해당 실행에만 적용할 모델을 고르면 됩니다.
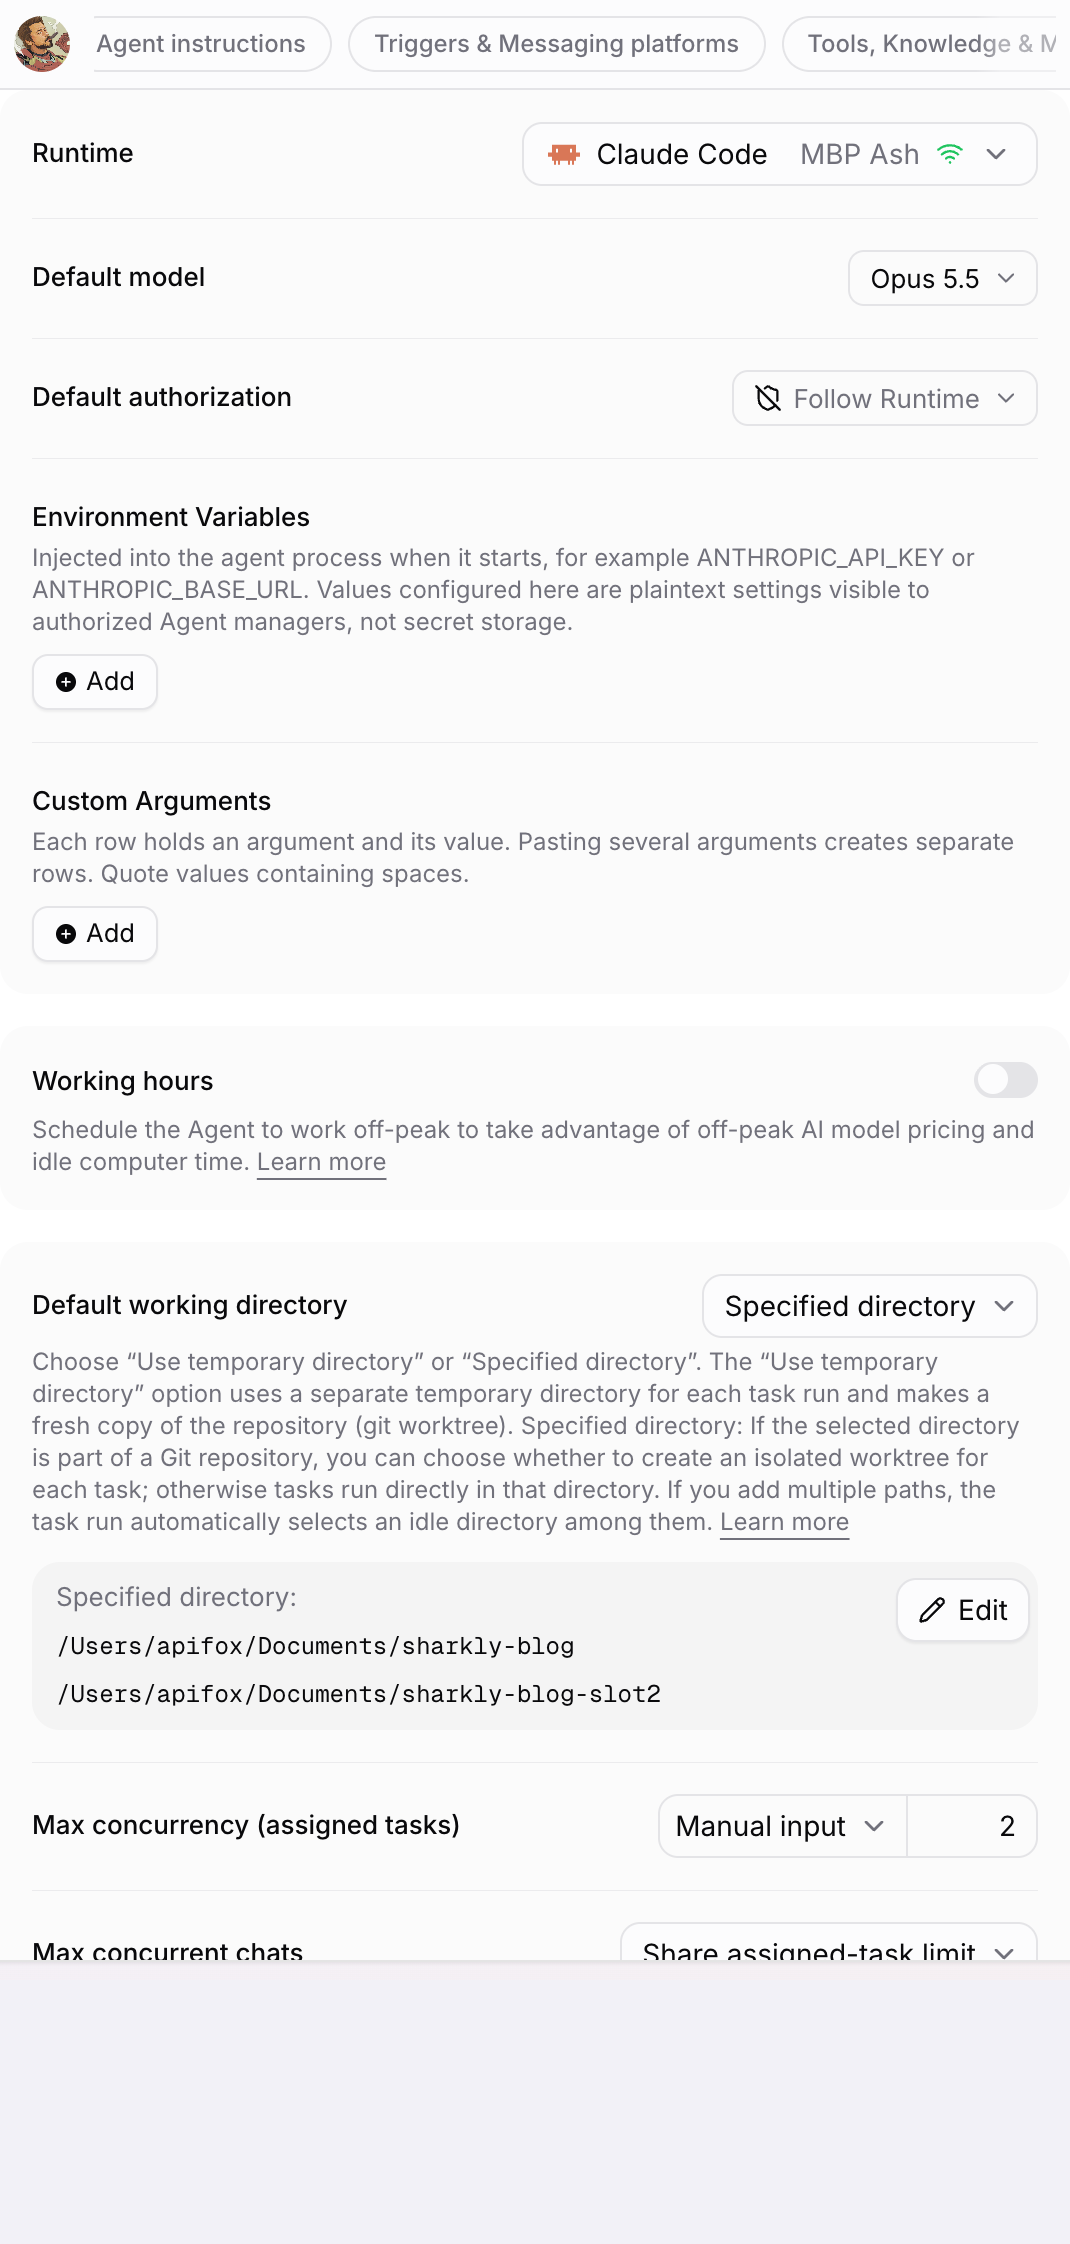
같은 패널에는 시작 시 에이전트 프로세스에 주입되는 Environment Variables도 있습니다. 각 Agent 그룹에 자체 OpenAI 프로젝트의 API 키를 부여하면 OpenAI 사용량 페이지가 그룹별로 지출을 분리해 보여줍니다. Working hours는 Agent를 비혼잡 시간대에 예약해, 대량 작업이 밤에 실행되고 낮의 용량은 기다리는 사람들을 위해 남겨두게 합니다.
지출에는 상한도 필요합니다. Max concurrency는 Agent가 동시에 실행하는 작업 수를 제한하고, Max run duration은 무한 루프에 빠진 실행을 멈추며, Queue timeout은 너무 오래 기다린 작업을 폐기합니다.
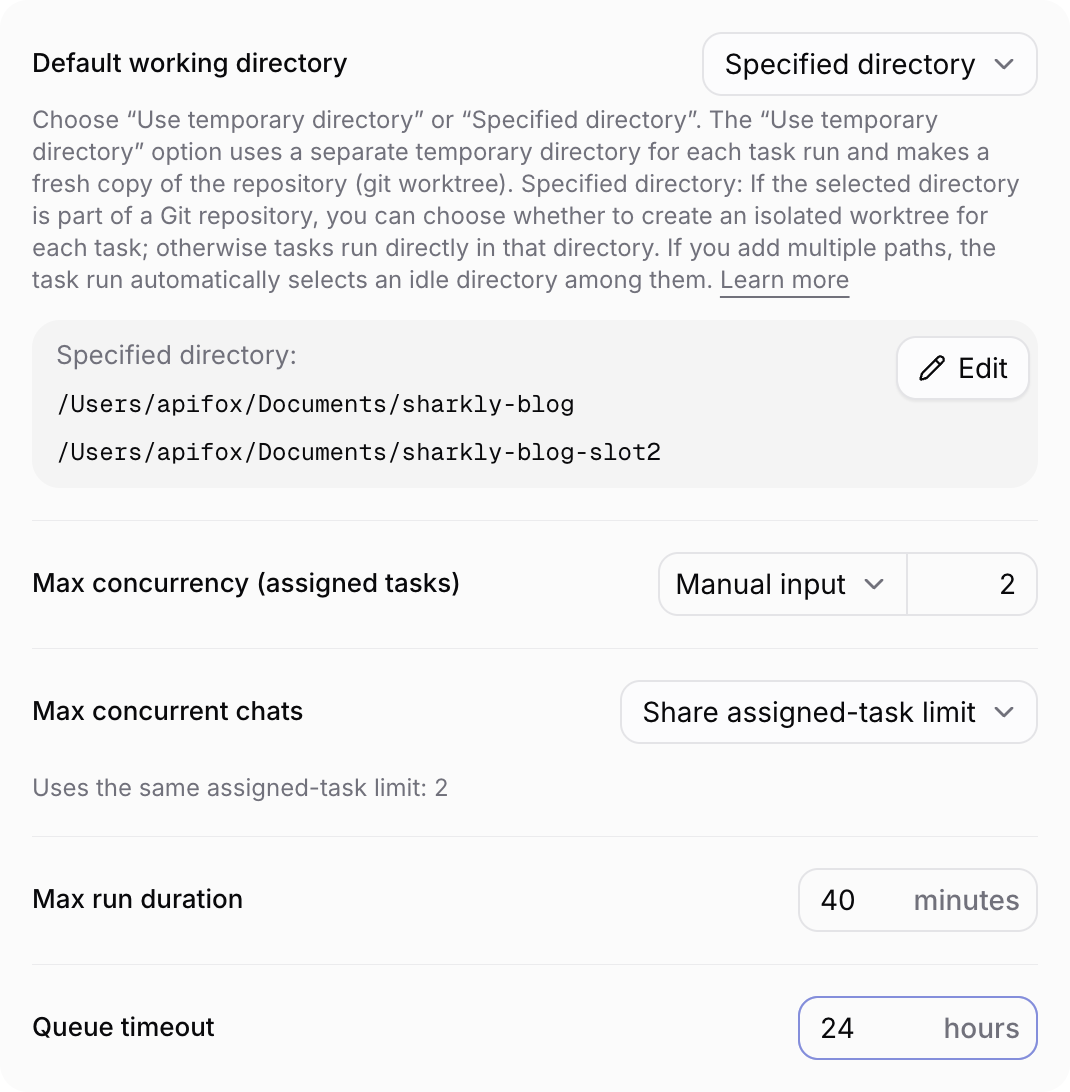
Sol Agent에 40분 실행 상한을 두면 최악의 경우가 한정됩니다. 각 Agent의 실행 목록은 모든 실행이 사용한 토큰을 보여주므로, 다른 작업의 3배를 태우는 작업 유형을 찾아낼 수 있습니다. 그런 작업에는 더 엄격한 설명이나 더 저렴한 모델이 필요합니다.
결론
GPT-6.2 가격은 단순해 보입니다: 모든 항목에서 Astra는 Sol의 4배입니다. 그러나 에이전트 청구서는 단순하지 않습니다. 캐싱은 작업 비용을 약 71% 움직이고, 272K 임계값은 한 턴의 비용을 2배로 만들 수 있으며, 동시성은 그 모든 것을 곱합니다. 실제 작업 하나를 측정하고, 캐시 히트율을 높이고, 일상 작업은 Sol에 맡기고, 동시 실행 수에 상한을 두세요.
먼저 Agent 하나에서 시도해 보세요. Computer를 연결하고, GPT-6.2 Sol로 Codex Agent를 만들고, Max concurrency를 2, Max run duration을 40분으로 설정한 뒤 일상 작업을 하나 할당하세요. 그리고 실행의 토큰 수를 확인하세요. 여러 에이전트 팀 운영에 대해서는 AI 코딩 에이전트 10개 동시에 실행하는 방법을 참고하세요.
FAQ
GPT-6.2 비용은 얼마인가요?
GPT-6.2 Astra는 입력 토큰 백만 개당 $8, 출력 토큰 백만 개당 $40입니다. GPT-6.2 Sol은 $2와 $10입니다. 캐시된 입력 읽기는 Astra $0.40, Sol $0.10입니다.
GPT-6.2 Sol이 Astra보다 저렴한가요?
네. Sol은 입력, 출력, 캐시 읽기, 캐시 쓰기 모두 Astra의 4분의 1 비용입니다. 두 모델 모두 1,050,000 토큰 컨텍스트 윈도우와 동일한 속도 제한을 공유합니다.
GPT-6.2 긴 컨텍스트 가격은 무엇인가요?
입력 토큰이 272K를 넘는 요청은 임계값을 넘는 토큰만이 아니라 전체 요청에 대해 입력과 캐시는 2배, 출력은 1.5배를 지불합니다.
GPT-6.2는 Flex 처리를 지원하나요?
아니요. OpenAI는 장시간 작업을 할인된 백그라운드 완료 윈도우로 안내합니다: 공개 베타로 제공되는 30% 할인 2h와 40% 할인 8h입니다.
GPT-6.2 Batch 비용은 얼마인가요?
Batch는 두 모델 모두 표준 요율의 50%입니다. 평가와 오프라인 작업에는 적합하지만 대화형 에이전트에는 적합하지 않습니다.
Sharkly는 GPT-6.2 토큰에 대해 요금을 청구하나요?
아니요. Sharkly는 이미 사용 중인 코딩 에이전트를 실행하며, 모델 사용량은 여러분의 Codex 플랜이나 API 키로 청구됩니다. Sharkly는 각 Agent가 사용할 모델과 동시에 실행할 작업 수를 통제합니다.


