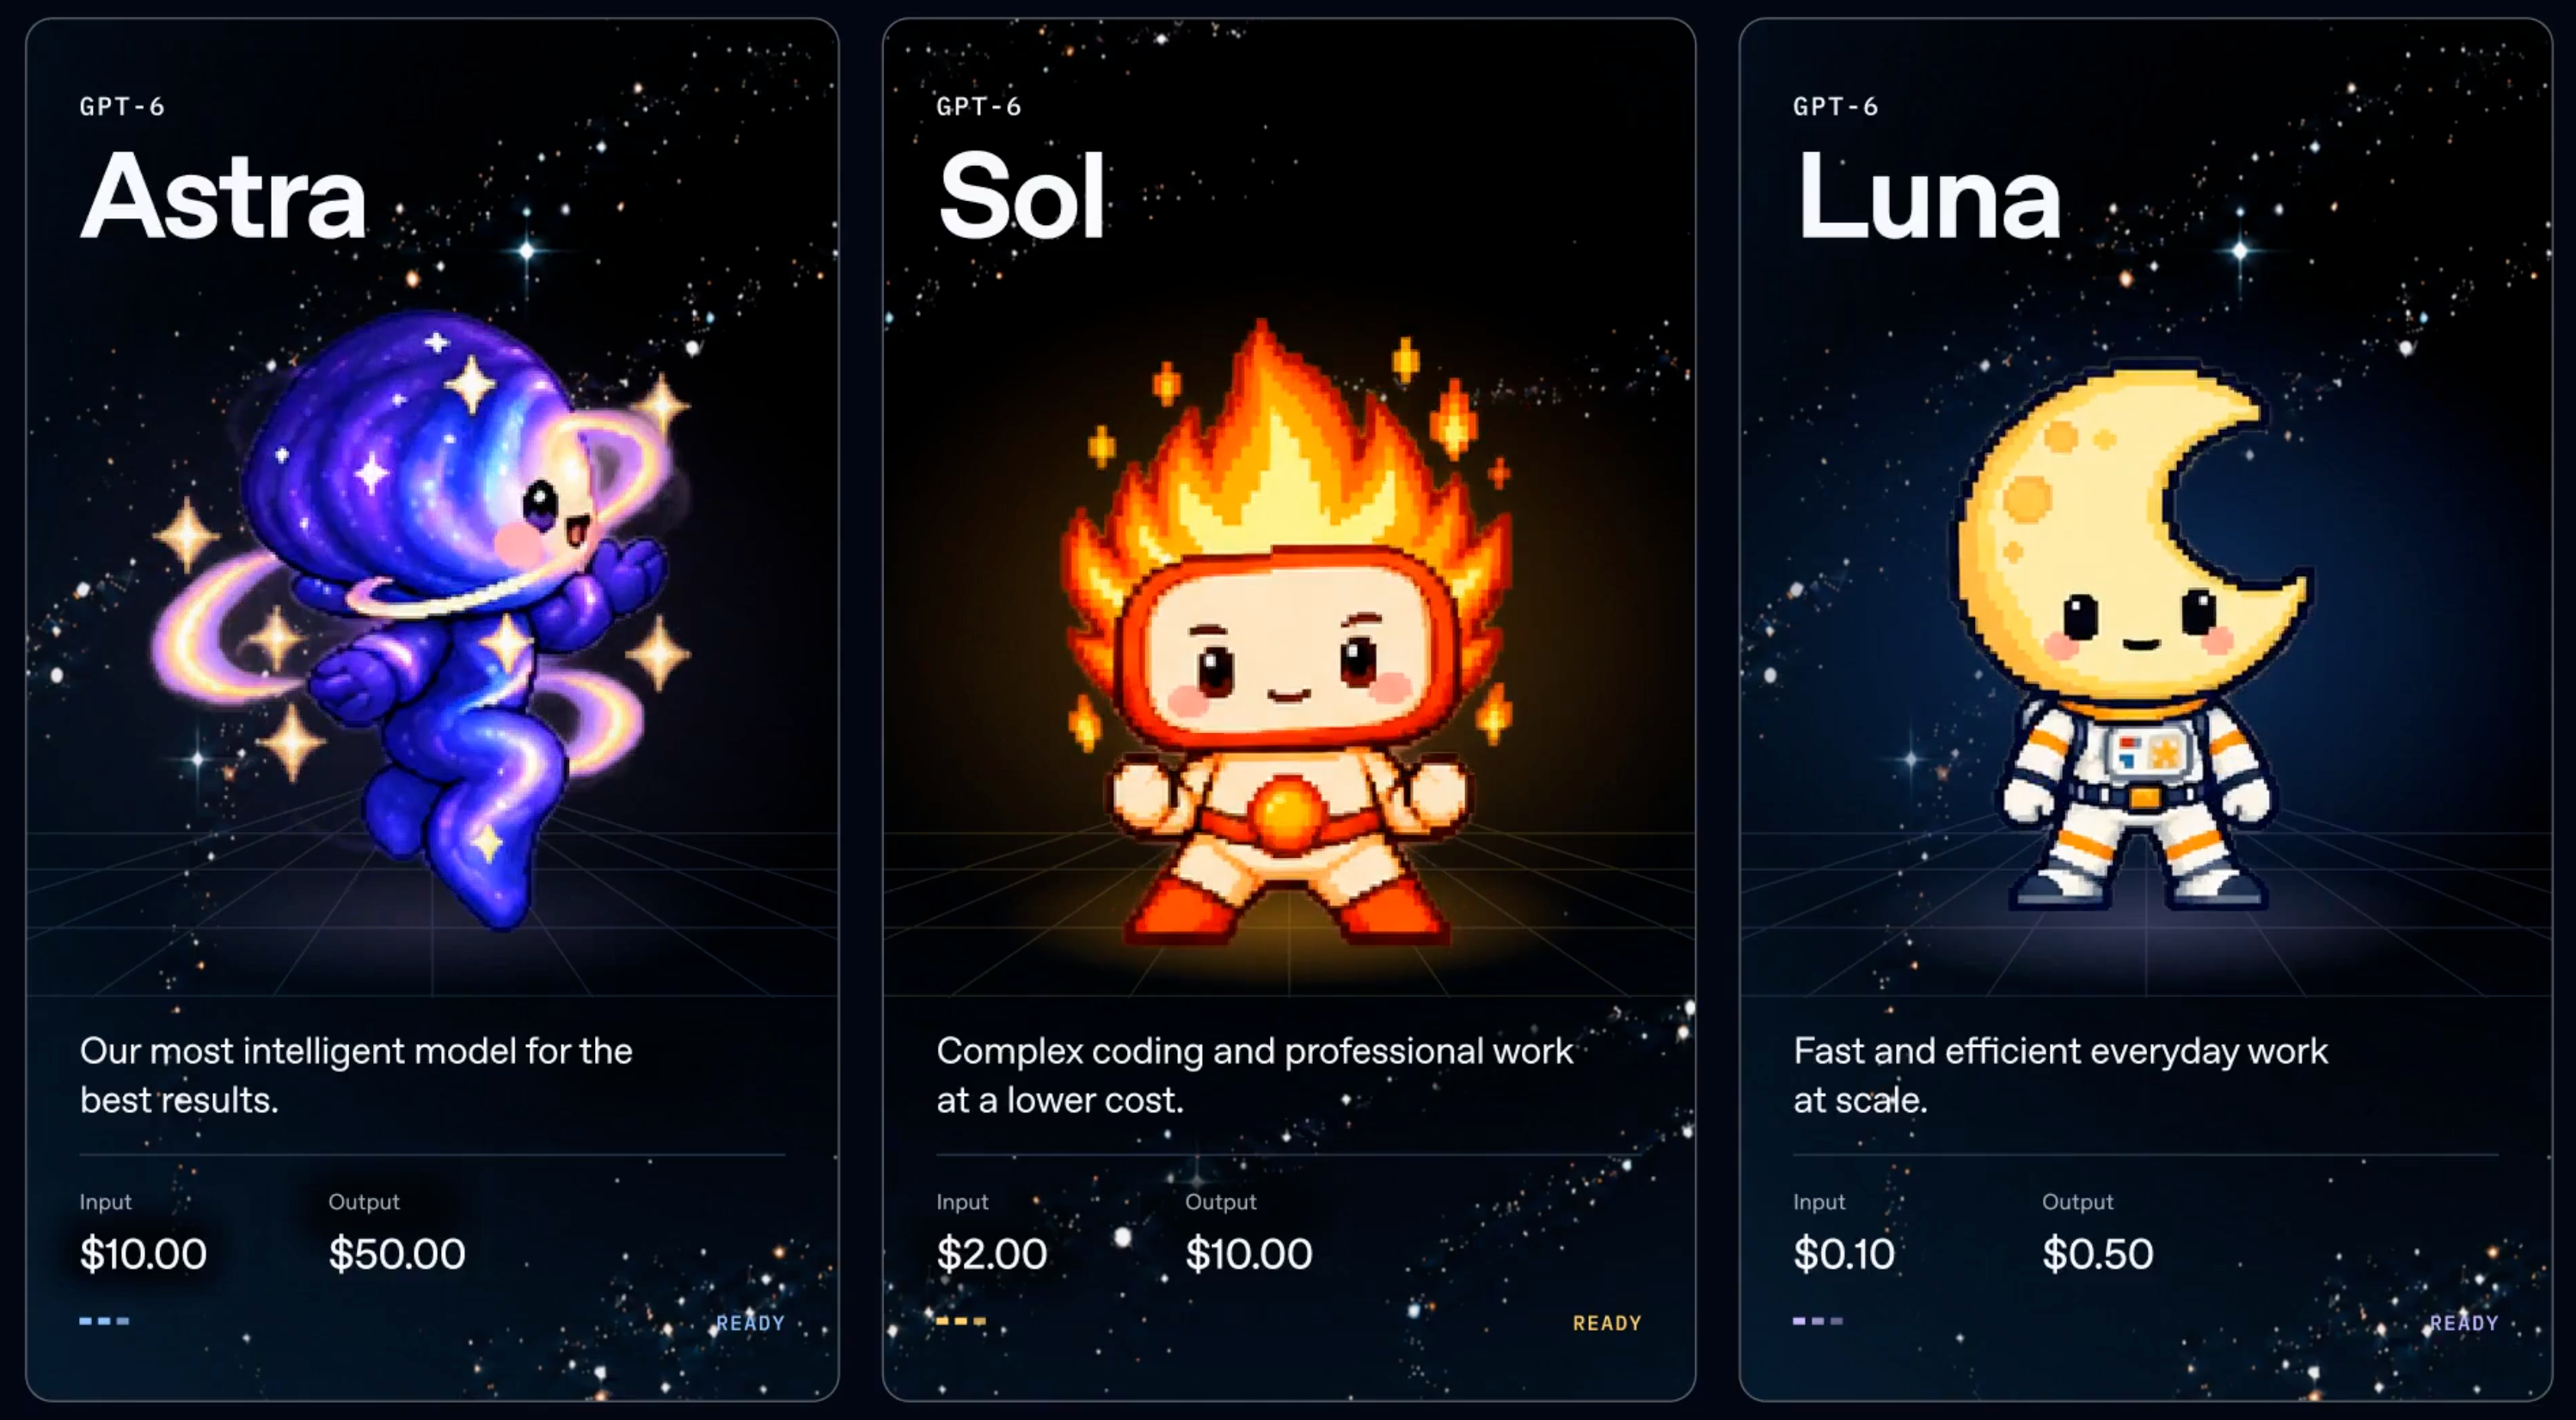
청구서에 찍히는 숫자는 가장 줄이기 쉬운 수치이면서, 동시에 실질적으로는 가장 의미 없는 수치이기도 합니다. 팀의 일상적인 업무를 100만 토큰당 0.10달러와 0.50달러인 GPT-6 Luna로 라우팅하면, 모델 사용료 항목은 단 하루 만에 급감합니다. 2주가 지나도 청구서 금액은 여전히 낮고, 대시보드에는 완료된 실행(run) 건수가 그 어느 때보다 가득하지만, 지난 화요일에 올라온 변경 사항 네 건은 여전히 누군가의 승인을 기다리고 있습니다.
무언가 잘못된 것은 아닙니다. 그저 매일 확인하던 비용 항목에서 아무도 가격을 매기지 않는 항목으로 비용을 옮겨 놓았을 뿐입니다.
승인된 변경 사항당 비용(Cost per accepted change)은 사람이 승인한 하나의 변경 사항을 만들기 위해 시도된 모든 실행에 들어간 금액과 사람의 시간을 합산한 총비용입니다. 여기에는 실패한 실행, 아무도 머지(merge)하지 않은 코드 결과물, 그리고 이 둘을 검토하고 판단하느라 소모된 엔지니어의 시간이 모두 포함됩니다. 어떤 모델 제공업체도 이 수치를 공개하지 않고, 어떤 벤치마크도 이를 측정하지 않지만, 팀의 실제 제품 출시 속도와 맞물려 움직이는 숫자는 오직 이것뿐입니다.
요약 (TL;DR)
더 저렴한 모델을 쓰면 1회 시도당 비용은 낮아지지만, 리뷰어의 집중력이라는 비용을 치러야 하는 세 가지 요소가 늘어납니다. 바로 배포된 변경 사항당 시도 횟수, 1회 시도당 출력량, 그리고 배포된 변경 사항당 내려야 하는 의사결정의 수입니다. 2026년 9월 22일 모델 가격이 내려갔다고 해서 사람의 주의력까지 덩달아 저렴해진 것은 아닙니다. 저가형 모델은 머신이 시도의 성공 여부를 직접 판정할 수 있는 곳에서는 확실히 비용을 아껴주지만, 사람이 개입해 판단해야 하는 영역에서는 조용히 막대한 비용을 발생시킵니다. 에이전트는 조사하고, 실행하고, 테스트하고, 보고합니다. 사람은 방향을 설정하고, 권한을 부여하며, 결과를 승인합니다. 따라서 해결책은 라우팅 규칙을 바꾸기 전에 회계 기준부터 바꾸는 것입니다. Runtime별로 승인된 변경 사항당 시도 횟수와 사람의 검토 시간(분)을 측정하고, 사람의 승인을 기다리는 작업을 '금요일 오후에나 느끼는 막연한 답답함'이 아니라 '정량적으로 셀 수 있는 명확한 상태'로 만드세요.
세 가지 측정 단위, 그리고 팀에 진짜 중요한 단 하나
| 단위 | 주요 사용자 | 알려주는 정보 | 누락된 내용 |
|---|---|---|---|
| 100만 토큰당 | 모델 제공업체 가격 페이지 | 입력 및 출력 토큰 비용 | 해당 작업에 실제로 필요한 토큰 수 |
| 완료된 작업(Task)당 | 벤치마크 평가표 | 점수가 매겨진 1회 시도의 비용 | 실패한 시도, 실제 코드베이스 환경, 사람의 리뷰 과정 |
| 승인된 변경 사항당 | 개발 팀 | 배포된 변경 사항 1건의 엔드투엔드 총비용 | 빠져 있는 내용 없음 (업체들이 이를 공개하지 않는 이유) |
두 연구소 모두 2026년 9월 22일에 모델을 출시하며 중간 열(완료된 작업당 비용) 기준으로 수치를 발표했습니다. 하지만 그 표들을 마치 우측 열의 수치인 것처럼 해석해서는 안 됩니다.
저가형 모델의 실제 비용과 벤치마크 점수
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| API id | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| Input / output per 1M | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| Cached input | 90% off reads | 90% off reads | $0.20 read, $5 write |
| Context | 1M | 872k | 1M |
| DeepSWE 1.1 at max reasoning | 66.6% | 68.8% | Not in the launch material |
| Artificial Analysis index | 37 | 48 | 58, first of 212 |
Anthropic은 Opus 5.5의 AutomationBench 성능을 40.0%로 발표했습니다. OpenAI는 Sol의 최대 추론(extra high reasoning) 설정 기준 AutomationBench 1.0.6 점수를 33.2%, 작업당 비용을 0.27달러로 보고했습니다. 두 개의 연구소, 두 개의 서로 다른 테스트 환경, 그리고 각자 공개한 작업당 비용 하나씩. 이 둘은 1:1로 직접 비교할 수 있는 대상이 아니며, 그렇게 비교할 수 없다는 사실 자체가 핵심입니다. 어떤 벤더가 제공하는 표로도 승인된 변경 사항당 비용을 계산해낼 수는 없습니다.
숨겨진 변수 1: 승인된 변경 사항당 시도 횟수
OpenAI 발표에 따르면 최대 추론 설정 시 DeepSWE 1.1 점수는 Luna가 66.6%, Sol이 68.8%입니다. 산술적으로 따져보면 Luna의 시도 중 세 번에 한 번꼴로 통과 결과를 얻지 못한다는 뜻입니다. 여러분의 코드베이스는 DeepSWE 벤치마크와 다르고 통과율도 차이가 나겠지만, 본질적인 구조는 같습니다. 벤치마크 점수가 몇 점 낮은 저가형 모델은 실행당 성능이 '약간' 떨어지는 데 그치지 않고, 다시 실행해야 하는 결과물을 넘겨줄 확률이 '그만큼' 더 높아진다는 점입니다.
다시 실행하는 데 드는 모델 비용 자체는 여전히 미미합니다. OpenAI는 동일 벤치마크에서 최대 추론 설정의 Luna가 Claude Opus 5보다 작업당 비용이 93% 더 저렴하다고 밝혔습니다. 시도 횟수를 두 배로 늘려도 산술적으로는 여전히 86%가량 저렴합니다. 모델 청구서 자체가 문제가 되는 일은 결코 없습니다.
하지만 실패한 시도는 다른 지점에서 결코 공짜가 아닙니다. 실패한 시도 역시 브랜치와 변경 사항 요약을 만들어내고, 결국 사람이 내려야 할 의사결정을 남깁니다. 실패한 실행은 비용이 0인 무(無)가 아닙니다. 마지막에 적용할 변경 사항도 없으면서 사람의 시간만 잡아먹는 리뷰 일감일 뿐입니다.
숨겨진 변수 2: 저가형 모델은 더 오래 생각해야 똑똑해진다
Luna의 준수한 점수가 어디서 나오는지 살펴볼 필요가 있습니다. 66.6%라는 수치는 '최대 추론' 설정 기준이며, OpenAI의 팩트 노트에 따르면 Luna는 더 높은 추론 노력을 들여야 GPT-5.6 Sol의 성능을 약 100분의 1 비용으로 따라잡습니다. 저가형 모델이 납득할 만한 품질을 내려면 더 많은 노력을 투입해야 하고, 그 노력은 고스란히 출력 토큰 수와 처리 시간(wall clock time)의 증가로 이어집니다.
양대 벤더가 아닌 제3자 기관 Artificial Analysis의 측정에 따르면, 최대 추론 버전 기준 초당 출력 토큰 수는 Luna가 153.9개(첫 번째 토큰 생성까지 124.23초), Sol이 115.2개(첫 번째 토큰 생성까지 102.15초)였습니다. 이는 참고용 지표입니다. 제3자 측정치이며, 최대 추론 모델에 한정된 수치이고, 연구소의 재측정에 따라 달라질 수 있기 때문입니다.
하지만 이로 인한 두 가지 결과는 청구서가 아니라 팀의 몫으로 고스란히 돌아옵니다. 첫째, 2분 동안 아무런 반응이 없는 실행은 멈춰버린(hang) 프로세스와 똑같아 보여 결국 누군가 직접 확인하러 가야 합니다. 둘째, 추론 과정이 길어지고 diff가 길어질수록 사람이 승인하기 전에 검토해야 할 분량이 실행 1회당 대폭 늘어납니다. 읽는 사람의 시간이야말로 가장 희소한 자원인데, 그 자원을 소모하는 요소를 돈을 주고 더 늘려버린 셈입니다.
숨겨진 변수 3: 코드 diff가 아닌 의사결정의 증가
Task가 할당된 시점부터 변경 사항이 승인될 때까지 사람이 내려야 하는 의사결정 횟수를 세어보세요. 뛰어난 Runtime을 쓸 때는 보통 단 한 번입니다. 읽고, 승인하면 끝납니다. 반면 검증하기 어려운 작업을 저렴한 Runtime에 맡기면 경로가 갈라지기 시작하며, 모든 분기점마다 사람의 개입이 필요해집니다.
- 실행이 실패했습니다. 같은 Runtime으로 재시도할까요, 아니면 더 강력한 모델로 에스컬레이션할까요?
- 테스트는 통과했지만 사람이었다면 택하지 않았을 방식으로 작성되었습니다. 승인할까요, 아니면 반려할까요?
- 세 가지 부분적인 결과물이 나왔습니다. 이 중 어떤 것이 실제 변경 사항인가요?
- 실행 도중 질문을 던지며 멈췄습니다. 누가 답변하고, 그 답변은 어디에 기록해야 할까요?
이 중 어떤 것도 토큰 청구서에는 찍히지 않습니다. 하지만 이 모든 일은 사람의 리뷰를 담당하는 팀원의 캘린더를 가득 채우게 됩니다.
실제 우리 팀의 숫자로 계산해보는 총비용
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
저희의 수치가 아닌 여러분 팀의 실제 수치를 대입해 보세요. 100만 토큰당 0.10달러와 0.50달러 수준에서는 괄호 안의 모델 비용은 사실상 0에 수렴하므로, 전체 수식은 '리뷰어의 투입 시간(분) × 시도 횟수'에 의해 결정됩니다. 더 저렴한 Runtime으로 바꾸는 것은 원래도 미미했던 항목을 조금 줄이는 대신, 결코 작지 않았던 항목을 몇 배로 불리는 결과를 낳습니다. 경우에 따라서는 이것이 여전히 이득일 수도 있습니다. 하지만 결코 가격 페이지만 보고 판단할 수 있는 문제는 아닙니다.
저가형 모델이 실제로 더 저렴한 순간
시도의 성공 여부를 머신이 직접 판정할 수 있을 때 저렴한 Runtime을 사용하세요. 타입 검사, 유닛 테스트, 빌드, 린트 규칙, 스키마 검증 등 사람이 주의를 기울이기 전에 결과가 먼저 나오고, 추가 시도로 인한 비용을 엔지니어의 금요일 오후가 아닌 테스트 하네스가 흡수할 수 있는 경우입니다. 이는 실제 업무 환경에서 Crew가 처리하는 작업의 대부분을 차지하며, 반복적이고 따분한 80%의 작업을 Luna로 라우팅해야 하는 타당한 이유가 됩니다.
반면 승인 여부가 인간의 정성적 판단에 달려 있다면 저가형 Runtime을 쓰지 마세요. 아키텍처 설계 결정, 데이터 마이그레이션, 보안과 관련된 모든 작업, 그리고 명령어 하나로 "이게 맞는가?"를 검증할 수 없는 모든 작업이 여기에 해당합니다. 이런 작업에서는 모델 점수의 격차가 곧바로 리뷰어의 시간 소모로 이어지며, 가장 저렴한 선택은 한 번만 읽고 바로 승인할 수 있는 고품질의 시도를 구매하는 것입니다.
에스컬레이션 규칙은 개발자 개인의 취향에 맡겨두지 말고 반드시 명문화하세요. 주관적인 선호는 언제나 더 저렴한 가격표 앞에 무너지기 마련입니다. 모델 라우팅의 제1원칙은 비용이 아니라 '검증 가능성'입니다.
어떤 벤더도 이 사실을 알려주지 않는 이유
두 연구소는 같은 날 서로를 겨냥해 벤치마크를 공개했고, OpenAI의 비교 기준이었던 Claude Opus 5를 Anthropic은 불과 몇 시간 뒤 Opus 5.5로 교체해 버렸습니다. 모든 벤더에게 저가형 모델은 자사 서비스로 사용자를 유입시키는 최상단 퍼널입니다. "저희 보급형 모델을 쓰면 리뷰어가 검토를 한 번 더 해야 하므로 비용이 더 듭니다"라고 솔직하게 적어둘 벤더는 없으며, 그들이 이를 밝히지 않는다고 해서 틀린 것도 아닙니다. 그 비용은 전적으로 고객사의 코드베이스와 엔지니어에 따라 달라지기 때문입니다.
Sharkly는 모델 토큰을 판매하지 않습니다. 모델 사용은 팀이 이미 사용 중인 도구에 설정된 구독이나 API 키를 통해 이루어지므로, 여러분이 어떤 Runtime을 선택하든 저희의 이해관계와는 무관합니다. 그렇기 때문에 이 논의를 온전히 객관적인 입장에서 풀어낼 수 있으며, 다음번에 더 저렴한 새 모델이 출시되더라도 기존 워크플로우를 갈아엎지 않고 유지할 수 있는 이유이기도 합니다.
대시보드에 대신 올려야 할 지표들
Runtime별 승인된 변경 사항당 사람의 검토 시간(분). 모델 전환 후 이 시간이 증가했다면, 더 싼 모델이 실제로는 더 비싼 모델인 것이며 여러분은 이제 그 명백한 증거를 쥐게 된 셈입니다. 실행당 달러 비용은 2026년 9월 22일부로 실질적인 의미를 잃었습니다.
Runtime별 승인된 변경 사항당 시도 횟수. 이 변수가 다른 모든 것을 결정하며, 어떤 벤더도 이 수치를 대신 알려줄 수 없습니다. 해당 작업(Task)에 어떤 Runtime이 각 시도를 생성했는지 기록함으로써 이 수치를 파악할 수 있습니다.
'사람 대기 중'을 실질적인 상태(state)로 관리하기. 실행 내용, 병목 지점, 결과, 후속 논의를 Task 타임라인으로 통합해 사람이 필요한 대기 큐를 막연한 추측이 아닌 명확히 셀 수 있는 수치로 만드세요. 모든 실행이 완료되면 다음과 같은 근거를 갖추어 도착하도록 규정해야 합니다.
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
규모가 작은 조직이라면 이런 방식이 당장 필요하지는 않습니다. 한 사람이 두 개의 Agent를 돌리고 같은 날 오후에 결과를 모두 직접 검토할 수 있다면 계속 그렇게 하셔도 좋습니다. 상태와 큐를 관리하는 것은 아직 겪지 않은 문제에 대한 오버헤드일 뿐입니다. 하지만 대기 중인 완료 실행이 몇 건인지 아무도 기억하지 못하는 순간부터는, 이러한 회계적 관리가 필수적이 됩니다.
결코 저렴해지지 않은 영역
두 연구소는 같은 날 1회 시도에 드는 비용을 크게 낮췄습니다. 하지만 그 누구도 diff를 대신 읽어주는 기술을 내놓지는 못했으며, 변경 사항에 대한 최종 책임은 여전히 사람에게 있습니다. 모델이 저렴해졌다고 해서 워크플로우 전체가 저렴해진 것은 아닙니다. 단지 시도 비용이 낮아졌을 뿐이며, 그 시도들이 흘러 들어가는 파이프라인의 가장 값비싼 단계는 여전히 사람의 몫입니다.
이미 여러 개의 코딩 에이전트를 운영하고 있다면, Sharkly를 통해 어떤 Runtime이 어떤 시도를 만들었는지, 어떤 증거가 첨부되었는지, 그리고 지금 이 순간 사람의 검토를 기다리는 작업이 얼마나 쌓여 있는지를 한눈에 확인할 수 있습니다.