
Resposta rápida: Para corrigir falhas de CI com um agente de IA, envie o evento de falha da CI para um webhook, deixe um agente de programação verificar se a falha é algo que ele consegue resolver, reproduzi-la localmente em uma worktree limpa e enviar a correção para uma branch como um draft pull request. Uma pessoa revisa e faz o merge. Sem reprodução local, sem push.
Uma build quebrada às 16h custa mais do que a própria correção. Alguém interrompe o que estava fazendo, abre o log, rola por mais de 900 linhas de saída de configuração e encontra um erro de lint ou um snapshot desatualizado. A correção leva dois minutos. A troca de contexto leva vinte.
É exatamente nesse intervalo que um agente de programação mostra seu valor. Você provavelmente já usa o Claude Code, o Codex ou outro agente no seu dia a dia. A peça que falta é a integração: algo que detecte a falha, repasse-a ao agente com o contexto correto e impeça o agente de enviar palpites para o seu repositório. Este guia mostra como estruturar essa integração usando o GitHub Actions e uma Sharkly Automation, e a mesma arquitetura funciona com qualquer CI capaz de enviar uma requisição HTTP.
O que um agente de IA resolve bem na CI (e o que ele não resolve)
O agente tem o melhor desempenho em falhas que podem ser reproduzidas em uma máquina local e que exigem uma correção pequena e verificável. Ele se sai pior em problemas relacionados a infraestrutura, credenciais ou serviços de terceiros. Faça uma triagem antes de automatizar:
| Tipo de falha | Aderência do agente | Motivo |
|---|---|---|
| Erros de lint e formatação | Alta | Determinístico; o linter confirma a correção |
| Erros de tipagem | Alta | O compilador confirma a correção |
| Snapshot quebrado após mudança intencional de UI | Boa | Fácil de reproduzir, mas uma pessoa deve confirmar se a mudança era intencional |
| Teste instável (flaky test) | Mista | A reprodução exige várias execuções; a causa costuma ser uma condição de corrida real |
| Teste unitário falhando após mudança de lógica | Mista | O teste pode estar certo e o código errado |
| Runner sem espaço em disco, timeouts de rede | Baixa | Não há o que corrigir no repositório |
| Secrets ausentes ou expiradas, erros de permissão | Nunca | O agente não deve ter acesso a credenciais |
A regra que decorre dessa tabela é: o agente só entrega uma correção que ele próprio viu falhar e depois passar no seu próprio Computer. Um ensaio de arquitetura que a equipe do DeepSeek Harness publicou no X chama esse padrão de “silently reproduce and fix” (reproduzir e corrigir silenciosamente): um gatilho monitora os eventos, fica silencioso por padrão e só traz à tona uma correção simples e comprovada. Esse texto descreve o design de um protótipo, não um produto lançado, mas o princípio se aplica a qualquer fluxo que você configure por conta própria.
Como funciona o fluxo de correção de CI
O fluxo é dividido em cinco partes: um evento de falha, um webhook assinado, um filtro de baixo custo, uma reprodução isolada e uma etapa de revisão humana.
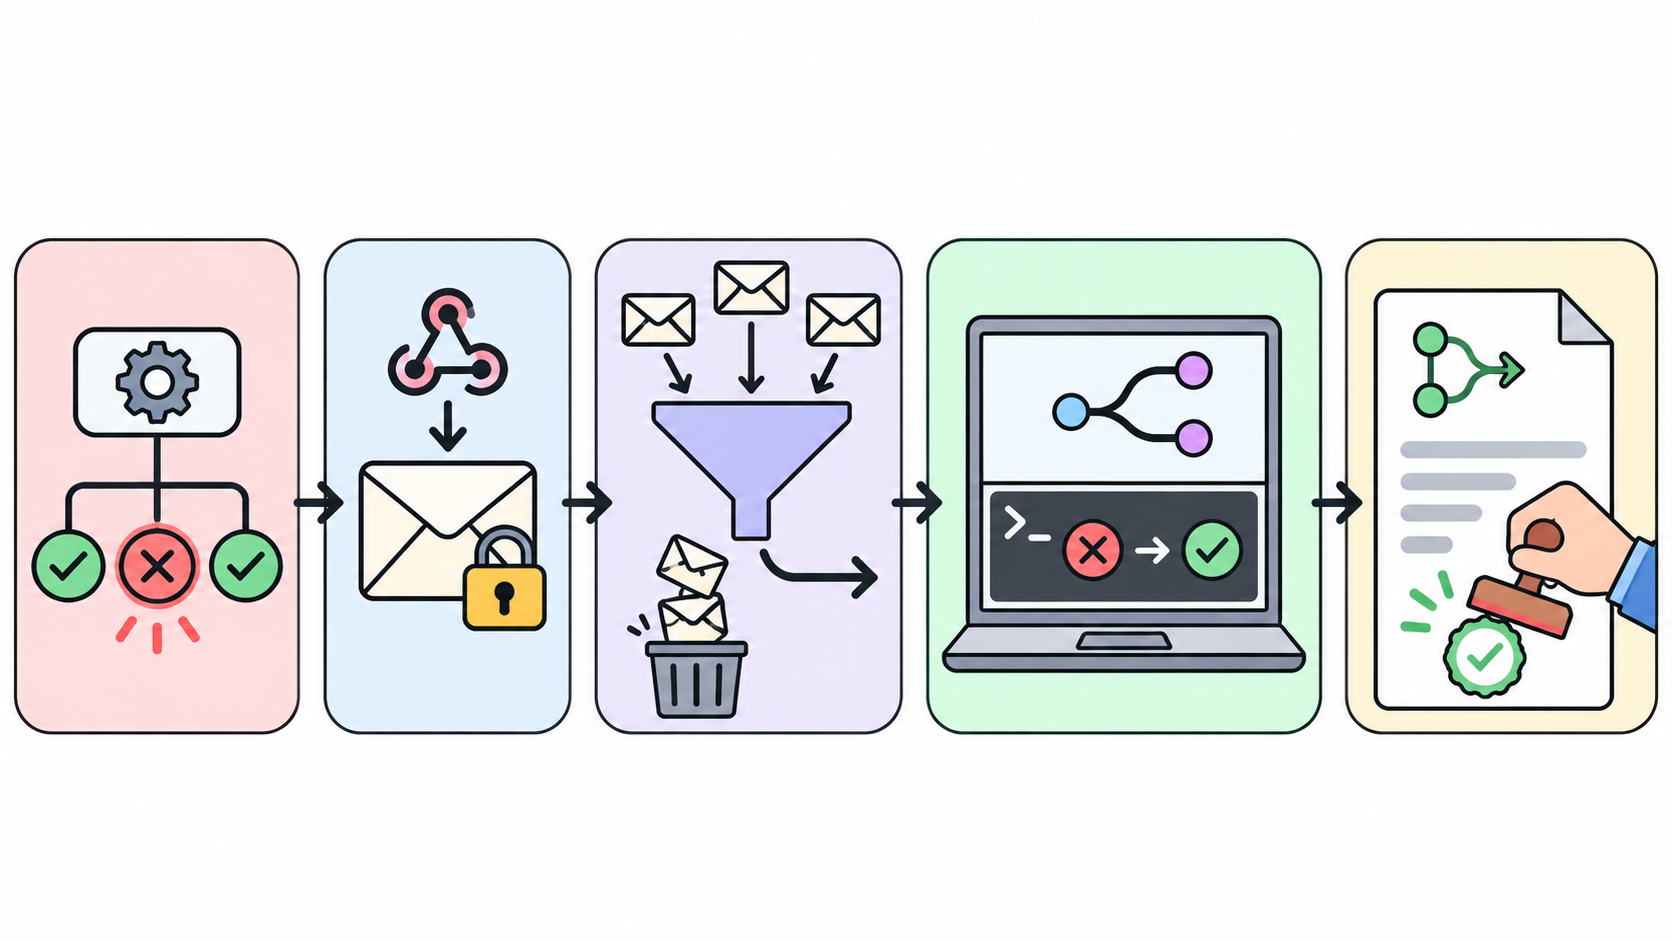
- Sua CI finaliza uma execução com falha.
- Um workflow simples envia um payload JSON assinado para a URL de um webhook.
- O agente lê o corpo da requisição e descarta qualquer coisa fora de escopo, como o repositório errado ou uma falha em uma branch de release.
- O agente abre uma tarefa, faz checkout em uma worktree limpa, reproduz a falha e a corrige.
- Ele faz push para uma branch e abre um draft pull request. Uma pessoa revisa, aprova e faz o merge ou fecha o PR.
As etapas 3 e 4 rodam como uma Sharkly Automation. Uma Automation é um conjunto salvo de instruções somado ao Agent ou Crew responsável por executá-las, acionado por um gatilho: um agendamento, uma mudança de status de tarefa, uma palavra-chave em comentário ou um webhook.
Etapa 1: Enviar a falha da CI para um webhook
O GitHub Actions oferece o evento workflow_run, disparado quando outro workflow termina. Como ele é disparado para qualquer resultado, você filtra por failure usando uma condição no job. Um detalhe importante da documentação do GitHub: o arquivo do workflow precisa estar presente na branch padrão, caso contrário ele nunca será acionado.
Este workflow monitora um workflow chamado CI, monta um payload JSON enxuto, assina os dados e envia a requisição:
name: Report CI failure
on:
  workflow_run:
    workflows: [CI]
    types: [completed]

jobs:
  notify:
    if: ${{ github.event.workflow_run.conclusion == 'failure' }}
    runs-on: ubuntu-latest
    steps:
      - name: Send signed webhook
        env:
          WEBHOOK_URL: ${{ secrets.SHARKLY_WEBHOOK_URL }}
          SIGNING_SECRET: ${{ secrets.SHARKLY_SIGNING_SECRET }}
          REPO: ${{ github.repository }}
          RUN_ID: ${{ github.event.workflow_run.id }}
          RUN_URL: ${{ github.event.workflow_run.html_url }}
          BRANCH: ${{ github.event.workflow_run.head_branch }}
          SHA: ${{ github.event.workflow_run.head_sha }}
        run: |
          BODY=$(jq -nc --arg repo "$REPO" --arg run_id "$RUN_ID" \
            --arg url "$RUN_URL" --arg branch "$BRANCH" --arg sha "$SHA" \
            '{event:"ci_failure",repo:$repo,run_id:$run_id,run_url:$url,branch:$branch,sha:$sha}')
          TS=$(date +%s)
          SIG=$(printf '%s\n%s' "$TS" "$BODY" \
            | openssl dgst -sha256 -hmac "$SIGNING_SECRET" -binary | base64)
          curl -fsS -X POST "$WEBHOOK_URL" \
            -H "Content-Type: application/json" \
            -H "X-Webhook-Timestamp: $TS" \
            -H "X-Webhook-Signature: v1=$SIG" \
            --data-raw "$BODY"
Como os nomes de branch vêm de contribuidores, o workflow os repassa via env e jq em vez de concatená-los diretamente no script shell. Guarde os dois valores como secrets criptografadas do repositório, nunca diretamente no arquivo.
Etapa 2: Criar a Automation e o gatilho de webhook
No seu Space, crie uma Automation, associe-a ao Agent encarregado da correção e adicione um gatilho do tipo Webhook. O Sharkly mostra a URL completa apenas uma vez, no momento em que você cria ou regenera o gatilho; copie-a imediatamente para a secret do GitHub.
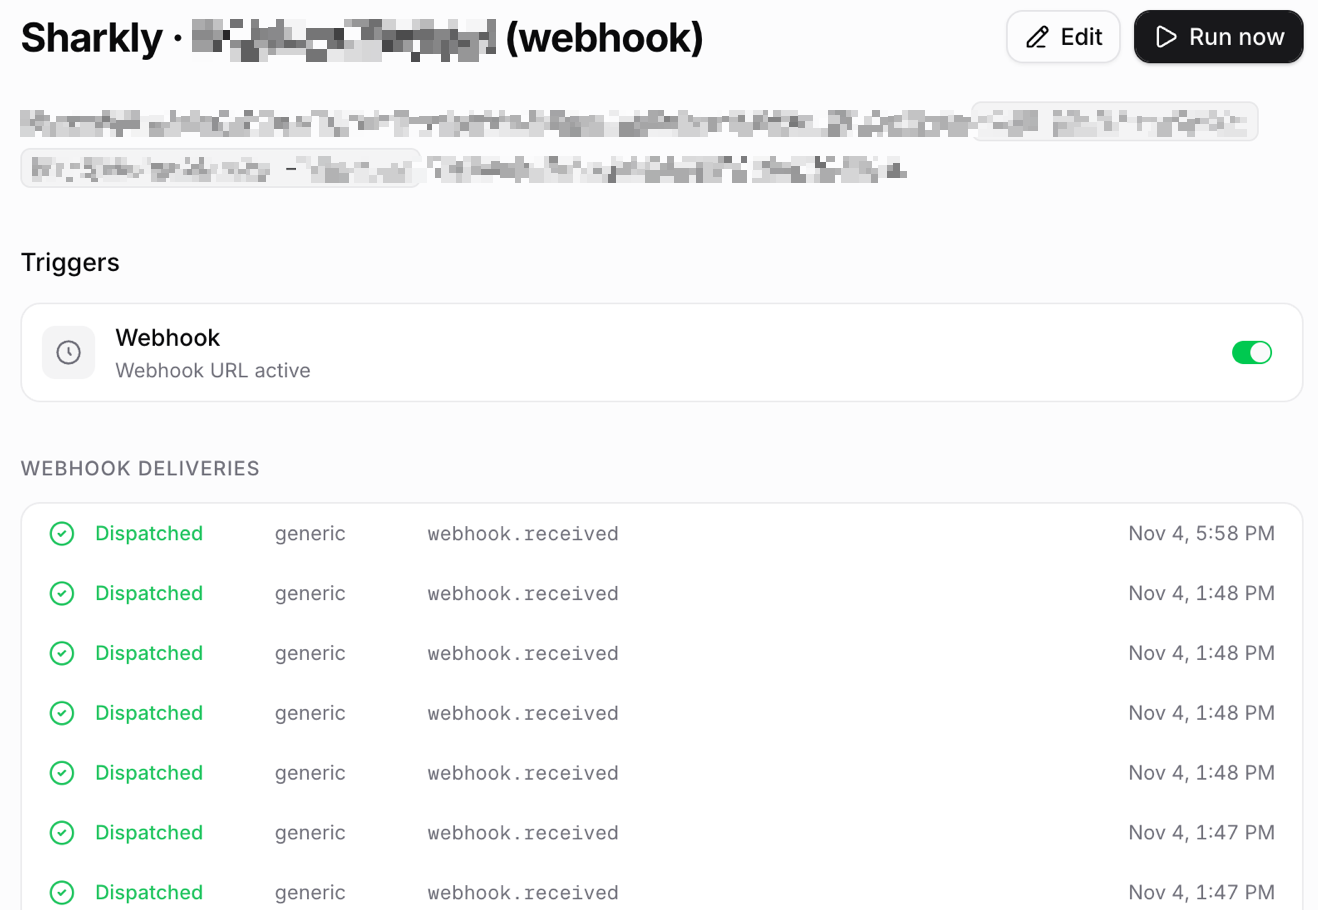
Ative uma signing secret. Sem ela, a URL funciona como um bearer token: qualquer pessoa em posse dela pode iniciar uma execução. Com a secret ativada, conforme a documentação de Automations, cada requisição precisa incluir um cabeçalho X-Webhook-Signature com v1= seguido do HMAC-SHA256 em Base64 calculado sobre o timestamp, uma quebra de linha e o corpo bruto da requisição, usando a chave whsec_. O Sharkly rejeita timestamps com diferença superior a 300 segundos e aceita uma determinada assinatura apenas uma vez dentro de uma janela de 10 minutos, o que impede ataques de repetição.
O gatilho precisa estar ativado e a Automation com status Active para que uma requisição válida inicie uma execução. Faça um teste prévio com o botão Run now.
Etapa 3: Escrever instruções que filtram primeiro e corrigem depois
Uma execução de Automation iniciada por webhook não cria uma tarefa automaticamente. Como a execução não vem com uma tarefa vinculada, suas instruções devem abrir uma; isso garante que cada falha tenha um registro, um histórico para perguntas e um status visível para a equipe. Coloque as checagens mais rápidas e baratas logo no início para descartar a maioria dos eventos em questão de segundos:
You receive a CI failure webhook. The trigger payload is JSON with
event, repo, run_id, run_url, branch, sha.

1. Stop with no output unless event == "ci_failure" and repo is
   acme/web. Stop if branch starts with "release/".
2. Search open tasks for run_id. If one exists, stop.
3. File a task titled "CI fix: <repo> run <run_id>" with run_url in
   the body. Do all further work under that task.
4. Read the failed steps: gh run view <run_id> --log-failed
5. If the cause is a secret, permission, runner, or network problem,
   comment the diagnosis on the task and stop. Change nothing.
6. Check out sha in a fresh worktree. Run the failing command and
   confirm it fails the same way. If it does not reproduce, comment
   what you tried and stop. Never push an unreproduced fix.
7. Make the smallest change that fixes it. Do not edit CI config,
   lockfiles, or tests you were not asked to fix. Rerun the command
   and the nearest test suite.
8. Push to branch ci-fix/<TASK-ID> and open a draft PR with
   gh pr create --draft, task ID in the title. Comment the PR link
   on the task and hand it to a human for review.
Dois detalhes são muito importantes aqui. Hoje, gatilhos de status e de comentário monitoram toda a organização, e é por isso que a documentação orienta a validar os dados dentro das instruções; já o webhook fica restrito à sua URL específica, mas o passo 1 ainda funciona como proteção contra requisições direcionadas por engano. Além disso, o ID da tarefa no nome da branch tem um papel essencial: com a integração com o GitHub conectada, incluir o ID da tarefa na branch, no título do PR ou no corpo do PR vincula automaticamente o pull request à tarefa.
Etapa 4: Executar em um Computer dentro de uma worktree isolada
Um Computer é o host conectado onde seu Agent executa, com seus próprios Runtimes, arquivos e credenciais do Git. Defina o repositório do Agent no modo Temporary para que cada execução receba seu próprio diretório de tarefa e uma worktree separada. Assim, duas falhas que ocorram com um minuto de intervalo não correrão o risco de sobrescrever os arquivos uma da outra. Para entender os detalhes técnicos, confira o guia sobre agentes paralelos em worktrees isoladas e a documentação do git worktree.
O acesso ao Git parte do Computer, não do GitHub App. A integração apenas vincula pull requests e sincroniza issues; clonar e fazer push continuam dependendo da chave SSH, do token HTTPS ou do login da CLI gh configurados naquele host. Conceda a essa credencial apenas permissão de push para branches e configure proteção na branch padrão para que qualquer merge exija revisão.
Custos e barreiras de proteção
Cada execução é cobrada no plano do próprio Runtime. O Sharkly não comercializa tokens, então uma execução de correção de CI custa exatamente o mesmo que uma sessão de Claude Code ou Codex daquela duração custaria hoje. O filtro de descarte rápido do passo 1 é o seu principal mecanismo de economia: um evento descartado no passo 1 consome apenas algumas centenas de tokens, em vez de pagar pelo custo de uma reprodução completa.
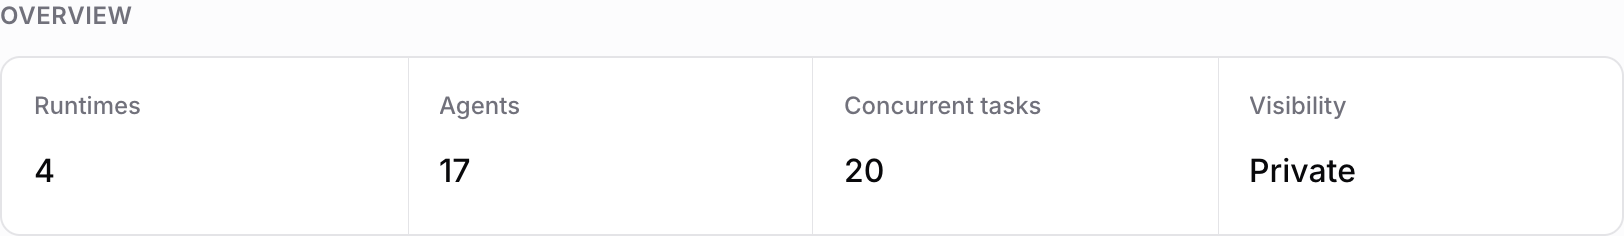
A concorrência é a segunda forma de controle. Cada Computer possui um limite de tarefas simultâneas, e execuções em diretórios temporários usam por padrão metade dessa capacidade. Quando o limite é atingido, novas execuções aguardam em fila em vez de sobrecarregar uma máquina só. Uma manhã turbulenta com 30 builds quebradas se transforma em uma fila organizada, sem risco de gargalo.
O restante são regras que você define uma única vez:
- Apenas draft PRs. O agente nunca faz merge. Veja o artigo sobre agentes de programação com supervisão humana (human-in-the-loop) para definir onde posicionar a etapa de revisão.
- Apenas uma tentativa por execução. Se a primeira correção falhar na sua própria reexecução local, o agente comenta na tarefa e interrompe o trabalho.
- Uma deny list: configurações de CI, secrets, lockfiles e migrations.
- Pause a Automation na página dela sempre que alterar as instruções e retome apenas após validar com o Run now.
Valide antes de confiar plenamente. O ciclo de planejar, observar e verificar faz toda a diferença aqui: acompanhe uma semana de histórico de execuções antes de expandir a lista de repositórios atendidos.
Alternativas
Você pode criar uma tarefa para cada falha em vez de usar uma Automation por webhook. Basta direcionar o workflow para um script que execute sharkly task create e deixar o Agent encarregado assumir o trabalho. Isso gera uma tarefa para cada build quebrada, inclusive para aquelas que o agente deveria ignorar, sendo uma opção mais indicada para repositórios com baixo volume de alterações. Equipes que já concentram o fluxo de trabalho no GitHub também podem começar pelo guia sobre como delegar issues do GitHub para um agente de IA.
Comece por um repositório
Escolha o repositório com maior incidência de erros de lint e tipagem, implemente o workflow descrito acima e execute a Automation manualmente três vezes antes de liberar o disparo automático pelo webhook. Quando chegar a hora de escalar além de um agente, o guia sobre como rodar 10 agentes de programação de IA ao mesmo tempo explica os próximos passos. O Sharkly é gratuito para começar: conecte um Computer e deixe seu agente resolver a próxima build vermelha.
Perguntas frequentes (FAQ)
Um agente de IA consegue corrigir builds de CI com falha de forma autônoma?
Ele consegue corrigir falhas de lint, tipagem e snapshots que consiga reproduzir localmente. O que ele não deve fazer é o merge por conta própria. Mantenha a entrega sempre como um draft PR e deixe a aprovação final para uma pessoa da equipe.
Como acionar um agente de IA quando o GitHub Actions falha?
Adicione um workflow acionado pelo evento workflow_run com types: [completed] e uma condição no job para conclusion == 'failure'. Esse job envia uma requisição assinada para a URL do webhook do agente.
O que impede o agente de enviar uma correção errada?
A exigência de reprodução local. O agente precisa reproduzir a falha localmente, aplicar uma modificação e ver o mesmo comando passar com sucesso. Se não houver reprodução local, ele adiciona um comentário na tarefa e não faz nenhum push.
A integração do Sharkly com o GitHub abre pull requests?
Não. Ela apenas vincula pull requests a tarefas e sincroniza issues. Quem abre o PR é o próprio agente, usando as credenciais de Git e da CLI gh configuradas no seu Computer.
E quanto aos testes instáveis (flaky tests)?
Configure o agente para rodar o teste com falha várias vezes antes de tomar qualquer decisão. Se o teste passar em algumas tentativas e falhar em outras, ele deve reportar a instabilidade na tarefa em vez de tentar aplicar uma correção superficial.
Quanto custa uma execução de correção de CI?
Apenas os tokens que o seu Runtime consome durante a sessão. As execuções no Sharkly são faturadas diretamente no plano contratado do seu Claude Code, Codex ou de API.


