
A Anthropic diz que o Claude Opus 5.5 tem um custo de execução 40% menor que o Opus 5. Alguém do seu time já fez a conta óbvia: mesmo orçamento, cerca de 1,7 vez mais execuções de agentes, logo cerca de 1,7 vez mais trabalho entregue. Essa conta está aritmeticamente correta e operacionalmente errada, e a semana em que ela for colocada em prática é a semana em que seu board se enche de execuções concluídas que ninguém leu.
A restrição para rodar mais agentes em paralelo nunca foi a fatura do modelo. Era a capacidade de uma pessoa de ler um diff, entender o que um agente decidiu e aceitar aquilo. Um corte de preço não mexe nesse número. Ele só aumenta a velocidade com que o trabalho chega até ele.
TL;DR
Um teto de revisão é o número de execuções de agentes concluídas que um time consegue de fato ler, julgar e aceitar em um dia, e ele é definido por pessoas, não por tokens. Modelos mais baratos aumentam a taxa de chegada nesse teto e deixam o teto intacto, então o primeiro efeito visível de um corte de preço é uma fila maior, não um lançamento mais rápido. Agentes pesquisam, executam, testam e reportam. Pessoas definem a direção, concedem autoridade e aceitam o resultado. A resposta útil é limitar a concorrência pelo número de revisores, e não pelo orçamento, e separar o trabalho de agente que converge para um único resultado revisável do trabalho de agente que se ramifica em muitos. O Sharkly mantém contexto, progresso, bloqueios, resultados e revisão humana visíveis na Task, da solicitação ao lançamento, e é isso que torna a fila contável em primeiro lugar.
O que de fato ficou mais barato
Dois laboratórios lançaram novidades em 22/09/2026. Aqui está a parte que mexe com a sua fatura.
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| ID da API | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Entrada por 1M de tokens | US$ 5 | US$ 4 | US$ 2 | US$ 0,10 |
| Saída por 1M de tokens | US$ 25 | US$ 20 | US$ 10 | US$ 0,50 |
| Entrada em cache | n/a | US$ 0,20 leitura, US$ 5 escrita | 90% de desconto nas leituras | 90% de desconto nas leituras |
A Anthropic afirma que o Opus 5.5 tem um custo de execução 40% menor que o Opus 5 e produz saída cerca de 30% mais rápido. Os preços de tabela acima são 20% menores que o preço por token do Opus 5, o que é uma conta nossa feita a partir de dois números publicados e uma afirmação distinta dos 40%. A OpenAI afirma que Sol e Luna são 50% mais baratos que o preço promocional do GPT-5.6, e “promocional” é palavra da própria OpenAI, portanto esse número de manchete é medido em relação a uma tarifa com desconto, e não a um preço de tabela.
O custo por tarefa concluída caiu mais do que o custo por token. No AutomationBench 1.0.6, a OpenAI reporta o GPT-6 Sol com raciocínio extra alto marcando 33,2% a US$ 0,27 por tarefa, contra o Claude Opus 5 em raciocínio máximo marcando 26,9% a 11,1 vezes o custo do Sol. No DeepSWE 1.1, a OpenAI coloca o GPT-6 Luna em raciocínio máximo com 66,6% e 93% mais barato por tarefa que o Opus 5.
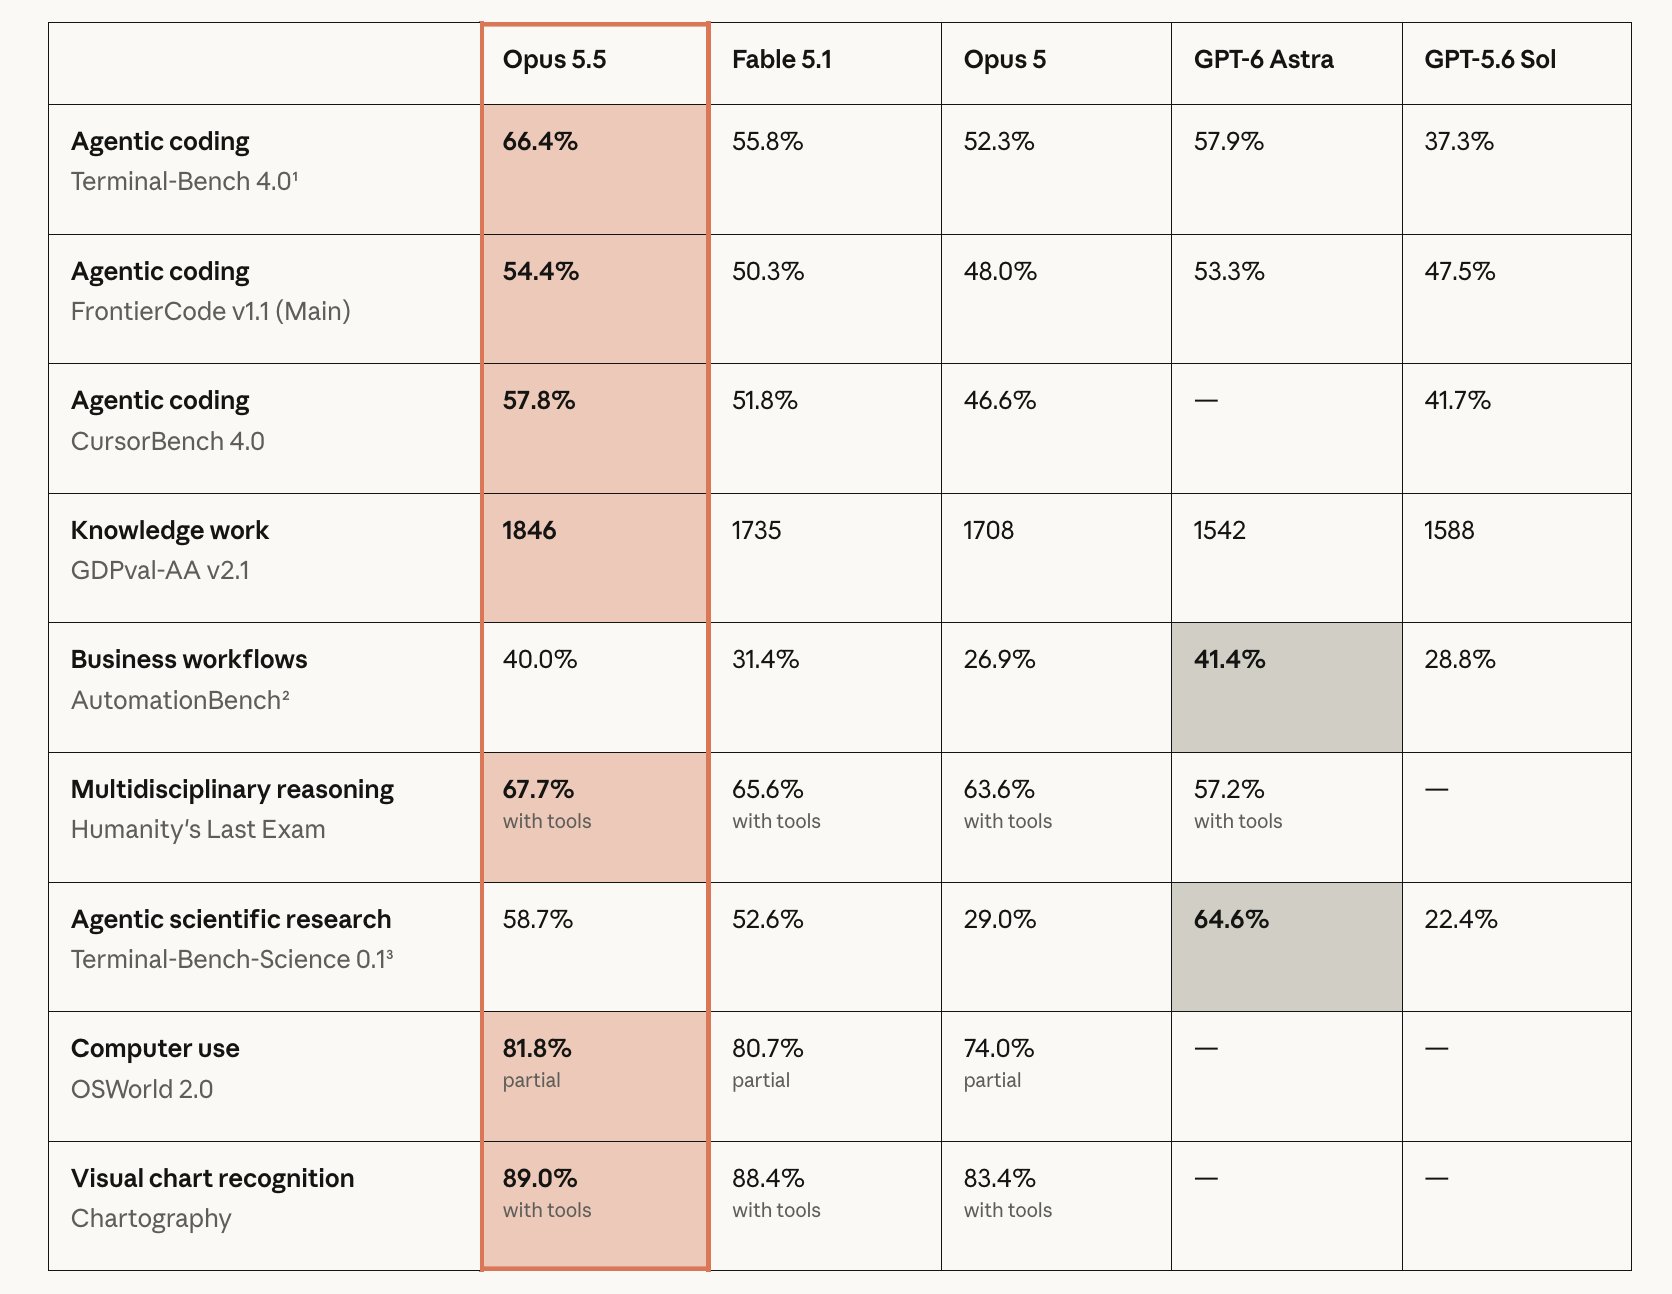
Ou seja, o preço de uma tentativa despencou, em dois fornecedores diferentes, em um único dia. Nada mais na sua semana mudou.
A conta que todo mundo fez esta semana
Mantenha o gasto fixo e divida. Com um custo de execução 40% menor, o mesmo valor mensal compra cerca de 1,67 vez mais execuções do Opus 5.5 do que comprava de execuções do Opus 5. Encaminhe a metade rotineira do trabalho para o Luna e o multiplicador deixa de ser interessante, porque a US$ 0,10 e US$ 0,50 por milhão de tokens a linha do modelo deixa de ser aquilo que você está orçando.
Agora faça a segunda conta, a que decide se algo disso chega a ser entregue. Pegue o número de execuções concluídas que um dos seus engenheiros consegue ler direito em um dia. Não passar os olhos, não aprovar porque o check ficou verde: ler o diff, entender o que o agente escolheu fazer e assumir a responsabilidade por isso. Qualquer que seja esse número, ele era o mesmo em 21/09/2026 e vai ser o mesmo no próximo trimestre. A aritmética da capacidade de revisão não fecha bem nem antes de um corte de preço, e um corte de preço só muda o lado da entrada.
Um corte de preço não é um aumento de capacidade. É uma mudança em quão barato fica gerar algo que ainda exige uma pessoa.
A pista: o custo não era o que estava te travando
Se o custo do modelo fosse a restrição limitante, os times estariam rodando a configuração mais barata que funcionasse. Não estavam. Os próprios números da OpenAI dizem que o pesquisador mediano da organização roda mais de US$ 600 por dia de inferência a preços de API, e o percentil 90 roda US$ 7.000 por dia. A tabela de benchmarks publicada pela própria OpenAI mostra times usando de forma consciente uma configuração 11,1 vezes mais cara por tarefa para obter uma pontuação menor, porque um resultado em que você confia vale mais do que um resultado que você precisa conferir duas vezes.
Essa é a forma da restrição real. As pessoas pagam um múltiplo alto por resultados que exigem menos escrutínio humano por unidade. O recurso escasso que se compra é atenção, não computação, e ele já vinha sendo comprado a um prêmio elevado.
O que significa que um corte de preço chega de forma assimétrica. Ele barateia o lado que gera e deixa o lado que aceita exatamente onde estava.
O fan-out que converge e o fan-out que chega ao board
Aqui está a distinção que faz modelos baratos serem de fato úteis em vez de silenciosamente caros, e é a que a maioria dos times ignora.
Parte do paralelismo converge. Três agentes tentam a mesma migração em worktrees isolados, uma suíte de testes e um Agente líder escolhem a que passou, e um único resultado chega até uma pessoa. O custo triplicou e a carga de revisão não se moveu. É aqui que um corte de preço compra throughput de verdade, e onde a nova economia justifica mudar sua configuração.
Parte do paralelismo diverge. Dez agentes pegam dez Tasks sem relação entre si e produzem dez diffs, dez resumos de mudanças e dez decisões de aceite. O custo são as mesmas dez execuções. A carga de revisão é dez vezes a unidade de atenção de uma pessoa.
| Fan-out convergente | Fan-out divergente | |
|---|---|---|
| Exemplo | 3 tentativas de uma migração, a melhor vence | 10 Tasks, 10 Responsáveis, 10 diffs |
| O que modelos mais baratos compram | Mais tentativas, maior chance de uma ser boa | Mais trabalho concluído esperando |
| Itens de revisão gerados | 1 | 10 |
| Seguro escalar só com base no preço | Sim | Não |
Use modelos baratos para ampliar o fan-out convergente até onde for a sua paciência com retentativas. Não os use para ampliar o fan-out divergente além do número de revisores que você tem, por mais acessíveis que as execuções tenham ficado. Esse é o par de decisões honesto, e a segunda metade dele é a que custa dinheiro quando é ignorada.
O que mudar em vez do orçamento
Limite a concorrência pelos revisores, não pelo gasto. Escreva a regra onde a Crew possa vê-la: Tasks abertas aguardando aceite humano não devem exceder o número de revisores em turno multiplicado por quantas revisões um deles conclui em um turno. Os seus números, não os nossos. Quando o limite é atingido, os agentes param de pegar novas Tasks mesmo que o orçamento permita. Uma regra de roteamento por escrito ganha de uma preferência nesse caso, porque uma preferência perde silenciosamente para um preço mais baixo.
Faça de “aguardando um humano” um estado visível. Uma execução que terminou e uma execução que parou para perguntar algo parecem idênticas vistas de fora, e as duas ficam invisíveis se o único registro for um terminal. Execução, bloqueios, resultados e discussões de acompanhamento devem voltar para a linha do tempo da Task, para que a fila seja algo que você consegue contar em vez de uma sensação que você tem na sexta-feira.
Precifique a revisão, não os tokens. Rastreamento de custos entre agentes que reporta dólares por execução responde a uma pergunta que já não é a que limita. O número que vale colocar em um painel é minutos humanos por mudança aceita. Se ele aumentou depois que você migrou para um modelo mais barato, o modelo mais barato está mais caro.
Gaste parte da economia em evidências. Uma execução que anexa seu typecheck, os resultados dos testes, o resumo das mudanças e os limites conhecidos custa mais tokens e menos atenção. A US$ 0,20 por milhão de leituras de entrada em cache no Opus 5.5 e 90% de desconto em leituras em cache no GPT-6, a passada extra de verificação sai quase de graça e recompra o recurso que era de fato escasso.
Onde isso deixa a semana
Dois laboratórios cortaram o preço de uma tentativa no mesmo dia, e um deles fez benchmark contra um modelo que foi substituído horas depois. Nenhum dos dois entregou algo que leia um diff para você. A propriedade humana do trabalho é a parte que não ficou 40% mais barata, e é a parte que decide o que chega à produção.
Se você já roda vários agentes de código, o movimento útil desta semana não é aumentar o número de concorrência. É descobrir qual é o seu teto de revisão de verdade e então ajustar a concorrência para corresponder a ele. O Sharkly te dá um único lugar para ver as execuções, os bloqueios, os resultados e a fila de trabalho esperando que uma pessoa aceite.


