
Resposta rápida: O preço do Claude Fable 5.2 é de $8 por milhão de tokens de entrada e $40 por milhão de tokens de saída na API padrão da Anthropic. O fast mode custa $16 e $80, respectivamente. Faça o orçamento considerando todo o fluxo de trabalho: contexto repetido, raciocínio (thinking), novas tentativas, agentes de coordenação, ferramentas e revisão humana. Tarifas verificadas em 10 de novembro de 2026.
O preço por token indica o custo de uma chamada ao modelo. Já o seu orçamento de engenharia precisa do custo de um resultado aprovado. Uma migração que exige três tentativas, a revisão de outro agente e a correção de um humano traz diversos custos atrelados a uma única entrega.
Se você estiver executando vários agentes de programação, o Sharkly oferece um espaço compartilhado para suas Tasks e resultados. Comece sua análise de custos por aí: defina o que conta como concluído antes de comparar modelos.
Quanto custa o Claude Fable 5.2?
A Anthropic cobra separadamente por tokens de entrada e de saída, com tarifas distintas para cache, processamento em lote (Batch) e modo rápido (fast mode). Um MTok significa um milhão de tokens. As seguintes tarifas em dólares americanos são provenientes da documentação oficial de preços, verificada em 10 de novembro de 2026. Elas descrevem o consumo da API, e não uma assinatura mensal fixa de programação.
| Categoria de faturamento | Entrada por MTok | Saída por MTok |
|---|---|---|
| API padrão | $8 | $40 |
| Fast mode | $16 | $80 |
| Batch API | $4 | $20 |
| Gravação de cache padrão (5 minutos) | $10 | Não se aplica |
| Gravação de cache padrão (1 hora) | $16 | Não se aplica |
| Acerto de cache padrão (cache hit) | $0.20 | Não se aplica |
Gravações e acertos de cache são categorias de entrada, e não descontos sobre a saída. A precificação de cache no fast mode aplica os multiplicadores de cache sobre as tarifas de entrada do modo rápido. O processamento em lote (Batch) oferece 50% de desconto na entrada e na saída, mas o fast mode não pode ser combinado com o Batch.
O Fable inclui a janela de contexto completa de um milhão de tokens nas tarifas padrão por token. Ainda assim, um contexto amplo continua caro: entradas sem cache se acumulam a cada chamada. Plataformas de nuvem parceiras podem ter preços diferentes; confirme qual endpoint fatura os custos da sua equipe.
Como calcular o orçamento de um fluxo de trabalho?
Para uma chamada padrão sem cache, multiplique os tokens de entrada por $8 por milhão e os tokens de saída por $40 por milhão e, em seguida, some os resultados. Repita isso para cada chamada em todas as tentativas. Adicione custos separados de ferramentas e de infraestrutura, seguidos pelo tempo de revisão humana, para estimar o custo total de entrega.
# Hypothetical standard-API example, not a measured benchmark.
input_tokens = 100_000
output_tokens = 20_000
api_cost = input_tokens / 1_000_000 * 8
api_cost += output_tokens / 1_000_000 * 40
print(f"${api_cost:.2f}")  # $1.60
Aqui, saída refere-se ao total faturável de tokens gerados, incluindo o raciocínio (thinking), quando aplicável. Não substitua o volume reportado pelo provedor pelo tamanho visível da resposta.
Suponha que você execute 20 tarefas com esses totais de tokens. Cinco tarefas exigem uma nova tentativa idêntica. Considere que um agente coordenador adicione $2 no total e que um revisor gaste 15 minutos a um custo interno de $80 por hora.
| Componente hipotético | Cálculo | Custo |
|---|---|---|
| Tentativas iniciais | 20 × $1.60 | $32 |
| Tentativas adicionais | 5 × $1.60 | $8 |
| Coordenador | Gasto agregado presumido com o modelo | $2 |
| Revisão humana | 0,25 horas × $80 | $20 |
| Total | Antes de ferramentas, infraestrutura e impostos | $62 |
Se todas as 20 tarefas forem aprovadas, esse exemplo custa $3,10 por tarefa aprovada. Se apenas 16 forem aprovadas, os mesmos $62 custam cerca de $3,88 por tarefa aprovada. O denominador muda a decisão.
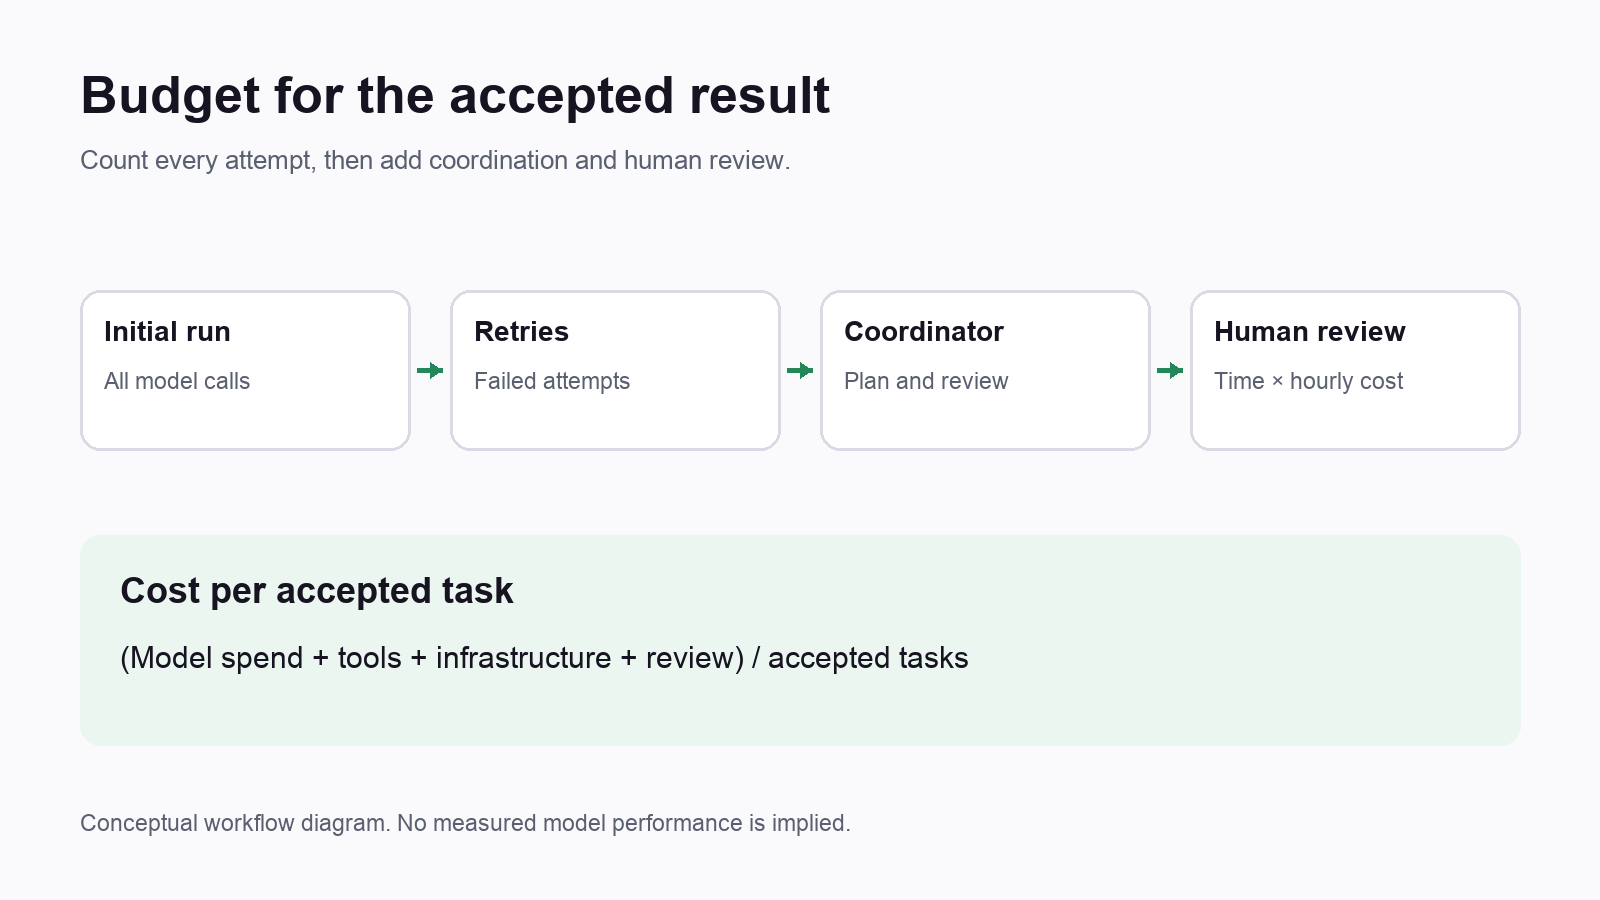
Estas são premissas de planejamento, e não o desempenho medido do Fable. Substitua-as pelos seus totais de tokens, contagens de tentativas, resultados de aprovação e tempo de revisão. Nosso guia sobre precificação de execuções de agentes por alteração aceita explica por que essa comparação é essencial.
O fast mode e as configurações de esforço alteram custos distintos
O fast mode eleva as tarifas por token para reduzir o tempo de geração. O nível de esforço altera a quantidade de trabalho que o modelo realiza, incluindo o raciocínio e as chamadas de ferramentas. Trate-os como controles independentes: uma geração mais rápida não assegura um fluxo de trabalho de ponta a ponta mais curto, e uma configuração de esforço menor não define um teto de gastos fixo.
O anúncio de lançamento da Anthropic afirma que o fast mode gera tokens até 2,5 vezes mais rápido. Trata-se de uma alegação do provedor sobre a velocidade de geração, não de uma garantia de que builds, testes, chamadas de rede ou a revisão humana terminarão 2,5 vezes mais rápido.
Com quantidades de tokens idênticas, o exemplo de $1,60 passa para $3,20 no fast mode. Utilize o fast mode quando o benefício da redução na espera superar o custo adicional. Prefira o modo padrão para tarefas autônomas quando a latência de geração não limitar a entrega.
A documentação de esforço lista os níveis Low, Medium, High, Xhigh e Max para o Fable 5.2. O padrão da API é High. O anúncio identifica Medium como o padrão nos aplicativos Claude e no Claude Code. Documente o produto e a configuração explícita na sua comparação.
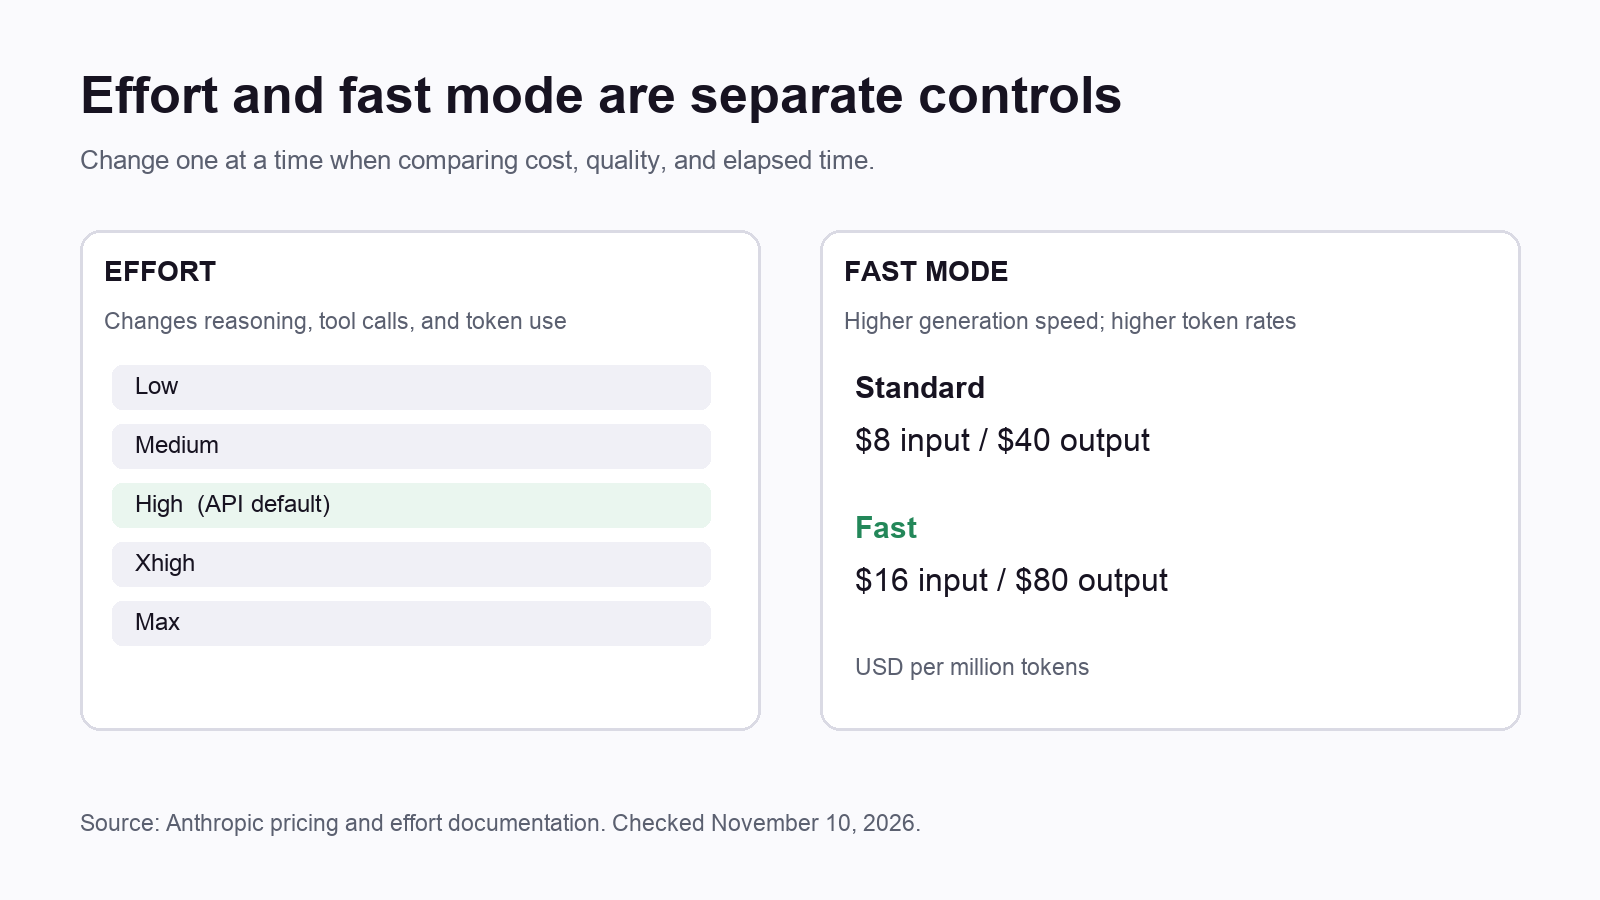
A Anthropic recomenda iniciar as cargas de trabalho da API em High, reduzindo o esforço nos cenários em que as avaliações mantiverem a qualidade, e avançando para Xhigh onde trabalhos complexos demonstrarem ganhos mensuráveis. O nível Max prioriza a capacidade sem considerar o custo dos tokens. O parâmetro de esforço é apenas uma diretriz comportamental; imponha limites reais de gastos na sua aplicação e nos processos operacionais.
Controle o contexto repetido, as tentativas e a orquestração
Adote estas seis medidas de controle antes de expandir o número de agentes:
- Meça cada tentativa. Mantenha tentativas com falha ou abandonadas no custo total da mesma tarefa.
- Faça cache de contexto estável. Reutilize instruções do repositório e documentos inalterados sempre que a carga de trabalho permitir o uso de prompt caching.
- Limite as novas tentativas. Estabeleça um teto de tentativas e exija um diagnóstico antes de autorizar outra tentativa de alto custo.
- Roteie por complexidade. Escale raciocínios não resolvidos em vez de atribuir cada etapa de extração ou formatação ao Fable.
- Inclua a coordenação no orçamento. Contabilize chamadas de planejamento, distribuição, resumos e revisão junto às chamadas dos agentes executores.
- Controle o fluxo para revisão. Ajuste o volume de trabalho concluído à capacidade real de avaliação dos seus revisores.
Definições e retornos de ferramentas aumentam os tokens de entrada do modelo. Algumas ferramentas do lado do servidor geram cobranças adicionais, conforme explica o guia de preços da Anthropic. Um comando que retorna um log gigantesco pode inflar os custos de contexto subsequentes, mesmo que o comando em si tenha custado quase nada.
O cache também exige acompanhamento. Para um prefixo hipotético de 100.000 tokens, uma gravação padrão de cinco minutos custa $1. Um acerto subsequente no cache custa $0,02, contra $0,80 de uma entrada sem cache. Esses números desconsideram novos tokens de entrada e saída. Verifique a taxa real de acertos de cache antes de presumir economia.
Para estruturar uma política de roteamento reproduzível, utilize a visão geral dos modelos. A Anthropic indica o Opus 5.5 para a maioria das cargas de trabalho e o Fable para raciocínios exigentes ou tarefas de longo fôlego. Essa é uma diretriz inicial a ser avaliada, não a comprovação de que determinado modelo superará os demais no seu repositório.
O que você deve medir em um projeto-piloto?
Mantenha o escopo das tarefas e os testes de aceitação idênticos em todas as configurações. Separe o tempo de fila, a geração do modelo, a execução de ferramentas e a revisão humana nas suas medições de tempo. Caso contrário, uma suíte de testes demorada pode ocultar as vantagens de uma geração mais ágil, ou uma seleção de tarefas simples pode fazer uma configuração cara parecer econômica.
Monitore a entrada com cache separadamente da entrada sem cache. Registre os totais reais de consumo do provedor a cada tentativa em vez de estimar tokens a partir do tamanho dos arquivos. Ao alterar uma configuração de esforço, compare tanto a primeira resposta quanto os resultados aprovados e o retrabalho gerado. Uma execução inicial mais curta pode deixar uma fatura muito maior de correções.
Estabeleça uma condição de parada antes do início do piloto: um número limite de tentativas, um teto de gastos ou marcos de revisão. Um modelo que continua investigando continuamente pode esgotar seu orçamento gerando avanços que você ainda não consegue aprovar.
Mantenha o orçamento vinculado ao trabalho entregue
A descrição oficial de produto da Sharkly reúne Tasks, agentes de programação, Computers conectados e revisões humanas em um único workspace. Você preserva as contas de API ou assinaturas de desenvolvimento configuradas em suas próprias ferramentas. O consumo dos modelos continua registrado diretamente nessas contas de provedor.
Utilize esse histórico compartilhado de trabalho para registrar o modelo, o nível de esforço, as tentativas realizadas, as evidências e o parecer da revisão. Em uma migração, solicite que o Agent apresente os resultados dos testes e as limitações identificadas junto com as alterações propostas. A equipe poderá então aprovar o trabalho ou solicitar ajustes. Consulte como revisar código gerado por IA com evidências no nível da tarefa para estruturar um processo de revisão eficiente.
Para uma correção pontual, encarregue um único Agent. Recorra a uma Crew quando a tarefa demandar coordenação e especialistas dedicados. Agentes adicionais exigem mais chamadas e transições de responsabilidade (handoffs); portanto, meça os resultados antes de definir o trabalho paralelo como fluxo padrão. O guia de Crew com modelos mistos aborda essas integrações.
Inicie com dez tarefas representativas. Acompanhe o custo total, o tempo transcorrido, a taxa de aprovação e os minutos dedicados à revisão em cada configuração. Conecte um Computer no Sharkly, atribua uma Task com escopo delimitado e solicite as evidências junto à entrega. Só expanda a operação quando puder justificar com clareza o custo por resultado aprovado.
FAQ
O fast mode do Claude Fable 5.2 custa o dobro?
As tarifas tabeladas para tokens de entrada e de saída são o dobro das tarifas padrão. Contudo, o custo final do seu fluxo de trabalho também dependerá da quantidade de tokens, do uso de cache, das ferramentas e do volume de novas tentativas.
O nível de esforço Medium altera o preço por token?
O nível de esforço altera o comportamento do modelo e a quantidade de tokens consumidos. Ele não substitui as tarifas tabeladas de entrada e saída por valores diferenciados por nível de esforço.
O orçamento de uma assinatura é igual ao orçamento da API?
Não. Este artigo calcula o uso tarifado por demanda da API. Verifique os termos, condições e franquias da sua assinatura de ferramentas de programação separadamente.
O processamento em lote pode reduzir a fatura?
A API Batch estipula $4 para entrada e $20 para saída por milhão de tokens do Fable. Recorra ao processamento assíncrono quando o fluxo de trabalho puder aguardar; o fast mode não está disponível em conjunto com o Batch.
Um custo menor por chamada significa uma entrega final mais barata?
Apenas se as novas tentativas, a taxa de aprovação, a orquestração e a revisão sustentarem essa vantagem. Compare o investimento total em relação às tarefas efetivamente aprovadas, mantendo os mesmos critérios de avaliação.
Recursos adicionais
Para complementar o planejamento de seus fluxos de trabalho, leia nossos artigos sobre gestão de custos de agentes de programação e capacidade de revisão humana para agentes paralelos. Reconfirme a documentação de preços e de esforço da Anthropic indicada nos links antes de consolidar essas tarifas em um novo orçamento.


