

GPT-6.2 Astra vs Fable 5.2 está mais equilibrado do que as manchetes sugerem. Ambos têm preço de tabela de US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída. A Anthropic publica pontuações mais altas em codificação agêntica para o Fable 5.2; a OpenAI não publica nenhum benchmark de codificação para o Astra. O preço de cache, as sobretaxas de contexto longo e a sua própria taxa de alterações aceitas é que decidem o vencedor para o seu time.
A OpenAI lançou o GPT-6.2 Astra em 17 de novembro de 2026, oito dias depois de a Anthropic disponibilizar o Claude Fable 5.2. Ambos são modelos de fronteira voltados a trabalhos agênticos longos e difíceis. Se você roda agentes de codificação, agora tem duas opções de ponta pelo mesmo preço de tabela.
Um ranking não resolve isso para você. Suas dependências, sua suíte de testes e seus revisores resolvem. Este guia compara os números publicados, mostra onde as faturas divergem e apresenta um teste frente a frente que você pode rodar no seu próprio repositório. Se você já usa o Codex e o Claude Code lado a lado, o Sharkly é onde você atribui a mesma tarefa a ambos e mantém os resultados juntos.
GPT-6.2 Astra vs Fable 5.2: as especificações lado a lado
O GPT-6.2 Astra é o modelo de fronteira da OpenAI na família GPT-6.2; o GPT-6.2 Sol é o irmão mais barato para o dia a dia. O Claude Fable 5.2 é o modelo de ponta de disponibilidade geral da Anthropic, com o Mythos 5.2 mantido como lançamento de acesso limitado. Veja o que cada fornecedor publica, verificado em 20 de novembro de 2026.
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| Lançamento | 17 de novembro de 2026 | 9 de novembro de 2026 |
| ID do modelo na API | gpt-6.2-astra |
claude-fable-5-2 |
| Entrada, por 1M de tokens | US$ 8 | US$ 8 |
| Saída, por 1M de tokens | US$ 40 | US$ 40 |
| Entrada em cache (acerto de cache) | US$ 0,40 | US$ 0,20 |
| Gravação de cache | US$ 10 (30 minutos) | US$ 10 (5 minutos), US$ 16 (1 hora) |
| Lote | 50% do padrão | US$ 4 entrada, US$ 20 saída |
| Modo rápido | 2x o padrão | US$ 16 entrada, US$ 80 saída |
| Janela de contexto | 1.050.000 tokens (922.000 máximo de entrada) | 1M de tokens no preço padrão |
| Saída máxima | 128.000 tokens | 128.000 tokens |
| Sobretaxa de entrada longa | Acima de 272K de entrada: tarifas de entrada e cache dobram, saída 1,5x | Nenhuma listada |
| Agente de codificação usual | Codex | Claude Code |
Fontes: a página do modelo GPT-6.2 Astra da OpenAI, a documentação de preços e a visão geral dos modelos da Anthropic.
Duas linhas importam mais para agentes. Um agente de codificação reenvia o contexto a cada turno, então a taxa de acerto de cache define a maior parte da fatura. E um agente que já leu um repositório grande pode ultrapassar 272K de tokens de entrada, ponto em que as tarifas do Astra mudam.
O que os benchmarks de codificação dizem — e o que não dizem
O anúncio do Fable 5.2 da Anthropic reporta 69,9% no FrontierSWE v2 e 49,1% no FrontierCode 2.0 com esforço Xhigh. Na mesma tabela, a coluna de comparação da OpenAI é o GPT-6 Astra, a geração anterior, com 65,5% e 42,8%.
Essa tabela não inclui o GPT-6.2 Astra. A página do modelo da OpenAI também não lista nenhuma pontuação de codificação no estilo SWE para ele. O texto de lançamento de Simon Willison observa que “o Astra 6.2 não está pontuando tão alto quanto o Fable 5.2 em vários benchmarks” e que alguns usuários acham seu estilo de comunicação “confuso”.
Portanto, a leitura honesta tem três partes:
- O Fable 5.2 tem pontuações publicadas de codificação agêntica, medidas pelo próprio fornecedor, à frente do último Astra.
- Nenhum fornecedor publicou uma comparação direta de codificação com o GPT-6.2 Astra.
- Todos os números acima foram gerados pelo próprio fornecedor do modelo, no seu próprio harness, com níveis de esforço escolhidos.
Trate benchmarks como um filtro inicial. Este artigo não inclui resultados de testes independentes de nenhum dos dois modelos.
Onde as faturas divergem
Preços de tabela iguais não significam faturas iguais. Três mecanismos as separam.
Acertos de cache
O Fable 5.2 cobra US$ 0,20 por milhão de tokens em um acerto de cache. O Astra cobra US$ 0,40. Para um agente que reenvia um prefixo em cache de 100.000 tokens 50 vezes numa sessão, esse prefixo custa US$ 1,00 no Fable e US$ 2,00 no Astra, antes de entrada e saída novas. Simon Willison ainda considera o preço em cache do Astra “uma ótima notícia para sessões agênticas mais longas”; é muito mais baixo que a tarifa de US$ 8 sem cache.
Contexto longo
As tarifas do Astra sobem quando uma requisição ultrapassa 272K de tokens de entrada. A Anthropic lista o contexto completo de 1M nas tarifas padrão do Fable. Se seus agentes carregam rotineiramente meio monorepo, modele esse limite antes de fechar a decisão.
Esforço e tokens por tarefa
Ambos os modelos expõem níveis de esforço, e um esforço mais alto consome mais tokens. O teste informal de SVG do Simon mostra a variação em um prompt: o GPT-6.2 Astra custou 11,55 centavos com esforço High e 88,71 centavos com Max. É um único prompt de brinquedo, não um benchmark de codificação, mas a diferença de 7x mostra por que você deve fixar o nível de esforço antes de comparar custos.
Nosso detalhamento de preços do Fable 5.2 examina retentativas e tempo de revisão; o guia de limites de taxa do GPT-6.2 cobre o teto de tokens por minuto que os agentes do Astra atingem primeiro.
Como rodar um teste GPT-6.2 Astra vs Fable 5.2 no seu próprio repositório
Um duelo no seu próprio código vence qualquer tabela publicada. O método abaixo segue o nosso guia mais completo para avaliar o Fable 5.2 no seu código; aqui ele roda como um duelo entre dois modelos.
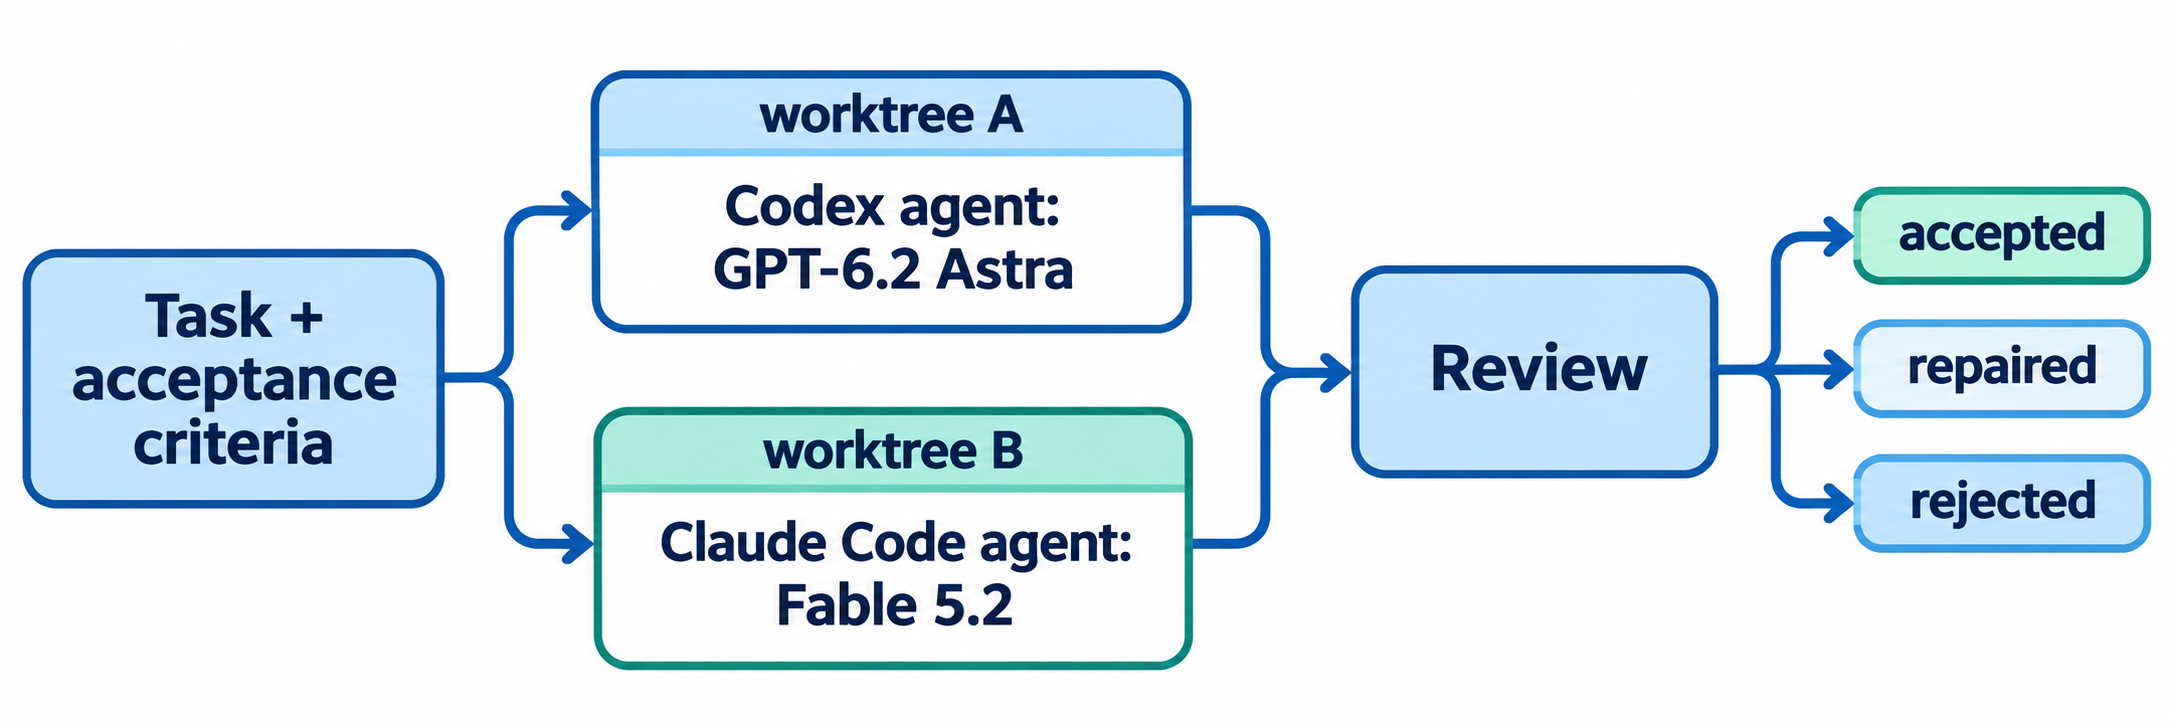
- Escolha 10 a 12 tarefas recentes do seu backlog: correções de bugs, pequenas adições, uma refatoração e uma investigação.
- Escreva os critérios de aceitação primeiro, antes de qualquer agente rodar, para que nenhum resultado molde o padrão.
- Fixe o harness. O Astra roda melhor no Codex e o Fable no Claude Code, então você está comparando dois fluxos completos. Diga isso no seu relatório.
- Fixe o nível de esforço. Escolha High em ambos, ou nomeie as configurações exatas que usou.
- Isole cada tentativa em um worktree git novo, para que nenhum agente herde as edições do outro.
- Rode cada tarefa nos dois modelos, alternando qual vem primeiro.
- Revise às cegas quando possível e pontue cada resultado como aceito, aceito após reparo ou rejeitado.
- Divida o gasto total pelas alterações aceitas, incluindo as tentativas fracassadas.
O custo por alteração aceita é o número que decide. Um modelo que é 20% mais barato por token mas precisa de um ciclo extra de reparo por tarefa é o modelo mais caro para o seu time.
Rode os dois modelos como Agentes no Sharkly
O Sharkly roda os agentes de codificação que você já usa; ele não os substitui. Um Agente no Sharkly é um colega de IA configurado que executa Tarefas por meio de um Runtime, como o Codex ou o Claude Code, em um Computador que você conecta.
Monte o duelo com dois Agentes:
- Agente Astra: um Runtime Codex configurado para
gpt-6.2-astra. - Agente Fable: um Runtime Claude Code configurado para
claude-fable-5-2.
Cada Agente tem um modelo padrão, escolhido em Computador, Runtime e Diretório de trabalho a partir dos modelos que o seu Runtime reporta. Consulte a central de ajuda do Sharkly para ver as configurações atuais dos Agentes.
Defina os mesmos limites de execução nos dois Agentes, para que nenhum tenha mais execuções paralelas ou um orçamento de tempo maior que o outro.

Use o modo de diretório de trabalho Temporário, para que cada Tarefa receba um diretório isolado e execuções com suporte de repositório possam preparar um worktree novo. Coloque os critérios de aceitação na descrição da Tarefa. Cada Agente reporta seu patch e as verificações de volta à sua própria Tarefa, o que mantém cada tentativa junto ao veredito do revisor.
O uso do modelo continua nas suas próprias assinaturas e chaves de API. O Sharkly não vende tokens, e a cota de modelos depende das ferramentas, planos e contas de API que o seu time conecta.
Alternativas a uma escolha direta entre Astra e Fable
Você não precisa coroar um único modelo.
- Divida por tipo de tarefa. Use o Fable 5.2 nas categorias em que ele vence o seu teste, e o Astra no restante.
- Lidere com um, escale com o outro. Um modelo de fronteira planeja e revisa; um modelo mais barato faz as peças rotineiras, o padrão em GPT-6 Astra como líder da sua Crew.
- Desça uma camada. O GPT-6.2 Sol tem preço de tabela de US$ 2 de entrada e US$ 10 de saída por milhão de tokens. Para manutenção rotineira, pode atender o seu critério por um quarto do preço.
- Mantenha os dois vivos. Neutralidade de fornecedor é o ponto: nenhum modelo isolado se mantém o melhor por muito tempo, como argumentou o artigo Argon, Astra e Opus.
Casos de uso reais
- Migrações longas. A Anthropic relata que um time de agentes Fable 5.2 migrou um serviço de produção de Python para Rust. Teste esse tipo de trabalho com um recorte seu antes de confiar qualquer um dos modelos para isso.
- Investigações em repositórios grandes. Ultrapasse 272K de tokens de entrada e o preço do Astra muda. Rode o modelo de custo com o seu tamanho real de contexto.
- Filas paralelas de bugs. Dez correções pequenas divididas entre os dois Agentes dão a você uma taxa de alterações aceitas por modelo dentro de uma semana.
Conclusão
O GPT-6.2 Astra e o Fable 5.2 custam o mesmo por token no papel. O Fable tem as pontuações de codificação publicadas mais fortes e acertos de cache mais baratos; o Astra tem uma janela de contexto um pouco maior, mas tarifas mais altas acima de 272K de entrada. Nenhum desses fatos diz qual deles entrega mais código aceito no seu repositório.
Faça o duelo. Conecte um Computador ao Sharkly, crie um Agente Codex no GPT-6.2 Astra e um Agente Claude Code no Fable 5.2, e atribua as mesmas cinco tarefas aos dois nesta semana. Fique com o modelo que vencer em custo por alteração aceita.
Perguntas frequentes
O GPT-6.2 Astra é mais barato que o Claude Fable 5.2?
Não. Ambos têm preço de tabela de US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída. Os acertos de cache do Fable são mais baratos (US$ 0,20 vs US$ 0,40), e as tarifas do Astra sobem acima de 272K de tokens de entrada.
Qual é melhor para codificação, GPT-6.2 Astra ou Fable 5.2?
A Anthropic reporta pontuações mais altas de codificação agêntica para o Fable 5.2 do que para o GPT-6 Astra anterior. Nenhum benchmark publicado compara o Fable 5.2 diretamente com o GPT-6.2 Astra, então teste os dois nas suas próprias tarefas.
Qual é a janela de contexto do GPT-6.2 Astra e do Fable 5.2?
O GPT-6.2 Astra lista 1.050.000 tokens com um limite de 922.000 tokens de entrada. O Fable 5.2 inclui um contexto de 1M de tokens no preço padrão. Ambos limitam a saída a 128.000 tokens.
Posso usar o GPT-6.2 Astra no Claude Code ou o Fable 5.2 no Codex?
Cada modelo é normalmente executado no agente de codificação do seu próprio fornecedor: o Astra no Codex, o Fable no Claude Code. Compará-los geralmente significa comparar dois fluxos completos, modelo mais harness.
Como comparar dois modelos de codificação de forma justa?
Use as mesmas tarefas, critérios de aceitação escritos, níveis de esforço fixos e worktrees isolados. Pontue os resultados como aceitos, reparados e rejeitados, e divida o gasto total pelas alterações aceitas.
O Sharkly escolhe o modelo para o meu Agente?
Não. Você escolhe o modelo padrão de cada Agente a partir dos modelos que o seu Runtime reporta. O Sharkly não roteia tarefas entre modelos automaticamente.


