
A Anthropic lançou o Claude Sonnet 5.5 em 28 de setembro a US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída — o mesmo preço de tabela do Sonnet 5 e a metade do Opus 5.5. Segundo a Anthropic, ele roda mais de 30% mais rápido que o Sonnet 5 e custa até 30% menos por tarefa. Para uma equipe que opera diversos agentes de código, a grande novidade é que o modelo que você colocaria em Agents do dia a dia agora fica apenas alguns pontos abaixo do carro-chefe na maioria das linhas da tabela de lançamento da Anthropic.
Colocá-lo no quadro é menos automático do que parece. O modelo default do Claude Code resolve para Opus 5.5 nos planos Pro, Max, Team, Enterprise e na Anthropic API, portanto um Computer executando o Claude Code continua no modelo principal até que alguém o altere. O alias sonnet aponta para o Sonnet 5.5 apenas na Anthropic API; no Bedrock, Google Cloud e Microsoft Foundry, ele ainda resolve para o Sonnet 4.5. Uma equipe que “migrou para o Sonnet” pode acabar com três modelos em três Computers diferentes, sem ter como saber qual execução usou qual modelo. Este guia adota o menor caminho viável: um Computer, um Agent, uma Task real e, em seguida, uma decisão sobre onde o Opus 5.5 ainda justifica o seu preço.
TL;DR
Atualize o Claude Code no Computer para a versão v2.1.284 ou posterior, fixe o ID completo claude-sonnet-5-5 em vez do alias sonnet e faça um novo escaneamento até que o Claude Code Runtime exiba Available. Escreva instruções para o Agent que evitem os check-ins prematuros e as adições não solicitadas do Sonnet 5.5, mantenha o diretório de trabalho como Temporary, defina o tempo limite (timeout) de acordo com um escopo bem delimitado e atribua uma Task. Em uma Crew, coloque os membros de tarefas rotineiras no Sonnet 5.5 e mantenha o Opus 5.5 como líder e revisor. Agents pesquisam, executam, testam e relatam. Pessoas definem o direcionamento, concedem autoridade e aprovam o resultado.
Onde fica a configuração do modelo
O Sharkly não escolhe modelos. A documentação dos Agents afirma isso com clareza: “O Agent segue o modelo padrão do Runtime. Ele não garante nem exibe um nome de modelo específico. Altere os modelos na configuração de ferramentas do Runtime ou do Computer, não no Agent.” A mesma página acrescenta que o Agent não disponibiliza nenhum seletor de modelos nem controle de profundidade de pensamento.
Isso é importante para o Sonnet 5.5, pois o esforço é onde o comportamento deste modelo mais varia — e o esforço reside onde o modelo reside: no Claude Code dentro do Computer. O Agent define como o trabalho é conduzido, o Computer fornece o host, o Runtime (neste caso, o Claude Code) executa a sessão, e a Task permanece como o registro compartilhado.
Etapa 1: configure o Sonnet 5.5 no Claude Code no Computer
O Sonnet 5.5 exige o Claude Code v2.1.284 ou posterior, de acordo com a documentação de configuração de modelos do Claude Code. Atualize-o no Computer e faça login com um plano pago ou uma chave de API que tenha acesso; o Claude Code não está disponível no Claude Free (o que uma licença de chat pode ou não executar). Em seguida, execute claude --model claude-sonnet-5-5 em um terminal comum nesse host. Se uma sessão for iniciada, o Sharkly poderá utilizá-la.
Fixe o ID completo, e não o alias. É para isto que sonnet resolve no Claude Code atualmente:
| De onde o Claude Code obtém o modelo | O alias sonnet resolve para |
|---|---|
| Anthropic API | Sonnet 5.5 |
| Claude Platform on AWS | Sonnet 4.6 |
| Amazon Bedrock | Sonnet 4.5 |
| Google Cloud Agent Platform | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
O ID é claude-sonnet-5-5 em todos os lugares, exceto no Bedrock, onde o modelo opera por meio do perfil global entre regiões global.anthropic.claude-sonnet-5-5. O opusplan também herda o problema do alias: ele planeja no Opus e executa no que quer que sonnet signifique no momento.
Depois, garanta que a escolha seja definitiva: defina o modelo na configuração do Claude Code nesse Computer, para que cada execução iniciada pelo serviço local adote o Sonnet 5.5 em vez do padrão Opus 5.5, e repita a verificação no terminal.
De volta ao Sharkly, abra os detalhes do Computer e execute a ação de novo escaneamento ou teste de conexão. O Claude Code Runtime deve exibir Available. Um Computer que aparece como online indica apenas que o serviço local está enviando heartbeats; o status do Runtime é o que realmente indica que uma execução pode começar.
Etapa 2: estruture o Agent de acordo com o comportamento do Sonnet 5.5
Abra Agents, selecione New Agent e escolha o Computer e o Claude Code Runtime. O guia de engenharia de prompts do Sonnet 5.5 da Anthropic descreve comportamentos que costumam ir parar direto na fila de revisão.
O nível de esforço define qual modelo você contratou. O Claude Code executa o Sonnet 5.5 com esforço medium por padrão, e o pensamento não pode ser desativado ali. A maior parte dos números de destaque do lançamento foi medida em max. Os gráficos da Anthropic posicionam o Sonnet 5.5 em 39,2% no CursorBench 4.0 em medium e 55,5% em max, a um custo estimado de US$ 0,70 e US$ 9,67 por tarefa. Trata-se de orçamentos diferentes, não de uma configuração certa ou errada. O guia recomenda medium para codificação agêntica em tarefas com escopo bem delimitado, reservando xhigh e max para ganhos mensuráveis.
Ele faz check-ins prematuros. Em níveis de esforço low e medium, o Sonnet 5.5 tende a interromper a execução e fazer perguntas intermediárias em tarefas agênticas longas. No Sharkly, esse check-in retorna para a Task na forma de comentário, a Task passa a indicar que está aguardando resposta humana e fica parada na Inbox de alguém até que seja respondida. Oriente o Agent a prosseguir com base em premissas explícitas. Em low effort, ele também pode sinalizar o código como concluído sem executar os testes; portanto, exija validações.
Ele adiciona coisas que ninguém pediu. O guia aponta a criação não solicitada de testes, documentações e pequenos arquivos em todos os níveis de esforço, além de rodadas adicionais de revisão ou subagentes revisores em xhigh e max. As notas de rodapé de lançamento da Anthropic revelam o impacto disso: o Sonnet 5.5 pontuou menos no FrontierCode em max do que em xhigh porque acionou com mais frequência a habilidade de code review do Claude Code, que dispara vários subagentes; em dois casos analisados pela Cognition, isso provocou estouro de tempo (timeout) ou alterações fora do escopo. Para quem revisa, o resultado é um diff muito maior, com edições que fogem da Task.
Tempo limite e diretório. A Anthropic posiciona o Sonnet 5.5 para “tarefas rotineiras de escopo bem delimitado”. Sendo assim, ajuste o tempo limite por Task de acordo com essa premissa e, caso uma execução atinja o limite, divida a Task antes de simplesmente aumentar o tempo. Mantenha o diretório de trabalho como Temporary: cada Task recebe um diretório isolado, e execuções associadas a repositórios preparam uma nova worktree, evitando que execuções paralelas sobrescrevam arquivos umas das outras. Deixe a simultaneidade no valor padrão, 50% do limite do Computer, até que ele tenha operado sob carga real.
Instruções para adaptar:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior. Do not add tests,
docs, or new files unless the Task asks for them; list any you
think are missing in your report instead.
Do not stop to ask whether to continue. When a detail is ambiguous,
proceed with a stated assumption and record it in your report.
Ask only when different interpretations would materially change
the result.
Run the closest relevant checks before reporting done, and report
failures without hiding them.
Do not start extra review rounds or reviewer subagents.
If a safeguard notice or refusal appears, say so in your report.
Stop and ask before anything destructive or outside the attached
repositories.
Etapa 3: atribua uma Task e, em seguida, estruture uma Crew de dois níveis
Escolha uma Task com um critério de aceitação bem definido, selecione o Agent como Assignee e mova-a do Backlog (onde as Tasks atribuídas aguardam) para um status pronto para execução. A execução passa pelas fases de queued, dispatched e running, e a aba Executions transmite os logs em tempo real.
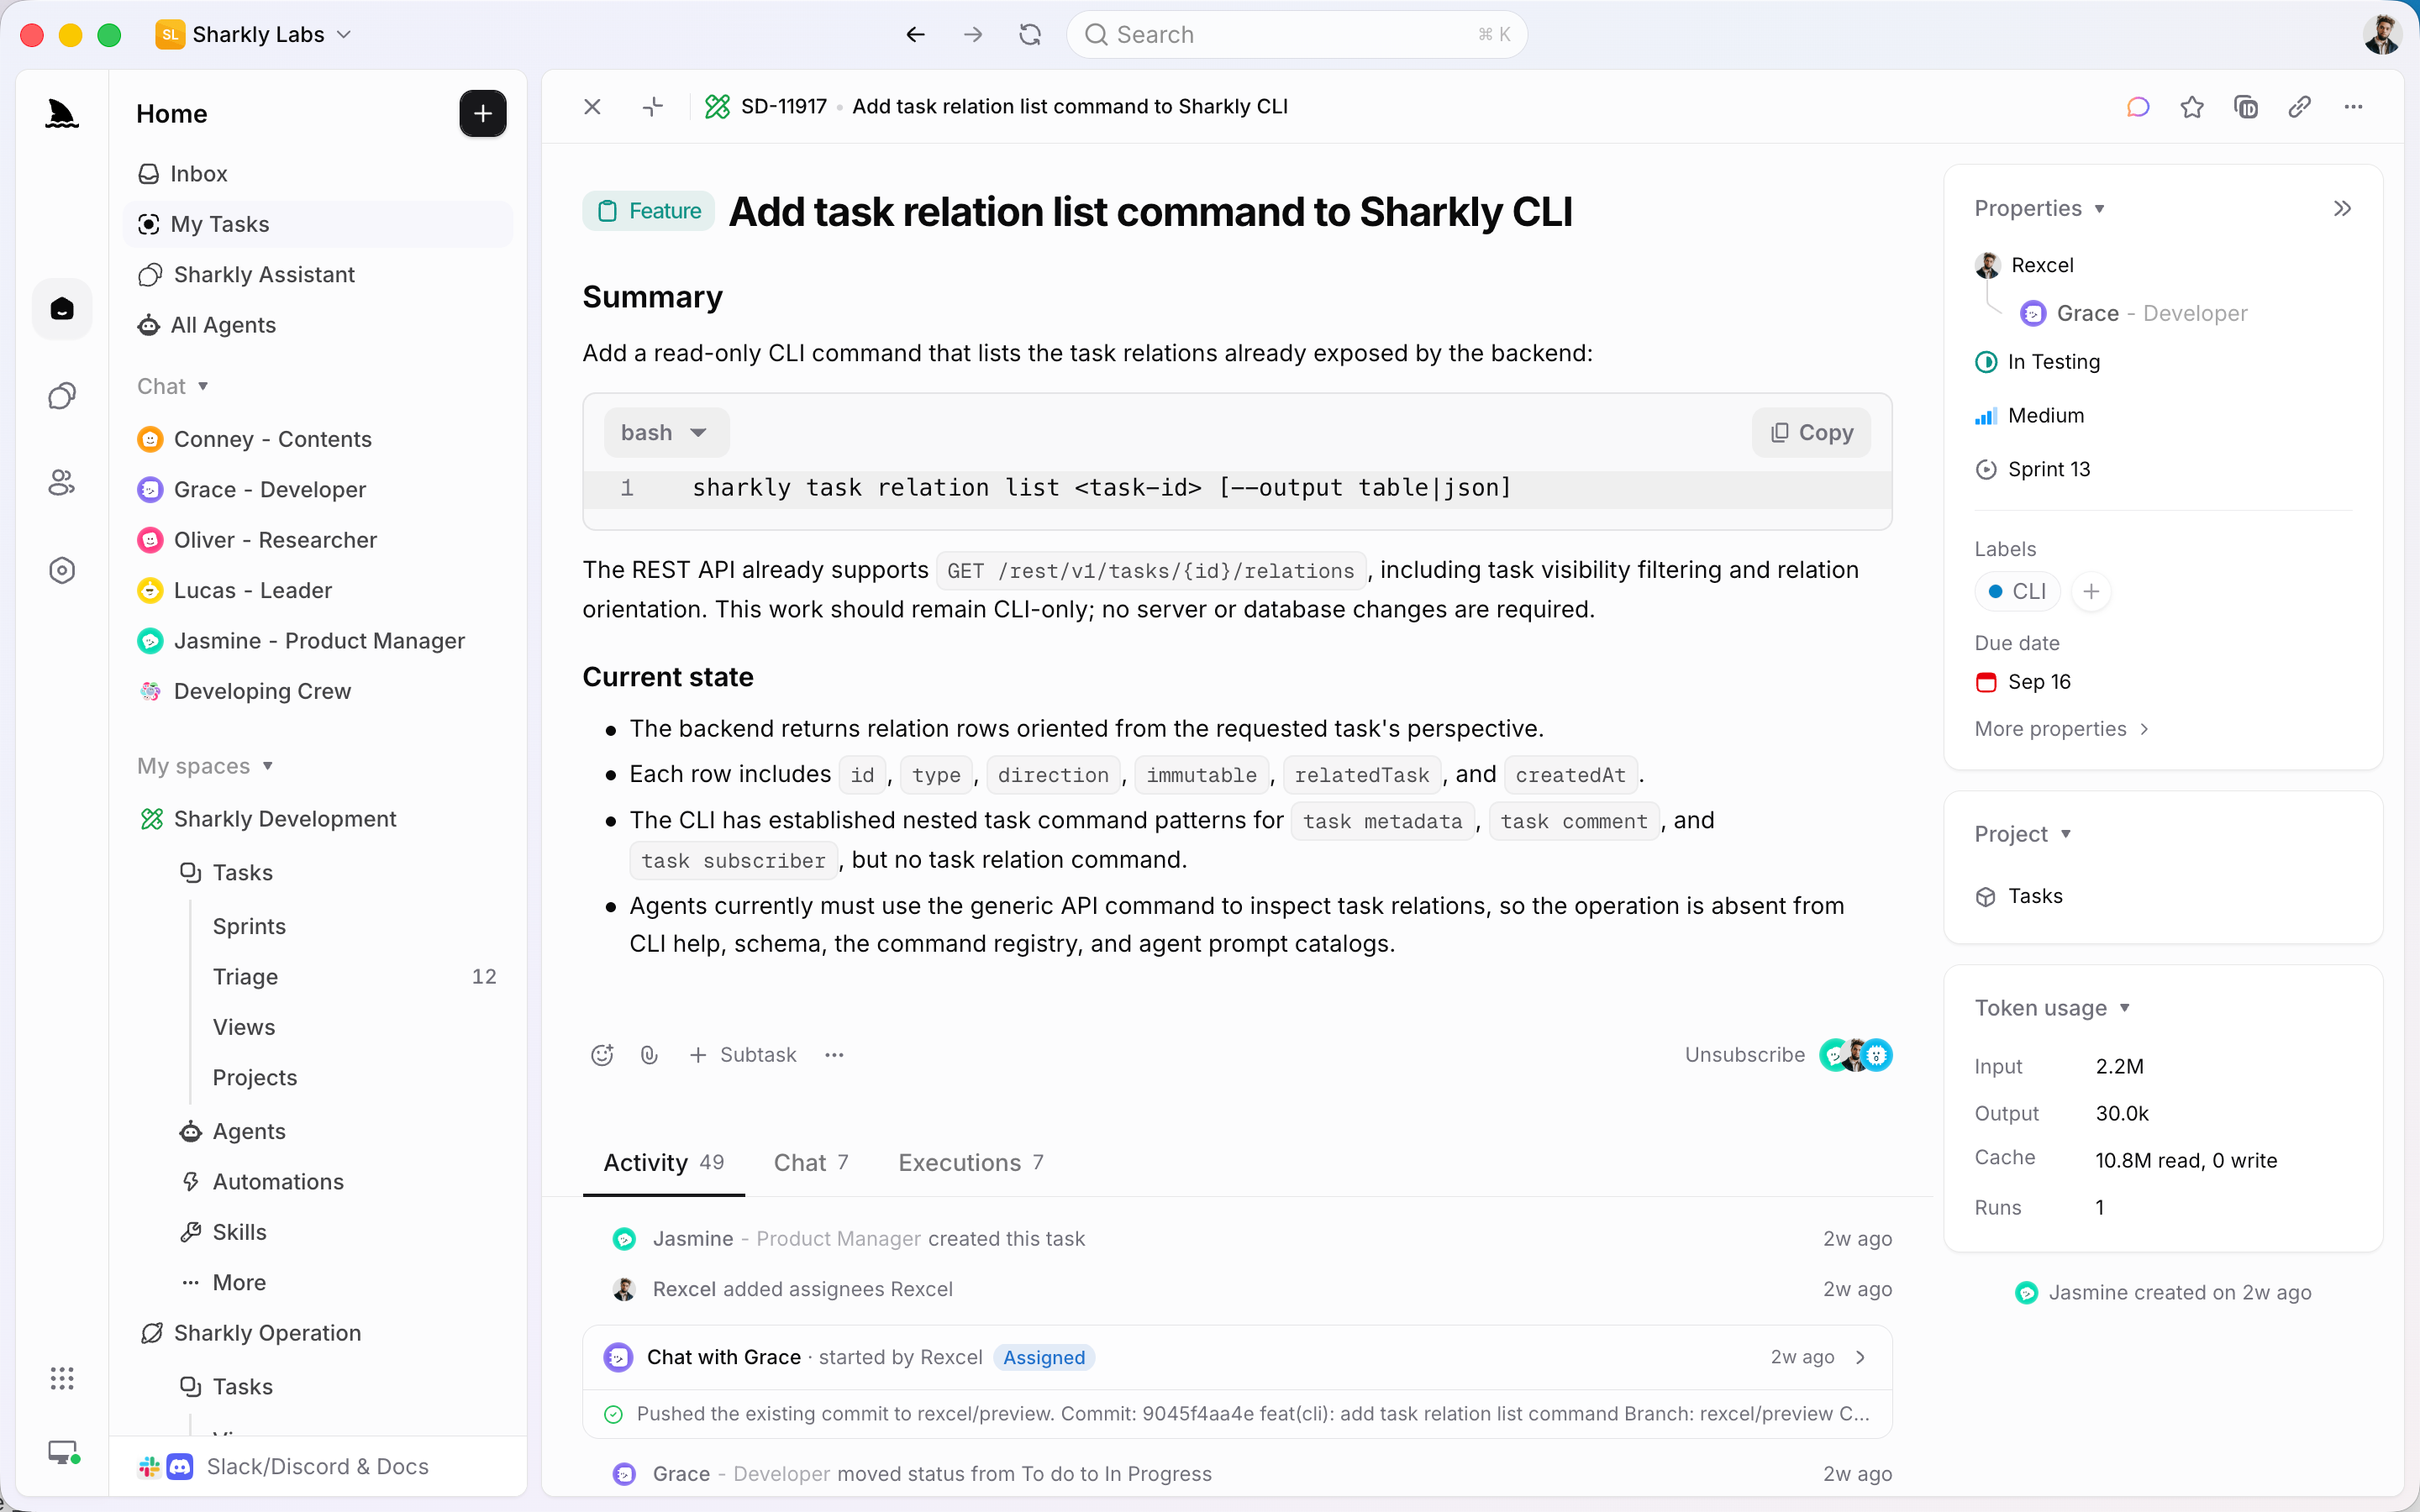
Mantenha essa primeira Task em um único Agent. Uma Crew é um grupo reutilizável de People e Agents coordenado por um Agent líder, e ela se justifica quando o líder precisa interpretar um objetivo e consolidar os resultados de múltiplos membros em uma única Task. Para a correção de um bug pontual, um único Agent é a escolha certa.
Em uma Crew, a divisão segue o próprio posicionamento da Anthropic. O Opus 5.5 “continua nitidamente superior em trabalhos complexos e abertos”, o que descreve com precisão a função do líder: planejar, atribuir e revisar. O trabalho dos membros é exatamente aquele de escopo bem delimitado para o qual o Sonnet 5.5 foi projetado, e um dos primeiros testadores citados na página de lançamento descreve essa mesma dinâmica: o Sonnet 5.5 implementando uma arquitetura definida pelo Opus 5.5.
| Modelo do Runtime | ID da API | Entrada / saída por 1M | Onde se encaixa |
|---|---|---|---|
| Claude Sonnet 5.5 | claude-sonnet-5-5 |
$2 / $10 | Membros de rotina: correções de bugs, recursos delimitados, docs |
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | Líder, revisor, trabalho de escopo aberto |
| Claude Sonnet 5 | claude-sonnet-5 |
$2 / $10 | A versão anterior do Sonnet; para onde convergem requisições de cibersegurança sinalizadas |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Um segundo Runtime, no Codex, pelo mesmo preço |
Como o local documentado para o modelo é a configuração de ferramentas do Computer, a estrutura de dois níveis mais direta consiste em dois Computers: um em que o Claude Code mantém o padrão Opus 5.5 para o líder e outro fixado em claude-sonnet-5-5 para os membros. Onde traçar o limite entre eles é uma regra de roteamento que vale a pena registrar; o artigo Sonnet 5.5 ou Opus 5.5 detalha esse processo, e Sonnet 5.5 contra GPT-6 Sol aborda a outra opção de Runtime nessa mesma faixa de preço. O consumo do modelo continua sendo tarifado pelas assinaturas ou chaves de API configuradas nessas ferramentas; portanto, essas cobranças constarão na fatura do seu provedor, e não no Sharkly.
O que muda no quadro
Execuções mais rápidas recaem sobre os mesmos revisores. Mais tarefas concluídas por dia com o mesmo orçamento não significam mais horas de revisores disponíveis, e o hábito de adicionar testes e documentação torna cada diff mais extenso. Planeje sua operação considerando a capacidade de revisão, e não apenas o custo do modelo.
Uma execução sinalizada pode não ser uma execução do Sonnet 5.5. Esta é a primeira versão do Sonnet com salvaguardas cibernéticas. A Anthropic afirma que tarefas cibernéticas de maior risco “irão, de forma visível, recorrer ao Sonnet 5 como fallback”, e o cartão de sistema (system card) alerta para mais recusas mesmo em atividades legítimas de segurança. Estar visível na sessão não significa estar visível no quadro: o Sharkly não exibe o nome do modelo; portanto, nada na Task indicará qual modelo respondeu, a menos que o Agent registre isso. É exatamente por isso que as instruções acima solicitam esse registro.
O raciocínio permanece com o modelo que o gerou. O Sonnet 5.5 não consegue ler os blocos de pensamento do Opus 5.5, nenhum outro modelo lê os do Sonnet 5.5, e blocos ilegíveis são descartados sem gerar erro. Mesmo dentro de uma única sessão do Claude Code, alternar entre os dois preserva o texto visível, mas descarta o raciocínio subjacente. Entre Agents em uma Crew, o raciocínio nunca foi transmitido: o revisor recebe apenas o que o membro escreveu na Task. O artigo Transições entre modelos perdem o raciocínio explica como contornar isso, e os modelos de transição oferecem uma estrutura prática.
O modelo mudou esta semana. A atribuição, o contexto, o progresso, os impedimentos, os resultados e a revisão humana continuam onde toda a equipe pode acompanhar. Você pode estruturar isso manualmente com worktrees ou usar o Sharkly para gerenciar todo o fluxo de trabalho.


