

Pergunte ao seu agente de código onde uma função é chamada e observe o que acontece. Ele faz um grep, lê três arquivos, faz grep de novo com outro padrão, lê mais quatro e por fim responde corretamente — depois de ter enchido o contexto com código-fonte que vai esquecer assim que a sessão terminar. Faça uma pergunta de acompanhamento e ele repete tudo de novo.
O codebase-memory-mcp elimina esse ciclo. Com 41.536 estrelas, licença MIT e escrito em C, é a entrada da onda de ferramentas para agentes deste ano com o melhor retorno e a menor mudança na sua forma de trabalhar. Ele dá ao agente memória do seu código. Não dá à sua equipe memória do trabalho — e esses são problemas diferentes.
TL;DR
Esta é uma das cinco análises aprofundadas do nosso compilado de ferramentas de código aberto que ampliam agentes de codificação.
O codebase-memory-mcp indexa um repositório em um grafo de conhecimento persistente de funções, classes, cadeias de chamadas e rotas, e depois responde perguntas estruturais a partir do grafo em vez de fazer grep. O projeto mede cinco consultas estruturais em cerca de 3.400 tokens via grafo, contra aproximadamente 412.000 tokens arquivo por arquivo. É um único binário nativo, não precisa de runtime nem chave de API, roda inteiramente local e funciona com qualquer cliente MCP. Instale-o primeiro. Depois decida, separadamente, onde vai ficar o registro do que os seus agentes fizeram.
O que ele faz
A análise sintática passa pelo tree-sitter em mais de 160 linguagens, com resolução semântica de tipos aplicada a um grupo principal que inclui Python, a família TypeScript e JavaScript, Go, Java, Rust, C# e C++. O resultado é exposto como 15 ferramentas MCP que cobrem busca, rastreamento de cadeias de chamadas, visão geral da arquitetura, análise de impacto, detecção de código morto, consultas ao grafo e ligação HTTP entre serviços. Qualquer cliente que fale o Model Context Protocol pode usá-lo, e o projeto lista 45 superfícies de agentes compatíveis.
| Métrica | Relatado |
|---|---|
| Cinco consultas estruturais | ~3.400 tokens vs ~412.000 arquivo por arquivo |
| Comparação revisada por pares | 10x menos tokens, 2,1x menos chamadas de ferramenta, 83% de qualidade nas respostas |
| Índice do kernel do Linux | 28 milhões de linhas, 75 mil arquivos, 3 minutos |
| Latência de consultas estruturais | Menos de 1 ms |
Leia os dois números de tokens em conjunto. A redução de 99% corresponde a cinco consultas estruturais, ou seja, o melhor cenário do grafo. O número do preprint, considerando 31 repositórios, é de 10x. Planeje com base em 10x e trate qualquer coisa melhor como bônus.
Instalando
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bash
No Windows há um instalador em PowerShell, e o projeto recomenda lê-lo antes de executar. O instalador detecta seus agentes de codificação e grava as entradas MCP deles. Reinicie o agente e peça que ele indexe o projeto.
Duas configurações que vale a pena aplicar logo no primeiro dia:
codebase-memory-mcp config set auto_index true
codebase-memory-mcp --ui=true --port=9749
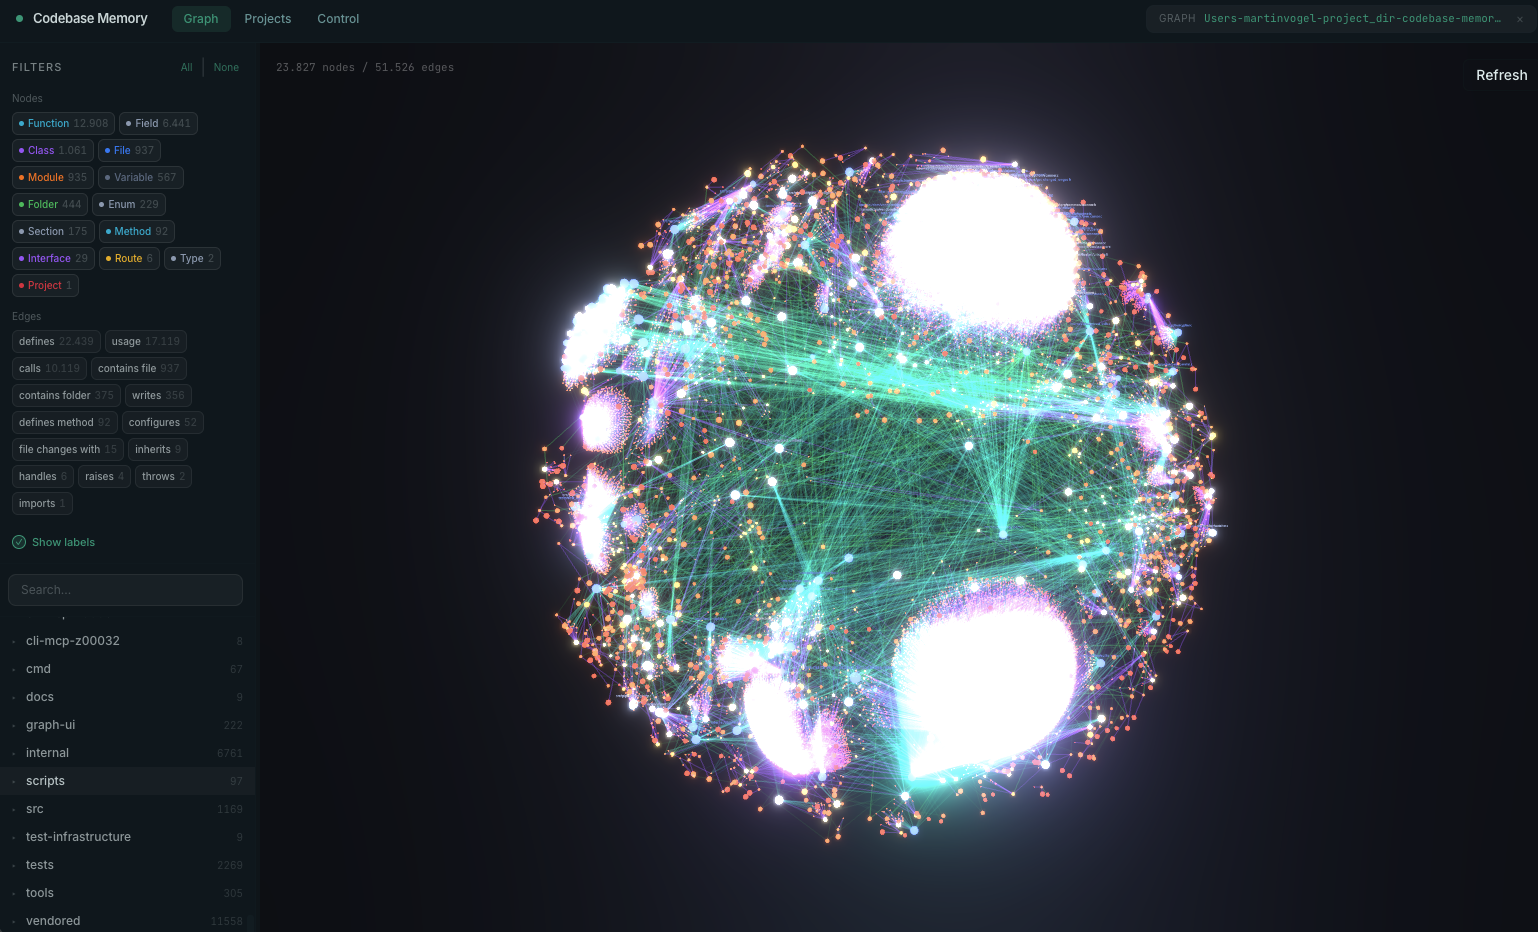
O visualizador de grafo vem embutido no binário e é uma boa verificação para confirmar que o índice cobriu o que você esperava.
Duas ressalvas que o próprio projeto documenta, e que merecem trinta segundos de atenção. O Microsoft Defender pode sinalizar um binário de release como falso positivo; o projeto observa que, normalmente, 61 de cerca de 62 engines retornam limpo e que a mesma família de detecção atinge o GitHub CLI e a própria toolchain Go da Microsoft. E a ferramenta lê a sua base de código e grava nos arquivos de configuração dos seus agentes — o que é justamente a função dela, dito sem rodeios. Leia o script de instalação antes de canalizá-lo para um shell.
Por que começar por esta
Todo o resto da onda atual de ferramentas pede que você mude a forma como trabalha. Bibliotecas de papéis mudam como você escreve prompts. Worktrees paralelos mudam como você organiza o trabalho. Acesso à web muda o que você pede.
Esta não muda nada e deixa todas as sessões mais baratas. Não há hábito nenhum para aprender.
O efeito sobre a qualidade é a metade menos valorizada. Um agente que gasta 400.000 tokens lendo arquivos tem muito menos espaço para raciocinar sobre o seu problema, e a lembrança do que leu no início se degrada ao longo de uma sessão longa. Responder a partir de um grafo mantém o contexto livre.
A mudança aparece no tipo de pergunta que você faz. Perguntas que você evitava antes porque custavam 50.000 tokens e dois minutos agora saem quase de graça. A análise de impacto antes de alterar uma assinatura transforma "acho que isso é seguro" em uma lista. Rastrear a cadeia de chamadas em um repositório desconhecido é melhor do que ler cinco arquivos de baixo para cima na esperança de encontrar o ponto de entrada.
Memória do código não é memória do trabalho
Aqui está a fronteira, e ela é bem nítida.
O grafo é construído a partir do seu código, então ele sabe o que o seu código é. Ele consegue dizer que o helper de retry chama o cliente de pagamentos. Não consegue dizer por que o backoff mudou em julho, quem decidiu isso, qual era a alternativa ou se alguém revisou. Essa história existiu em uma sessão de terminal que já se foi.
As equipes sentem isso como uma assimetria estranha: o agente lembra melhor da base de código do que qualquer pessoa do time, e não lembra absolutamente nada das decisões que a produziram.
O índice também é por máquina. Ele fica em um diretório de cache sob uma conta, compartilhado entre as suas sessões locais por um daemon de coordenação, e para na borda dessa máquina.
Onde fica o registro do trabalho
Uma Task é a unidade principal de trabalho no Sharkly. Ela carrega a solicitação, o contexto, a execução, os bloqueios e o resultado em um só lugar compartilhado, em vez de dividi-los entre prompts privados e sessões de terminal.
Cada peça tem uma função. O Agent define como o trabalho deve ser conduzido. O Computer fornece o host e os recursos locais. O Runtime executa a sessão do agente propriamente dita, usando a ferramenta de codificação já instalada ali. A Task permanece como o registro compartilhado.
Essa separação torna a combinação concreta. O índice é um recurso local em um Computer, então o Computer que guarda um repositório indexado é aquele onde existe um grafo quente, em vez de uma partida fria de três minutos. Um Agent é uma configuração salva, então o setup em que o seu agente tem o índice e as permissões corretas é reutilizado em vez de recriado a cada máquina. E execução, bloqueios, resultados e a discussão de acompanhamento voltam para a linha do tempo da tarefa, que é onde o raciocínio por trás de uma mudança sobrevive.
O Sharkly não substitui o Claude Code, o Codex nem o codebase-memory-mcp. Ele adiciona a camada de tarefa compartilhada, Computer, contexto, controle e revisão ao redor deles. O uso de modelos continua pelas assinaturas ou chaves de API configuradas nessas ferramentas.
Memória de código mais memória de trabalho: essa é a combinação. Uma dá ao agente lembrança do repositório. A outra dá à equipe lembrança do que os agentes fizeram nele.
Quando você precisa de cada uma
Instale o codebase-memory-mcp agora, independentemente do tamanho da equipe. Ele é local, não exige mudança de fluxo de trabalho, e a redução de custo vale tanto para um desenvolvedor quanto para vinte.
Adicione um sistema de trabalho compartilhado quando o raciocínio precisar sobreviver à sessão: quando a revisão acontece antes do release, quando mais de uma pessoa mexe no mesmo repositório, ou quando alguém for perguntar daqui a três meses por que uma mudança foi feita. Um grafo responde o que o código faz. Ele nunca responde por quê.
Agentes pesquisam, executam, testam e reportam. Pessoas definem a direção, concedem autoridade e aceitam o resultado.
Perguntas frequentes
Funciona com agentes além do Claude Code? Sim. É um servidor MCP, então qualquer cliente MCP funciona, e o projeto lista 45 superfícies de agentes compatíveis, incluindo Cursor, Codex, Windsurf, OpenCode e Aider.
Meu código sai da minha máquina? Não. O processamento é totalmente local, e o projeto afirma que não faz nenhuma requisição de rede por conta própria nem verifica atualizações em segundo plano. O código-fonte está disponível caso você queira verificar em vez de confiar.
A redução de 99% nos tokens é realista? Esse número corresponde a cinco consultas estruturais, o melhor cenário. O número revisado por pares, considerando 31 repositórios, é de 10x menos tokens e 2,1x menos chamadas de ferramenta. Planeje com base em 10x.
Qual o tamanho de repositório que ele suporta? O caso limite declarado é o kernel do Linux, com 28 milhões de linhas em três minutos. Repositórios de aplicações comuns são indexados em milissegundos.
Ele ajuda quando vários agentes rodam ao mesmo tempo? Sim, e mais do que o de costume. Cinco agentes fazendo grep no mesmo repositório é cinco vezes o desperdício. Cada execução de Task continua recebendo seu próprio worktree isolado, enquanto o índice estrutural é compartilhado no Computer.
A versão curta
Esta é a ferramenta menos visível da onda de 2026 e a de melhor retorno. Um único binário nativo, nenhuma mudança de fluxo de trabalho e um corte de uma ordem de grandeza, devidamente medido, nos tokens que um agente gasta respondendo perguntas para as quais não deveria precisar fazer grep. Instale, indexe o seu projeto e abra o visualizador de grafo uma vez para ver o que ele construiu.
Depois, tenha clareza sobre o limite. Ele lembra do repositório, não do trabalho, e as decisões por trás de uma mudança morrem com a sessão, a menos que algo as guarde. O Sharkly faz esse papel: a Task é o registro compartilhado, a execução roda em Computers que você conecta por meio dos runtimes que já paga, e os resultados voltam para um lugar onde uma pessoa pode revisá-los e aceitá-los.


