

Jev é um novo modelo da TypeSafe AI, e não escreve código nem texto corrido. Você fornece um trecho do estado de um programa, declara as perguntas que precisa ver respondidas e ele retorna respostas tipadas com probabilidades calibradas. A TypeSafe o chama de System One Model. Ele chegou ao Vercel AI Gateway em 16 de setembro de 2026, e é por isso que de repente apareceu em todos os feeds.
Para uma equipe que opera vários agentes de codificação, a parte interessante não é o modelo. É onde um modelo de decisão se encaixa na stack. Seus agentes geram o trabalho. O problema difícil, como defendemos em por que a revisão humana é o gargalo, é decidir o que fazer com a saída de cinco execuções ao mesmo tempo: qual precisa de uma pessoa, qual pode ser mesclada, qual está travada. O Jev foi feito exatamente para esse tipo de pergunta. Este post explica o que ele é, o que não é e onde ele se encaixa acima dos seus agentes.
O que é o Jev
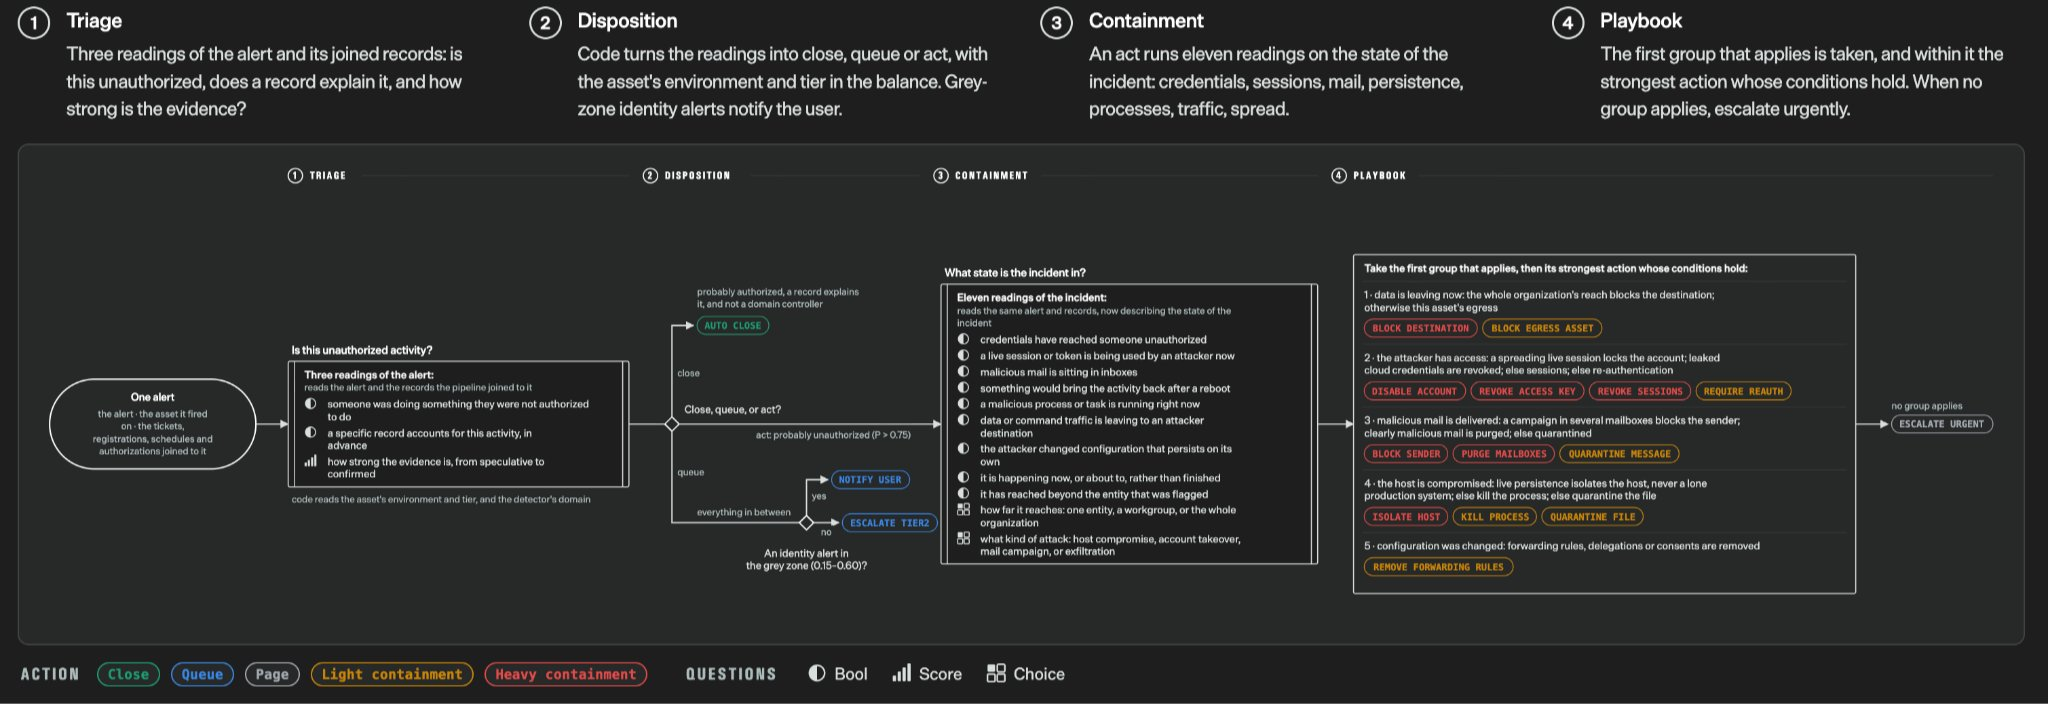
Um System One Model é um modelo que retorna decisões em vez de texto. O post de lançamento da TypeSafe resume isso como “estado não estruturado na entrada, decisões probabilísticas tipadas na saída”. Três propriedades importam.
O formato da saída é declarado antes da chamada. Você define o tipo de cada pergunta de antemão, e o modelo só pode responder dentro dele. Não há texto para interpretar nem incompatibilidade de schema para detectar.
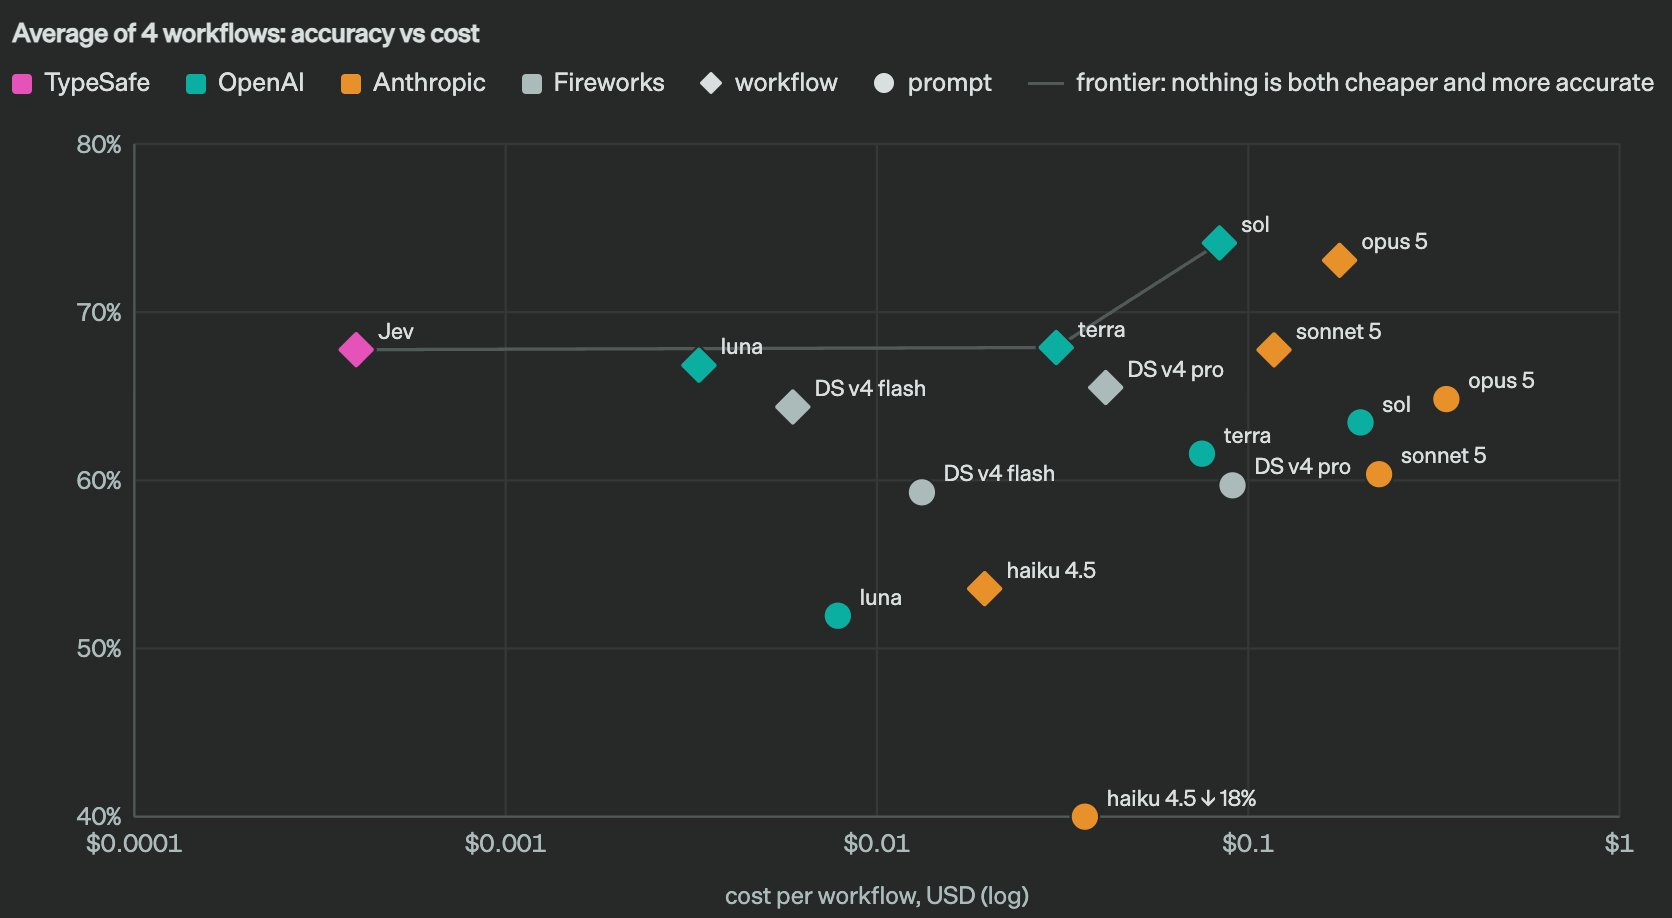
Toda resposta carrega uma probabilidade. Uma pergunta de sim/não retorna 0.97, não true. Uma escolha retorna a distribuição completa entre as opções. A TypeSafe o treinou com um método que chama de Reinforcement Learning for Calibrated Decisions, e a alegação é que uma confiança maior significa uma precisão maior, de modo que você pode definir um limite: automatize acima dele, envie o resto para uma pessoa.
Todas as perguntas são respondidas em paralelo, em uma única requisição. É por isso que a TypeSafe cita tempos ponta a ponta de 70ms a 500ms. Esses são os números do fornecedor, não um benchmark independente, mas a arquitetura os explica: nada é gerado token a token.
Os três tipos de pergunta
A API do Jev expõe três primitivas. Cada uma é um objeto JSON sob uma chave que você escolhe, todas avaliadas contra o mesmo state.
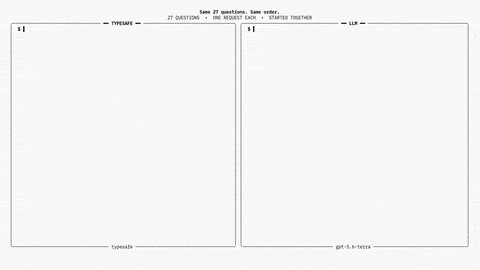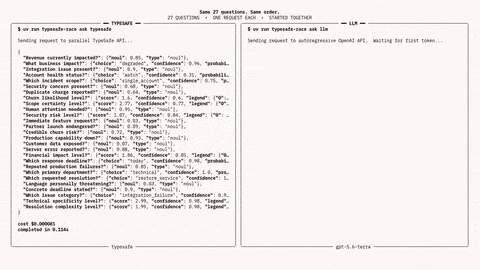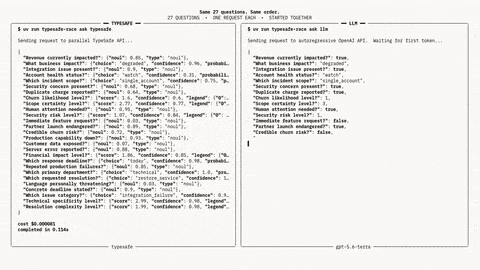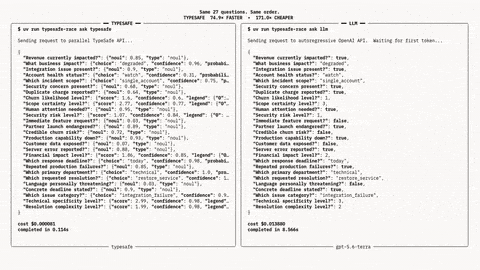
Noul é uma probabilidade de sim/não. {"type": "noul", "instructions": "Does this run need a human before merge?"} retorna {"noul": 0.91}. Você aplica o limite no código.
Choice escolhe uma opção de um conjunto nomeado de até 255. Você passa criteria mapeando nomes de opções para descrições, e a resposta traz a escolha, a distribuição completa e um valor de confiança.
Score posiciona o estado em uma rubrica ordenada de 2 a 10 níveis. A resposta é uma posição ponderada por probabilidade, então um bug pode pontuar 1.3 entre “existe solução alternativa” e “bloqueante”.
Por meio do Vercel AI SDK, o tipo sim/não é chamado de boolean e o campo é probability; no endpoint próprio da TypeSafe, é noul. Mesma ideia, chave diferente.
Onde um modelo de decisão se encaixa acima dos seus agentes
Aqui está o modelo mental que usamos. Modelos produzem tokens. Agentes de codificação (Claude Code, Codex, Gemini CLI, OpenCode) transformam tokens em mudanças em um Computer. A camada de gestão decide quem trabalha no quê e o que acontece com o resultado. O Jev pertence a essa camada superior, não à do meio. Ele não é um agente e não consegue editar um arquivo. É uma resposta rápida e tipada para uma pergunta de gestão.
Três perguntas surgem em todo board que roda agentes em paralelo, e cada uma corresponde a uma primitiva do Jev.
Qual Assignee deveria assumir esta Task? Um Choice entre seus Agents, com criteria descrevendo no que cada um é bom. O estado é o título, a descrição e o repositório vinculado da Task. Esse é o passo de triagem que descrevemos em gestão de backlog com IA e triagem, feito como uma única chamada de 100ms em vez de uma pessoa lendo quarenta tickets.
Esta execução precisa de uma pessoa antes de ser mesclada? Um Noul sobre o resumo do diff da execução, os resultados dos testes e os caminhos tocados. Acima de 0.85, segure para revisão; abaixo de 0.15, deixe o gate de aprovação passar; no meio, sinalize. O objetivo não é remover o revisor. É garantir que a tarde do revisor seja dedicada às execuções que realmente precisam dele.
Quão arriscada é esta mudança? Um Score de “cosmético” a “mexe em autenticação ou pagamentos”, aplicado ao mesmo estado. Esse número ordena a fila de revisão, que é a maior parte da finalidade de acompanhar o trabalho concluído por agentes de codificação.
A comunidade chegou lá primeiro. Na semana após o lançamento, desenvolvedores publicaram um fluxo de revisão de código em etapas construído sobre o Jev, um plugin do Claude Code que substitui resumos de compactação por decisões do Jev sobre quais chamadas de ferramenta manter, e um “software factory foreman” que roteia trabalho com ele. Todos eles são uma camada de decisão acima de um agente, que é o padrão que importa.
Uma regra de decisão honesta
Use o Jev quando a pergunta tem um conjunto fixo de respostas e você precisa de uma probabilidade junto: roteamento, gravidade, “precisa de revisão”, “está travado”, “a descrição deste PR é honesta”. Essas são as perguntas que um board faz cem vezes por dia.
Não use o Jev quando a pergunta exige um julgamento que não está no estado. “Esta é a arquitetura certa?” não é um Choice. “O cliente vai aceitar isto?” não é um Score. Uma probabilidade nesses casos é um número que parece uma decisão. Mantenha uma pessoa, ou um modelo de linguagem capaz de explicar seu raciocínio, desse lado da linha.
E não deixe uma probabilidade substituir o gate de revisão. Um 0.96 em “seguro para mesclar” é um sinal forte para colocar a execução no topo da fila de uma pessoa, não um motivo para dispensá-la. A fronteira que a Sharkly traça é que a automação para onde o julgamento da equipe é necessário, e um modelo de decisão não move essa linha. Ele torna a fila do lado humano dela mais curta e melhor ordenada.
Como chamar
Direto: POST https://api.typesafe.ai/v1/systemone com uma chave Bearer de console.typesafe.ai, modelo jev-latest (atualmente jev-1.13.0). Por meio do Vercel AI Gateway: modelo typesafe-ai/jev via experimental_evaluate no AI SDK 7, e observe que a documentação do Gateway diz que a avaliação está disponível apenas por meio do AI SDK, não pelos endpoints compatíveis com OpenAI.
Uma chamada de triagem que responde às três perguntas de uma vez:
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
Preço conforme a página de modelos da TypeSafe: US$ 0,042 por milhão de tokens de entrada, saída não cobrada, 64k tokens por requisição com 32k para o estado, somente texto. A esse preço, a chamada de triagem acima custa uma fração de centavo, o que torna plausível executá-la em cada Task e cada execução.
Como isso se relaciona com a Sharkly
A Sharkly não chama o Jev por você, e não é um modelo de decisão. Ela é a camada compartilhada de tarefas, Computers, contexto e revisão em torno dos agentes que você já opera. O que um modelo como o Jev oferece é uma forma barata e tipada de tomar as decisões de roteamento e revisão que essa camada expõe: qual Assignee, qual fila, quão urgente. Integre-o a uma Automation que cria uma Task e escolhe o Agent, ou execute-o sobre a saída de uma execução concluída antes que o resultado chegue a um revisor. De qualquer forma, a decisão cai em algum lugar onde uma pessoa pode vê-la, que é a parte que precisa se manter verdadeira independentemente do que a probabilidade diga.
Se você opera mais de um agente e a fila de revisão é o que dói, primeiros passos com a Sharkly cobre o board, os Computers e o fluxo de revisão no qual um modelo de decisão se conecta.
FAQ
O Jev é um agente de codificação?
Não. Ele não gera código nem edita um arquivo. Ele responde a perguntas declaradas sobre o estado que você fornece, com uma probabilidade. Os agentes produzem o trabalho; o Jev ajuda a decidir o que fazer com ele.
Ele pode substituir a revisão de código?
Não, e não deveria. Ele pode ordenar a fila de revisão e tirar dela os casos claros. A decisão de mesclar continua com uma pessoa, que é a fronteira da qual todo esse fluxo de trabalho depende.
O que significa calibrado?
Se o Jev diz 0.9, ele deve estar certo em cerca de 90% das vezes nesse tipo de pergunta. Teste isso nas suas próprias execuções antes de confiar em um limite: algumas dezenas de diffs rotulados bastam para ver se o número significa o que diz.
Preciso da Vercel para usá-lo?
Não. A API direta funciona com uma chave Bearer. O Gateway é uma conveniência se você já usa o AI SDK.


