
O scraping gratuito da web para agentes de IA agora roda no seu próprio hardware. O Firecrawl Local é um único binário em Rust que faz scraping, crawl e mapeamento de sites para markdown, se integra ao Claude Code, Codex, Cursor ou Gemini CLI como servidor MCP e responde à API v2 do Firecrawl no localhost. Defina FIRECRAWL_CLOUD=off e nenhuma página, consulta ou URL sai da sua máquina.
Resumo rápido
- Instalação:
cargo install firecrawl-local(Rust mais um compilador C). Nossa compilação levou 5 minutos e 55 segundos e gerou um binário de 19 MB. - Integração:
firecrawl-local initadiciona o servidor MCP a todas as ferramentas de agente compatíveis que encontrar. - Custo: US$ 0 para scrape, crawl, map e batch scrape. Busca, páginas bloqueadas e provedores de dados Alexandria vão para o Firecrawl Cloud, a menos que você desative isso.
- Chave de privacidade:
FIRECRAWL_CLOUD=offmantém tudo local. - Configuração em equipe: instale uma vez por Computer onde seus agentes rodam, e todos os agentes daquele Computer usam o mesmo scraper.
O que é o Firecrawl Local
O Firecrawl Local é um único binário da equipe do Firecrawl que busca páginas da web, limpa o conteúdo em markdown e retorna o mesmo JSON que a API hospedada do Firecrawl. Não precisa de banco de dados, fila ou container. O Firecrawl o anunciou em 18 de novembro de 2026, e o crate no crates.io foi publicado uma semana antes, como versão 0.1.0.
O README descreve três formas de usá-lo: uma CLI, um servidor MCP para agentes e uma cópia local da API v2. O código de limpeza é compilado a partir da mesma fonte que a API hospedada usa, então uma página markdown gerada no seu laptop corresponde ao que a nuvem retornaria para uma página que ambas conseguem acessar.
O post de lançamento do Firecrawl afirma uma primitiva de scrape 37 vezes mais rápida que o Firecrawl auto-hospedado e 230 vezes menos memória, com 11 MB em repouso. Esses são os números do Firecrawl; o README não publica metodologia. Medimos a parte de memória nós mesmos, logo abaixo.
Se você já usa vários agentes de código, este é o primeiro scraper que você pode entregar a todos eles sem cobrança por chamada. O restante deste guia cobre a configuração, a chave de privacidade e como dar a uma equipe inteira de agentes a mesma ferramenta no Sharkly.
Por que os agentes precisam de um scraper local
Um agente que não consegue ler a web trabalha com dados de treinamento desatualizados. Ele chuta uma API que nunca viu ou pede para você colar a documentação no chat.
APIs de scraping hospedadas resolvem isso, mas acrescentam dois custos. Cada página é uma chamada tarifada, então um crawl de um site de documentação com 400 páginas vira uma linha na fatura. E toda URL que seu agente abre passa pelos servidores de outra pessoa, o que importa quando o agente investiga o domínio de um cliente ou uma página de concorrente ainda não lançada.
Um scraper local elimina ambos. As páginas são buscadas na sua própria rede e limpas na sua própria CPU. A contrapartida é que você assume a instalação e os limites que vêm com um laptop.
Instalar o Firecrawl Local
Você precisa de Rust e um compilador C. No macOS, xcode-select --install cobre o compilador; no Debian ou Ubuntu, instale build-essential. Obtenha o Rust em rustup.
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Dois extras são opcionais. O Chrome ou Chromium permite renderizar páginas que precisam de JavaScript; sem um deles, páginas estáticas ainda funcionam e uma página com muito script volta com um aviso. O Node.js 22 ou superior é necessário para o servidor MCP, porque firecrawl-local mcp executa o pacote npm firecrawl-mcp via npx.
Scrape, crawl e map pela CLI
Três comandos cobrem a maior parte do trabalho dos agentes.
# Uma página como markdown
firecrawl-local scrape https://example.com --markdown

# Até 50 páginas, um arquivo markdown para cada
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Toda URL que um site expõe
firecrawl-local map https://firecrawl.dev
Executamos cada um em 19 de novembro de 2026, com a nuvem desativada. Um único scrape de example.com terminou em 1,6 segundos. Um crawl de 10 páginas da própria documentação do Firecrawl levou 4,2 segundos e gravou 144 KB de markdown. O map retornou a lista de URLs da documentação em 3,9 segundos.
| Comando | Flags úteis |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (padrão 100), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| Qualquer comando | --browser auto|never|always |
Uma pegadinha do nosso teste: em uma rede que só acessa a web por meio de proxy, o primeiro scrape falhou com um erro de TLS. Definir HTTPS_PROXY resolveu, então o binário respeita as variáveis de proxy padrão.
Conecte ao seu agente de IA via MCP
O MCP (Model Context Protocol) é a forma padrão pela qual uma ferramenta de agente carrega ferramentas externas. O Firecrawl Local se registra como um servidor MCP.
firecrawl-local init --dry-run   # mostra o que mudaria
firecrawl-local init             # grava as alterações, fazendo backup de cada configuração antes
O dry run no nosso Mac listou cinco destinos: Claude Code em ~/.claude.json, Claude Desktop, Cursor em ~/.cursor/mcp.json, Gemini CLI em ~/.gemini/settings.json e Codex em ~/.codex/config.toml. O Windsurf também é compatível quando instalado. Reinicie cada ferramenta após o init para que ela carregue o servidor. Use --agent cursor para configurar apenas uma ferramenta.
Para adicionar manualmente, registre o binário como um servidor stdio:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
O agente recebe as ferramentas MCP padrão do Firecrawl. Scrape, crawl, map e batch scrape rodam localmente; o restante vai para o Firecrawl Cloud. A flag --public-only é um acréscimo nosso, explicado na seção de segurança abaixo.
Mantenha a nuvem desligada por privacidade
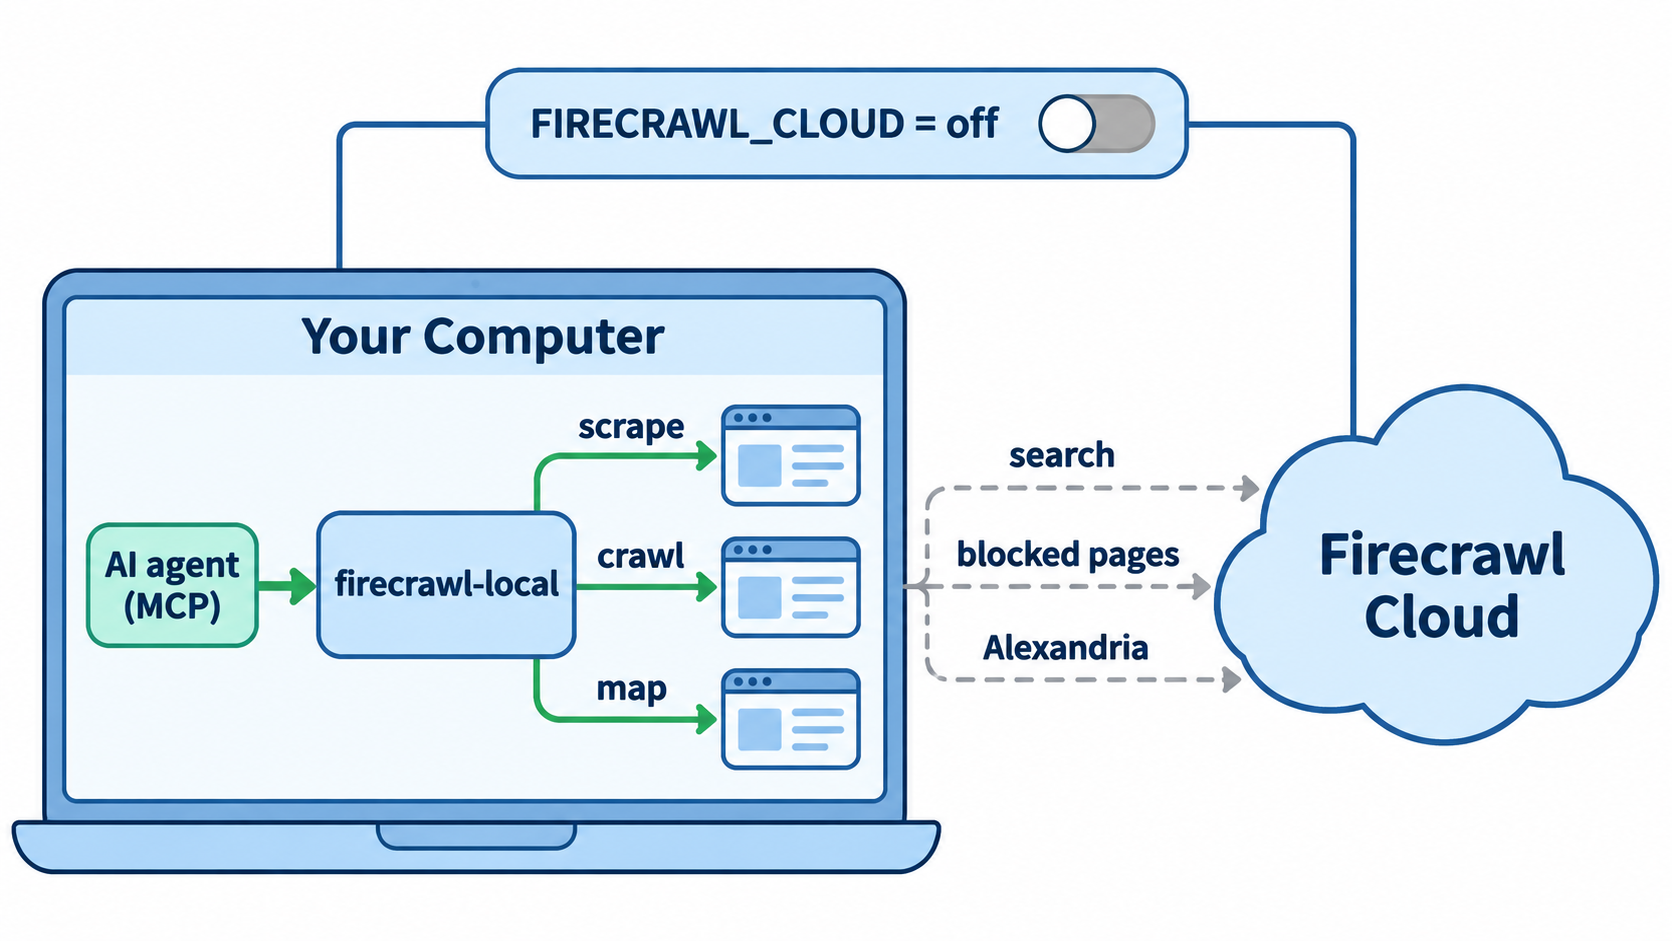
Três tarefas precisam do Firecrawl Cloud, porque um laptop não tem índice de busca nem como contornar um site que o bloqueia.
| Enviado ao Firecrawl Cloud | Por quê | Conta |
|---|---|---|
| Consultas de busca | Não há índice de busca local | Não; busca sem chave tem limite de taxa |
| URL de uma página que bloqueou você | A nuvem a busca por você | Não |
| Provedores de dados Alexandria | Os provedores rodam na nuvem | Sim, uma conta gratuita via firecrawl-local login |
| Um ID de instalação aleatório e o nome da sua ferramenta | Contagem de instalações | Não |
A variável FIRECRAWL_CLOUD controla essa passagem para a nuvem. auto (o padrão) permite tudo o que está acima. search envia apenas consultas de busca. off não envia nada, e um valor não reconhecido também conta como off. Uma página buscada na nuvem vem marcada com "source": "firecrawl-cloud", para você poder auditar o que saiu.
Para trabalho de agentes em sites de clientes ou pesquisas internas, comece com off. Seu agente perde a busca na web, então combine com a ferramenta de busca em que você já confia.
Rode a API do Firecrawl localmente
firecrawl-local serve responde à API v2 do Firecrawl na porta 3002 sem chave de API para rotas locais. Código existente com SDK muda apenas trocando uma URL.
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
As rotas locais são POST /v2/scrape, POST /v2/map, crawl e batch scrape com seus endpoints de status e cancelamento, e GET /health. Outras rotas /v2, como /v2/search, são encaminhadas para a nuvem; v0 e v1 não são atendidas.
Medimos a memória enquanto ele rodava: o processo serve ficou em 10 MB residentes em repouso e 16 MB após um scrape. Isso está próximo da afirmação de 11 MB do Firecrawl. Um scrape pela API retornou "creditsUsed": 0 e "engine": "local-fetch".
Padrões de segurança que importam para agentes
Um agente que lê uma página com instruções ocultas pode ser induzido a buscar uma URL interna. O OWASP classifica esse tipo de ataque como prompt injection, e um scraper é o caminho óbvio para isso.
servevincula-se a127.0.0.1e recusa localhost e endereços privados, a menos que você passe--allow-private. Pedimos para ele fazer scrape de127.0.0.1:22e recebemosBLOCKED_TARGET.- Vincular outro host com
--hostexige--token. - Endereços link-local e de metadados de nuvem são bloqueados em todos os modos, inclusive após redirecionamentos.
scrape,crawlemcppodem acessar sua rede privada por padrão, porque rodam para a pessoa no teclado. Adicione--public-onlyquando um agente navegar por sites em que você não confia.- Crawls leem o
robots.txt(o padrão RFC 9309), e donos de sites podem se dirigir ao crawler comoFirecrawlLocal.
Limitações para planejar
- Sem formatos
jsonousummarye semactionsde navegador localmente. Nossa requisição desummaryretornou metadados mais um aviso de que o formato foi ignorado. - Capturas de tela precisam do Chrome.
- Trabalhos de crawl e batch ficam em memória, expiram uma hora após o início e terminam quando o
servepara. - Licença: o repositório é AGPL-3.0. Consulte seu time jurídico antes de distribuir uma cópia modificada dentro de um produto hospedado.
Para filas, workers e todos os formatos, o guia de auto-hospedagem do Firecrawl cobre o servidor completo.
Dê a todos os agentes da equipe o mesmo scraper
Um desenvolvedor com um agente pode parar por aqui. Uma equipe rodando vários agentes esbarra em outro problema: as ferramentas de cada agente vivem na configuração do computador em que ele roda, e ninguém acompanha qual agente consegue ler a web.
No Sharkly, um Agent roda em um Computer (um laptop, servidor ou container que você conecta) por meio de um Runtime, que é a ferramenta de agente instalada ali, como Claude Code ou Codex. Você instala ferramentas no Computer da mesma forma que faria para uso direto. As configurações Tools, Knowledge & MCP do Agent então listam os servidores MCP que ele herda do Claude Code naquele Computer, incluindo servidores stdio da configuração do usuário, o escopo em que o init grava.
Portanto, a configuração é: instale o Firecrawl Local no Computer, rode init, abra as configurações do Agent e clique em Check. Confirmamos que o painel lista servidores stdio da configuração do usuário; ainda não executamos um scrape do Firecrawl dentro de uma Task do Sharkly, então teste primeiro uma Task somente leitura.
Coloque o scraper em um Computer sempre ligado
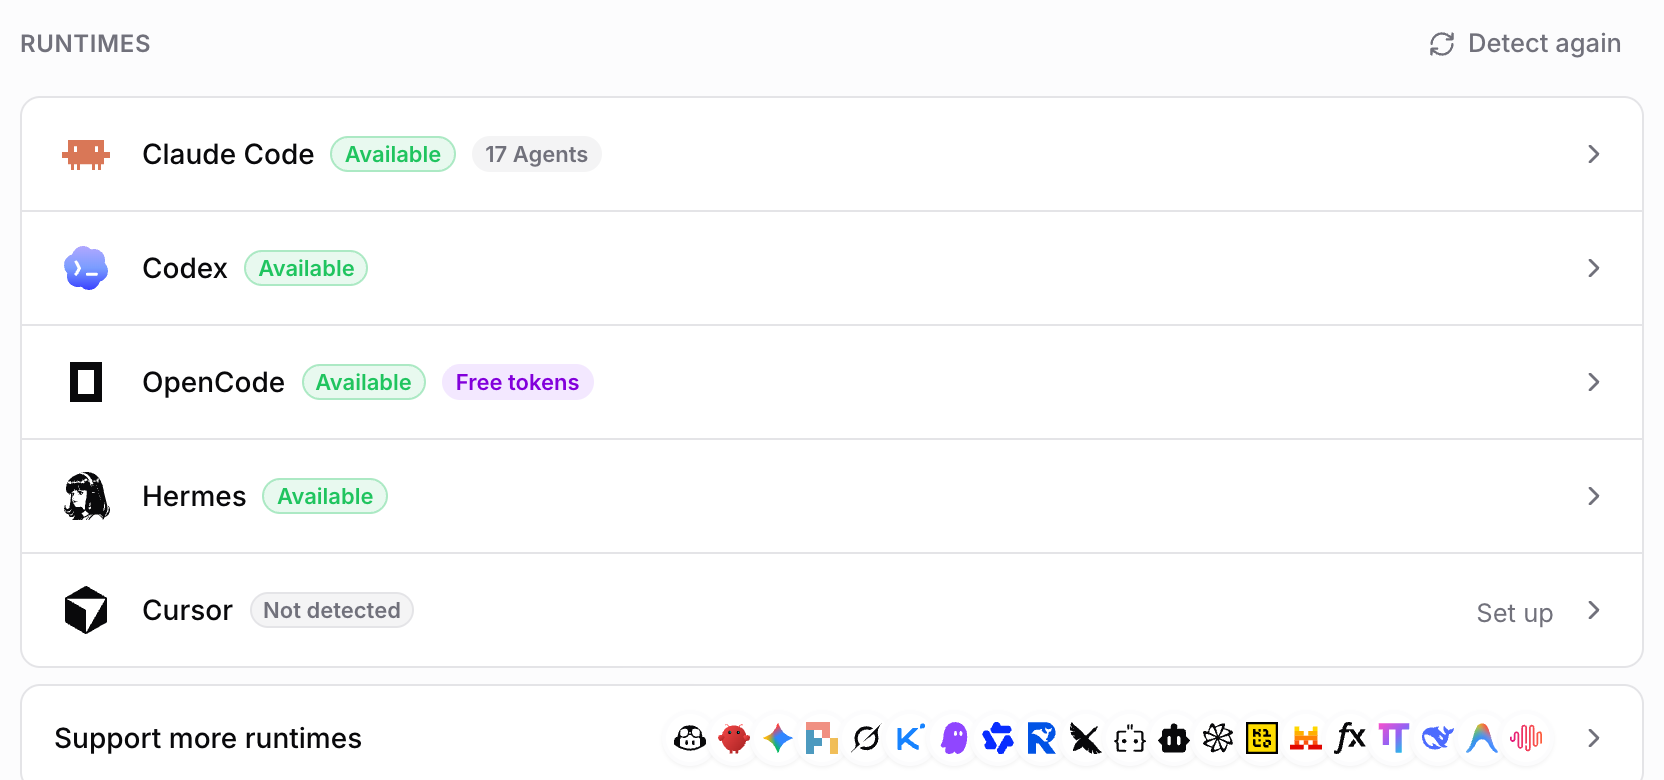
Um laptop dorme. Um pequeno servidor Linux registrado como Computer (sharkly computer register com um token de instalação sit_, conforme a documentação de Computers) fica no ar, então todo Agent apontado para ele compartilha um scraper e uma política FIRECRAWL_CLOUD. Defina a variável no ambiente do Runtime do Agent para que a política viaje com o Agent, não com quem fez login por último.
A partir daí, a pesquisa vira trabalho atribuível. Um líder de Crew divide "mapeie a documentação destes cinco fornecedores" em Tasks, cada Agent faz o crawl da sua parte localmente, e os resultados caem no quadro para revisão humana. O Sharkly é gratuito para organizações de até 5 pessoas hoje, e Agents e Computers não ocupam assentos; os modelos ficam nas suas próprias assinaturas.
Usos no mundo real
- Ingestão de documentação: faça o crawl da documentação de uma biblioteca para markdown antes de um agente atualizar uma dependência.
- Pesquisa de leads: combine scraping local com provedores Alexandria, como no nosso passo a passo de listas de leads.
- Monitoramento de changelog: uma Task agendada mapeia o site de um fornecedor diariamente e sinaliza novas URLs.
- Pesquisa privada: faça scrape de páginas de clientes ou pré-lançamento com a nuvem desligada, para que nada saia da sua rede. Nosso artigo sobre por que desligar a busca na web não impede vazamentos de dados de agentes de IA cobre as outras saídas.
Conclusão
O Firecrawl Local transforma o scraping gratuito da web para agentes de IA em uma compilação de seis minutos e um comando init. Mantenha FIRECRAWL_CLOUD=off para trabalho privado, adicione --public-only para sites não confiáveis e trate as afirmações de velocidade como do Firecrawl até você medi-las.
Seu próximo passo: instale-o no Computer que seus agentes já usam e depois conecte esse Computer ao Sharkly para que todo Agent da equipe tenha o mesmo scraper e as mesmas regras. Para mais configurações a US$ 0, veja agentes de IA gratuitos para equipes.
Perguntas frequentes
O Firecrawl Local é gratuito? Sim. Scrape, crawl, map e batch scrape rodam localmente sem chave de API, e nosso scrape de teste reportou 0 créditos usados. Busca e Alexandria usam o Firecrawl Cloud.
O Firecrawl Local precisa de Docker? Não. É um único binário sem banco de dados, fila ou container. O Docker é apenas uma opção, e a renderização de JavaScript em um container precisa de um perfil seccomp que permita o sandbox do Chrome.
Quais agentes o firecrawl-local init suporta? Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI e Codex. Qualquer outro cliente MCP pode registrar firecrawl-local mcp como um servidor stdio.
Posso manter todo o scraping fora dos servidores do Firecrawl? Sim. Defina FIRECRAWL_CLOUD=off. Você perde a busca, o fallback para páginas bloqueadas e o Alexandria.
O Firecrawl Local é mais rápido que o Firecrawl auto-hospedado? O Firecrawl diz 37 vezes mais rápido e 230 vezes menos memória. Medimos 10 MB de memória em repouso, o que corresponde à afirmação sobre memória; não comparamos a velocidade com a de um servidor auto-hospedado.
O Firecrawl Local é open source? O repositório tem licença AGPL-3.0. Leia a licença antes de distribuir uma cópia modificada como parte de um serviço hospedado.


