
O custo por tarefa do Gemini 4 Neon depende de mais do que seu preço de $3 / $15 por milhão de tokens. Segundo o Google, o Neon no nível de pensamento high padrão custa 32% menos por tarefa que o Gemini 4 Carbon. Por token, o Neon custa 50% mais que a tarifa de lançamento do Carbon e 25% menos que a tarifa do Carbon a partir de 1º de dezembro de 2026. Qual deles é mais barato para seus agentes depende dos tokens por tarefa e de quantas tentativas sua equipe aceita.
TL;DR
- Preço de tabela do Neon: $3 por 1M de tokens de entrada, $15 por 1M de tokens de saída (pensamento incluído), $0,15 por 1M de entrada em cache. Apenas na camada paga.
- Preço de tabela do Carbon: $2 / $10 até 30 de novembro de 2026 e, depois, $4 / $20 a partir de 1º de dezembro.
- Afirmação do Google: 32% menos custo por tarefa que o Carbon em
high, com base em um gráfico do Artificial Analysis Intelligence Index. O post não diz qual preço do Carbon o gráfico usou. - O que isso significa: o Neon só vence o preço de lançamento do Carbon se concluir a mesma tarefa usando menos de dois terços dos tokens do Carbon. A partir de 1º de dezembro, ele vence, a menos que consuma um terço mais tokens que o Carbon.
- O que medir: custo por alteração aceita, não custo por tentativa.
O preço do Gemini 4 Neon ao lado do Carbon e do Hydrogen
O Gemini 4 Neon é o modelo intermediário da família Gemini 4 do Google, lançado em 18 de novembro de 2026 como gemini-4-neon. O model card o descreve como adaptado do Carbon e criado para equilibrar “profundidade e eficiência”. Estas são as tarifas padrão da camada paga por 1M de tokens, segundo a página de preços da API Gemini:
| Modelo | Entrada | Saída (incl. pensamento) | Entrada em cache | Entrada / saída em lote | Camada gratuita |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3.00 | $15.00 | $0.15 | $1.50 / $7.50 | Não |
| Gemini 4 Carbon, até 30 de nov | $2.00 | $10.00 | $0.10 | $1.00 / $5.00 | Não |
| Gemini 4 Carbon, a partir de 1º de dez | $4.00 | $20.00 | $0.20 | $2.00 / $10.00 | Não |
| Gemini 4 Hydrogen (camada paga) | $1.50 | $7.50 | $0.075 | $0.75 / $3.75 | Sim |
Os três usam apenas cacheamento implícito. O guia do AI Studio do Neon diz que o cacheamento implícito entra em ação em prompts de pelo menos 4.096 tokens e dá 95% de desconto na entrada em cache. O Neon não tem cacheamento explícito, então remova quaisquer campos cached_content ao migrar uma configuração do Carbon.
O Google cobra “cada token que o modelo processa, incluindo tokens de pensamento, instruções internas do sistema de grounding e declarações de funções”. Para um agente com uso intensivo de ferramentas, essas declarações acompanham cada turno.
Como o Google mede o custo por tarefa do Neon
O custo por tarefa é o gasto total para um modelo concluir uma tarefa de benchmark: os tokens que ele usou multiplicados pelo seu preço. O post de lançamento do Google diz que, em high, o Neon “combina uma pontuação alta no Artificial Analysis Intelligence Index com um custo por tarefa 32% menor que o Carbon”. O gráfico está rotulado como “AA Index v5.01 cost per task”.
A Artificial Analysis é uma empresa terceirizada, não o Google. O post traz mais duas afirmações de custo, e nenhuma delas é sobre o Carbon:
- O Neon roda com “custo por tarefa aproximadamente 50% a 80% menor que o dos principais modelos frontier concorrentes”, sem nomear os concorrentes.
- Em
xhigh, o Neon ainda custa “36%+ menos por tarefa que modelos concorrentes em suas configurações máximas”.
O post não publica as contagens de tokens nem o preço do Carbon por trás dos 32%. Essa lacuna importa mais do que de costume, porque o preço do Carbon dobra menos de duas semanas após o lançamento do Neon.
O Gemini 4 Neon é mais barato que o Carbon? Depende da data
Por token, o Neon fica entre os dois preços do Carbon: 1,5 vez a tarifa de lançamento do Carbon e 0,75 vez sua tarifa de dezembro. Logo, os 32% só podem vir do Neon usando menos tokens por tarefa. Analise a afirmação dos dois jeitos:
| Se o gráfico do Google precificou o Carbon em | Tokens implícitos do Neon vs. Carbon | Neon vs. Carbon até 30 de nov | Neon vs. Carbon a partir de 1º de dez |
|---|---|---|---|
| $2 / $10 (lançamento) | cerca de 45% | 32% mais barato | cerca de 66% mais barato |
| $4 / $20 (dezembro) | cerca de 91% | cerca de 36% mais caro | 32% mais barato |
Ambas as linhas assumem que os dois modelos dividem os tokens de entrada e saída na mesma proporção, uma simplificação. De qualquer forma, a partir de 1º de dezembro o Neon é mais barato por tarefa segundo os próprios números do Google. Até 30 de novembro, a resposta depende de um detalhe que o Google não publicou.
Quanto custa uma tarefa de agente no preço de tabela
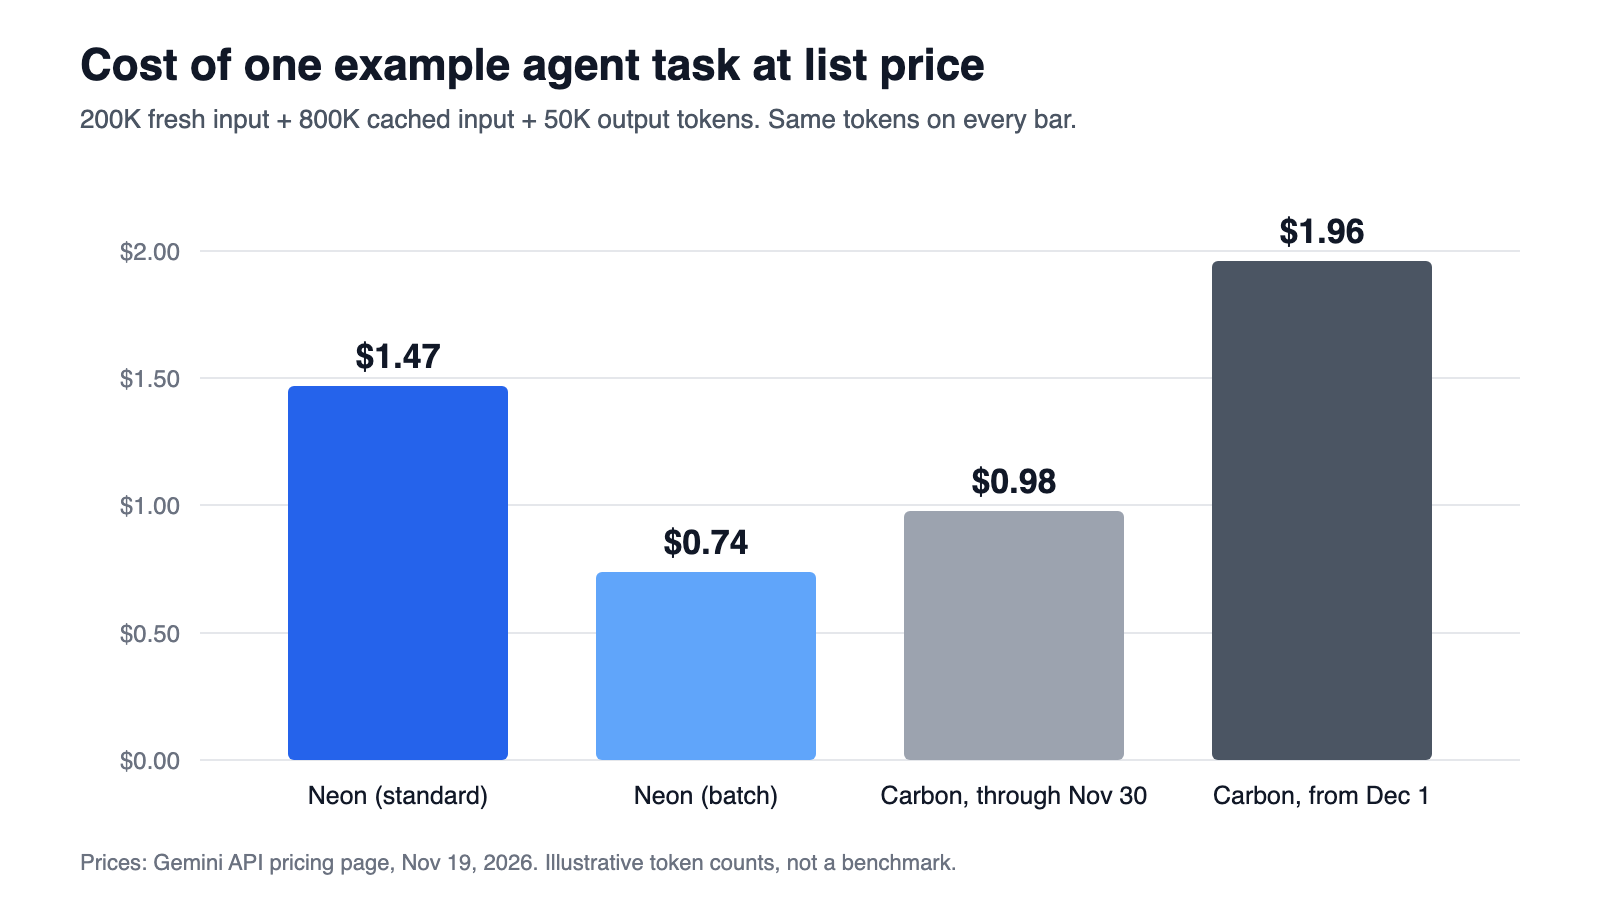
Aqui está um exemplo prático com números redondos, não um benchmark. Imagine uma sessão de agente de código que envia 200K de tokens de entrada novos, recebe 800K de tokens de acertos de cache ao reler o repositório e produz 50K de tokens de saída, incluindo o pensamento.
| Modelo | Entrada nova | Entrada em cache | Saída | Total |
|---|---|---|---|---|
| Neon (padrão) | $0.60 | $0.12 | $0.75 | $1.47 |
| Neon (lote) | $0.30 | $0.06 | $0.375 | $0.74 |
| Carbon, até 30 de nov | $0.40 | $0.08 | $0.50 | $0.98 |
| Carbon, a partir de 1º de dez | $0.80 | $0.16 | $1.00 | $1.96 |
Com contagens de tokens idênticas, o Neon perde para o preço de lançamento do Carbon e vence seu preço de dezembro. A regra do ponto de equilíbrio é simples: contra o preço de lançamento, o Neon precisa terminar usando menos de 67% dos tokens do Carbon. Contra o preço de dezembro, o Neon continua mais barato, a menos que precise de mais de 133% dos tokens do Carbon.
Neste exemplo, a saída é metade da fatura do Neon, e os tokens de pensamento são cobrados como saída. É por isso que o nível de pensamento que você escolher mexe no custo mais do que o preço de tabela.
Níveis de pensamento: o controle por trás do custo por tarefa do Neon
O Neon oferece quatro níveis de pensamento: low, medium, high (o padrão) e xhigh. O guia do Google é direto quanto ao trade-off: xhigh “aumenta a latência e o uso de tokens”, e você deve “escolher o menor thinking_level que atenda ao seu padrão de qualidade”.
Um roteamento prático para trabalho de agentes fica assim:
low: perguntas sobre o codebase, resumos de diffs, notas de triagem.medium: correções delimitadas em que a suíte de testes é o verdadeiro juiz.high: refatorações, depuração e sessões longas de chamadas de ferramentas. É aqui que se aplica a afirmação dos 32% do Google.xhigh: apenas para tarefas que já falharam na revisão emhigh.
Defina-o por requisição no código:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Find why test_checkout_retry flakes and propose a fix.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
O Neon rejeita o antigo nível minimal com um erro e ignora temperature, top_p e top_k. O Google também recomenda timeouts no cliente de pelo menos 15 minutos para prompts difíceis — o que as execuções longas de agentes atingem primeiro.
Por que o custo por tarefa ainda não é o seu número
Uma tarefa de benchmark termina quando o avaliador dá a nota. A sua termina quando uma pessoa faz o merge da alteração. Retentativas, diffs rejeitados e tempo de revisão ficam entre os dois, e nenhum gráfico de custo por tarefa os mostra.
O número que corresponde ao seu orçamento é o custo por alteração aceita: o gasto total do modelo em uma tarefa, somadas todas as tentativas, dividido pelas alterações que você entregou. Fizemos o argumento completo em quando um modelo mais barato custa mais. Em resumo:
custo por alteração aceita = custo por tentativa / taxa de aceitação
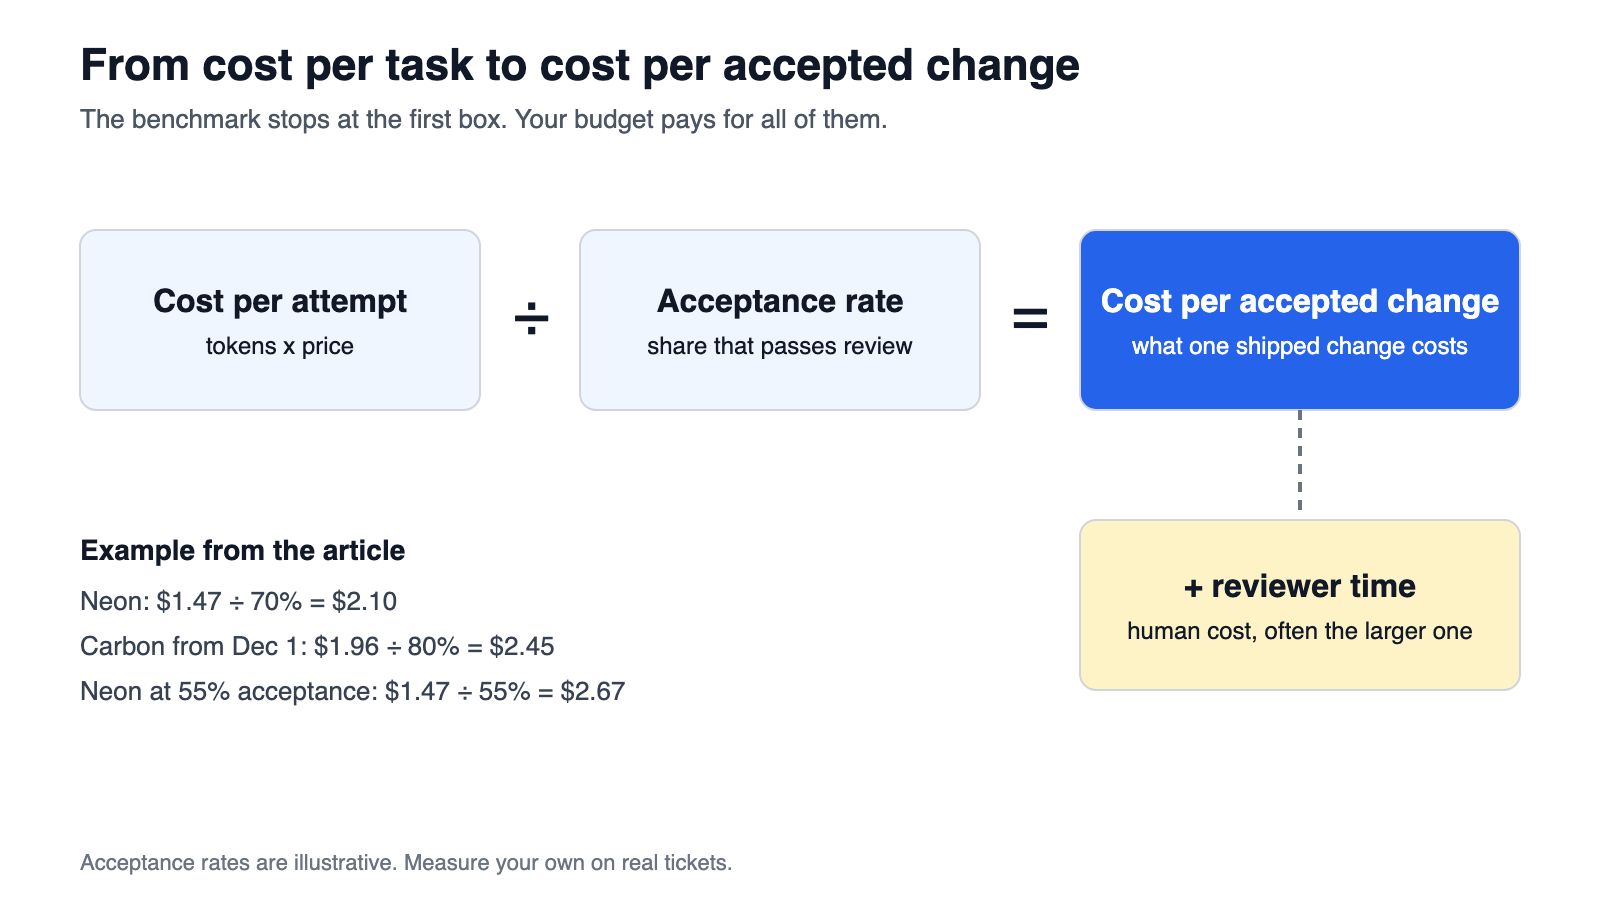
Execute o exemplo de cima. Se o Neon passa na revisão em 70% das primeiras tentativas, $1,47 por tentativa se torna $2,10 por alteração aceita. Se o Carbon no preço de dezembro passa em 80%, $1,96 se torna $2,45. O Neon ainda vence. Mas se a aceitação do Neon cair para 55%, ele custa $2,67 por alteração aceita, e o Carbon vence. Suas taxas de aceitação, não o gráfico do Google, decidem o roteamento.
O tempo do revisor fica fora dessa fórmula e geralmente custa mais que os tokens. A revisão humana é o gargalo para agentes em paralelo, então menos diffs rejeitados economizam a parte mais cara.
Como testar o Neon contra o Carbon nas suas próprias tarefas
Você não precisa de um benchmark novo. Precisa de duas semanas de tickets reais e de uma forma de saber qual modelo fez o quê. A Sharkly te dá esse quadro: cada tarefa guarda a execução do agente, o resultado e o status da revisão em um só lugar.
- Escolha de 20 a 30 tarefas comuns do seu backlog: correções de bugs, pequenas refatorações, adição de testes.
- Crie dois Agents. Um Sharkly Agent segue o modelo padrão do seu Runtime e não tem seletor de modelo, conforme a documentação de Agents. Portanto, aponte cada Agent para um Runtime configurado com um modelo diferente: um em
gemini-4-neone outro emgemini-4-carbon. - Divida as tarefas entre os dois Agents com dificuldade semelhante em cada lado.
- Registre três números por tarefa: tokens pelo seu uso da API Gemini, tentativas até a aceitação e minutos de revisão.
- Calcule o custo por alteração aceita para cada modelo, nos dois preços do Carbon se o seu teste atravessar 1º de dezembro.
A Sharkly não vende tokens de modelo. Suas execuções são cobradas na chave da API Gemini já configurada no Runtime, então a comparação permanece honesta: nada na plataforma desloca o preço em favor de um modelo. Para uma visão mais ampla, veja por que uma plataforma de agentes não deveria vender tokens e acompanhamento de gastos entre Claude Code, Codex e Gemini.
Onde o Neon, o Carbon e o Hydrogen se encaixam
O model card do Google coloca o Carbon em “seus projetos mais difíceis e de longo prazo” e o Hydrogen em “execução rápida do dia a dia”, com o Neon entre eles. Em termos de custo, isso dá a uma equipe de agentes três faixas:
- Hydrogen a $1,50 / $7,50 para trabalho de alto volume e baixo risco. Veja Gemini 4 Hydrogen para agentes de código.
- Neon em
highcomo a faixa padrão para tickets complexos, e como o líder que coordena subagentes Hydrogen em paralelo. - Carbon para o trabalho de longo prazo em que o Neon falha em
xhigh. Nossa análise do Carbon cobre onde ele justifica seu preço.
O guia de pareamento Carbon e Hydrogen mostra um quadro de planejador e trabalhadores; a partir de 1º de dezembro, o Neon assume a cadeira de planejador por menos. Para roteamento entre fornecedores, veja roteamento de modelos para equipes de agentes.
Conclusão
O Gemini 4 Neon é mais barato que o Carbon por tarefa a partir de 1º de dezembro, sob qualquer leitura dos números do Google. Antes dessa data, depende de qual preço do Carbon estava por trás do gráfico dos 32%, e o Google não disse. O preço de tabela nunca foi o número decisivo de qualquer forma: tokens por tarefa, nível de pensamento e taxa de aceitação são.
Execute o teste de duas semanas no seu próprio backlog e precifique os dois modelos por alteração aceita. Se você já roda vários agentes de código, a Sharkly te dá um quadro único para atribuir as tarefas, comparar os resultados dos Agents e manter a revisão em uma só fila. A documentação da Sharkly mostra como conectar um Computer e criar Agents.
FAQ
Quanto custa o Gemini 4 Neon?
$3 por 1M de tokens de entrada, $15 por 1M de tokens de saída incluindo o pensamento, e $0,15 por 1M de tokens de entrada em cache na camada paga da API Gemini. Lote e Flex cortam isso pela metade: $1,50 / $7,50. Não há camada gratuita de API.
O Gemini 4 Neon é mais barato que o Gemini 4 Carbon?
Por token, não até 30 de novembro ($3 / $15 contra $2 / $10) e sim a partir de 1º de dezembro ($3 / $15 contra $4 / $20). Por tarefa, o Google relata que o Neon em high é 32% mais barato que o Carbon, sem publicar qual preço do Carbon usou.
O Gemini 4 Neon tem camada gratuita?
Não. A página de preços lista “Not available” para a camada gratuita do Neon em todos os níveis de serviço. O Gemini 4 Hydrogen tem uma.
Os tokens de pensamento são cobrados no Gemini 4 Neon?
Sim. O Google cobra os tokens de pensamento na tarifa de saída de $15 por 1M, junto com as declarações de funções e as instruções do sistema de grounding. Reduzir o thinking_level é a principal forma de economizar tokens.
Qual nível de pensamento é mais barato para agentes de código?
O low usa menos tokens e o xhigh mais. O Google recomenda testar os quatro no seu conjunto de avaliação e escolher o menor nível que atenda ao seu padrão de qualidade. Comece em high para mudanças de código complexas.
Quando o preço do Gemini 4 Carbon sobe?
Em 1º de dezembro de 2026. A entrada passa de $2 para $4 por 1M de tokens e a saída de $10 para $20, segundo a página de preços da API Gemini.


