

Resumo: o preço do GPT-6.2 é de US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída para o Astra, e US$ 2 e US$ 10 para o Sol. Leitura de entrada em cache custa US$ 0,40 e US$ 0,10. Uma tarefa ilustrativa de agente com 20 turnos custa cerca de US$ 3,23 no Astra e US$ 0,81 no Sol com o cache de prompts funcionando, e quatro vezes isso sem ele.
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol em 17 de novembro de 2026. O Astra é o modelo de fronteira para os trabalhos mais difíceis. O Sol é o modelo do dia a dia, e sua página de modelo diz que ele foi criado para "alimentar agentes em escala".
Um preço por milhão de tokens diz pouco sobre o que uma equipe de agentes vai gastar. Os agentes reenviam seu contexto a cada turno, então a conta depende do cache, do comprimento do contexto e de quantos agentes rodam ao mesmo tempo. Este guia converte a lista de preços do GPT-6.2 em números por tarefa e por mês e, em seguida, mostra os limites que mantêm esses valores previsíveis. Se você já roda agentes de programação lado a lado, o Sharkly é onde você define esses limites por Agente.
Preços do GPT-6.2 para Astra e Sol
Esta é a lista de preços padrão da API extraída da página do modelo Astra e da página do modelo Sol, verificada em 20 de novembro de 2026. Todos os preços são por milhão de tokens.
| Preço por 1 milhão de tokens | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Entrada | $8,00 | $2,00 |
| Entrada em cache (leituras) | $0,40 | $0,10 |
| Gravações em cache (retenção de 30 minutos) | $10,00 | $2,50 |
| Gravações em cache (retenção de 12 horas) | $20,00 | $5,00 |
| Saída | $40,00 | $10,00 |
| Janela de contexto | 1.050.000 | 1.050.000 |
O Sol custa exatamente um quarto do Astra em todas as linhas. Ambos os modelos compartilham a mesma janela de contexto e os mesmos limites de taxa, então o preço é o que os diferencia na conta.
As regras de precificação que mudam o total
Cinco regras nas páginas dos modelos movem a conta de um agente mais do que a taxa principal:
- Sobretaxa de contexto longo. Uma solicitação com mais de 272 mil tokens de entrada paga o dobro na entrada e no cache, e 1,5 vez na saída, sobre toda a solicitação.
- Gravações em cache custam extra. Gravar um prefixo no cache custa 1,25 vez a entrada normal por 30 minutos, ou 2,5 vezes por 12 horas.
- Leituras em cache são baratas. No GPT-6.2, uma leitura em cache custa 0,05 vez a entrada normal, segundo o guia de cache de prompts da OpenAI.
- O Batch custa 50 por cento das tarifas padrão.
- Velocidade custa mais. O modo rápido custa 2 vezes a tarifa padrão. O ultrarrápido custa 3 vezes até 28 de fevereiro de 2027 e 6 vezes a partir de 1º de março de 2027.
O GPT-6.2 não oferece suporte ao Flex processing. Seu substituto é uma janela de conclusão em segundo plano com desconto, abordada abaixo.
Quanto custa uma tarefa de agente no GPT-6.2
Considere uma tarefa ilustrativa de programação: 20 turnos, 60.000 tokens de entrada por turno e 2.000 tokens de saída por turno. Isso dá 1,2 milhão de tokens de entrada e 40.000 tokens de saída para a tarefa inteira. Seus números serão diferentes, então substitua pelos seus.
| Cenário | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Sem acertos de cache | $11,20 | $2,80 |
| 90 por cento de acertos de cache | $3,23 | $0,81 |
| 90 por cento de acertos de cache, janela em segundo plano de 8 horas | $1,94 | $0,49 |
As linhas com cache assumem que 90 por cento da entrada é lida do cache e os outros 10 por cento são cobrados como gravação em cache de 30 minutos. Esse é o caso pessimista, então uma execução real com cache deve ficar em ou abaixo desses números.
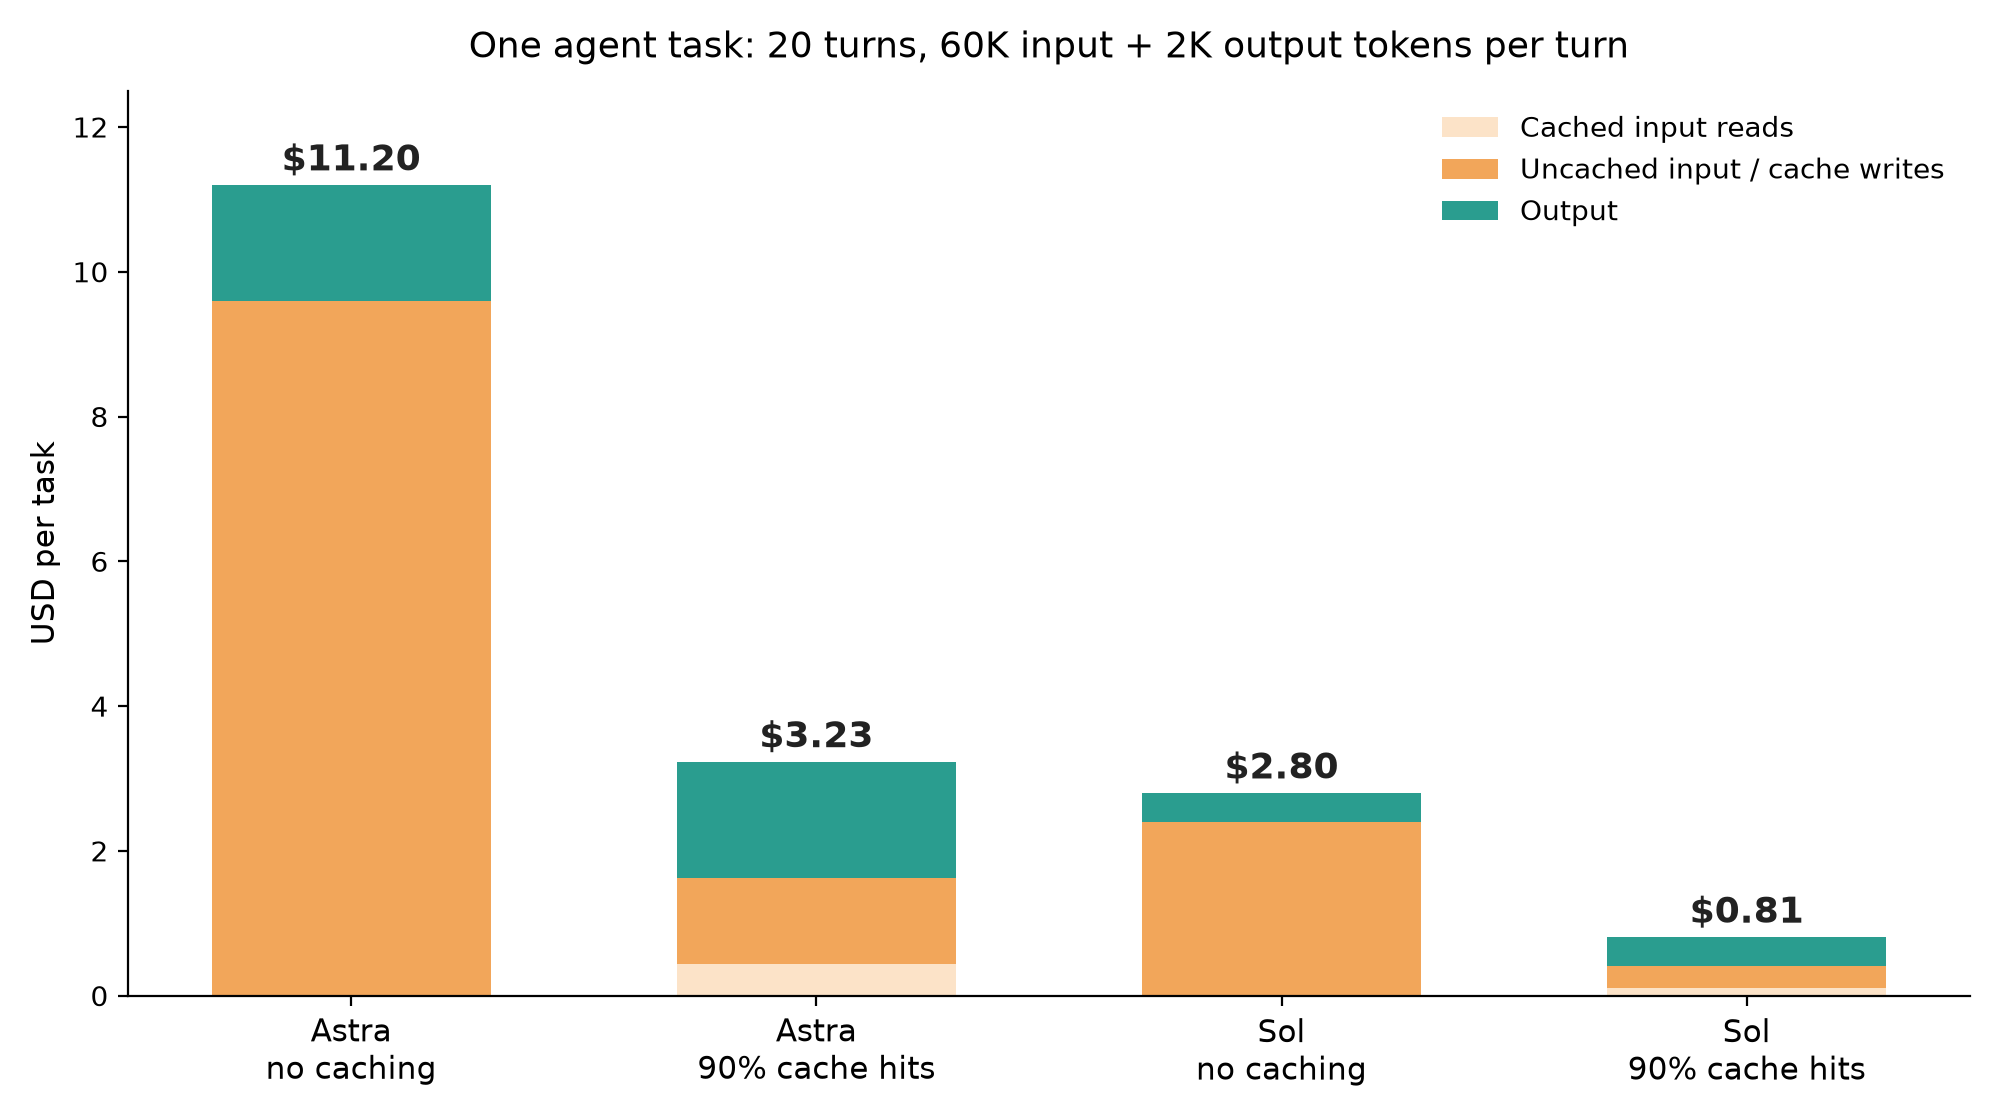
Dois números se destacam. O cache reduz o custo da tarefa em cerca de 71 por cento em ambos os modelos. E uma tarefa no Astra com cache custa apenas um pouco mais do que uma tarefa no Sol sem cache. O modelo barato com um cache quebrado custa quase tanto quanto o modelo caro com um cache funcionando.
Onde a sobretaxa de contexto longo pesa
Agentes de programação que leem metade de um repositório podem ultrapassar 272 mil tokens de entrada por turno. Compare dois turnos do Sol, ambos com 2.000 tokens de saída e sem cache:
- 270.000 tokens de entrada: US$ 0,54 de entrada mais US$ 0,02 de saída, US$ 0,56 no total.
- 300.000 tokens de entrada: US$ 1,20 de entrada mais US$ 0,03 de saída, US$ 1,23 no total.
Um contexto 11 por cento maior custa mais que o dobro. Se o seu harness de agente compacta o contexto, mantenha-o abaixo de 272 mil. A mesma lógica está por trás do nosso artigo sobre por que modelos baratos podem custar mais: o preço por alteração aceita vale mais do que o preço por token.
Custo mensal do GPT-6.2 para uma equipe de agentes
Agora escale os números com cache. Digamos que cinco agentes concluam 8 tarefas por dia durante 22 dias úteis. Isso dá 880 tarefas por mês.
| Configuração da equipe | Tarefas por mês | Custo mensal dos modelos |
|---|---|---|
| Todos os cinco agentes no Astra | 880 | $2.842 |
| Um líder Astra, quatro agentes Sol | 176 + 704 | $1.139 |
| Todos os cinco agentes no Sol | 880 | $713 |
A configuração mista custa 60 por cento menos do que a configuração só com Astra. Ela mantém o modelo de fronteira no planejamento e nas revisões difíceis e envia o trabalho rotineiro para o Sol. Abordamos o papel de líder em GPT-6 Astra como líder da sua Crew, e o mesmo raciocínio orienta o mesmo orçamento, mais agentes com o GPT-6 Sol.
O preço é apenas um limite. Tokens por minuto interrompem uma equipe de agentes antes que o dinheiro acabe nos níveis de uso mais baixos, o que o guia de limites de taxa do GPT-6.2 detalha nível por nível.
Planos Codex versus chaves de API
Se seus agentes rodam o Codex em um plano do ChatGPT, você não paga por token. Você consome uma cota. A página de preços do Codex estima de 6 a 50 mensagens locais por janela de cinco horas para o GPT-6.2 Astra nos planos Plus e Standard Business, e de 17 a 180 para o Sol. Sessões longas drenam a cota mais rápido, então o cálculo de tokens acima ainda prevê quais tarefas esgotarão a cota primeiro.
Nosso guia do GPT-6.2 Codex cobre a configuração de ambos os modelos.
Como reduzir o custo do GPT-6.2 para equipes de agentes
A ordem abaixo move mais dinheiro primeiro:
- Faça o cache funcionar. Coloque instruções estáveis em uma mensagem
developerno início da entrada e nunca reescreva turnos anteriores. Um prefixo alterado é uma falha de cache. - Use o Sol por padrão. Promova uma tarefa ao Astra somente quando ela cruzar serviços ou quando o Sol falhar duas vezes no mesmo tipo de tarefa.
- Fique abaixo de 272 mil tokens de entrada por solicitação.
- Envie trabalho em massa para janelas em segundo plano quando chamar a API pelo seu próprio harness.
- Use o Batch para avaliações e tarefas offline, nunca para um agente interativo.
- Mantenha Fast e Ultrafast desativados a menos que alguém esteja esperando o resultado.
Janelas em segundo plano com desconto substituem o Flex
O guia do modo em segundo plano da OpenAI lista duas janelas de conclusão com desconto para a API Responses, em beta público no GPT-6.2: 2h com 30 por cento abaixo da tarifa padrão e 8h com 40 por cento abaixo. Elas compartilham o limite de taxa do Batch, não o seu limite de tokens ao vivo.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
Consulte o ID da resposta depois ou use um webhook. Isso serve para geração de testes, atualizações de dependências e revisões de documentação que ninguém precisa antes da manhã.
Controle o gasto do GPT-6.2 por Agente no Sharkly
O Sharkly não revende tokens. Cada execução é cobrada no plano Codex ou na chave de API já vinculada ao Runtime, então sua fatura da OpenAI continua sendo a única fonte da verdade. O que o Sharkly oferece é controle sobre quanto trabalho chega a essa fatura.
Cada Agente tem uma linha de Modelo padrão que lista os modelos que seu Runtime reporta. Configure seus Agentes rotineiros com o Sol e seu Agente líder com o Astra. Quando uma tarefa precisar de mais, a documentação do Sharkly descreve uma substituição por tarefa: passe o cursor sobre o Agente no seletor de responsáveis e escolha um modelo apenas para aquela execução.
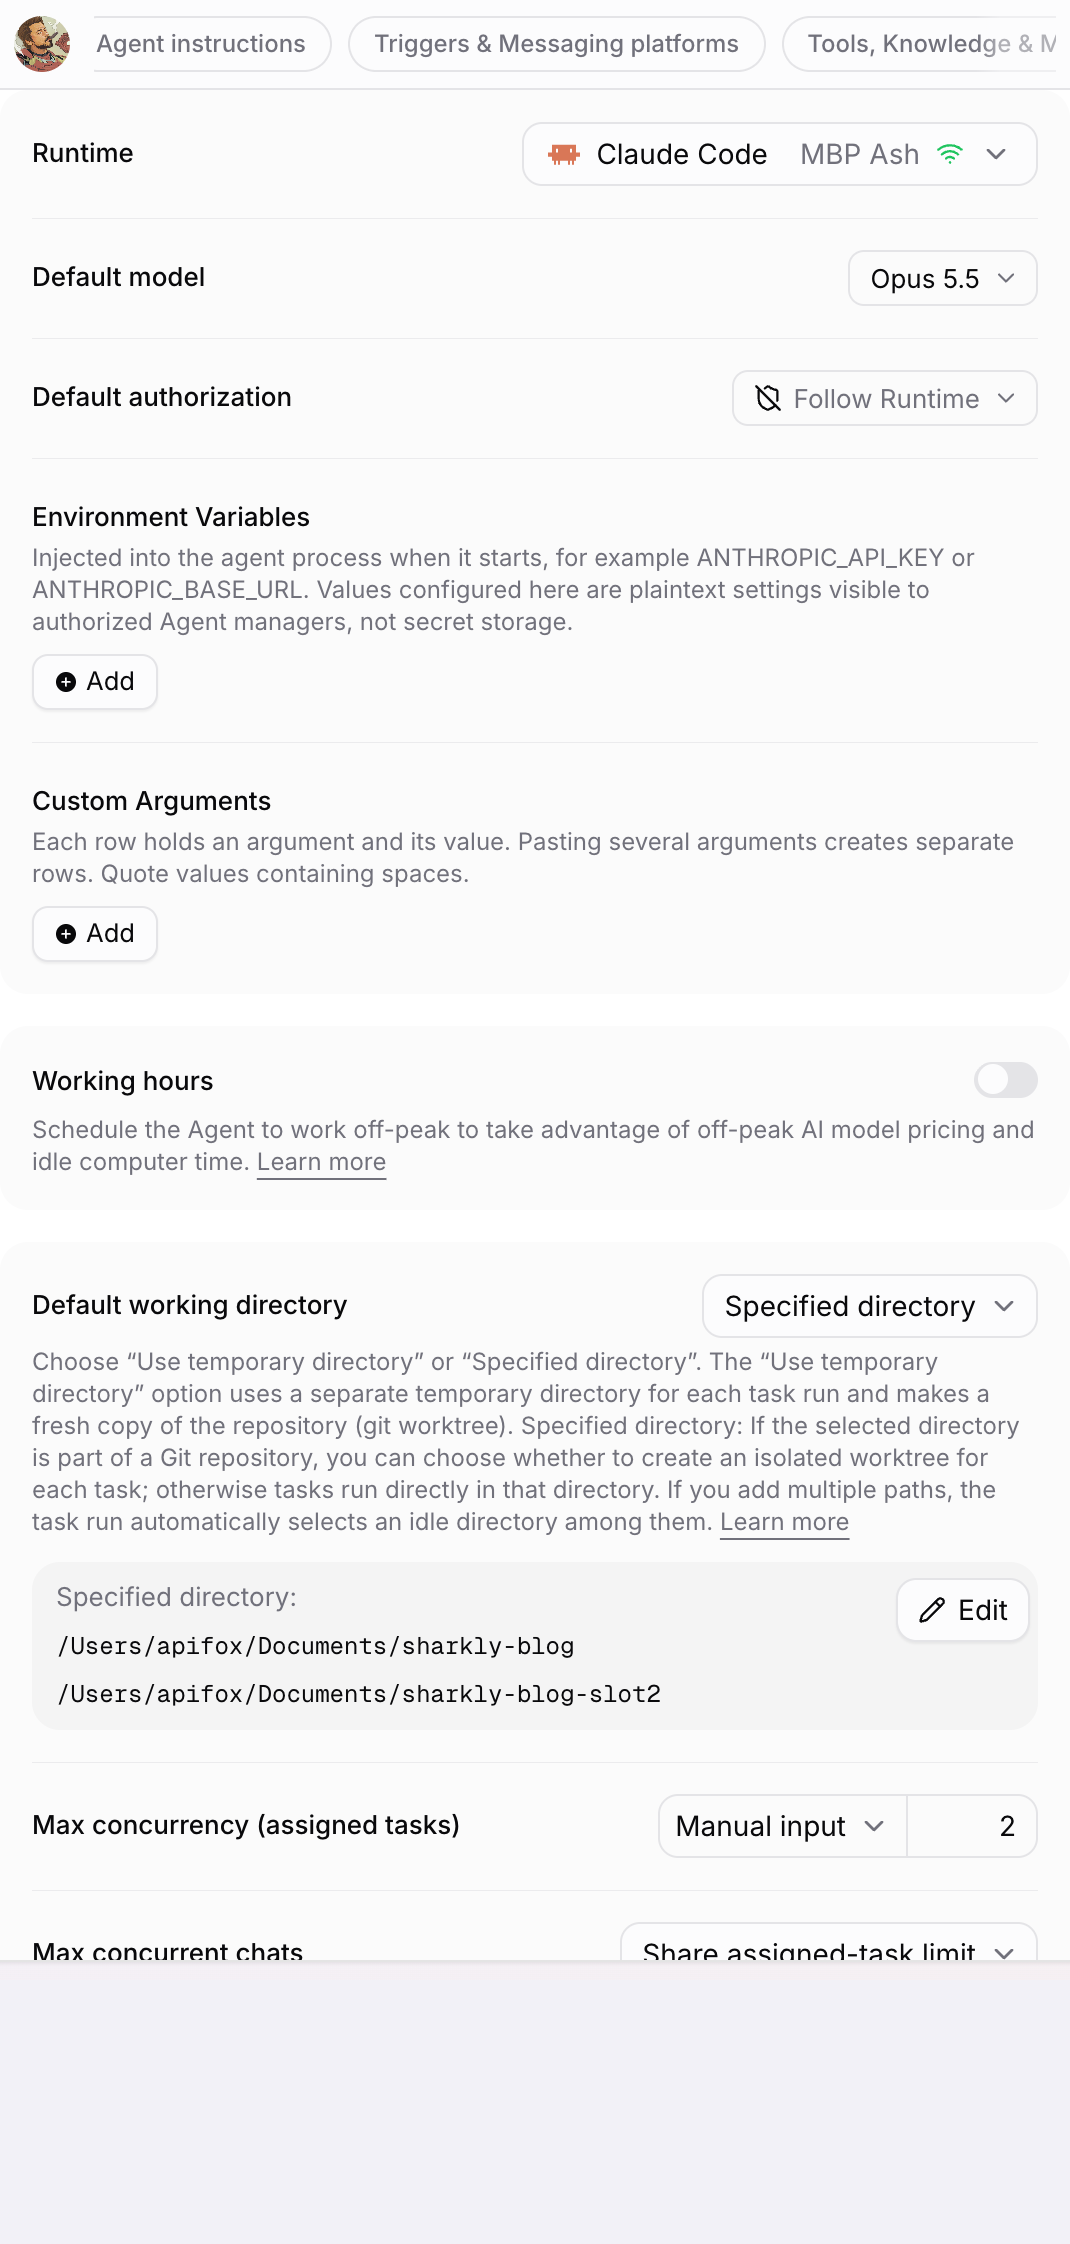
O mesmo painel contém as Variáveis de ambiente, injetadas no processo do agente na inicialização. Dê a cada grupo de Agentes uma chave de API do seu próprio projeto OpenAI, e a página de uso da OpenAI dividirá o gasto por grupo. Os Horários de trabalho agendam um Agente em janelas fora do horário de pico, para que tarefas em massa rodem à noite e deixem a capacidade diurna para as pessoas que estão esperando.
O gasto também precisa de um teto. A Concorrência máxima limita quantas tarefas um Agente executa ao mesmo tempo, a Duração máxima de execução interrompe uma execução que entra em loop, e o Timeout da fila descarta trabalhos que esperaram demais.
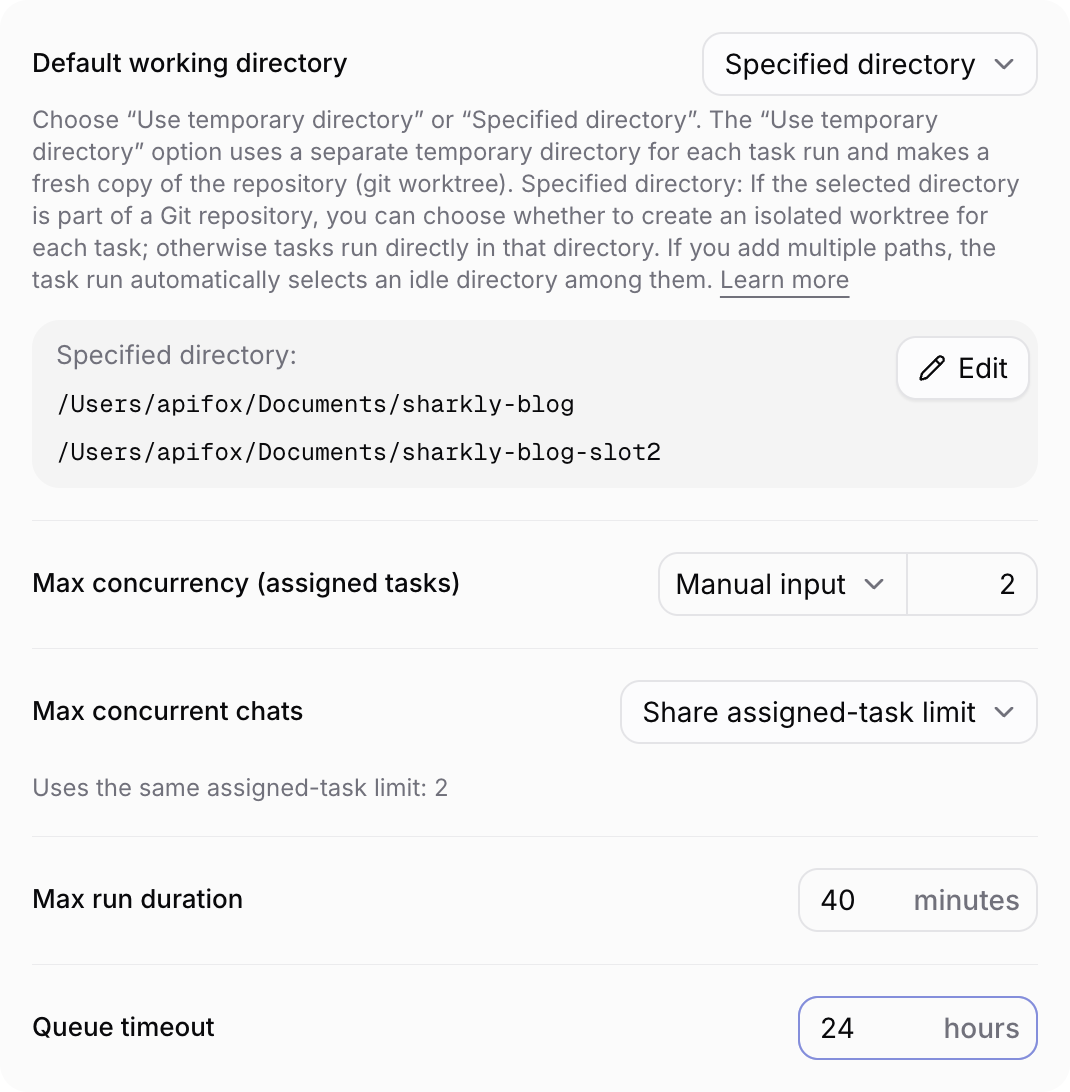
Um limite de 40 minutos por execução em um Agente Sol restringe o pior caso. A lista de execuções de cada Agente mostra os tokens usados em cada execução, para que você possa identificar o tipo de tarefa que consome três vezes mais que as outras. Essa tarefa precisa de uma descrição mais precisa ou de um modelo mais barato.
Conclusão
O preço do GPT-6.2 parece simples: o Astra custa quatro vezes o Sol em todas as linhas. A conta dos agentes não é simples. O cache move o custo de uma tarefa em cerca de 71 por cento, o limite de 272 mil pode dobrar o custo de um turno, e a concorrência multiplica tudo isso. Meça uma tarefa real, aumente sua taxa de acertos de cache, coloque o trabalho rotineiro no Sol e limite o que roda ao mesmo tempo.
Experimente primeiro em um Agente. Conecte um Computer, crie um Agente Codex no GPT-6.2 Sol, defina a Concorrência máxima como 2 e a Duração máxima de execução como 40 minutos e atribua uma tarefa rotineira. Depois leia os tokens da execução. Mais sobre rodar uma equipe lado a lado em como rodar 10 agentes de programação com IA ao mesmo tempo.
Perguntas frequentes
Quanto custa o GPT-6.2?
O GPT-6.2 Astra custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída. O GPT-6.2 Sol custa US$ 2 e US$ 10. Leituras de entrada em cache custam US$ 0,40 no Astra e US$ 0,10 no Sol.
O GPT-6.2 Sol é mais barato que o Astra?
Sim. O Sol custa um quarto do Astra em entrada, saída, leituras em cache e gravações em cache. Ambos compartilham uma janela de contexto de 1.050.000 tokens e os mesmos limites de taxa.
Qual é o preço de contexto longo do GPT-6.2?
Solicitações acima de 272 mil tokens de entrada pagam o dobro na entrada e no cache, e 1,5 vez na saída, sobre toda a solicitação, não apenas os tokens acima do limite.
O GPT-6.2 oferece suporte ao Flex processing?
Não. A OpenAI direciona trabalhos longos para janelas de conclusão em segundo plano com desconto: 2h com 30 por cento de desconto e 8h com 40 por cento de desconto, em beta público.
Quanto custa o Batch do GPT-6.2?
O Batch custa 50 por cento das tarifas padrão em ambos os modelos. Ele serve para avaliações e tarefas offline, não para agentes interativos.
O Sharkly cobra pelos tokens do GPT-6.2?
Não. O Sharkly roda os agentes de programação que você já usa, e o uso dos modelos é cobrado no seu próprio plano Codex ou chave de API. O Sharkly controla qual modelo cada Agente usa e quantas tarefas rodam ao mesmo tempo.


