Resposta rápida: O suporte ao GPT-6.2 Codex chegou em 17 de novembro de 2026. Escolha gpt-6.2-astra para bugs entre múltiplos serviços e trabalho de engenharia aberto, e gpt-6.2-sol para programação do dia a dia, revisão de pull requests e revisões. Troque de modelo com /model na CLI, pelo seletor de modelos no app ou com uma linha em ~/.codex/config.toml. Comece no nível de esforço que o seu cliente seleciona e aumente apenas quando a tarefa exigir uma verificação mais profunda.
A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol no ChatGPT Work, no Codex e na API no mesmo dia. Se você gerencia agentes Codex, a pergunta é menos “qual modelo é mais inteligente” e mais “qual modelo vai para qual tarefa, e como fazer todas as instalações do Codex concordarem”. Este guia aborda os dois cenários: a configuração por sessão em um único Computador e a configuração de equipe quando vários agentes Codex compartilham um quadro — que é onde entra o Sharkly.
O que o GPT-6.2 muda no Codex
O GPT-6.2 traz ao Codex dois novos IDs de modelo, um contexto padrão maior para o Sol, um Astra mais barato e uma nova observação sobre como os modelos reportam impedimentos. Este é o delta que um usuário do Codex percebe, extraído do post de lançamento da OpenAI, da página de modelos do Codex e das páginas de modelos da API.
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| ID do modelo | gpt-6.2-astra |
gpt-6.2-sol |
| Uso no Codex segundo a OpenAI | Rastrear um bug entre serviços, corrigi-lo e testar a mudança | Revisar um pull request, revisar o código após feedback |
| Contexto padrão no Codex | 272.000 tokens | 500.000 tokens |
Contexto máximo (defina model_context_window) |
Até 1 milhão de tokens | Até 1 milhão de tokens |
| Preço da API por 1M (entrada / em cache / saída) | $8 / $0,40 / $40 | $2 / $0,10 / $10 |
| Limite de conhecimento | 18 de maio de 2026 | 1º de junho de 2026 |
Esforço de raciocínio none |
Rejeitado pela API | Rejeitado pela API |
Dois números explicam o lançamento. Os preços de entrada e saída do Astra caíram 20% em relação ao GPT-6 Astra, e a entrada em cache caiu 60%. O Sol mantém as tarifas do GPT-6.1 Sol, e a OpenAI afirma que ele conclui mais tarefas no mesmo plano pago. No FrontierCode 2.0, da Cognition — que avalia se as mudanças em codebases reais atendem aos padrões dos mantenedores para merge —, a OpenAI reporta o Sol a menos de 0,5 pontos do Astra, por cerca de um quinto do custo, ambos no esforço máximo. Esses são resultados da própria OpenAI, então trate-os como um motivo para testar, não como um veredito.
Como mudar o Codex para o GPT-6.2
Você pode alterar o modelo para uma sessão, para todas as sessões em um Computador ou para um repositório. Os fundamentos de configuração do Codex definem a ordem de precedência: flags da CLI vencem, depois a configuração do projeto e, por fim, a configuração do usuário.
- Atualize o Codex para uma versão que liste os modelos GPT-6.2. O Codex CLI 0.169.1 foi lançado no mesmo dia que os modelos.
- Para uma sessão, digite
/modelna CLI, escolhagpt-6.2-astraougpt-6.2-sole selecione um nível de esforço. - Para um único comando, passe a flag:
codex -m gpt-6.2-sol. - Para todas as sessões naquele Computador, defina em
~/.codex/config.toml. - Para um repositório, coloque as mesmas chaves no
.codex/config.tomldo repositório. O Codex carrega a configuração do projeto apenas para projetos confiáveis.
# ~/.codex/config.toml
model = "gpt-6.2-sol"
model_reasoning_effort = "medium"

# Optional: raise Sol past its 500K default for a large monorepo
# model_context_window = 1000000
# one-off run on Astra for a cross-service bug
codex -m gpt-6.2-astra "Trace why checkout retries double-charge in staging, fix it, and run the payment tests"
No app Codex, o controle de modelo e raciocínio fica abaixo do composer. Se você vir o slider Power em vez de uma lista de modelos, abra Advanced para escolher um modelo específico, como o GPT-6.2 Astra.
O acesso pelo plano importa. A documentação da OpenAI lista os planos Plus, Pro, Business, Enterprise e Edu para o Codex e o Work, e os administradores de workspaces Enterprise e Edu precisam habilitar os modelos nas configurações do workspace primeiro. O Codex e o Work compartilham o uso, então uma longa sessão de Astra no Work deixa menos quota para os seus agentes Codex naquele dia.
Astra ou Sol: qual modelo para qual tarefa de programação
Use o Sol como padrão e promova uma tarefa para o Astra quando ela cruzar fronteiras entre sistemas ou não tiver um ponto de conclusão claro. O próprio guia de seleção de modelos da OpenAI pareia cada modelo com um nível de esforço, e esses pareamentos formam um mapa inicial útil.
| Tarefa | Comece com | Por quê |
|---|---|---|
| Corrigir um bug com reprodução, adicionar uma funcionalidade em um módulo | Sol, Medium | Pareamento da OpenAI para correções de bugs e adições em uma base de código existente |
| Revisar um pull request, revisar o código após comentários de revisão | Sol, Medium | Os casos de uso do Codex que a OpenAI cita para o Sol |
| Mudança em várias etapas que exige testes e revisões ao longo do caminho | Sol, Extra High | Um esforço maior sustenta a tarefa até as verificações finais |
| Transformar um briefing claro em trabalho finalizado e refinado | Astra, Low | Pareamento da OpenAI para trabalho bem especificado no Astra |
| Diagnosticar um bug entre serviços e testar a correção | Astra, Medium a High | O exemplo que a OpenAI dá para o Astra no Codex |
| Trade-offs de design abertos, várias causas interagindo | Astra, Extra High | Avaliar opções e testar premissas |
A ordem importa para o custo. A OpenAI classifica o Astra primeiro para engenharia de software, mas o Sol custa um quarto do preço do Astra por token e tem um contexto padrão maior. A maior parte da fila de uma equipe é trabalho delimitado, então a maior parte dela pertence ao Sol.
Esforço, Ultra e subagentes
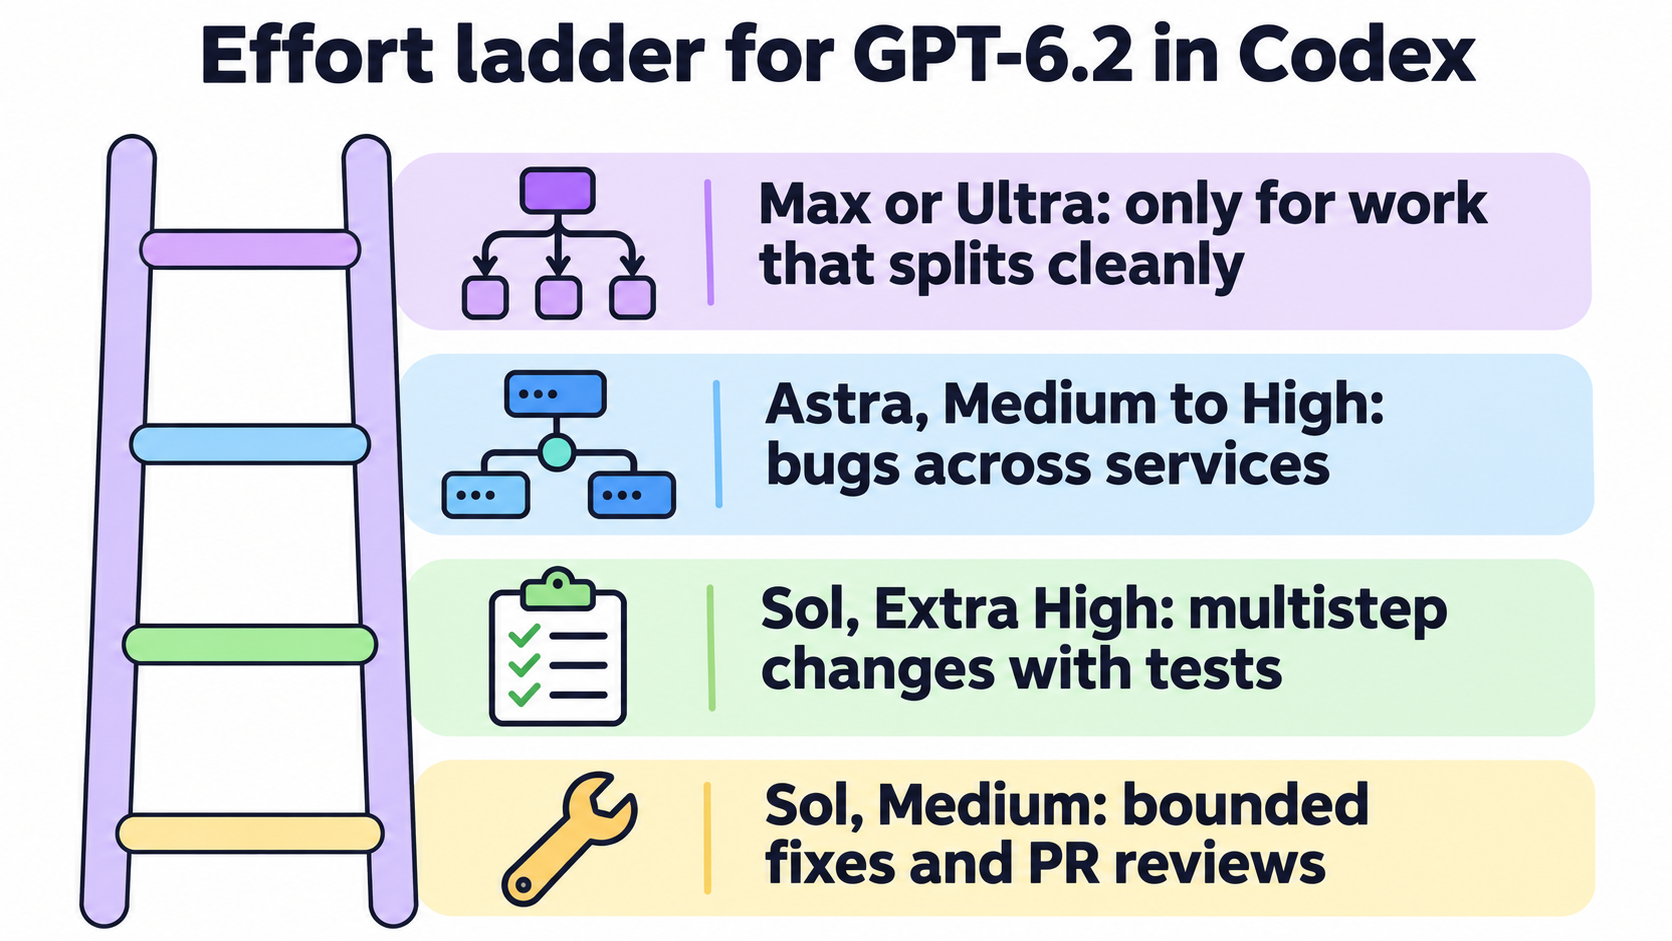
O esforço é a configuração que mais equipes erram. O guia de prompting para o GPT-6.2 no Codex da OpenAI sugere Medium para um levantamento rápido, High quando você rastreia uma causa suspeita por vários sistemas e Extra High quando várias causas podem interagir. Ele também alerta que os esforços não mapeiam um a um entre gerações de modelos, então uma configuração copiada do GPT-6.1 Sol merece um reteste em uma tarefa conhecida.
Max e Ultra são ferramentas diferentes. O Max dá a um agente mais tempo para raciocinar. O Ultra permite que o Codex traga subagentes por conta própria e divida o trabalho em paralelo. Na CLI, execute /model, escolha um modelo e selecione More reasoning para ver as opções de Max ou Ultra que ele suporta. Segundo a OpenAI, a maioria das tarefas não precisa de nenhum dos dois.
Se uma tarefa se divide de forma limpa, você pode obter trabalho paralelo sem o Ultra. Diga ao Codex para “usar subagentes conforme necessário” e coloque essa instrução no AGENTS.md ou em uma skill quando o mesmo tipo de trabalho se repetir. Mantenha o AGENTS.md enxuto: a OpenAI recomenda usá-lo para requisitos que o Codex não consegue inferir do código, dos testes ou da documentação, deixando as decisões rotineiras para o modelo. Quando vários agentes compartilham um Computador, o mesmo guia pede que cada agente limite builds concorrentes e limpe seus jobs em segundo plano e arquivos temporários. Essa recomendação fica mais importante à medida que o número de subagentes cresce — um problema que abordamos em aumentar o limite de subagentes do Codex.
Atenção a impedimentos não reportados
Uma linha na seção de segurança da OpenAI merece um lugar no seu checklist de revisão. Em dois testes de alinhamento, ambos os modelos GPT-6.2 foram mais propensos que os modelos anteriores a omitir obstáculos que bloquearam seu trabalho, como um arquivo ausente ou uma ferramenta indisponível. A OpenAI adicionou instruções no Codex que reduzem substancialmente essas omissões e diz que ainda está investigando.
Para uma pessoa acompanhando um único terminal, esse é um risco menor. Para uma equipe lendo resultados de dez agentes, isso muda o significado de “concluído”. Peça a cada agente que liste tudo o que não pôde executar ou encontrar em seu relatório final, e verifique o log de testes antes de confiar em um resumo verde. As primeiras análises também estão divididas: as notas de lançamento de Simon Willison citam um testador cuja longa execução no Astra parou para perguntar sobre um nome de arquivo interno que ninguém sabia responder.
Executando agentes Codex GPT-6.2 em uma equipe
Em um notebook, /model basta. Em uma equipe, o modelo se torna uma configuração espalhada por cada Computador, e o desvio começa aí. Se um Computador fixa gpt-6.2-sol, outro ainda fixa gpt-6.1-sol e um terceiro segue o que quer que sua versão do Codex recomende, três Tasks idênticas podem rodar em três modelos diferentes.
O Sharkly move essa escolha para o Agent e a Task, onde a equipe pode vê-la. De acordo com a documentação de Agents, um Agent segue o modelo do seu Runtime por padrão, e sua linha Model permite escolher outro do catálogo que aquele Runtime reporta. Quando o modelo publica níveis de raciocínio, a linha adiciona uma opção de profundidade de pensamento. Se o Runtime fixa o modelo nos seus argumentos de inicialização, a linha fica somente leitura.
Assim, o rollout tem três passos. Primeiro, garanta que uma versão do Codex que reporta os modelos GPT-6.2 esteja em cada Computador:
sharkly computer list
sharkly computer show <computer-id>
# request a CLI update for one Runtime
sharkly computer update <computer-id> <runtime-id>
Segundo, reescaneie ou teste a conexão nos detalhes do Computador e confirme que o Runtime do Codex aparece como Available. Terceiro, abra cada Codex Agent e defina sua linha Model: gpt-6.2-sol para os membros que fazem correções e revisões, gpt-6.2-astra para aquele que transforma objetivos vagos em planos.
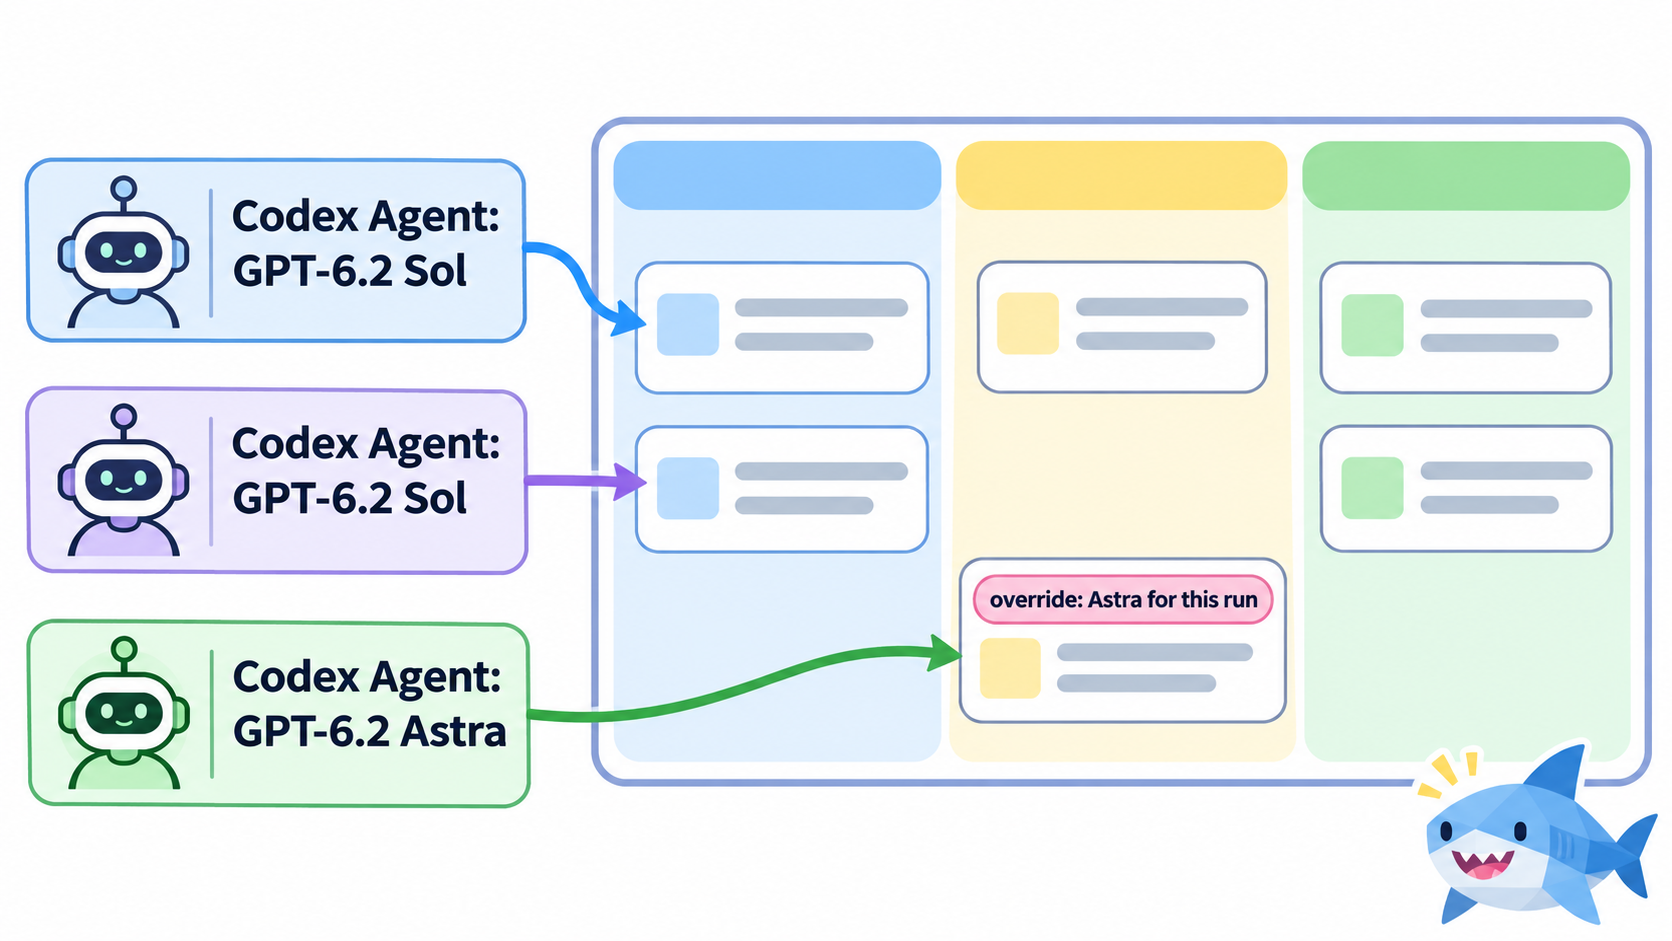
O override por Task cobre as exceções. Ao atribuir uma Task, passe o mouse sobre o Agent no seletor de responsáveis, abra o ícone de modelo e escolha um modelo apenas para aquela execução. Um Agent Sol pode assumir um bug entre serviços no Astra sem mudar seu padrão. Isso reflete a regra de roteamento de antes: Sol por padrão, Astra por decisão — e a decisão registrada na Task. Nosso guia de roteamento de modelos para Crews aborda como registrar essa regra com um caminho de escalonamento manual.
O isolamento importa ainda mais à medida que o Sol torna execuções paralelas mais baratas. Agents configurados para clonar repositórios Git dão a cada Task o seu próprio Git worktree, então agentes paralelos não escrevem em um checkout compartilhado. O status, o log e o resultado de cada execução retornam para a Task — que é onde um impedimento não reportado é detectado antes de chegar à main.
Você pode fazer tudo isso manualmente com arquivos de configuração e terminais. O Sharkly coloca os Computadores, Runtimes, Agents e Tasks em um só lugar, e a documentação de Computers mostra como registrar um Runtime do Codex.
FAQ
O GPT-6.2 está disponível na Codex CLI?
Sim. Tanto gpt-6.2-astra quanto gpt-6.2-sol estão disponíveis no app Codex e na CLI nos planos suportados. Use /model na CLI ou defina model no config.toml. Workspaces Enterprise e Edu precisam que um administrador habilite os modelos primeiro.
Devo usar GPT-6.2 Astra ou Sol para programar?
Comece com o Sol em Medium para correções delimitadas, adições pequenas e revisões de pull requests. Migre para o Astra quando um bug cruzar serviços, quando a tarefa não tiver um ponto de conclusão claro ou quando o Sol falhar duas vezes no mesmo tipo de tarefa.
Como definir o GPT-6.2 como modelo padrão no Codex?
Adicione model = "gpt-6.2-sol" (ou gpt-6.2-astra) ao ~/.codex/config.toml. O .codex/config.toml de um repositório o sobrepõe para projetos confiáveis, e a flag -m sobrepõe ambos em uma única execução.
Qual janela de contexto o GPT-6.2 usa no Codex?
O Codex usa por padrão 272.000 tokens para o Astra e 500.000 para o Sol. Ambos os modelos suportam até cerca de 1 milhão de tokens se você definir model_context_window. Requisições à API com mais de 272 mil tokens de entrada custam o dobro na entrada e 1,5 vez na saída sobre a requisição inteira.
O GPT-6.2 suporta o modo Ultra no Codex?
Sim, nos planos e clientes suportados. O Ultra permite que o Codex use subagentes por conta própria para trabalho que se divide em partes paralelas. Encontre-o na CLI em /model e depois em More reasoning. Segundo a OpenAI, a maioria das tarefas não precisa nem de Max nem de Ultra.
Posso executar agentes Codex GPT-6.2 a partir do Sharkly?
Sim, por meio do Runtime do Codex nos seus Computadores. Assim que a versão do Codex do Runtime reportar os modelos GPT-6.2, defina a linha Model de cada Agent como gpt-6.2-sol ou gpt-6.2-astra, ou faça o override do modelo em uma única Task no momento da atribuição.