Resposta rápida: o código gerado por IA deve ser open source? Não há nenhuma regra legal que diga que precisa ser. O argumento a favor se apoia em dois pontos: os modelos aprenderam a partir de código open source, e código escrito inteiramente por uma IA pode não ter direito a copyright. De qualquer lado que você esteja, sua equipe precisa primeiro da mesma coisa: um registro de qual agente escreveu o quê, a partir de qual tarefa, e quem revisou.
Em 17 de novembro de 2026, um post intitulado “All AI-generated code should be Open Source” estava no topo do Hacker News com mais de 1.200 pontos e 650 comentários. A discussão é barulhenta, mas a pergunta por trás dela é prática. Se seus agentes escrevem uma fatia crescente da sua base de código, quem é o dono desse código, sob qual licença, e quem responde por ele quando algo quebra?
O que diz o argumento de que “o código gerado por IA deve ser open source”
O caso a favor de tornar open source o código gerado por IA é uma reivindicação ética somada a uma jurídica: os modelos foram treinados com código open source e Creative Commons, então fechar a produção deles lava essas licenças, e código sem autor humano pode não ser protegido por copyright de qualquer forma, por isso deveria ser publicado sob uma licença aberta ou CC0.
O post de Jakub Jankiewicz faz quatro argumentos:
- Dados de treinamento. Os modelos aprenderam a partir de décadas de código open source e de respostas do Stack Overflow, que têm licenças Creative Commons que exigem atribuição. Transformar isso em código fechado “parece lavagem de licença”, nas palavras dele.
- Autoria. Código puramente gerado por IA não tem autor humano, então não deveria ser protegido por copyright. Ele cita a disputa da selfie do macaco e a posição do Escritório de Copyright dos EUA sobre IA.
- Jurisdição. Alguns países, como o Reino Unido, concedem proteção limitada a obras geradas por computador, então as regras não são uniformes.
- A solução. Desenvolvedores deveriam publicar código gerado por IA sob uma licença open source ou dedicá-lo ao domínio público com CC0, pelo menos nos casos em que humanos fizeram pouco além de escrever prompts.
Esse último ponto é o que mais importa para equipes: ele mira código que ninguém revisou ou alterou, não código que um humano projetou e um agente digitou.
Copyright e código gerado por IA: como está a legislação
A parte jurídica do argumento tem apoio real nos EUA e menos apoio em outros lugares.
Em janeiro de 2025, o Escritório de Copyright dos EUA publicou a Parte 2 de seu relatório sobre IA, sobre a proteção por copyright. Sua posição: copyright exige autoria humana, prompts sozinhos geralmente não dão a uma pessoa controle suficiente sobre a saída, e contribuições humanas como selecionar, organizar ou modificar a saída ainda podem ser protegidas. Em março de 2025, o D.C. Circuit confirmou em Thaler v. Perlmutter que a Copyright Act exige um autor humano.
O Reino Unido segue uma linha diferente. A Seção 9(3) do Copyright, Designs and Patents Act de 1988 trata como autor de uma obra gerada por computador a pessoa que fez os arranjos necessários para sua criação.
Portanto, nos EUA, um arquivo produzido por um agente sem edições humanas significativas pode ter proteção de copyright fraca ou inexistente. Um arquivo que um desenvolvedor reestruturou, cortou e estendeu provavelmente tem. A maioria do código de produção fica em algum ponto entre esses dois extremos, e a linha passa pelo seu processo de revisão.
Os contra-argumentos, lado a lado
As objeções mais fortes na discussão não são “o autor está errado sobre a lei”. Elas tratam do que decorre dela.
| O argumento | O contra-argumento |
|---|---|
| Modelos treinados com open source, então a saída deveria ser aberta | Reivindicações sobre dados de treinamento estão sendo disputadas na Justiça; uma licença na saída não as resolve |
| Código sem copyright deveria ser publicado | Não ter copyright não é o mesmo que estar publicado; nada no relatório do Escritório de Copyright exige que você publique o código |
| Código de baixo esforço não merece proteção | Quase nenhum código de produção é de esforço zero: especificações, revisão, testes e edições são trabalho humano |
| Licenças abertas honram o commons | Um CC0 indiscriminado pode retirar a proteção de contribuições humanas misturadas no mesmo arquivo |
| A regra deveria ser uniforme entre os países | A lei de copyright é nacional; a regra do Reino Unido mencionada acima já difere da dos EUA |
Repare no que ambas as colunas pressupõem. Cada linha depende de saber quanta parte de uma determinada mudança veio de um agente e quanta parte uma pessoa moldou. Você não pode definir uma política de licenças, responder à pergunta de um cliente sobre proveniência ou discutir autoria sem esse registro.
Quem é responsável por código escrito por agentes?
O debate sobre licenças está aberto. A responsabilização, não. Quem fez o merge da mudança é o dono dela, independentemente do que escreveu o primeiro rascunho.
Essa é a ideia central do nosso post sobre propriedade humana do trabalho de agentes. Um bug em código escrito por agente ainda é o seu bug. Um segredo vazado no pull request de um agente ainda é o seu incidente.
Agentes pesquisam, executam, testam e relatam. Pessoas definem a direção, concedem autoridade e aceitam o resultado. O debate sobre open source não muda essa divisão; ele aumenta o custo de perder de vista quem faz o quê.
Proveniência de código gerado por IA: o que registrar
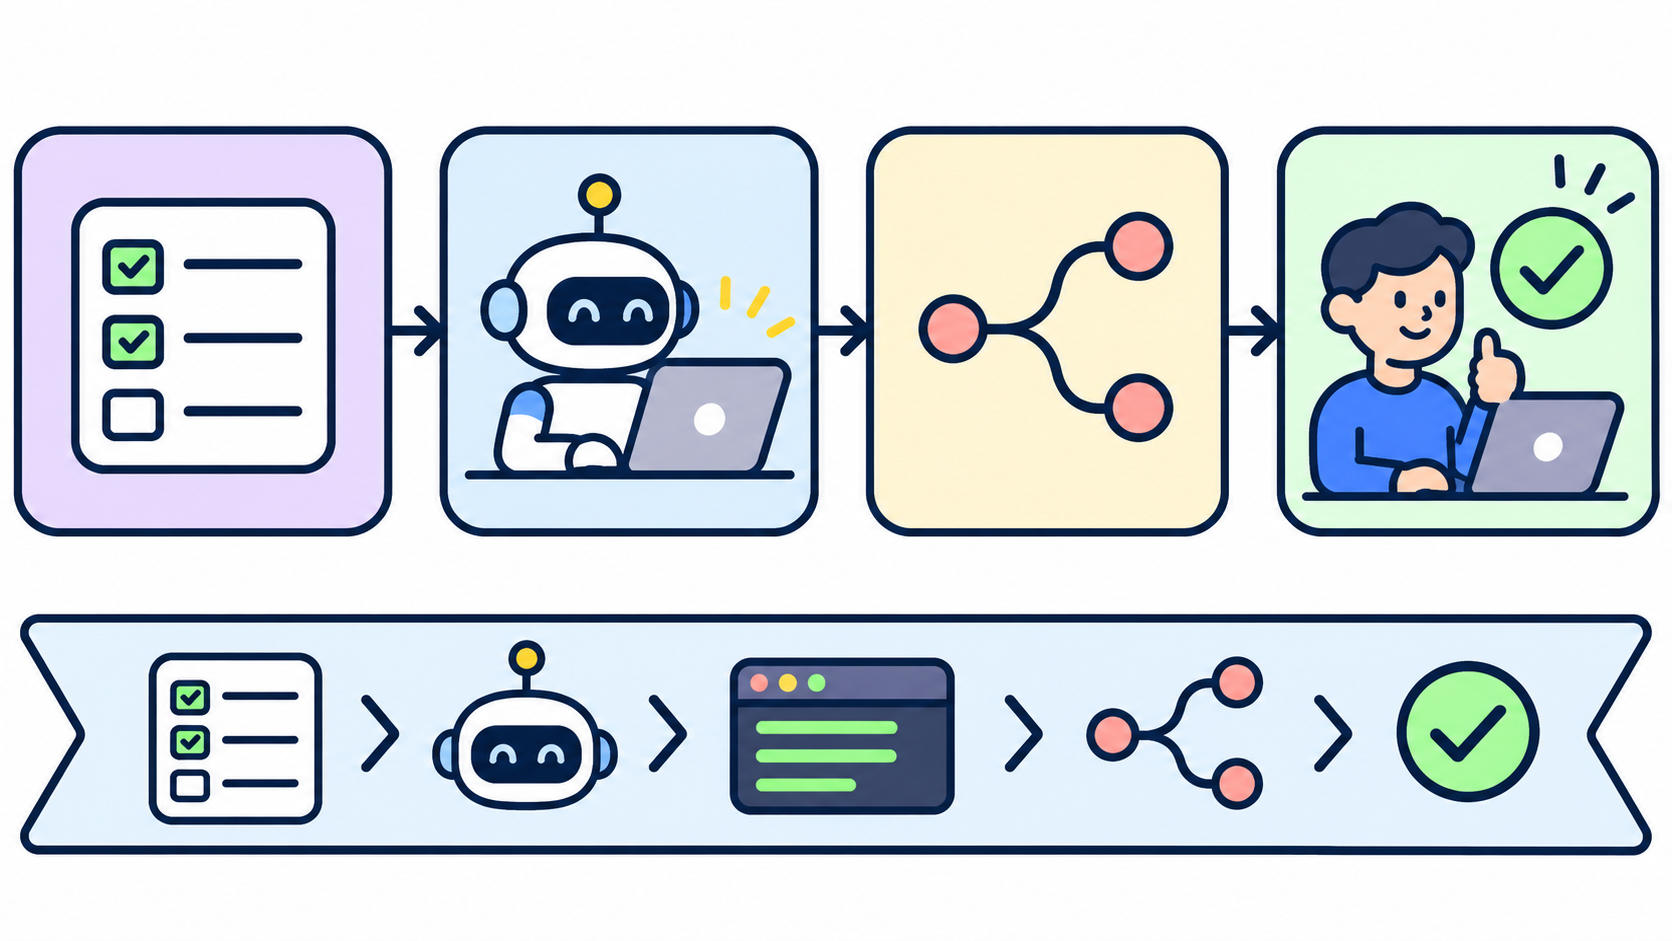
Proveniência é o registro de onde uma mudança veio. Para código escrito por agentes, um registro útil responde a seis perguntas:
- Qual tarefa pediu a mudança, com seu requisito e critérios de aceitação.
- Qual agente fez o trabalho, e em qual runtime e modelo.
- Qual execução o produziu, com horário de início, de término e origem do gatilho.
- Qual pull request o levou ao repositório.
- Quem o revisou, e o que mudou antes de aceitar.
- Qual licença o repositório aplica a esse código.
A maioria das equipes já tem partes disso. O pull request tem o diff e o revisor. O Git pode carregar metadados estruturados por meio de commit trailers. Alguns agentes de código, entre eles o Claude Code, adicionam por padrão um trailer de coautor, e você pode estender essa convenção com suas próprias chaves:
fix(auth): return 401 instead of 500 on expired refresh token

Refresh tokens past their TTL threw an unhandled TokenExpiredError
in the session middleware. Map it to a 401 with a retry hint.

Co-Authored-By: Claude <[email protected]>
Agent-Task: COIN-1287
Agent-Run: 3f9c2a71-0b4e-4c8a-9d51-6e2f4b7a1c09
Reviewed-By: Priya Shah
Human-Edits: renamed handler, added regression test
Os trailers viajam junto com o commit, então sobrevivem a mudanças de repositório. O que eles não conseguem guardar é a execução em si: as chamadas de ferramenta, as tentativas que falharam, a discussão por trás do formato final.
Para rastreamento de licenças no nível de arquivo, identificadores SPDX e as convenções do REUSE dão a cada arquivo um cabeçalho de licença que ferramentas podem verificar. Se sua equipe decidir que alguns ativos gerados serão publicados sob CC0, é aqui que essa decisão se torna verificável.
Como o Sharkly mantém o registro na tarefa
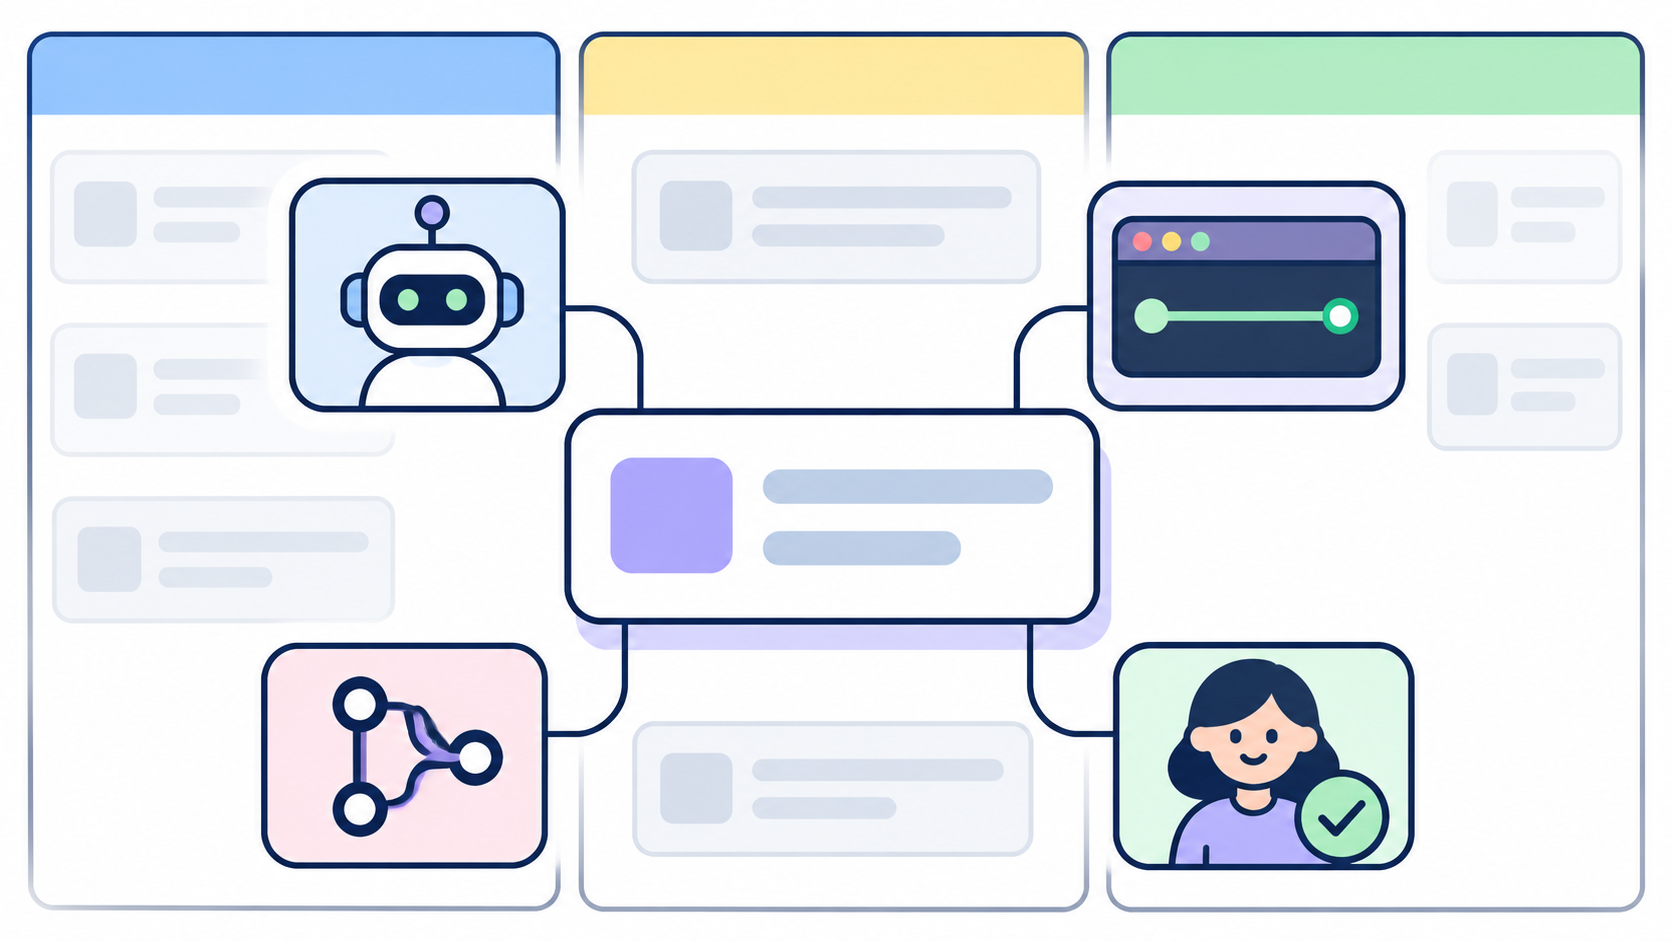
O Sharkly é um sistema de gestão de trabalho para pessoas e agentes de código. Você atribui uma Task a um Agent da mesma forma que a atribui a uma pessoa, e a Task permanece como o registro compartilhado da equipe.
Esse registro é a trilha de proveniência que a maioria das equipes está deixando escapar:
- A Task guarda o requisito, o Assignee, comentários, anexos e uma linha do tempo de Atividade com as mudanças da tarefa.
- O log de execução mostra, por execução, por que ela foi enfileirada, quando começou e terminou, chamadas de ferramenta e eventos de Runtime, a origem do gatilho e quaisquer detalhes de falha, como descrito na documentação de execução de tarefas.
- Comentários do agente destinados à equipe são salvos como Comments vinculados à execução, para que a explicação fique ao lado da evidência.
- Sinais de revisão: um Agent pode deixar uma Task aguardando revisão humana, o que a direciona à pessoa responsável em vez de fazer o merge silenciosamente.
- Links de pull request: a integração com GitHub vincula pull requests e sincroniza issues para dentro de um Space, para que a mudança de código e a tarefa apontem uma para a outra.
O Sharkly não decide sua licença, e não é um produto de compliance. Ele mantém em um só lugar os fatos dos quais uma decisão de licença depende, em vez de deixá-los em sessões privadas de terminal.
Uma política de proveniência que você pode adotar esta semana
Use a menor política possível que responda às seis perguntas acima. Comece aqui:
- Uma tarefa por mudança de agente. Nenhum trabalho de agente sem um ID de tarefa. Conversas ad hoc servem para explorar; tudo que vai para produção recebe uma tarefa.
- Coloque o ID da tarefa no branch e no commit. Um trailer ou um prefixo no nome do branch é suficiente para busca futura.
- Exija um revisor humano identificado. O nome do revisor vai no pull request e na tarefa, e suas edições são registradas.
- Escreva uma linha de licença por repositório. Decida se o código escrito por agentes segue a licença existente do repositório (o padrão para a maioria das equipes) ou outra coisa, e escreva isso no
CONTRIBUTING.md. - Marque os arquivos cuja licença difere. Use cabeçalhos SPDX se escolher CC0 ou outra licença para ativos gerados.
- Guarde os logs de execução pelo mesmo tempo que guarda os pull requests. Se você guardaria o thread de revisão, guarde a execução que produziu o diff.
Para saber mais sobre a mecânica de revisão, veja como revisar código gerado por IA com evidências no nível da tarefa e onde colocar portões de aprovação para agentes de código.
Use uma política leve quando os agentes só mexerem em ferramentas internas e testes. Use os seis passos completos quando código de agentes for entregue a clientes, rodar em ambientes regulados ou chegar a um repositório que você já publica sob uma licença open source.
Sua equipe deveria tornar open source o código escrito por agentes?
Provavelmente não por padrão, e não por causa apenas desta discussão. A lei ainda está mudando, a maior parte da saída de agentes em um fluxo de trabalho com revisão carrega contribuição humana real, e uma liberação indiscriminada sob CC0 pode ceder mais do que você pretendia.
O melhor caminho é tornar a pergunta respondível. Quando um cliente ou seu jurídico perguntar “quanto disso um agente escreveu, e quem verificou”, você abre um registro e mostra a tarefa, a execução, o pull request e o revisor.
Se você já usa Claude Code, Codex ou outro agente de código, conecte um Computer ao Sharkly, atribua uma tarefa de baixo risco a um Agent e veja o que o registro da tarefa mostra quando a execução termina. Esse registro é a sua trilha de proveniência, independentemente de como o debate sobre open source terminar.
FAQ
Código gerado por IA pode ser protegido por copyright?
Nos EUA, código produzido por IA sem contribuição humana significativa provavelmente não é protegido por copyright, segundo o relatório de 2025 do Escritório de Copyright e o caso Thaler v. Perlmutter. A seleção, organização e modificação humanas da saída ainda podem ser protegidas. Outros países, incluindo o Reino Unido, tratam obras geradas por computador de forma diferente.
Preciso tornar open source código que um agente de IA escreveu?
Nenhuma lei exige isso. O post no Hacker News argumenta que você deveria, por razões éticas. Código que não é protegido por copyright não é automaticamente público; você ainda pode mantê-lo privado.
Quem é responsável por bugs em código gerado por IA?
A equipe que fez o merge. Um agente pode escrever a mudança, mas quem aceitou o pull request é o dono do resultado. Registre essa pessoa na tarefa e no pull request.
Como rastrear qual código um agente de IA escreveu?
Vincule cada mudança de agente a uma tarefa, adicione os IDs da tarefa e da execução como commit trailers, vincule o pull request à tarefa e registre o revisor humano. Um quadro de tarefas que guarda o log de execução do agente completa o resto.
O CC0 faz sentido para código gerado por IA?
Pode fazer para ativos gerados claramente separáveis, como fixtures ou código de scaffolding. Aplicar CC0 a arquivos mistos arrisca liberar também as partes escritas por humanos, então marque esses arquivos com cabeçalhos SPDX em vez de relicenciar repositórios inteiros.