
O OpenAI lançou o GPT-6 Luna em 22 de setembro, a US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de saída, com o id de API gpt-6-luna e uma janela de contexto de 1M. Nesse preço, a pergunta interessante deixa de ser se o modelo é bom o suficiente em abstrato. Passa a ser quais faixas do seu board você está disposto a entregar a ele, e como a faixa barata e a faixa cara rodam no mesmo Computer sem que ninguém perca o rastro de qual delas produziu um determinado resultado.
Isso é um problema de configuração antes de ser um problema de modelo. Uma equipe que vincula o Luna em todos os lugares economiza dinheiro e depois o gasta de volta na revisão. Uma equipe que nunca o vincula continua pagando tarifas premium para que um Agent renomeie um arquivo de teste. Este guia segue o caminho útil mais curto: coloque o gpt-6-luna em um Computer, mantenha-o em sua própria faixa, atribua uma Task real, e leia o resultado onde a equipe possa vê-lo.
TL;DR
Vincule o gpt-6-luna como o modelo padrão de um Runtime em um Computer conectado, confirme que esse Runtime aparece como Available no Sharkly, dê a ele um Agent próprio em vez de reutilizar o caro, aumente o timeout por Task antes de confiar em uma execução longa, e mantenha o Luna em trabalhos cujo resultado uma pessoa possa verificar em menos de um minuto. O Sharkly não exibirá o nome do modelo. Ele mostrará a execução, o log, as perguntas e o resultado na Task. Os Agents pesquisam, executam, testam e relatam. As pessoas definem a direção, concedem autoridade e aceitam o resultado.
Onde fica a configuração do modelo
O Sharkly não escolhe modelos. A documentação dos Agents é explícita: “O Agent segue o modelo padrão do Runtime. Ele não promete nem exibe um nome de modelo específico. Altere os modelos na configuração de ferramentas do Runtime ou do Computer, não no Agent.”
Portanto, não há um menu suspenso de modelos em um Agent, nem um controle de profundidade de raciocínio. Quatro papéis, um trabalho cada. O Agent define como o trabalho deve ser conduzido. O Computer fornece o host e os recursos locais. O Runtime executa a sessão real do agent. A Task permanece como o registro compartilhado da equipe. O passo a passo completo dessa configuração está em nosso guia do GPT-6 Sol; este post aborda a parte específica de colocar um modelo barato no board.
Passo 1: vincule o gpt-6-luna ao Computer
No Computer que vai executá-lo, atualize sua ferramenta de agent e faça login com uma conta ou chave de API que tenha acesso ao Luna. O OpenAI disponibilizou o Luna no ChatGPT Work e no Codex para os planos Plus, Pro, Business, Enterprise e Edu, deu aos usuários Free e Go o Luna no aplicativo de desktop, e ainda não o colocou no Chat. Se codex -m gpt-6-luna inicia uma sessão em um terminal simples nesse host, o Sharkly pode usá-lo.
Em seguida, defina o padrão para que as execuções nesse Runtime o adotem:
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
Duas ressalvas sobre esse trecho. O nome da chave de esforço de raciocínio varia entre versões do Codex, então verifique-o em relação à configuração de exemplo da build instalada nesse Computer. E high está ali de propósito, e não como padrão: todo resultado publicado do Luna abaixo é medido em esforço alto ou máximo, não na configuração que você escolheria para tornar um modelo barato ainda mais barato. [VERIFY]
De volta ao Sharkly, abra o detalhe do Computer e execute o rescan ou o teste de conexão. O Runtime deve aparecer como Available. Um Computer exibido apenas como online significa somente que seu serviço local está enviando heartbeats. O status de capacidade do Runtime é o que indica que uma execução pode começar.
Passo 2: mantenha a faixa barata visivelmente separada
Um Computer pode expor um ou mais Runtimes, cada um relatando seu próprio estado de conexão, e um Runtime ACP personalizado pode ser adicionado a partir do detalhe do Computer, com seu próprio nome e comando de inicialização. Essa é a alavanca que vale a pena usar aqui. Dê à faixa do Luna sua própria entrada de Runtime e seu próprio Agent, nomeados pela faixa e não pelo modelo, e o board mostrará em qual faixa uma Task foi executada sem que ninguém precise ler um log de execução.
Isso não é cosmético. O Sharkly não consegue ler de forma confiável o modelo que um Runtime está de fato usando, e é exatamente por isso que os Agents seguem o padrão do Runtime e não exibem nenhum nome de modelo. Se um Agent muda silenciosamente de modelo entre terça e quinta porque alguém editou um arquivo de configuração, duas execuções que parecem idênticas na Task não eram. Uma faixa por nível de custo torna isso visível no único lugar onde a equipe já olha. Consulte Computers no Sharkly para saber como os Runtimes são detectados e testados.
Um par de decisão, já que duas faixas custam algo para manter. Divida o Runtime quando mais de uma pessoa atribui trabalho nesse Computer e a diferença entre uma execução de US$ 0,10 e uma de US$ 10 importa para alguém. Não divida quando um único engenheiro executa um punhado de Tasks por semana; um único Runtime e uma decisão por Task é menos coisa para manter em ordem, e o isolamento por worktree já impede que as execuções colidam.
Passo 3: dimensione a execução para um modelo que começa devagar
Barato não é o mesmo que rápido, e essa é a configuração que as pessoas erram primeiro. A Artificial Analysis, um terceiro em vez de qualquer um dos fornecedores, mediu 153,9 tokens de saída por segundo para a variante de raciocínio máximo do GPT-6 Luna, com 124,23 segundos até o primeiro token. Isso é mais do que a maioria das pessoas espera antes de supor que um processo travou.
Portanto, defina o timeout por Task de forma deliberada, e mantenha o diretório de trabalho no modo Temporary para que cada Task receba um diretório isolado e um worktree novo. Duas execuções do Luna no mesmo repositório então não podem escrever uma sobre a outra, e uma execução que está pensando parece diferente de uma execução que morreu, porque a Task carrega um status e um scrollback de terminal não.
Onde um Runtime barato se encaixa em uma Crew
Uma Crew é um grupo reutilizável de People e Agents coordenado por um Agent líder. A regra de posicionamento que decorre dos próprios números da OpenAI é que o Luna pertence aos membros, e não ao topo.
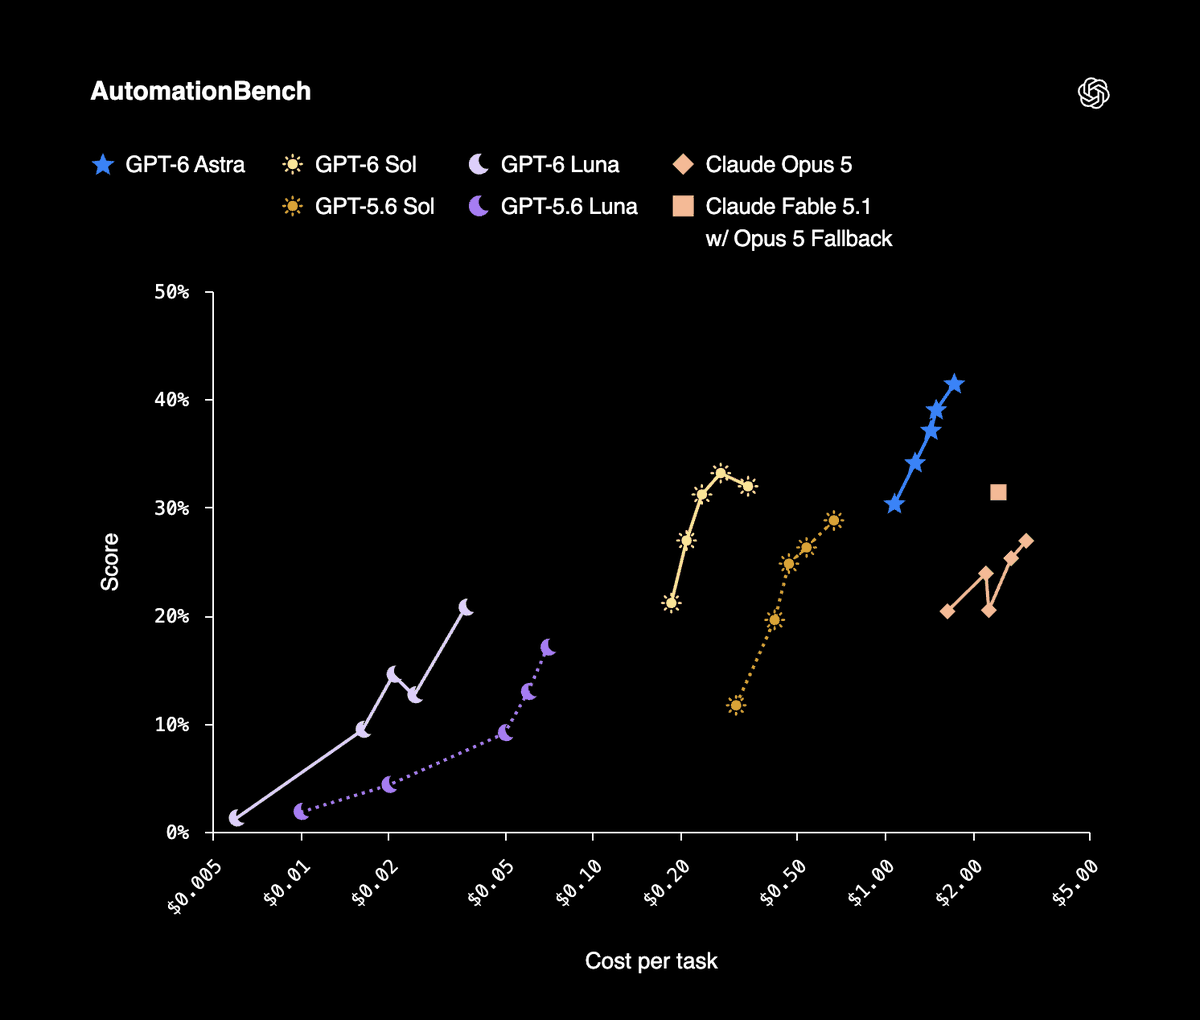
O caso dos membros é forte. No DeepSWE 1.1, a OpenAI reporta o Luna em esforço máximo com 66,6%, comparável ao Claude Opus 5 e ao Fable 5 em esforço médio, com 93% menos custo por tarefa que o Opus 5 e 96% menos que o Fable 5. No OSWorld 2.0 offline, o Luna no máximo supera o GPT-5.6 Sol no médio por um décimo do custo. No AutomationBench 1.0.6, o Luna no alto pontua 5,4 pontos percentuais acima de seu antecessor, com 58% menos custo por tarefa, e em factualidade, o Luna em esforço maior iguala o GPT-5.6 Sol por cerca de um centésimo do custo. A OpenAI também descreve o Sol e o Luna como 50% mais baratos que o preço promocional do GPT-5.6, e essa ressalva é da própria OpenAI: a base de comparação é uma tarifa promocional, e não uma tarifa de tabela.
O caso do líder é fraco, e não por causa de qualquer benchmark. Um líder interpreta o objetivo, decide o que os membros fazem e reúne seus resultados em uma única Task. Um erro de interpretação no topo não é uma execução ruim, são as execuções de todos os membros apontadas para a coisa errada, e a economia nos tokens do líder é erro de arredondamento diante disso. Nosso guia do líder de Crew faz o mesmo argumento no outro extremo da lista de preços.
| Trabalho | Faixa | Por quê |
|---|---|---|
| Triagem, rotulagem, organização do backlog | Luna | Alto volume, e uma pessoa pode conferir o veredito em segundos |
| Estruturação de testes, notas de revisão de primeira passada | Luna em esforço alto | Os ganhos publicados são em alto ou máximo, não em uma configuração menor |
| Alterações em código que vai para produção | GPT-6 Sol a US$ 2 / US$ 10 | AutomationBench 33,2% a US$ 0,27 por tarefa |
| Interpretar um objetivo ambíguo para uma Crew | GPT-6 Sol, ou Astra a US$ 10 / US$ 50 | Um erro do líder se multiplica por todos os membros |
Escreva isso como regra, e não como hábito. Qual modelo para qual tarefa de programação cobre a questão de roteamento por completo.
Uma ressalva sobre a leitura das margens da OpenAI: seu post de lançamento faz benchmarks contra o Claude Opus 5, e a Anthropic substituiu o Opus 5 pelo Opus 5.5 horas depois, no mesmo dia. As comparações do Luna acima são medidas contra a geração anterior do modelo que elas nomeiam.
O que um Runtime barato não torna mais barato
O Luna reduz o preço de produzir uma mudança. Ele não faz nada pelo preço de aceitar uma. Dez execuções baratas produzem dez diffs, dez conjuntos de saída de teste e dez decisões que só uma pessoa pode tomar, e os próprios números de gasto da OpenAI são um alerta, e não uma garantia: ela reporta um pesquisador mediano acima de US$ 600 por dia em agents de programação, com o percentil 90 em US$ 7.000. Mais barato por tarefa é como uma conta dessas se constrói.
A versão honesta do argumento, então. Vale a pena vincular um Runtime barato quando o trabalho que ele assume é um trabalho que uma pessoa pode verificar rapidamente, e é uma falsa economia quando ele multiplica a fila diante do seu revisor. Mantenha contexto, progresso, bloqueios, resultados e revisão humana visíveis desde a solicitação até o release, e decida a faixa no momento da atribuição, e não no momento da revisão. A revisão humana é o gargalo tem o lado de agendamento disso.
Se você já está executando vários agents de programação, conecte um Computer, crie um Agent na faixa barata e atribua a ele algo entediante.


