
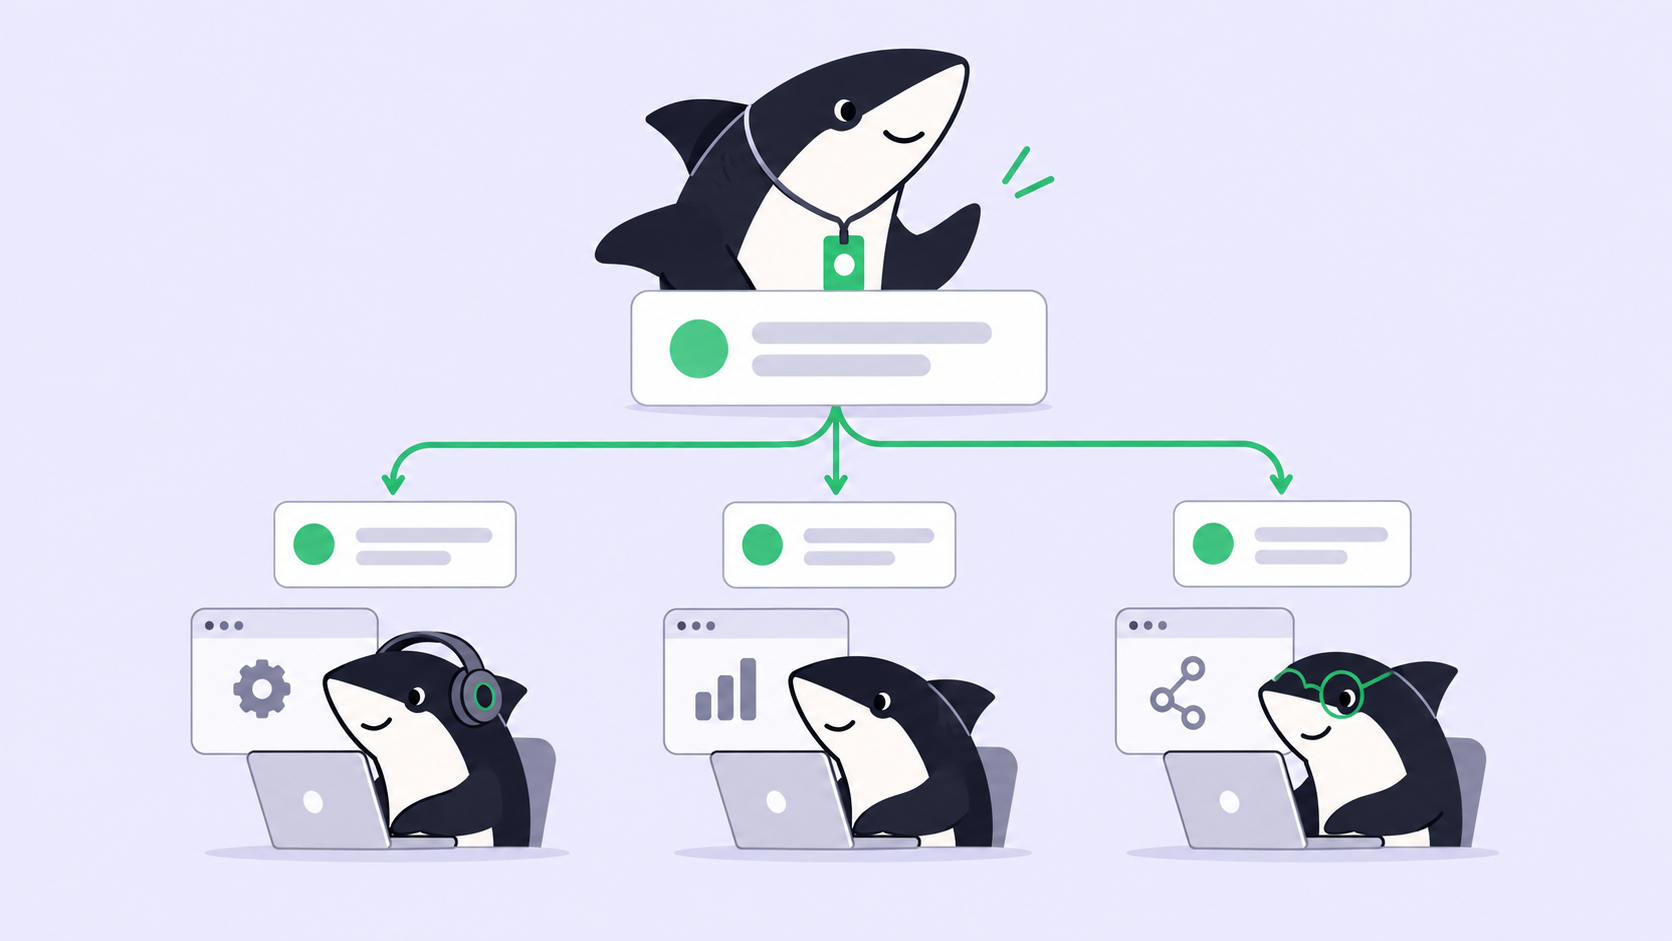
Um líder de Crew quase não escreve código. Ele lê a Task, decide quem deve agir, menciona os membros de que precisa, espera, lê o que voltou e então combina os resultados ou devolve a tarefa. No GPT-6 Astra, a US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de saída, o Agent que produzia menos código era o que tinha a tarifa mais alta da Crew.
A OpenAI lançou o GPT-6 Sol em 22 de setembro de 2026 a US$ 2 de entrada e US$ 10 de saída, API id gpt-6-sol, um quinto da tarifa do Astra em ambos os lados. Isso não faz do Sol o modelo mais inteligente disponível. Faz com que a cadeira de coordenação seja barata o bastante para ser ocupada em toda Crew que você executar.
Defendemos o Astra em GPT-6 Astra como líder da sua Crew: entregue a cadeira que decide ao melhor julgamento do time, e os membros podem ser comuns. Esse argumento continua válido. O que mudou foi o preço de agir com base nele. O que não mudou foi a fila de trabalho concluído esperando alguém aceitá-lo.
TL;DR
Uma Crew é um grupo reutilizável de People e Agents coordenado por um Agent líder, e a execução começa pelo líder: ele lê o contexto da Task e as instruções da Crew antes de qualquer membro começar. Essa cadeira é pesada em entrada e roda mais de uma vez por Task, então a conta dela acompanha a leitura, não a escrita. O Sol, a US$ 2 / US$ 10 com 90% de desconto nas leituras de entrada em cache, torna viável manter um líder em toda Crew. Mantenha o Astra ou o Claude Opus 5.5 na cadeira quando o próprio requisito for ambíguo. Os Agents pesquisam, executam, testam e reportam. As People definem a direção, concedem autoridade e aceitam o resultado.
O que a cadeira de líder realmente gasta
A documentação da Sharkly descreve a execução de uma Crew como uma sequência fixa. Se a Task está em um status executável e o líder está pronto, o Agent líder começa primeiro. Ele lê o contexto da Task e as instruções da Crew e então ou executa o trabalho ou menciona os membros Agent elegíveis para contribuições específicas. Os resultados deles retornam à Task, e o líder combina o que voltou.
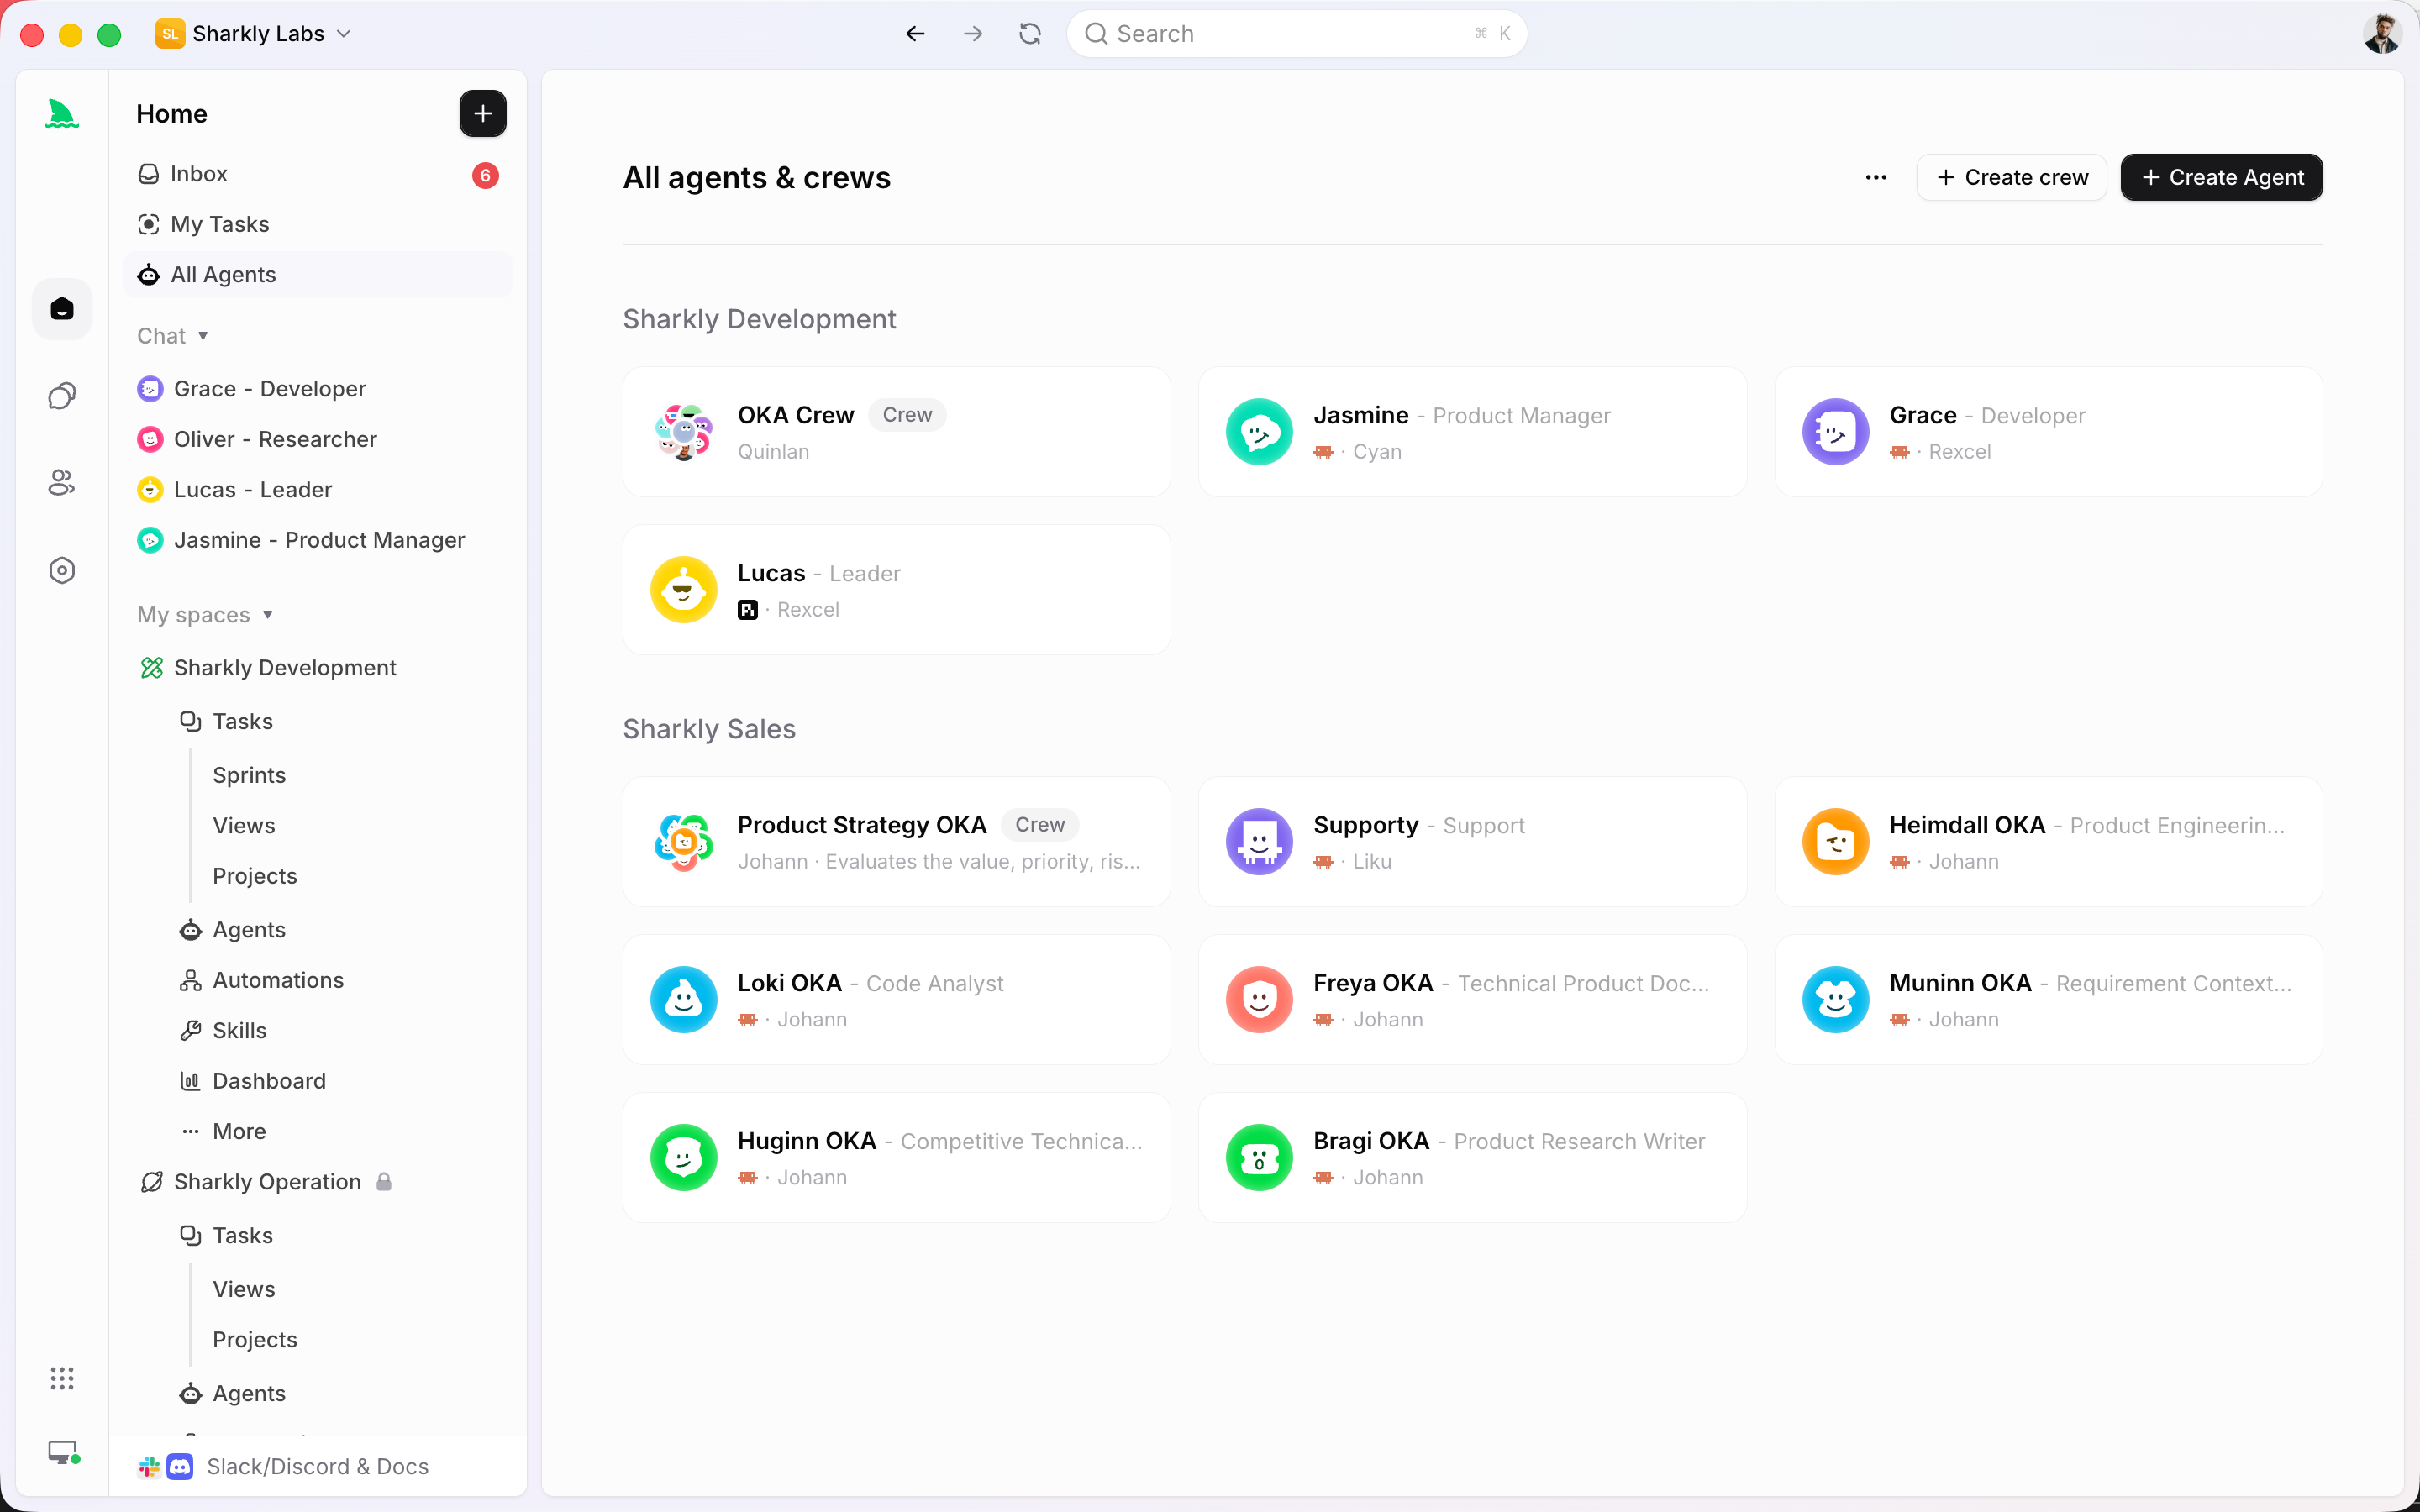
Leia isso como um formato de cobrança. Cada turno do líder começa com leitura: a descrição, os comentários desde a última vez, as instruções da Crew, os papéis disponíveis e tudo o que os membros já publicaram. Termina com a escrita de uma decisão curta ou uma menção. Pesado em entrada, leve em saída, repetidamente.
E a cadeira é mais movimentada do que a maioria dos times espera, porque o líder não roda uma vez por Task. Em uma Task atribuída a uma Crew, um comentário simples e elegível de um membro pode iniciar o líder da Crew, sob o mesmo requisito de disponibilidade de qualquer outra execução. Uma Task com uma discussão ativa é uma Task cujo líder já leu a thread várias vezes.
| Candidato à cadeira de líder | API id | Entrada / saída por 1M | Entrada em cache |
|---|---|---|---|
| GPT-6 Astra | não informado | US$ 10 / US$ 50 | não informado |
| Claude Opus 5.5 | claude-opus-5-5 |
US$ 4 / US$ 20 | US$ 0,20 de leitura, US$ 5 de escrita |
| GPT-6 Sol | gpt-6-sol |
US$ 2 / US$ 10 | 90% de desconto nas leituras |
| GPT-6 Luna | gpt-6-luna |
US$ 0,10 / US$ 0,50 | 90% de desconto nas leituras |
São tarifas de API dos fornecedores, e estão aqui pelas proporções, não pela fatura. O uso dos modelos continua pelas assinaturas ou chaves de API configuradas nas suas ferramentas de código, então o que seu time paga depende dos planos que ele conecta.
Custo por tarefa, não custo por token
Um líder que interpreta mal um requisito custa um dia de execuções dos membros, então a tabela de preços é o lugar errado para resolver isso. A OpenAI publica o custo por tarefa junto com a pontuação, o que chega mais perto da pergunta real.
| AutomationBench 1.0.6, conforme publicado pela OpenAI | Pontuação | Custo por tarefa |
|---|---|---|
| GPT-6 Sol, esforço extra-alto | 33,2% | US$ 0,27 |
| GPT-6 Astra, esforço baixo | 30,3% | 3,9x o Sol |
| Claude Opus 5, esforço máximo | 26,9% | 11,1x o Sol |
No Agents' Last Exam V1, o Sol em esforço máximo pontua 56,4%, acima do melhor resultado do Opus 5, com custo por tarefa 60% menor.
Três ressalvas honestas antes de você gastar qualquer coisa com base nessa tabela. São execuções de benchmark do agent inteiro, não execuções do líder; ninguém publica um número de custo de coordenação, e a conta real do seu líder depende de quão tagarelas são suas Tasks. A linha do Astra está em esforço de raciocínio baixo, que é a própria escolha de ponto de comparação da OpenAI, e não o Astra trabalhando duro. E a OpenAI afirma claramente que o Astra "continua sendo nosso melhor modelo em todos os aspectos", enquanto a Artificial Analysis, uma terceira parte, coloca o índice de inteligência do Sol em 48 contra 58 do Claude Opus 5.5. O Sol não é o modelo mais forte que você pode colocar na cadeira. É o mais forte que você pode se dar ao luxo de deixar sentado nela em toda Crew.
O cache é um desconto especialmente para a cadeira de líder
O GPT-6 aumenta as taxas de acerto de cache por padrão e aplica 90% de desconto nas leituras de entrada em cache. Duas mudanças importam mais para um líder do que para um membro: alterar o esforço de raciocínio ou o conjunto de ferramentas disponíveis não invalida mais o cache, e breakpoints explícitos permitem escolher onde termina um prefixo em cache. A OpenAI cita o GitHub, que passou a ter mais de 50% menos tokens de prompt precisando de processamento novo em bilhões de requisições.
Um líder é o maior vilão quando o assunto é contexto reenviado em uma Crew. Ele lê as mesmas instruções da Crew, as mesmas convenções do repositório e uma thread de Task que cresce a cada turno, e esse prefixo é quase idêntico toda vez. É exatamente o formato para o qual um prefixo em cache foi feito. A configuração fica no Runtime do Computer, não no Agent; como rodar agents com GPT-6 Sol no Sharkly mostra onde colocá-la.
Quando o Astra ou o Opus 5.5 ficam com a cadeira
Use o Sol como líder quando a Crew lida com muitas Tasks delimitadas por dia, os papéis são estáveis e a maior parte do julgamento pode ser escrita nas instruções da Crew em vez de ser deduzida de novo a cada execução. Mantenha um modelo mais caro na cadeira quando o próprio requisito for ambíguo, quando uma interpretação errada mandar três membros pelo caminho errado, ou quando a Task for um trabalho longo em vez de muitos curtos.
Um líder mais barato não é motivo para colocar uma Crew em um trabalho que um único Agent dá conta. A documentação é direta quanto a isso: para trabalhos pequenos e bem definidos, atribua a Task diretamente a um Agent. Use uma Crew quando o líder precisa interpretar o objetivo, envolver outros membros Agent e trazer os resultados deles de volta para uma única Task. Um ajuste em um único arquivo encaminhado por uma Crew paga por uma execução de coordenação de que nunca precisou, a qualquer preço.
Trocar o modelo do líder também não muda nada em termos de responsabilidade. O Owner gerencia a Crew; o líder coordena a execução.
Escrever o julgamento é o que torna viável uma cadeira mais barata:
You lead this Crew. Read the Task and the comments added since your
last turn, then pick the smallest set of members that can finish it.
Mention @backend for API and job changes, @tests for coverage,
@docs for user-facing pages.
Ask a person only when two readings of the requirement would produce
different designs. Otherwise state your assumption and proceed.
Combine member results into one summary: what changed, what you ran,
what failed, what you did not cover. Leave acceptance to a person.
Uma observação operacional antes de você confiar em um turno longo do líder. A Artificial Analysis mediu 102,15 segundos até o primeiro token para a variante de raciocínio máximo do GPT-6 Sol, um número de terceiros para uma configuração de esforço máximo, e não de um fornecedor. [VERIFY] A Crew inteira espera pelo primeiro turno do líder, então um líder que está pensando e um líder que travou parecem a mesma coisa até que um status diga o contrário.
A conta que não mudou
A OpenAI relata que seu pesquisador mediano gasta mais de US$ 600 por dia com agents de código, e o percentil 90 gasta US$ 7.000. Nas tarifas do Sol, um time que estava racionando execuções de Crew agora pode pagar por várias vezes mais execuções, e cada uma delas termina em um resultado que uma pessoa precisa ler.
É essa a restrição que um corte de preço piora em vez de melhorar. Coordenação mais barata compra mais trabalho em paralelo, mais diffs e mais decisões por semana, contra uma capacidade de revisão medida em horas humanas que não mudou em 22 de setembro de 2026. Os Agents pesquisam, executam, testam e reportam. As People definem a direção, concedem autoridade e aceitam o resultado. A automação para onde o julgamento do time é necessário.
É por isso que a saída do líder importa mais do que a tarifa dele. Uma execução de líder que termina em um histórico de rolagem não vale nada a US$ 0,27 nem a US$ 3. Uma execução de líder que devolve o plano, os resultados dos membros, as verificações, as falhas e a questão em aberto para uma única Task é o que permite que uma pessoa aceite o trabalho em minutos em vez de reconstruí-lo. Mantenha contexto, progresso, bloqueios, resultados e revisão humana visíveis da solicitação até a entrega, e a cadeira mais barata se transforma em vazão em vez de acúmulo de trabalho.
O que mudar esta semana
- Escolha uma Crew com um líder caro e aponte o Runtime dela para
gpt-6-solnaquele Computer. - Transfira para as instruções da Crew, por escrito, o julgamento que você estava pagando o líder para improvisar.
- Rode um Sprint e compare dois números com o anterior: Tasks concluídas e Tasks devolvidas após a revisão. Se as devolvidas aumentaram, a cadeira antiga estava fazendo mais do que você imaginava.
Se você já roda vários agents, a Sharkly oferece um único lugar para gerenciar as tarefas e os resultados deles.


