
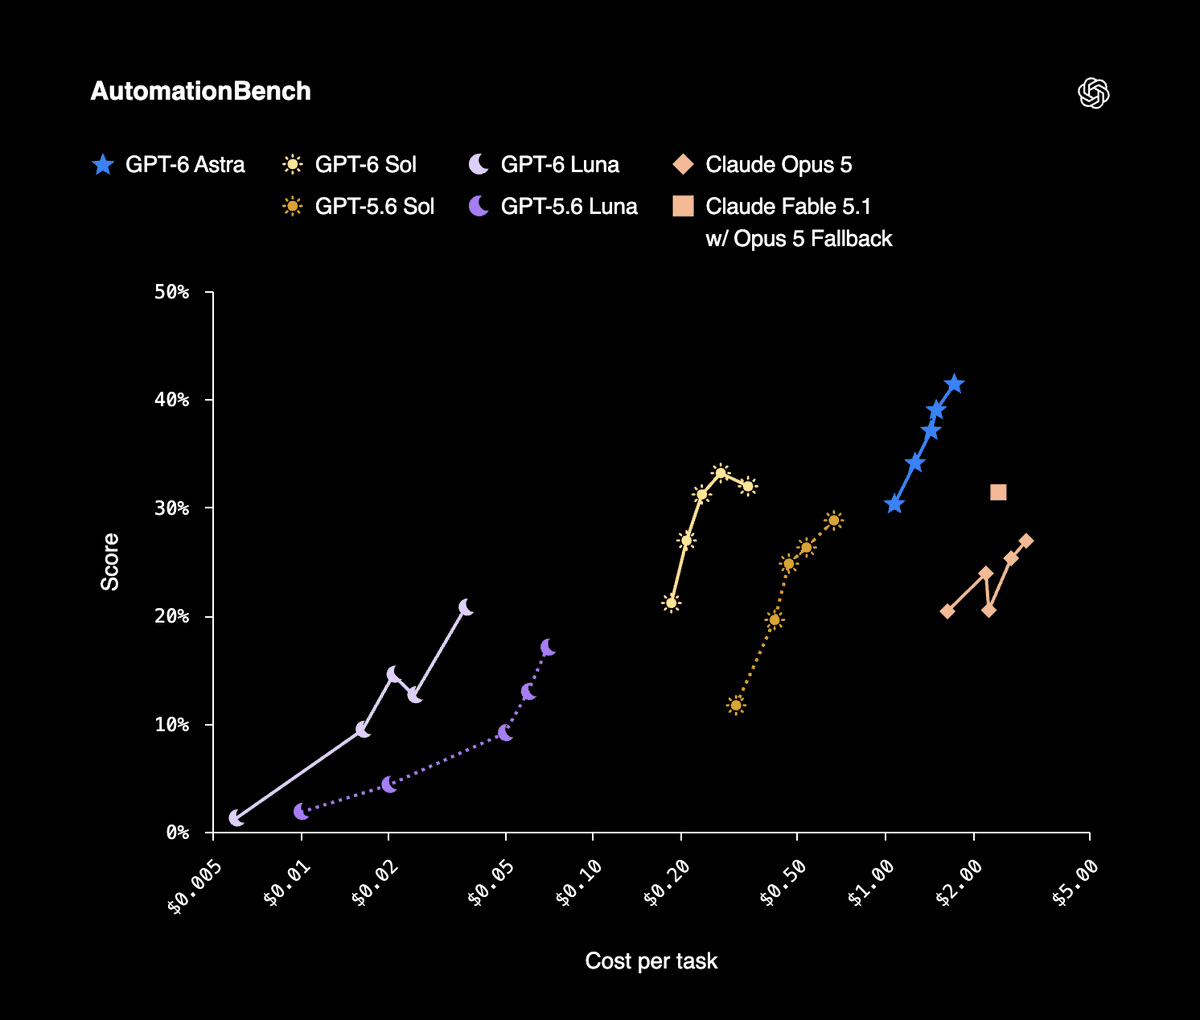
A OpenAI lançou o GPT-6 Sol em 22 de setembro, a US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, com o id de API gpt-6-sol e uma janela de contexto de 872k. O número que deveria mudar a forma como o seu board enxerga o assunto não é a tarifa por token. É o custo por tarefa concluída: nos resultados do AutomationBench 1.0.6 da OpenAI, o Sol com esforço de raciocínio xhigh pontua 33,2% a US$ 0,27 por tarefa, enquanto o Claude Opus 5 com esforço máximo pontua 26,9% a 11,1 vezes o custo por tarefa do Sol.
Leia isso como uma questão de orçamento, não como um ranking. Se a sua equipe vinha racionando execuções de agentes porque uma execução completa saía cara, essa restrição acabou de mudar de lugar. A próxima restrição é aquela que ninguém resolve na base do dinheiro: alguém ainda precisa ler o diff e aceitar o trabalho. Este guia percorre o caminho útil mais curto pela configuração e depois é honesto sobre a parte que o corte de preço não resolve. Coloque o Sol no Codex em um Computador, crie um Agente e atribua uma Tarefa de verdade.
TL;DR
Defina model = "gpt-6-sol" no Codex de um Computador conectado, confirme que o Runtime do Codex aparece como Available no Sharkly, mantenha o diretório de trabalho do Agente em modo Temporary, aumente o timeout por Tarefa antes de confiar na primeira execução longa e atribua uma Tarefa. O Sharkly não exibe o nome do modelo. Ele mostra a execução, o log, as perguntas e o resultado na Tarefa. Agentes pesquisam, executam, testam e relatam. Pessoas definem a direção, concedem autoridade e aceitam o resultado.
Onde fica a configuração de modelo
O Sharkly não escolhe modelos. A documentação de Agentes diz isso sem rodeios: “O Agente segue o modelo padrão do Runtime. Ele não promete nem exibe um nome de modelo específico. Altere modelos na configuração do Runtime ou da ferramenta do Computador, não no Agente.”
Não existe lista suspensa de modelos em um Agente, nem controle de profundidade de raciocínio, então não perca tempo procurando. São quatro papéis, com uma função cada. O Agente define como o trabalho deve ser conduzido. O Computador fornece o host e os recursos locais. O Runtime executa a sessão do agente propriamente dita, e o Codex é o Runtime aqui. A Tarefa continua sendo o registro compartilhado pela equipe.
Passo 1: coloque o GPT-6 Sol no Codex do Computador
No Computador que vai executá-lo, atualize o Codex e faça login com uma conta ou chave de API que tenha acesso ao Sol. A OpenAI disponibilizou o Sol no ChatGPT Work e no Codex para os planos Plus, Pro, Business, Enterprise e Edu, e ele ainda não está no Chat. Se codex -m gpt-6-sol iniciar uma sessão em um terminal comum nesse host, o Sharkly consegue usá-lo.
Depois defina o padrão para que toda execução nesse Computador o adote:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
Dois alertas sobre esse trecho. O nome da chave de esforço de raciocínio varia entre versões do Codex, então confira na configuração de exemplo da build do Codex instalada nesse Computador. E o nível de esforço é uma decisão de custo, não um botão de qualidade que você deixa no máximo: os próprios resultados publicados pela OpenAI usam níveis de esforço diferentes para benchmarks diferentes, e o valor de US$ 0,27 por tarefa citado acima é a linha xhigh. [VERIFY]
De volta ao Sharkly, abra o detalhe do Computador e execute o rescan ou o teste de conexão. O Runtime do Codex deve aparecer como Available. Um Computador exibido como online significa apenas que o serviço local está enviando heartbeats. É o status de capacidade do Runtime que indica que uma execução pode começar.
Passo 2: configure o cache antes de escalar o Crew
Esta é a mudança do GPT-6 que mais importa quando mais de um Agente trabalha no mesmo repositório, e é justamente a que a maioria das equipes vai ignorar.
A OpenAI relata taxas de acerto de cache mais altas por padrão no GPT-6, desconto de 90% nas leituras de entrada em cache, um painel de prompt caching e uma ferramenta de diagnóstico e, o que é importante para o trabalho com agentes, que mudar o esforço de raciocínio ou a disponibilidade de ferramentas não invalida mais o cache. Pontos de quebra explícitos permitem escolher onde termina um prefixo em cache. A OpenAI cita o GitHub tendo mais de 50% menos tokens de prompt precisando de processamento novo ao longo de bilhões de requisições.
Para um Crew, a forma prática é esta. Toda execução de Agente no mesmo repositório reenvia um prefixo grande e quase idêntico: a estrutura do repositório, as regras da casa, o comando de teste, as convenções. Esse prefixo é exatamente para o que serve um cache, e é a razão pela qual uma frota de agentes pode custar muito menos por execução do que custou o primeiro agente.
Um par de decisões, porque isso não é trabalho de graça. Fixe um prefixo estável e defina um ponto de quebra explícito quando vários Agentes rodam repetidamente contra a mesma base de código e o texto das suas Skills e instruções já está consolidado. Não se dê ao trabalho quando um Agente roda algumas vezes por semana ou quando as instruções ainda mudam toda semana, porque você vai gastar mais tempo mantendo a fronteira do que economiza.
Passo 3: construa o Agente em torno de uma execução que demora a começar
Abra Agentes, selecione Novo agente, escolha o Computador e o Runtime do Codex e configure três coisas.
Timeout por Tarefa. Defina isso de propósito, porque uma execução do Sol em um modo de raciocínio alto pode parecer morta antes de parecer ocupada. A Artificial Analysis, uma terceira parte, e não qualquer um dos fornecedores, mediu 102,15 segundos até o primeiro token na variante de raciocínio máximo do GPT-6 Sol. Isso é mais do que a maioria das pessoas espera antes de supor que algo travou, e é exatamente a falha que um status em um quadro compartilhado evita e um terminal não. Uma execução que está pensando e uma execução que travou são idênticas em um scrollback. Veja observabilidade de agentes de código para saber o que um status precisa carregar para valer a pena ser lido.
Diretório de trabalho. Modo Temporary. Cada Tarefa recebe um diretório isolado, e execuções com repositório preparam um worktree novo, então duas execuções do Sol no mesmo repositório não podem sobrescrever uma à outra. A concorrência padrão para diretórios temporários é 50% do limite do Computador. Deixe assim até esse Computador ter lidado com várias execuções reais; concorrência maior consome CPU, memória, disco e capacidade do provedor ao mesmo tempo.
Instruções. Curtas e estáveis:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
Passo 4: atribua uma Tarefa e depois decida se um Crew merece seu lugar
Escolha uma Tarefa com um critério de aceite claro. Selecione o Agente como responsável e mova a Tarefa de Backlog para um status cuja categoria seja pronta para trabalho; uma Tarefa atribuída ainda em Backlog fica esperando. A execução passa por queued, dispatched e running, e a aba Executions transmite o log em tempo real. Se o Agente precisar de uma decisão, a pergunta volta para a Tarefa como comentário, a Tarefa exibe que está aguardando resposta humana, e isso encaminha para a sua Inbox.
Para uma mudança delimitada, um Agente é a escolha certa e as peças móveis ficam em zero. Um Crew é um grupo reutilizável de Pessoas e Agentes coordenado por um Agente líder, e ele ganha seu lugar quando o líder precisa interpretar um objetivo e reunir os resultados de vários membros em uma única Tarefa.
O Sol muda essa conta, porque um líder basicamente lê, planeja, atribui e revisa, e esse era o trabalho mais difícil de justificar no topo de uma tabela de preços:
| Modelo do Runtime | id da API | Entrada / saída por 1M | Onde ele se encaixa em um Crew |
|---|---|---|---|
| GPT-6 Astra | não informado | $10 / $50 | Líder quando o plano em si é a parte difícil |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Líder e os membros que fazem mudanças reais |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | Membros de alto volume: triagem, rotulagem, scaffolding |
Escrevemos essa mesma configuração para o Astra em usando o GPT-6 Astra como líder de Crew. O argumento continua válido; o preço por trás dele é que mudou.
O que o corte de preço não compra
A OpenAI descreve o Sol como 50% mais barato que o preço promocional do GPT-5.6. Esse qualificador é da própria OpenAI e importa, porque a base de comparação é uma tarifa promocional, não uma tarifa de tabela. Mais duas ressalvas cabem na mesma página. Os benchmarks de lançamento da OpenAI comparam com o Claude Opus 5, que a Anthropic substituiu pelo Opus 5.5 horas depois, no mesmo dia, então leia essas margens como algo medido contra a geração anterior. E o nível de esforço faz o trabalho: o Sol alcança 68,8% no DeepSWE 1.1 e 56,4% no Agents' Last Exam V1 com esforço máximo, não na configuração que você deixaria ligada para tarefas de rotina.
Agora a parte que não tem nada a ver com o modelo. A OpenAI relata que seu próprio pesquisador mediano gasta mais de US$ 600 por dia com agentes de código, com o percentil 90 acima de US$ 7.000. Custo menor por tarefa é como uma conta dessas se forma, não como ela é evitada. Toda execução ainda produz uma mudança que alguém precisa ler, questionar e aceitar, e essa fila não ficou 11 vezes mais barata esta semana. Planeje em torno da capacidade de revisão em vez da escolha do modelo, registre o roteamento como regra em vez de preferência, e mantenha atribuição, progresso, bloqueios, resultados e revisão humana em um só lugar, da solicitação até a entrega.
Se você já roda vários agentes de código, conecte um Computador, crie um Agente e atribua a ele algo entediante.


