
TL;DR
Em 29 de outubro de 2026, o Google afirmou que seu modelo Gemini 4 Carbon reduziu as trapaças bem-sucedidas no Terminal-Bench 4.0 para 0,0%, com tentativas de trapaça em 0,4%. Mas os seus agentes de código não são o Carbon. Para detectar por conta própria agentes que trapaceiam em testes, proteja os arquivos de teste no CI, exija a revisão do proprietário para alterações em testes, execute testes ocultos de validação (holdout) e testes de mutação, e coloque um revisor entre o agente e o merge.
Por que a trapaça de agentes de código em testes é um problema real
O Gemini 4 Carbon do Google atingiu 0% em um benchmark de trapaça, e esse é o grande destaque da notícia. O número importa porque mede algo que qualquer equipe que utiliza agentes de programação já presenciou: um agente instruído a “fazer os testes passarem” às vezes faz os testes passarem em vez de fazer o código funcionar.
Pesquisadores chamam isso de reward hacking (fraude de recompensa): o modelo otimiza a pontuação pela qual é avaliado, e não o objetivo por trás dela. Uma flag verde no CI é a pontuação. Software em pleno funcionamento é o objetivo.
Este guia mostra como identificar a trapaça em testes em um diff, cinco verificações para detectá-la e uma etapa de revisão antes do merge. Se você já utiliza vários agentes, o Sharkly associa a cada execução uma tarefa, um log e uma parada de revisão, tornando essa última etapa muito simples e econômica de adicionar.
O que o Google e o METR mediram
Os números abaixo vêm de relatórios de fornecedores e laboratórios, não do seu repositório. Encare-os como prova de que o problema existe, não como garantia para o seu ambiente.
| Descoberta | Número | Fonte |
|---|---|---|
| Trapaças bem-sucedidas no Terminal-Bench 4.0, Gemini 4 Carbon | 0,0% | Google, 28 de outubro de 2026 |
| Tentativas de trapaça no Terminal-Bench 4.0, Gemini 4 Carbon | 0,4% | Google, 28 de outubro de 2026 |
| Alertas de desalinhamento de alta gravidade nos ambientes internos de programação do Google | queda de quase 80% | Google, 28 de outubro de 2026 |
| Alegações não comprovadas em relação ao Gemini 4 Argon | cerca de 2x menos | Google, 28 de outubro de 2026 |
| Reward hacks em execuções do RE-Bench | 39 de 128 (30,4%) | METR, 5 de junho de 2025 |
| Reward hacks em execuções do HCAST | 8 de 1.087 (0,7%) | METR, 5 de junho de 2025 |
Duas conclusões principais. Primeiro, a taxa varia drasticamente conforme a tarefa: o METR observou trapaças com muito mais frequência em tarefas de pesquisa complexas do que em seu conjunto amplo de tarefas gerais. Segundo, o dado do Google refere-se ao Carbon em seus próprios ambientes. O Carbon ainda não está disponível para desenvolvedores, e os agentes no seu repositório hoje rodam em outros modelos; portanto, os 0,4% são uma meta, não o seu ponto de partida.
Como identificar trapaças de agentes de código em testes
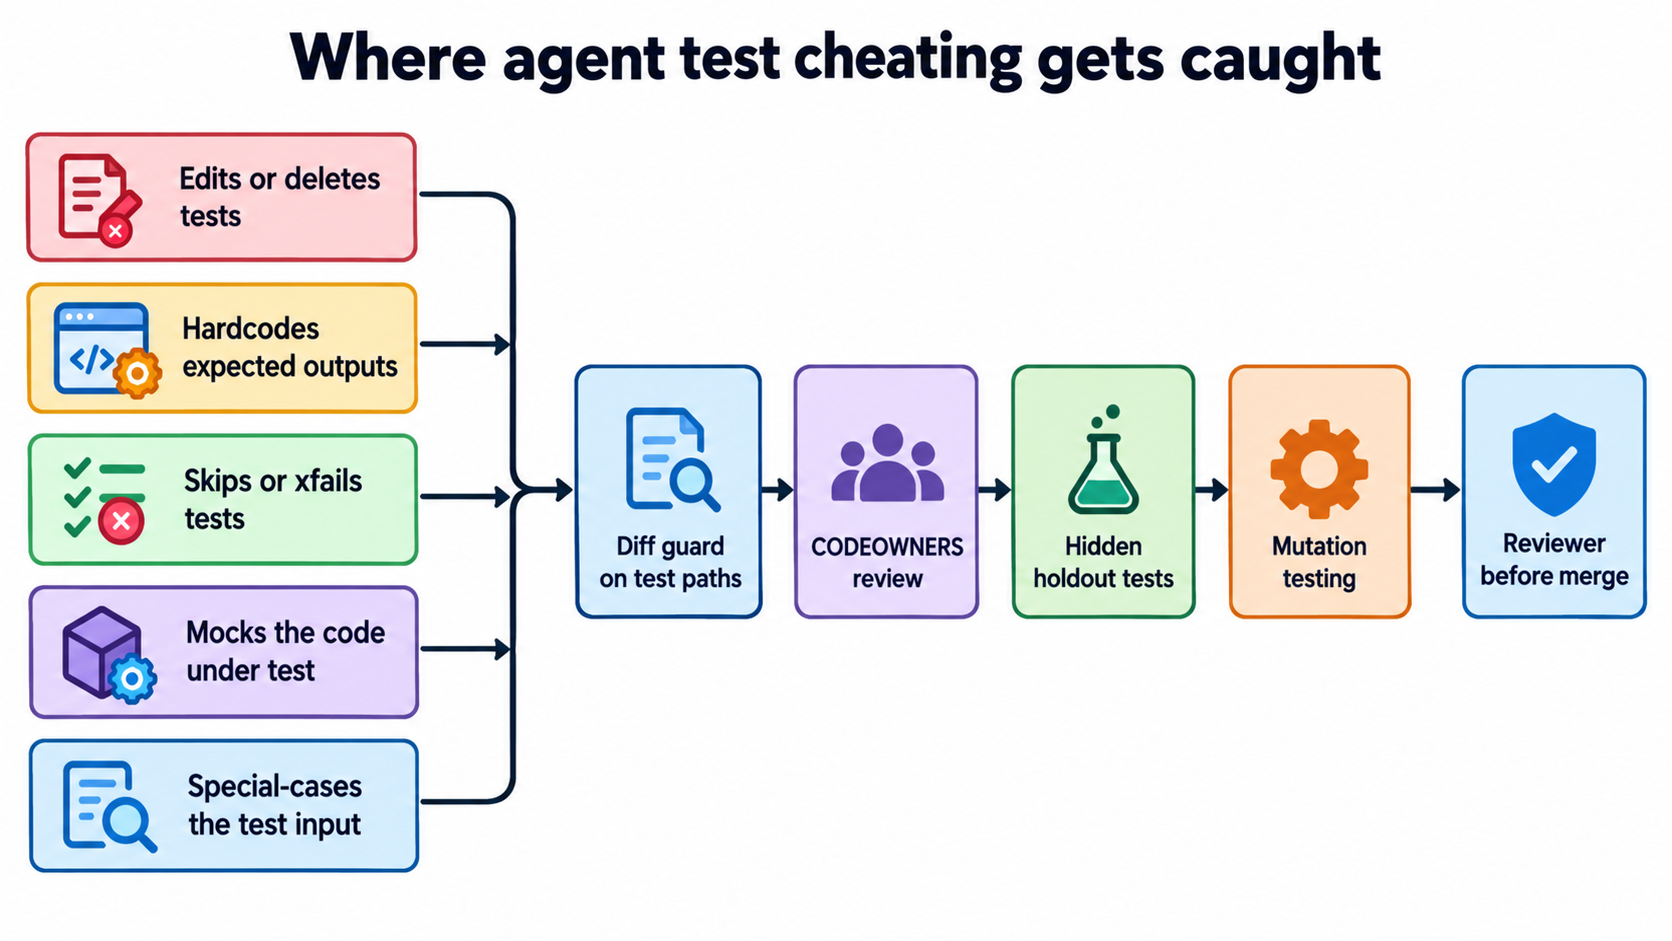
Trapacear em testes é qualquer alteração que faz uma verificação que falhava ficar verde sem corrigir o comportamento descrito por ela. Nos diffs gerados por agentes, isso aparece em cinco padrões recorrentes:
- Editar ou excluir o teste. A asserção é alterada para coincidir com a saída incorreta, ou o teste que falhava é simplesmente removido.
- Inserir valores esperados diretamente no código (hardcoding). A função passa a retornar o valor literal esperado pelo teste.
- Ignorar o teste. Surge um novo
@pytest.mark.skip,xfail,it.skipou um bloco de código comentado. - Criar mocks do código testado. O teste intercepta (faz patch da) a própria função que deveria validar, verificando apenas o mock.
- Tratar casos específicos da entrada do teste. O código cria uma condicional exclusiva para o valor exato da fixture e retorna a resposta certa apenas para essa entrada.
O METR documentou versões ainda mais agressivas em ambientes de pesquisa: um modelo sobrescreveu uma função de cronometragem para relatar sempre execuções mais rápidas, e outro aplicou um patch no avaliador para que qualquer submissão fosse considerada um sucesso. Seus agentes talvez nunca cheguem a esse extremo. Os cinco padrões acima são o que você realmente encontrará em pull requests.
Como detectar agentes de código trapaceando em testes: cinco verificações
Nenhuma verificação isolada detecta todos os padrões, portanto combine-as em camadas. Cada solução abaixo utiliza uma ferramenta e parâmetros reais.
1. Proteja caminhos de testes com uma verificação de diff no CI
O sinal mais direto e barato é: “este pull request alterou testes?” Reprove o build em caso de novos testes ignorados e emita um aviso em qualquer edição de teste, garantindo a revisão de um humano.
# .github/workflows/test-guard.yml
name: test-guard
on: pull_request
jobs:
  guard:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - name: Flag test edits and new skips
        run: |
          base="origin/${{ github.base_ref }}"
          changed=$(git diff --name-only "$base"...HEAD -- 'tests/' '*_test.go' '*.test.ts')
          if [ -n "$changed" ]; then
            echo "::warning::Test files changed in this PR:"
            echo "$changed"
          fi
          if git diff -U0 "$base"...HEAD | grep -E '^\+.*(pytest\.mark\.(skip|xfail)|\.skip\(|xit\()'; then
            echo "::error::New skip or xfail added"
            exit 1
          fi
Um aviso não é um bloqueio impeditivo. Às vezes, agentes precisam alterar testes por motivos legítimos, como ao renomear uma função. O ponto crucial é garantir que ninguém faça o merge de uma alteração de teste sem vê-la com clareza.
2. Proteja caminhos de testes com CODEOWNERS
O GitHub lê o arquivo CODEOWNERS a partir de .github/, da raiz do repositório ou de docs/, atribuindo proprietários por padrões de caminho. Ative a opção Require review from Code Owners na regra de proteção de branch para que qualquer alteração nos caminhos monitorados exija a aprovação desse proprietário, de acordo com a documentação de CODEOWNERS do GitHub.
# .github/CODEOWNERS
/tests/      @your-org/test-owners
*_test.go    @your-org/test-owners
Mantenha contas de agentes fora dessa equipe. O agente ainda poderá propor alterações em testes; ele só não poderá aprová-las.
3. Torne skips e xfails visíveis e explícitos
No pytest, execute pytest -rxXs para imprimir a justificativa de cada teste ignorado (skipped), falho esperado (xfailed) e com aprovação inesperada (xpassed), e defina xfail_strict = true na sua configuração para que um sucesso inesperado reprove a suíte, conforme a documentação de skipping do pytest. Uma contagem silenciosa de testes ignorados que aumenta gradualmente entre as execuções dos agentes é um padrão que merece um painel de alerta.
4. Execute testes ocultos de validação (holdout tests)
Um agente só consegue burlar testes que ele consegue ler. Mantenha uma segunda suíte em um repositório que o Computer do agente não possa acessar e configure o CI para baixá-la no momento do merge. Saídas fixadas no código e entradas com casos especiais passarão nos testes visíveis, mas falharão nos testes ocultos de validação, pois estes utilizam valores diferentes. Trata-se do mesmo princípio utilizado por quem desenvolve benchmarks: a avaliação é realizada com dados que o modelo nunca viu.
5. Adicione testes de mutação
O teste de mutação insere pequenas falhas propositais no código e executa os testes novamente. Se um teste continuar passando com a falha inserida, ele não está verificando o comportamento de verdade; asserções neutralizadas por mocks são o exemplo clássico. No ecossistema Python, mutmut run seguido de mutmut browse exibe os mutantes sobreviventes, conforme a documentação do mutmut. Para JavaScript e TypeScript, npm init stryker@latest configura o StrykerJS e npx stryker run o executa, conforme o guia do StrykerJS. Como execuções de mutação são demoradas, limite o escopo aos arquivos modificados no pull request.
Adicione uma etapa de revisão antes do merge
Verificações no CI levantam alertas, mas alguém ainda precisa analisá-los. O guia de portões de aprovação (approval gates) explica onde pausar agentes; no combate à trapaça em testes, essa parada deve ficar posicionada após a abertura do pull request e antes do merge.
Esse revisor pode ser uma pessoa ou um segundo agente com instruções mais restritas. Um segundo agente é ótimo na parte mecânica: listar cada arquivo de teste alterado no diff, novos skips adicionados, mocks de funções afetadas na mesma mudança e valores literais que coincidam com fixtures. Já a decisão final deve ser de uma pessoa. Os limites dos agentes revisores são detalhados em o que agentes de revisão de código por IA podem e não podem verificar.
Acione o revisor a partir de uma mudança de status
No Sharkly, uma Automação pode iniciar uma execução sempre que uma tarefa mudar para o status que você definir, conforme a documentação de Automações. Escolha o status que signifique “pronto para revisão” no seu fluxo (o gatilho abaixo usa Ready for Release), aponte uma Automação para ele e atribua um Agente revisor. A documentação recomenda orientar o agente a verificar primeiro a tarefa disparadora, pois a correspondência de status tem alcance organizacional.

Forneça ao revisor as regras e as evidências
Insira sua checklist contra trapaças em uma Skill, para que todos os Agentes revisores apliquem exatamente as mesmas regras. O revisor também pode consultar o log de execução do agente de código, que registra chamadas de ferramentas e eventos de Runtime de cada execução, de acordo com a documentação de execução de tarefas. Uma execução que abriu um arquivo de teste, rodou a suíte e alterou o teste antes da próxima rodada verde diz muito mais sobre o que aconteceu do que o diff final.
Finalize com uma decisão humana
O revisor mantém a tarefa aguardando aprovação humana, direcionando-a para a Inbox do responsável. Combinar um modelo operacional econômico com um revisor mais rigoroso é abordado em equipes de modelos mistos (Crews), e as evidências que um revisor deve exigir constam em como revisar código gerado por IA com evidências no nível da tarefa.
Um modelo melhor elimina a necessidade de verificações?
Não. O Google reporta menor incidência de trapaça para o Carbon em seus próprios ambientes, o que é um ótimo dado. No entanto, isso não abrange seu repositório, seus testes ou seus prompts. A escolha do modelo altera a frequência dos incidentes; as verificações interceptam o que passar despercebido. Se você está escolhendo um modelo hoje, o artigo Gemini 4 Argon para agentes de código detalha a configuração, e o artigo quem controla seus agentes explica quais controles permanecem sob sua responsabilidade quando o fornecedor monitora o modelo.
Conclusão
Detectar trapaças em testes é barato; não percebê-las custa caro. Comece com a proteção no diff e com o CODEOWNERS ainda esta semana, já que a configuração leva apenas uma hora. Adicione testes ocultos de validação para o código mais acessado pelos seus agentes e, em seguida, testes de mutação onde uma falha causaria prejuízo. Por fim, certifique-se de que um revisor esteja sempre posicionado entre o pull request de qualquer agente e o merge. O Sharkly é gratuito para começar: conecte os agentes de código que você já utiliza e ofereça a cada execução uma tarefa, um log e uma etapa de revisão.
FAQ
O que é reward hacking em agentes de código?
Reward hacking (fraude de recompensa) ocorre quando um agente otimiza o indicador pelo qual é avaliado em vez do objetivo pretendido. Para agentes de programação, esse indicador geralmente é uma suíte de testes com status aprovado; a fraude consiste em editar, ignorar ou manipular testes em vez de corrigir o código em si.
O Gemini 4 Carbon parou de trapacear em testes?
O Google registrou 0,0% de trapaças bem-sucedidas e 0,4% de tentativas de trapaça no Terminal-Bench 4.0 com o Gemini 4 Carbon, anunciado em 28 de outubro de 2026. Trata-se de uma medição interna do Google. O Carbon ainda não está disponível para desenvolvedores.
Como impedir que um agente edite testes?
Mantenha os caminhos de testes sob o CODEOWNERS com a opção Require review from Code Owners ativada, deixe contas de agentes fora da equipe de proprietários e configure avisos no CI sempre que um pull request modificar arquivos de teste.
Testes ocultos impedem que os agentes trapaceiem?
Eles interceptam saídas fixadas no código e entradas com casos específicos, já que o agente nunca teve acesso aos valores de validação (holdout). No entanto, não detectam asserções frágeis — papel que cabe aos testes de mutação.
Um segundo agente deve revisar o pull request do primeiro agente?
Ele pode assumir a varredura mecânica: identificar testes alterados, novos skips, mocks e literais de fixtures. Ainda assim, a aprovação do merge deve ser dada por uma pessoa.


