
Você está tentando decidir em qual agente de código confiar para trabalho de verdade: Claude Code, Codex, Gemini CLI, OpenCode, ou dois deles ao mesmo tempo. Então você lê as pontuações dos benchmarks. Um agente resolve 68% de um conjunto público de tarefas, outro 71%, e você deveria escolher com base nisso. Aí o agente chega no seu repositório e trava num passo de build que nenhum dataset público jamais viu.
Um benchmark mede um conjunto fixo e compartilhado de problemas. Seu código é um conjunto privado de problemas: suas convenções, o layout do seu monorepo, o teste instável que todo mundo ignora, o script de deploy que só uma pessoa entende. A pontuação que decide sua semana é a que você gera nesse código, não a que um laboratório publicou. Este guia apresenta um método para comparar agentes de código no software que você realmente entrega, e como fazer essa comparação sem abrir cinco terminais para manter os agentes separados.
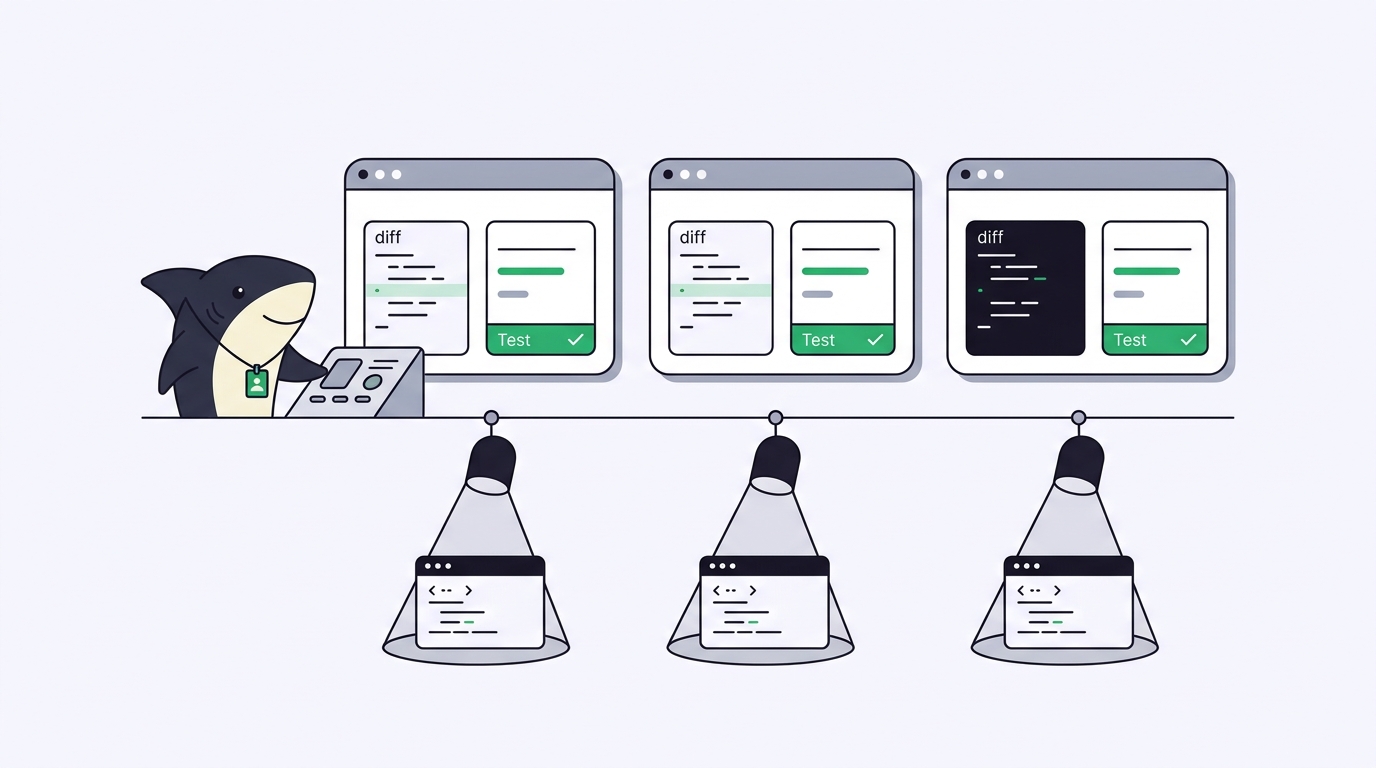
O Sharkly é onde esse método aterrissa. O Sharkly é uma plataforma tudo-em-um de comando e gestão de Agentes: você conecta seu próprio Computador, atribui a mesma Tarefa a Agentes diferentes, e cada execução devolve seu diff, sua saída de testes e sua revisão em um só lugar. É isso que torna possível uma comparação justa. A variável que você quer medir é o agente, não o malabarismo com terminais que você faria de outra forma para impedir que três execuções atrapalhem umas às outras.
Uma pontuação de benchmark mede um dataset, não o seu repositório
Um benchmark de agentes de código é um conjunto de testes público e fixo, pontuado da mesma forma para todos. É exatamente isso que o torna útil para os laboratórios que constroem modelos, e exatamente isso que o torna um preditor fraco para você.
Benchmarks públicos como o SWE-bench tiram suas tarefas de projetos open-source bem conhecidos, com um harness ajustado e verificações de aceitação criteriosas. Nada disso descreve a sua terça-feira. As coisas que determinam o desempenho de um agente no seu código são as que um dataset público jamais poderá conter: suas bibliotecas internas que o modelo nunca leu, sua configuração de lint, o arquivo de contexto de 400 linhas que explica como o serviço realmente inicializa, o único módulo sem testes.
Uma pontuação alta de benchmark não prevê como um agente se comporta no seu repositório. Ela prevê como ele se comporta no repositório de outra pessoa. Trate o ranking como um filtro grosseiro para saber quais agentes vale a pena testar, e depois faça o teste que importa. Se você ainda está escolhendo em qual modelo apontar cada agente, combinar modelos com papéis de agente é uma pergunta inicial melhor do que a pontuação bruta.
Escolha uma tarefa real, não um prompt de brinquedo
Comece pela comparação útil mais simples. Não avalie agentes com “construa um app de tarefas”. Escolha um requisito real do seu backlog: um bug contido, uma funcionalidade pequena em um único módulo, uma migração que você faria de qualquer forma. Algo com um teste de aceitação que você pode rodar e um diff que você lê em poucos minutos.
Depois dê a todos os agentes a mesma entrada: a mesma descrição de tarefa, o mesmo commit inicial, os mesmos critérios de aceitação. Escreva como o seu gerenciador de tarefas escreveria, algo como SH-312: corrigir o desvio de fuso horário na exportação de faturas. Se um agente recebe um prompt mais rico que outro, você está medindo seu prompt, não o agente.
Use uma correção de bug quando quiser ver como o agente lê código existente e se mantém dentro das regras. Use uma funcionalidade pequena quando quiser ver como ele estrutura código novo e se escreve os próprios testes. Faça os dois ao longo do tempo; uma única tarefa só te diz sobre uma única tarefa.
Compare cada agente no seu melhor, nunca no seu pior
Cada agente tem uma configuração em que faz seu trabalho mais forte: o modelo certo, o arquivo de contexto certo, as permissões que ele realmente precisa. Dê ao Claude Code o seu CLAUDE.md, dê ao Codex sua configuração, dê a cada Runtime o ambiente que sua documentação recomenda. Comparar um agente bem configurado com um agente cru não te diz nada além de qual deles você se deu ao trabalho de configurar.
Rodá-los no seu melhor, lado a lado, é onde a abordagem por terminal desmorona. No Sharkly você atribui a mesma Tarefa a cada Agente, e cada Agente roda em um Computador conectado em um worktree isolado, então três agentes editando o mesmo repositório nunca tocam nos arquivos uns dos outros. Você tem três tentativas limpas do mesmo problema em vez de uma árvore de trabalho compartilhada e um merge que você tem que desembaraçar na mão. Se você vem fazendo isso manualmente, rodar vários agentes ao mesmo tempo é a parte que o Sharkly foi feito para tirar das suas costas.
Se você usa apenas um agente e vive no terminal, uma única sessão bem ajustada do Claude Code em um worktree já basta, e talvez você não precise de nada disso. A equação muda no momento em que você está comparando dois ou mais agentes, em mais de uma tarefa, e quer os resultados em um formato que você consegue ler lado a lado de verdade.
Cinco critérios que decidem no trabalho real
Um benchmark pontua um único número: a tarefa passou. O trabalho real é decidido por cinco coisas que esse número deixa de fora.
| Critério | A pergunta que ele responde |
|---|---|
| Execução paralela | Posso rodar os agentes na mesma tarefa ao mesmo tempo, de forma isolada, sem conflitos? |
| Visibilidade para o time | Alguém além de mim consegue ver o que cada agente fez, e por quê? |
| Fluxo de revisão | Quão rápido consigo ler o diff, os testes e os limites conhecidos e aceitar ou rejeitar? |
| Execução na própria máquina | O agente roda no meu Computador, contra meu ambiente e meus segredos reais? |
| Integrações | O resultado chega no gerenciador de tarefas, no repositório e nas ferramentas de revisão que já usamos? |
Os quatro primeiros são onde a maioria dos agentes parece idêntica em um benchmark e se comporta de forma completamente diferente no seu código. A execução na própria máquina, em particular, é invisível para um teste público: um agente que roda contra seu toolchain real, seu banco de dados local, seus hooks de CI reais, está sendo testado naquilo que você entrega, não em um sandbox que se parece com isso.
Agentes pesquisam, executam, testam e reportam. Você define a direção, concede autoridade e aceita o resultado. Uma comparação só é honesta se você consegue ver cada parte disso, para cada agente, sem reconstruí-la a partir do histórico do terminal.
Pontue o que retorna, não o que o agente afirma
Um agente que imprime “concluído” não é a mesma coisa que uma mudança que passa. Pontue cada execução pelo que volta, não pelo que ela afirma. Para cada tentativa, a evidência útil é sempre a mesma lista curta: o diff, os resultados de typecheck e testes, o resumo da mudança e os limites que o agente admite. O Sharkly mantém contexto, progresso, bloqueios, resultados e revisão humana visíveis desde a solicitação até a entrega, então a comparação se lê como uma tabela de resultados em vez de cinco terminais que você precisa lembrar.
É também aqui que aparece o verdadeiro gargalo. Dois agentes podem ambos “terminar” uma tarefa em vinte minutos e ainda custar uma hora cada para revisar. Revisar a saída de agentes costuma ser o verdadeiro limite de quanto trabalho paralelo um time consegue absorver, e isso deveria pesar bastante na escolha do agente. O que priorizar depende de quem está escolhendo:
| Escolhendo para | Priorizar mais |
|---|---|
| Desenvolvedor solo | Fluxo de revisão e execução na própria máquina; você é o único revisor |
| Time pequeno | Execução paralela e visibilidade para o time; várias pessoas precisam ver as mesmas execuções |
| Time de plataforma | Integrações e visibilidade; o fluxo de trabalho precisa sobreviver ao próximo melhor agente |
Essa última linha é o motivo de comparar. O melhor agente de hoje pode não ser o melhor agente no próximo trimestre, e reconstruir seu fluxo de trabalho toda vez que a liderança muda é um imposto por si só. O Sharkly não é um agente de código nem um harness de benchmark; é a camada que permite continuar testando agentes contra seu próprio código sem reconstruir o processo em torno deles a cada vez.
Se você quer continuar usando vários agentes de código em vez de se comprometer com um único ecossistema, esse é o problema para o qual o Sharkly foi projetado. Baixe o Sharkly, conecte um Computador e atribua a mesma tarefa real a dois agentes. A comparação que você recebe é sobre seu código, que é a única que prevê sua semana.


