
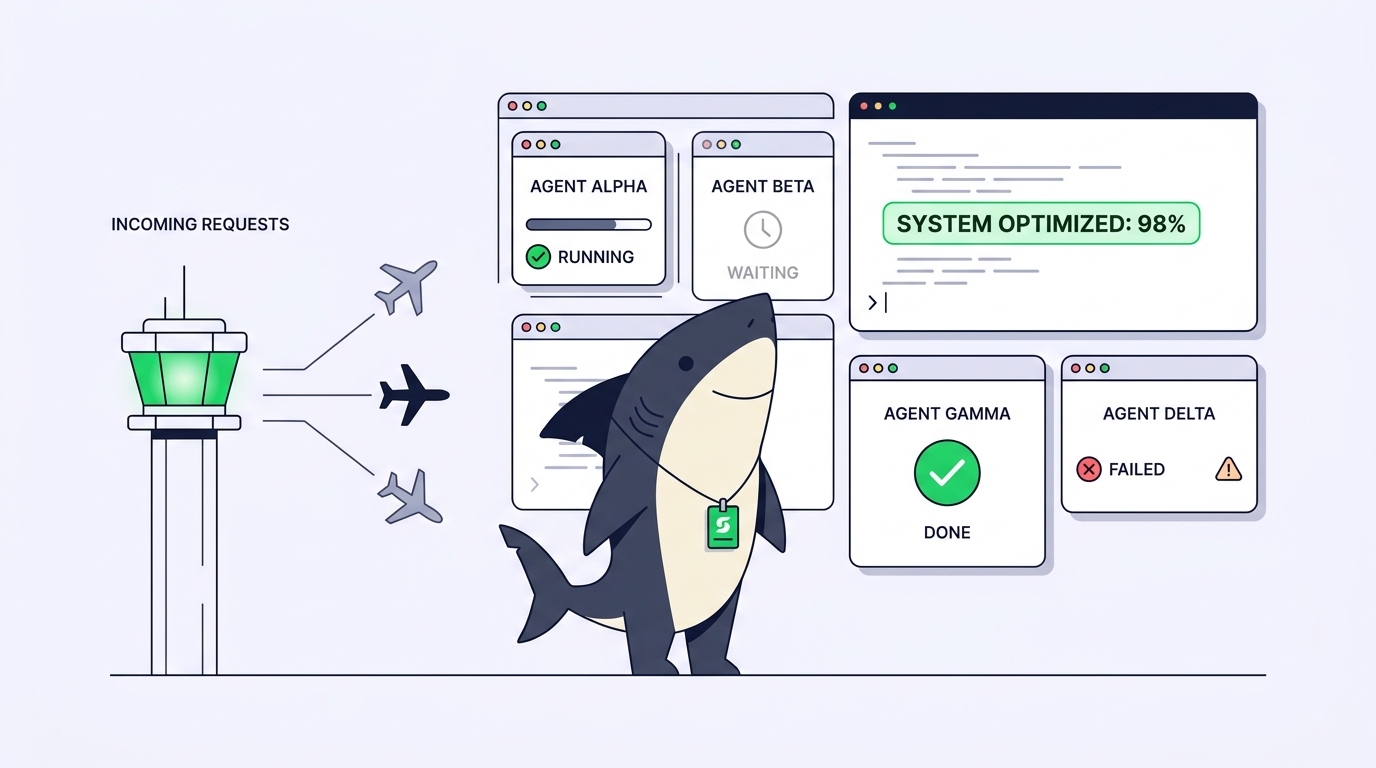
Você iniciou três coding agents hoje de manhã. Um está refatorando um módulo de autenticação, outro escrevendo testes e um terceiro investigando uma falha intermitente na CI. Uma hora depois, você tem cinco terminais abertos, dois painéis detached do tmux e uma sensação incômoda de que pelo menos um deles travou há algum tempo e ficou parado sem que você percebesse. Você dá alt-tab, rola um log, tenta adivinhar.
Ficar adivinhando é o verdadeiro custo de rodar agentes em paralelo. Disparar vários coding agents simultaneamente é fácil hoje em dia. Descobrir qual deles precisa da sua intervenção, qual travou e qual terminou em silêncio é a parte que consome a sua tarde. Monitorar coding agents paralelos significa responder a quatro perguntas em tempo real sem precisar abrir cinco janelas: o que cada agente está fazendo, até onde ele avançou, o que está bloqueando seu progresso e o que já está pronto para revisão.
Este guia analisa primeiro como montar um monitoramento no estilo faça você mesmo (DIY), apontando as falhas em cada etapa. Em seguida, mostra onde essa abordagem deixa de escalar e o que uma camada compartilhada de tarefas agrega. Essa camada compartilhada é o Sharkly: você já usa coding agents, e o Sharkly os transforma em uma equipe ao manter o progresso, os bloqueios e os resultados de cada um visíveis em um só lugar, em vez de espalhados por vários terminais. É possível criar a maior parte desse monitoramento manualmente. O objetivo de comparar as duas abordagens é identificar exatamente quando a versão caseira começa a custar mais do que economiza.
Os quatro sinais que você realmente precisa acompanhar
Monitoramento não é algo único. Quando alguém diz que a execução de um agente “parece boa”, geralmente está se referindo a um de quatro sinais distintos — e cada um falha de maneira diferente.
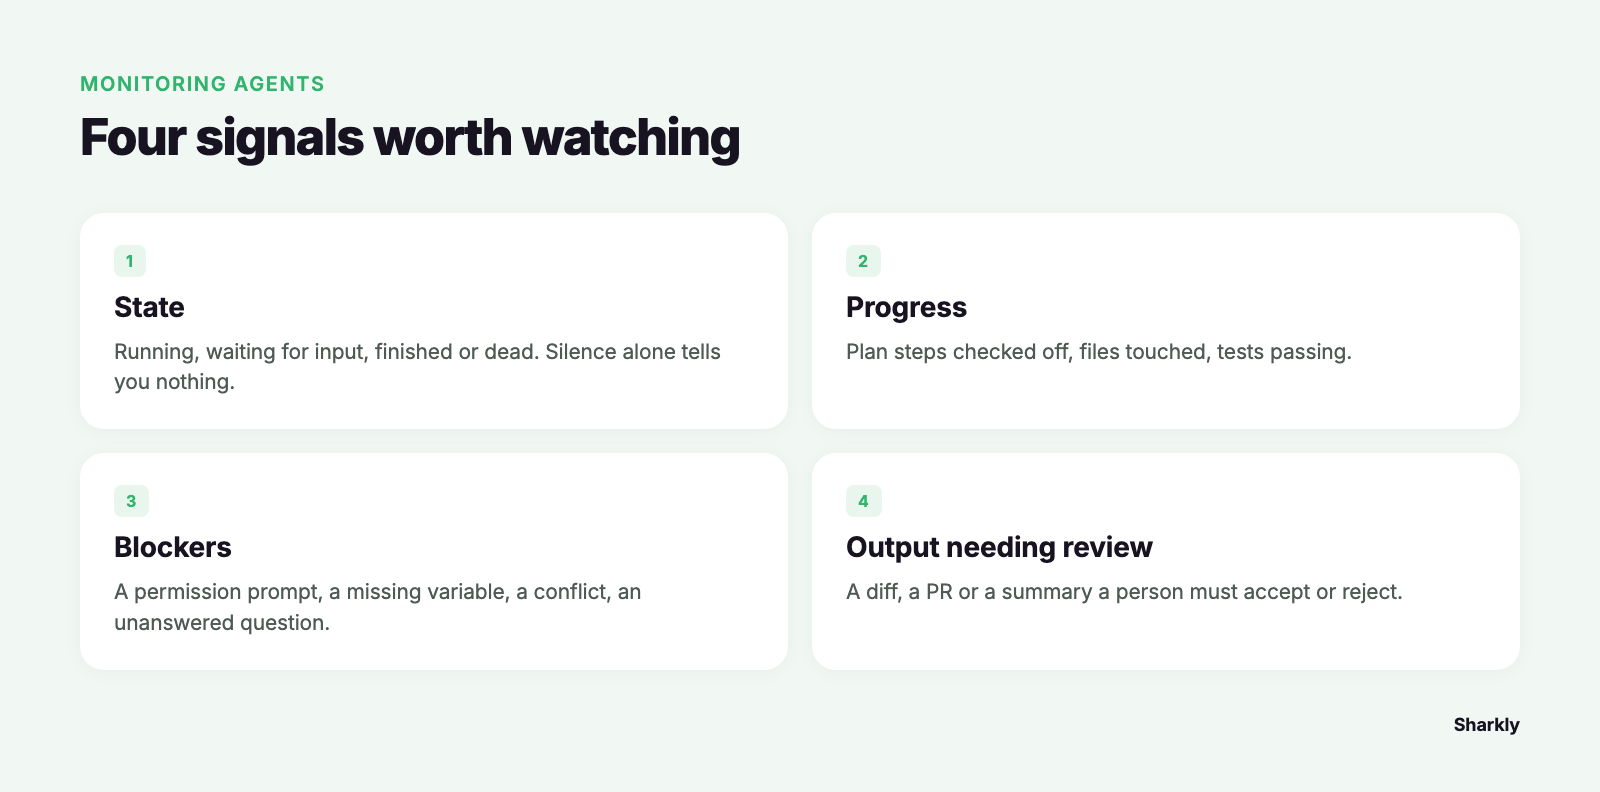
- Estado (State). O processo está em execução, aguardando entrada, concluído ou travado/morto? Um agente que terminou e um agente travado deixam de gerar saída; portanto, o silêncio por si só não informa nada.
- Progresso (Progress). Quanto da tarefa já foi concluído? Itens de um plano marcados como feitos, arquivos modificados, testes passando. O progresso é o que mostra se um agente ativo está realmente avançando ou se entrou em loop.
- Bloqueios (Blockers). O que está travando o agente? Uma confirmação de permissão, uma variável de ambiente ausente, um conflito de merge ou uma pergunta feita que ninguém respondeu.
- Resultados aguardando revisão. O que o agente gerou que agora precisa ser aprovado ou rejeitado por uma pessoa? Um diff, um PR, um resumo de alterações.
Se você monitorar apenas o estado, não perceberá o agente que está em execução, mas preso em um loop de tentativas. Se monitorar apenas o progresso, não notará aquele que finalizou vinte minutos atrás. Uma estrutura de monitoramento eficaz precisa exibir esses quatro sinais de cada agente, em um piscar de olhos.
Passo 1: monitore do jeito caseiro (DIY) e veja onde cada etapa falha
A configuração manual aproveita ferramentas que você já tem no seu fluxo de trabalho. Veja aqui a versão realista, com a lacuna que cada etapa deixa em aberto.
Identificar o que está em execução. Se cada agente roda em seu próprio git worktree, liste-os junto com suas branches:
git worktree list
tmux ls   # if each agent runs in a tmux session
Modo de falha: isso mostra apenas que a sessão existe, mas não se o agente dentro dela está trabalhando ou esperando. Um painel do tmux travado em um prompt Continue? (y/n) parece idêntico a outro em plena execução. Você só descobre ao se conectar à sessão (attach).
Acompanhar o progresso. Acompanhe o log de saída de cada agente em tempo real e consulte o worktree em busca de alterações:
tail -f /path/to/agent-1.log
watch -n 5 'git -C ../wt-auth status --short'
Modo de falha: isso escala de forma linear com a quantidade de agentes. Três logs ainda são gerenciáveis. Seis logs rolando ao mesmo tempo são ilegíveis, e loops com watch mostram apenas movimentação de arquivos, não contexto real. Você vê arquivos mudando sem saber se a alteração está correta ou se o agente está apenas andando em círculos.
Capturar conclusões. Envolva a execução de cada agente em um wrapper para enviar uma notificação quando o processo terminar:
your-agent-command "$TASK"; \
  curl -s -X POST "$WEBHOOK_URL" -d "agent-1 exited $?"
Modo de falha: código de saída 0 significa apenas que o processo encerrou, não que o trabalho ficou bom ou mesmo completo. Muitos agentes encerram sem erros depois de fazer uma pergunta que você nunca viu. Uma notificação de "concluído" acostuma você a confiar em um sinal que não significa que o trabalho está de fato pronto.
Detectar conflitos. Quando vários agentes compartilham o mesmo repositório, os worktrees isolam os diretórios de trabalho, mas dois agentes editando o mesmo arquivo em branches diferentes ainda vão colidir na hora do merge.
git worktree list --porcelain | grep branch
Modo de falha: você só descobre a sobreposição ao tentar fazer o merge — exatamente o momento mais custoso para lidar com isso.
Nada disso está errado. Para dois ou três agentes trabalhando em tarefas independentes, alguns painéis de tmux e um comando watch formam uma solução razoável, e você não precisa complicar à toa. Mantenha a complexidade no mínimo até bater no limite dessa abordagem.
Onde o monitoramento caseiro deixa de escalar
O limite aparece quando você está rodando tantos agentes que uma única tela já não dá conta de exibir tudo. Três problemas se acumulam:
Consultas manuais (polling) revelam o estado, não a causa. Executar git status e acompanhar logs indicam apenas que algo mudou ou que as mensagens pararam. Eles não conseguem dizer se o agente está travado aguardando uma resposta, bloqueado por uma dependência ausente ou se já concluiu. Você acaba entrando nas sessões uma a uma para diagnosticar — exatamente a troca frenética de terminais que o paralelismo deveria eliminar.
Não existe estado compartilhado. Seu monitoramento vive no seu laptop, no seu servidor tmux, no histórico do seu shell. Um colega de equipe não tem como ver qual agente está cuidando de qual tarefa — e nem você mesmo conseguirá após fechar a tampa do notebook. Quando um agente roda em uma máquina remota, a estratégia de monitorar logs locais deixa de funcionar por completo.
A revisão se torna o gargalo. Este é o ponto que as pessoas mais subestimam. Rodar agentes em paralelo perde a utilidade se a revisão do trabalho deles voltar a ser uma fila estritamente sequencial. Cinco diffs prontos sem um espaço compartilhado para gerenciar o que foi “revisado / mudanças solicitadas / mesclado” viram cinco abas no navegador e anotações mentais. Os agentes ficaram mais rápidos; o humano virou o gargalo.
Nesse momento, o que falta não são mais terminais. O que falta é um registro compartilhado.
O valor de um quadro de tarefas: centralizar todos os resultados
Uma camada de tarefas muda a unidade de monitoramento de “um processo em um painel” para “uma Tarefa com um estado”. É em torno dessa mudança que o Sharkly foi construído, e ela se alinha perfeitamente aos quatro sinais.
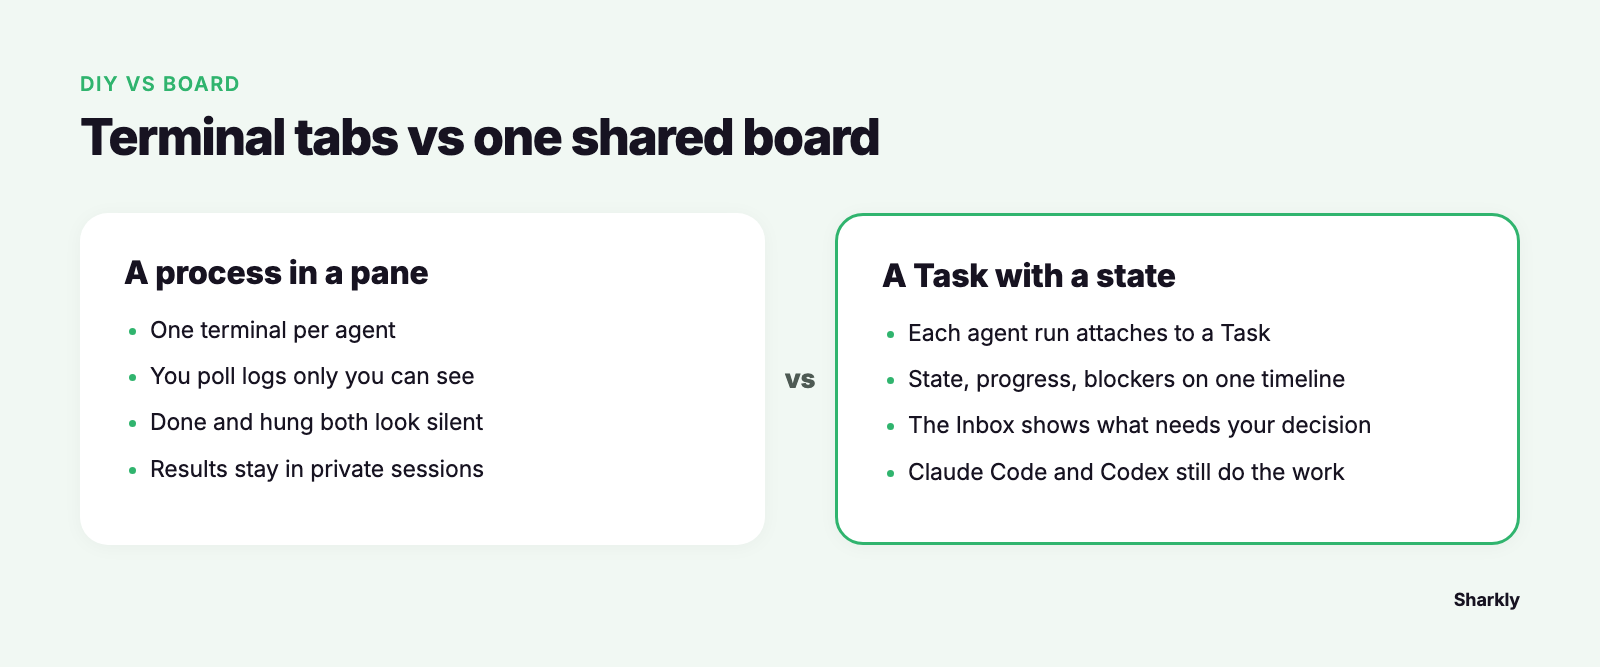
Cada execução de agente é vinculada a uma Tarefa. Estado, progresso, bloqueios e resultados são centralizados na linha do tempo dessa Tarefa, em vez de ficarem isolados em um log acessível apenas por você. Em vez de verificar manualmente, você acompanha um quadro: quais Tarefas estão em andamento, quais estão bloqueadas e quais foram concluídas e aguardam sua aprovação. A Inbox do Sharkly traz à tona as execuções que precisam de intervenção humana. Assim, a dúvida deixa de ser “será que algo terminou?” e passa a ser “isto aqui precisa da minha decisão”. Os agentes pesquisam, executam, testam e reportam; as pessoas definem o direcionamento, concedem permissões e aprovam os resultados. A automação termina onde o julgamento humano se faz necessário.
Essa distinção é fundamental para evitar conclusões erradas: o Sharkly não executa o agente nem escreve o código. O Claude Code, o Codex e os demais runtimes que você já utiliza continuam encarregados da execução. O Sharkly adiciona a camada compartilhada de tarefas, máquinas, contexto e revisão ao redor deles, garantindo que o progresso e o diff de cada execução fiquem visíveis para toda a equipe, da solicitação ao deploy. Ele também mantém cada execução em seu próprio worktree isolado, de modo que conflitos no mesmo arquivo — que antes só seriam notados no merge — fiquem contidos em cada Tarefa.
A regra prática é simples: se você roda um ou dois agentes em tarefas não relacionadas e nunca passa o bastão para ninguém, o monitoramento DIY é suficiente e o Sharkly seria excessivo. A dinâmica muda quando os agentes superam a capacidade das suas telas, quando o trabalho roda em máquinas remotas ou quando outras pessoas precisam acompanhar o mesmo quadro. Se você prefere continuar usando múltiplos coding agents em vez de se prender a um único ecossistema, essa visão compartilhada é exatamente o problema que o Sharkly resolve. Para uma visão mais ampla sobre o que deve constar nesse painel, confira o que um dashboard de coding agents com IA realmente deveria exibir.
Checklist de monitoramento para aplicar hoje mesmo
Quer você continue na abordagem manual ou adote uma camada compartilhada, um monitor de agentes paralelos deve responder a estes pontos sem que você precise se conectar a nenhuma sessão:
- Cada agente está mapeado para uma tarefa nomeada. Nada de "agent-3" anônimo. Você deve saber exatamente o propósito de cada um.
- O estado é visível de imediato. Em execução, aguardando entrada, concluído ou com falha — claramente diferenciados, e não deduzidos pelo silêncio.
- Agentes bloqueados pedem ajuda. Um prompt aguardando
y/n, uma credencial ausente ou uma pergunta não respondida chegam até você, em vez de pararem em silêncio. - Conclusão significa pronto para revisão, não apenas processo encerrado. Uma execução finalizada aponta diretamente para um diff ou PR, e não apenas para um código de saída.
- A revisão possui seu próprio fluxo de estado. Revisado, alterações solicitadas e merge realizado são rastreados, evitando que o trabalho paralelo volte a virar uma fila de revisão individual lenta.
- A visualização resiste ao notebook fechado e pode ser compartilhada. O estado reside em algum lugar além do histórico do seu shell.
- O trabalho no mesmo repositório fica isolado. Cada agente conta com seu próprio worktree, e sobreposições em arquivos aparecem antes do merge, não durante.
Avalie sua configuração atual com base nessa lista. Os itens que você não puder marcar hoje são exatamente os que custarão uma tarde de trabalho mais adiante. Se você já roda múltiplos agentes, o Sharkly oferece um único lugar para gerenciar suas tarefas e resultados. Você também pode executar seus coding agents atuais pelo Sharkly e manter os runtimes que já utiliza.


