
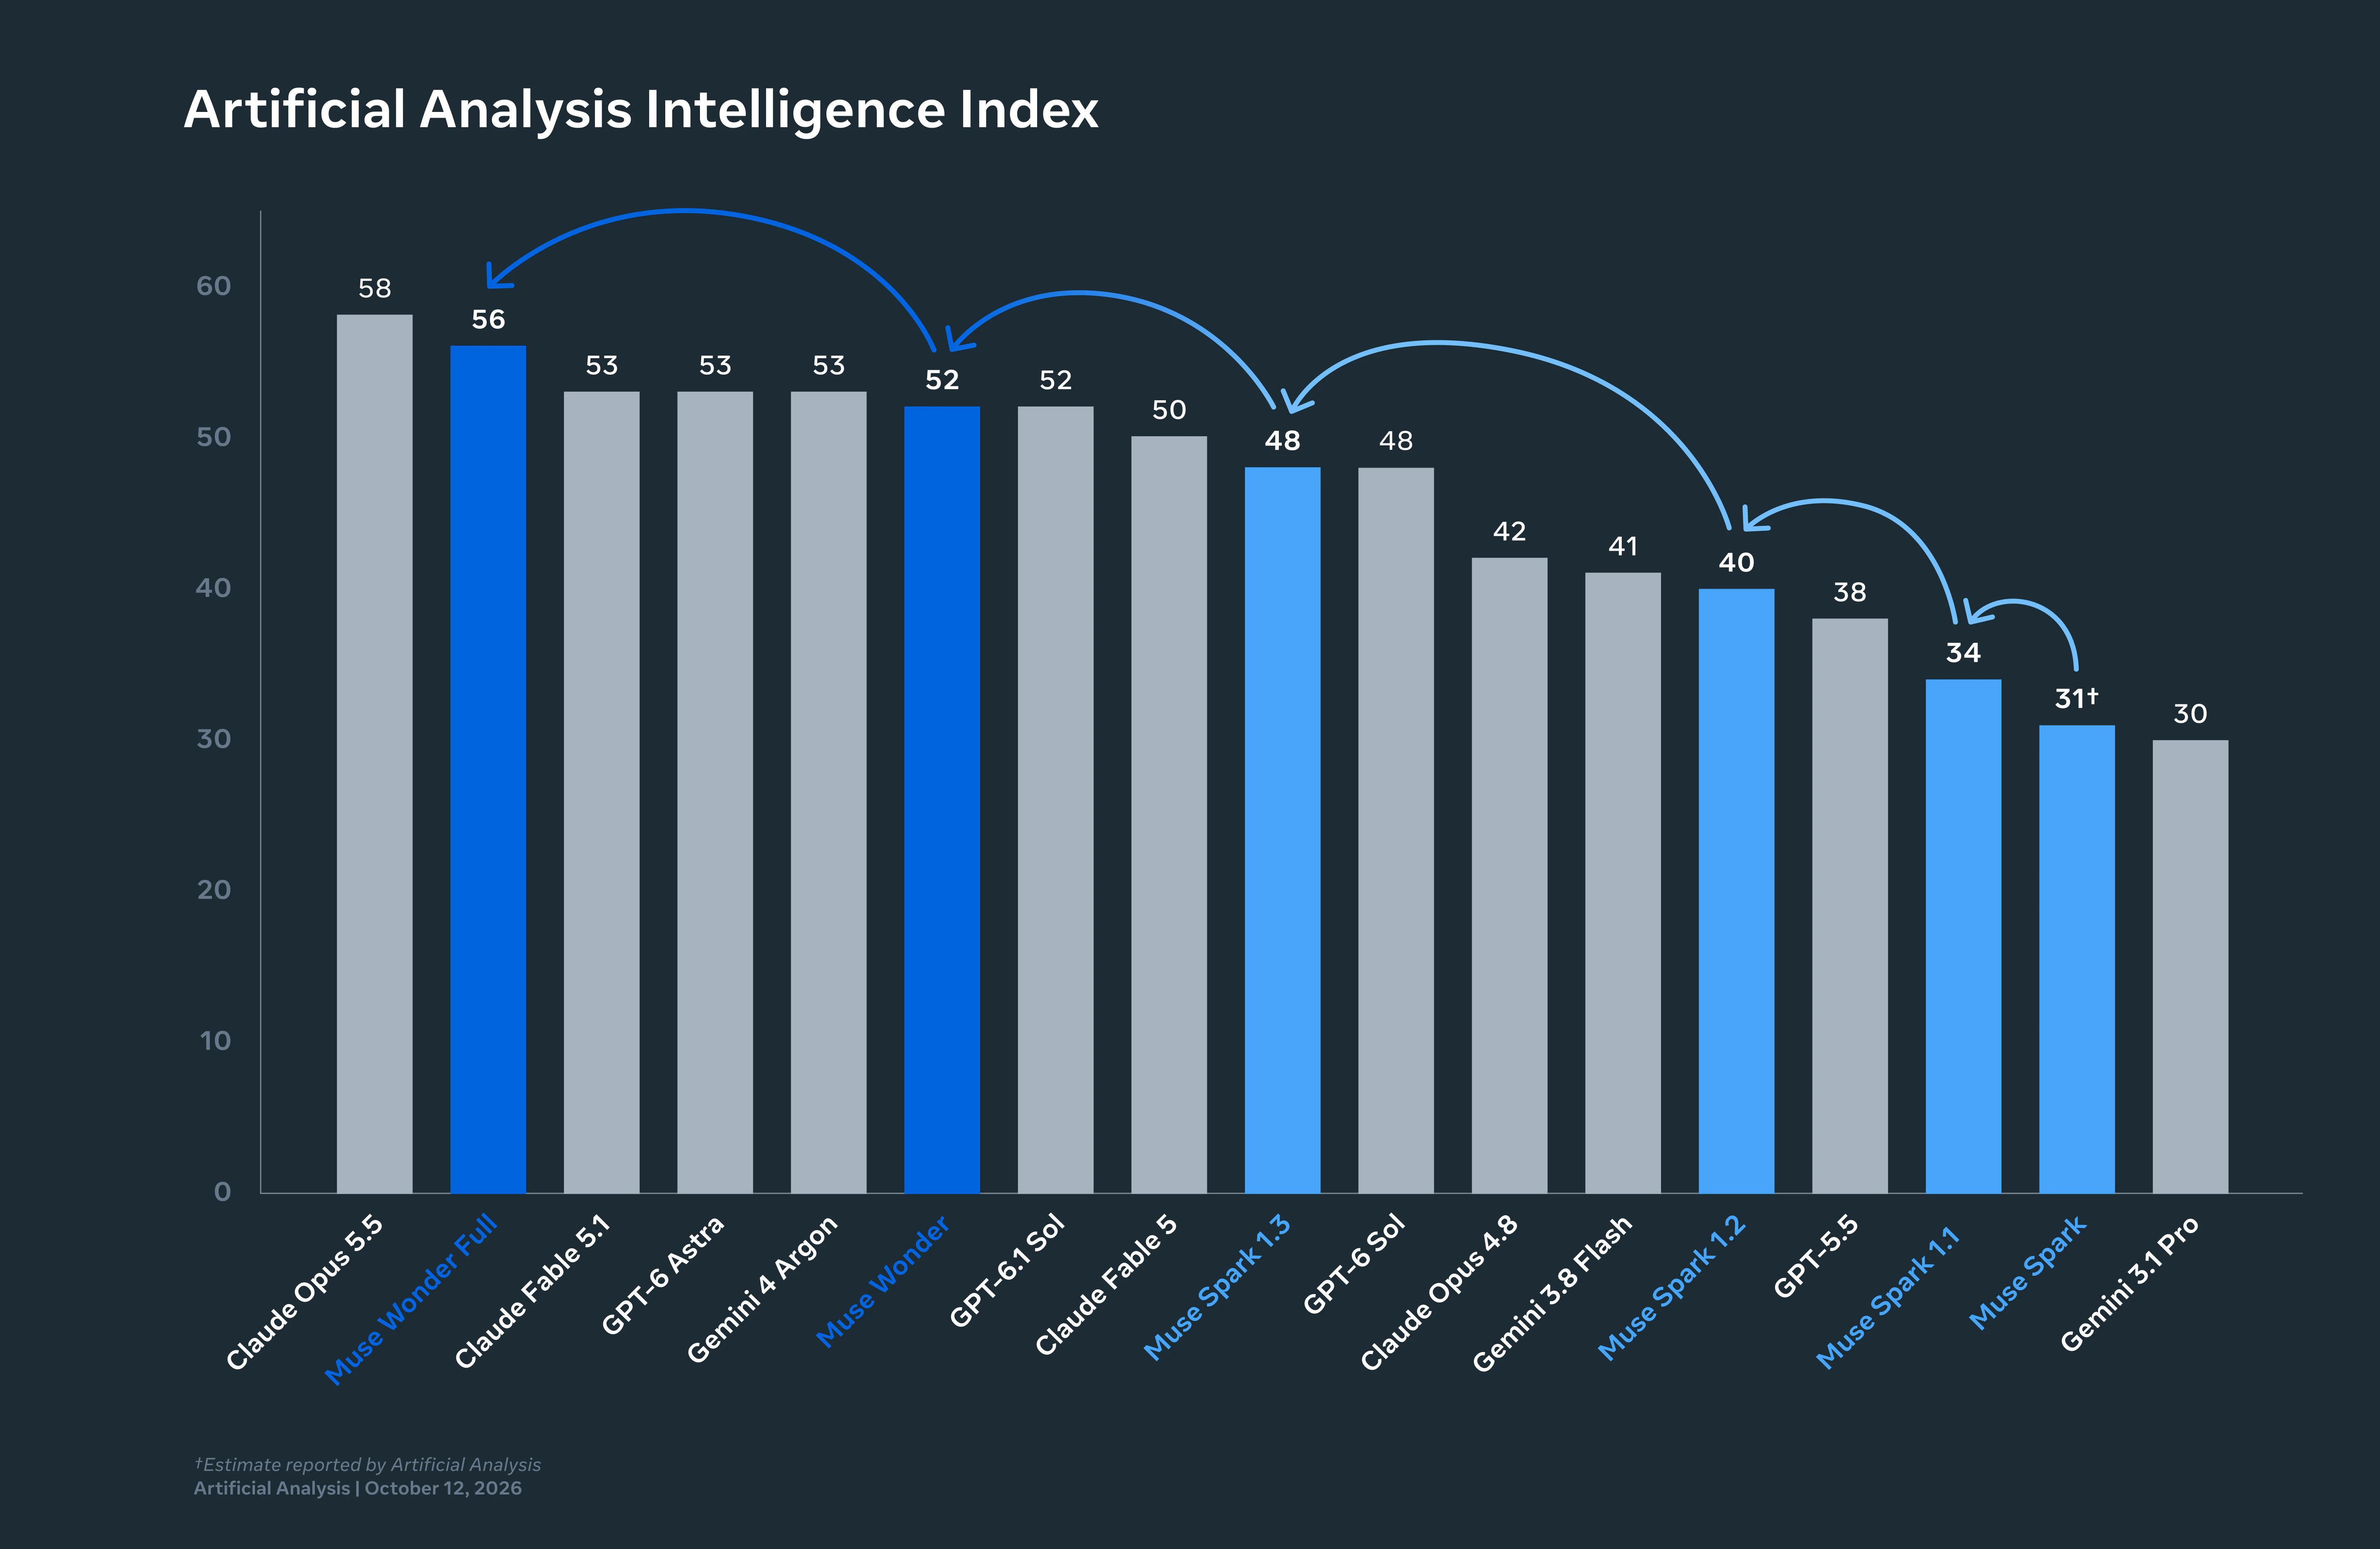
O Muse Wonder e o Claude Opus 5.5 têm o mesmo custo: US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída. Portanto, para uma Crew, a escolha entre eles não é uma questão de orçamento, mas sim uma regra de roteamento. O model card da Meta coloca o Wonder à frente no benchmark que avalia tarefas longas de programação (SWE-Marathon, 53,1 contra 46,3), enquanto o Opus lidera em operações no terminal (59,6 contra 52,0), inteligência geral (58 contra 52 no índice independente) e conhecimento (46 contra 25). Esses quatro números descrevem dois Agentes distintos — e um quadro que faz o roteamento com base neles extrai muito mais de ambos do que um que simplesmente adota um modelo padrão.
Este post traduz esses números em atribuições práticas: quais Tarefas direcionar para um Agente Muse Wonder, quais manter no Opus 5.5, o impacto de cada um na fila de revisão e como avaliar, após uma semana, se a regra está funcionando. O passo a passo para a esteira da Meta está disponível em como executar agentes Muse Wonder no Sharkly.
Os números que realmente importam para o roteamento
| Métrica | Muse Wonder | Claude Opus 5.5 | Fonte |
|---|---|---|---|
| SWE-Marathon (execuções longas de código) | 53.1 | 46.3 | Model card da Meta |
| DeepSWE 1.1 | 78.8 | 74.2 | Model card da Meta |
| Terminal-Bench 4.0 | 52.0 | 59.6 | Model card da Meta |
| AA-Omniscience (conhecimento) | 25 | 46 | Artificial Analysis |
| Taxa de alucinação | 27% | menor, segundo o ranking da AA | Artificial Analysis |
| Índice de Inteligência | 52 | 58 | Artificial Analysis |
| Índice de Agentes de Programação | 63 | 66 (Claude Code) | Artificial Analysis |
| Custo por tarefa do índice | $4.52 | $5.98 | Artificial Analysis |
| Entradas | Texto, imagem, vídeo, áudio | Texto, imagem, PDF | Documentação oficial |
Interprete a tabela como dois perfis distintos. Wonder: persistente, mais econômico por tarefa por ter uma saída concisa, fraco em recuperação de informações (recall), com suporte nativo a vídeo e áudio. Opus: mais inteligente no panorama geral, mais competente no shell, com maior base de conhecimento e custo mais elevado por tarefa. Nenhum dos perfis é inerentemente melhor; eles apenas atendem a Tarefas diferentes.
Tarefas ideais para o Agente Muse Wonder
O ponto em comum são tarefas extensas e cheias de obstáculos. A Meta treinou o modelo para o que chama de Foco Ativo (Active Focus) — testar abordagens alternativas e superar bloqueios —, e o SWE-Marathon é o benchmark criado justamente para avaliar essa capacidade.
- Refatorações em múltiplos arquivos mantendo a suíte de testes verde. Múltiplas etapas, cada uma verificável, com falhas que exigem uma segunda ou terceira abordagem.
- Migrações de dependências e frameworks. A clássica execução longa: atualizar, quebrar, corrigir e repetir — em que o papel do modelo é não desistir no décimo primeiro passo.
- Ciclos de correção e validação em suítes com testes instáveis (flaky tests). Execuções que precisam diferenciar o próprio bug de uma inconsistência da suíte.
- Tarefas com entradas de vídeo ou áudio. Uma gravação de tela exibindo um bug ou o áudio de uma reunião com requisitos. O Opus 5.5 não aceita esse tipo de arquivo.
Defina o critério de aceitação de forma que a própria execução possa validá-lo. O Wonder atinge seu potencial máximo quando a Tarefa diz: “todos os testes em packages/api passam e o changelog contém um novo registro”; e seu pior desempenho quando precisa decidir sozinho o que significa estar concluído.
Tarefas que devem permanecer no Opus 5.5
- Trabalhos com uso intensivo de terminal. Scripts de infraestrutura, pipelines de deploy ou qualquer cenário em que o agente viva no shell. Uma diferença de sete pontos e meio no Terminal-Bench representa uma vantagem real.
- Qualquer tarefa que dependa de conhecimento prévio. Uma pontuação de 25 contra 46 no Omniscience significa que o Wonder tem o dobro de probabilidade de não saber um fato. Para APIs de bibliotecas que nunca viu, códigos de erro obscuros ou conhecimento de domínio, o Opus responde de memória, enquanto o Wonder precisa pesquisar ou adivinhar.
- O papel de revisor. O Agente que analisa o diff de outro Agente e julga se a solução está correta deve ser o mais inteligente disponível. No índice composto, esse é o Opus — e o padrão de Crew com modelos mistos já reserva esse papel para o modelo mais robusto.
- Tarefas curtas e pontuais. No DeepSWE, ambos estão próximos; em inteligência geral, o Opus lidera. Se a execução durar dez minutos, a vantagem de persistência do Wonder nem chega a se manifestar.
O impacto de cada modelo na fila de revisão
O roteamento altera diretamente o que chega às mãos dos revisores — e esse é o custo real.
Uma execução do Wonder em uma Tarefa longa gera um histórico mais extenso: mais tentativas, mais abordagens revertidas, mais commits. Esse é o modelo fazendo o seu trabalho, mas também significa que o diff não conta a história completa. O revisor precisa do log de execução, e é exatamente por isso que as instruções do Agente devem orientá-lo a manter um registro contínuo de tudo o que tentou. O princípio de que a revisão humana é o gargalo aplica-se com ainda mais força aqui: um modelo persistente gera mais volume para revisar por Tarefa, e não menos.
A lacuna de conhecimento do Wonder se manifesta em afirmações específicas feitas com segurança, mas incorretas: uma flag inexistente, um método renomeado duas versões atrás. Sua taxa de alucinação é baixa para a categoria (27% na avaliação da Artificial Analysis), mas 27% não é zero. Instrua o Agente a confirmar no repositório tudo sobre o que tiver dúvidas e a explicitar quando não conseguir fazer isso — e oriente o revisor a fazer verificações pontuais exatamente nessas linhas.
Uma execução do Opus na mesma Tarefa tende a seguir um caminho mais curto e decisivo, com um custo mais elevado por tarefa. A revisão é mais leve por execução. Contudo, quando a Tarefa é longa e repleta de bloqueios, o Opus tem maior tendência a desistir antes do fim, o que traz outro tipo de demanda para a fila: uma Tarefa incompleta que precisa ter seu escopo redefinido.
Três Tarefas roteadas na prática
Exemplos práticos facilitam a aplicação da regra no momento da distribuição de tarefas.
“Atualizar o ORM da v5 para a v7 em todos os serviços; todos os testes de integração devem passar.” Wonder. Dezenas de etapas, uma suíte de testes que falhará de formas inéditas a cada estágio e uma linha de chegada bem definida. A persistência do modelo é o grande trunfo, e a própria execução pode validar o critério de aceitação.
“Escrever o Terraform para o novo ambiente de staging e aplicá-lo.” Opus. Uso intenso do terminal, conhecimento específico de infraestrutura e uma ação de alto impacto. O Terminal-Bench aponta para o Opus; o raio de impacto exige que o Agente pare e solicite confirmação antes do apply, independentemente do modelo utilizado.
“Explicar por que o webhook de pagamentos está disparando em duplicidade e propor uma correção.” Opus para a explicação, pois ela depende de entender a semântica de novas tentativas (retry) do provedor — ou seja, recuperação de conhecimento. Se a correção sugerida evoluir para uma alteração em múltiplos arquivos com testes, essa Tarefa de desdobramento pode ser direcionada ao Wonder.
O padrão é claro: Wonder para Tarefas definidas por uma linha de chegada; Opus para Tarefas definidas pelo que é preciso saber de antemão. Quando uma Tarefa envolver ambos os aspectos, divida-a. O Sharkly foi desenvolvido exatamente para esse tipo de divisão: uma Tarefa por Agente por esteira, com a passagem de bastão registrada no quadro em vez de ficar na cabeça de alguém.
Executando ambos e avaliando os resultados
Aplique a regra no quadro durante uma semana e deixe os resultados das Tarefas falarem por si.
- Crie o Agente Muse Wonder e mantenha o Agente Opus 5.5. Configure as instruções de ambos os Agentes para incluir o ID do modelo no topo do relatório, já que o Sharkly não o exibe.
- Faça as atribuições com base na regra descrita, e não por preferência pessoal: tarefas longas e com muitos bloqueios vão para o Wonder; tarefas de terminal e dependentes de conhecimento vão para o Opus; tarefas de revisão ficam com o Opus.
- Após uma semana, levante as Tarefas concluídas por cada Agente e contabilize três pontos: quantas retornaram com uma pergunta em vez de um resultado, quantas precisaram de uma segunda execução e quantos comentários de revisão cada uma recebeu.
Se as Tarefas longas do Wonder forem concluídas com menos reexecuções e as Tarefas de terminal do Opus exigirem menos correções, a regra está validada. Se as Tarefas do Wonder estiverem gerando mais comentários de revisão do que a economia obtida em reexecuções, restrinja o que envia a ele. Os números da tabela são médias de benchmarks; as suas Tarefas são o teste que realmente importa.
Nada disso impacta a fatura do Sharkly. O consumo dos modelos é cobrado diretamente pelas chaves da Meta e da Anthropic configuradas no Computer e, com preços de tabela idênticos, a única variação de custo será a informada pelo bloco de usage a cada execução.
Os modelos mudaram este mês. O contexto, o progresso, os bloqueios, os resultados e a revisão humana continuaram visíveis desde a solicitação inicial até o lançamento. Você pode estruturar isso manualmente com worktrees ou utilizar o Sharkly para gerenciar todo o fluxo de trabalho.


